エンタープライズAIデータインフラとは、パイプライン、ストア、インデックス、ガバナンス制御の体系であり、分断された運用データを、AIシステムが信頼してクエリできる基盤——新鮮で、一貫していて、権限管理され、関係を認識したデータ——に変えるものです。モデルがますます高性能になるにつれ、エンタープライズAIの制約要因はモデル品質からデータ基盤の品質へと移っています。AIシステムの信頼性は、依存するインデックスの鮮度とアクセス制御の完全性の程度に等しいのです。
本記事は、エンタープライズスーパーインテリジェンスアーキテクチャの設計図における Enterprise Data & Knowledge レイヤーの技術的深堀りです。前回の記事では6層の参照モデルを定義しましたが、ここではデータレイヤーが実際にどう構築されるかを詳述します——運用システムがどうベクトルストアとナレッジグラフにほぼリアルタイムでデータを供給するか、アクセス権限が派生インデックスにどう伝播するか、パイプラインが失敗したときどう復旧するか。最初に一点明確にしておくと、「SI対応(SI-ready)」とはアーキテクチャ上の方向性——増してゆくAIを吸収できるよう設計されたインフラ——であり、確立された技術標準でも、スーパーインテリジェンスが存在するという証拠でもありません。
重要なポイント
- SI対応データインフラはアーキテクチャ上の方向性——増していくAIに備えて統制・鮮度・相互運用性を確保したデータ——であり、認定標準でもASI存在の証拠でもありません。
- 従来のデータアーキテクチャとAI対応インフラの差は運用上のものです。鮮度、権限伝播、関係モデリングであって、ストレージ容量ではありません。
- ベクトルストアとナレッジグラフは異なる検索課題を解決します。ほとんどの企業は、単一の統制された検索インターフェース越しに両方を必要とします。
- チェンジデータキャプチャはAI向けパイプラインのデフォルトの骨格です。古くなったインデックスは静かに下流のすべてのAIシステムを劣化させます。
- 段階的に構築します。1つのデータドメイン、標準化されたインジェスション、検証済みの鮮度とアクセス制御——それから拡大します。
SI対応データインフラとは何か
AI対応データインフラは、AIワークロードを第一級の消費者として——アナリストやダッシュボードだけでなく——構築されたインフラです。「SI対応」はそこに計画の時間軸を加えます。同じエンジニアリングでも、その上のモデルの能力向上を再設計なしで吸収できる余裕を持たせたものです。それを定義する4つの特性があります。
- 鮮度(Freshness)。派生インデックスはソース変更に応じて更新されます。ホットなドメインでは一晩ではなく数分で。インデックスはコピーであり、コピーは劣化します。
- 相互運用性(Interoperability)。1つのインジェスション基盤がレイクハウス、ベクトルストア、ナレッジグラフに供給します。ユースケースごとの個別パイプラインではありません。
- 発見可能性(Discoverability)。メタデータカタログがデータセットを発見可能にし、ソース行からインデックス済みチャンクまでのリネージを保持します。
- 統制されたアクセス(Governed access)。ソースの権限は、エンベディングを含むすべての派生コピーに伝播します。エンベディングは法的にも実務的にもテキストのコピーです。
SI対応 vs AI対応:実務的な区別
| 観点 | 従来型 | AI対応 | SI対応の方向性 |
|---|---|---|---|
| 主な消費者 | レポートとダッシュボード | MLモデル、RAGアプリケーション | より自律的なエージェント、将来のより強力なモデル |
| 鮮度の期待 | 日次バッチで許容 | ホットドメインでほぼリアルタイム | ドメインごとの明示的な鮮度SLO |
| アクセス制御 | システムごと、手動で突合 | インデックスへ伝播 | 検索時に強制。取り消しは監査対象 |
| データモデル | テーブルとファイル | テーブル+エンベディング | さらに明示的関係とセマンティックレイヤー |
正直な注意点:右列のどの特性も、スーパーインテリジェンスに必要と証明されているわけではありません——その能力は存在しません。この方向性が擁護できるのは、将来何が来ても、すべての特性が今日のAIシステムに報いるからです。
従来のエンタープライズデータアーキテクチャがAIに対応できない理由
エンタープライズのデータ資産は別の消費者のために作られてきました。AIが第一級のワークロードになると、5つの失敗パターンが繰り返し現れます。
- 分析の鮮度は運用の鮮度ではない。日次ETLは「昨日時点で正しい」ウェアハウスを生みます。月曜のダッシュボードには良くても、午後3時に運用の質問に答えるAIアシスタントには間違いです。
- 権限が伝播しない。ソースシステムは行・オブジェクトレベルのACLを持ちますが、エンベディングを含む派生コピーは通常そのどれも継承しません。結果として、要求者が見る権限のないコンテンツを取得できるAIシステムが生まれます。
- 関係が暗黙的。リレーショナルストアはエンティティを記録します。重要な関係は、トラバーサルのために設計されたことのない外部キー、あるいは人の頭の中にあります。
- 消費者ごとに1本のパイプライン。新しいAIユースケースごとに個別の抽出が作られ、同じデータのコピーが静かに互いに乖離していきます。
- 鮮度の契約がない。特定のインデックスがどれだけ古いか誰も言えないため、その上に作られた回答を完全には信頼できません。
これらは評価の問題ではなく実装上の失敗です。データ資産が対応済みかどうかは別の問題であり、AIデータレディネスのガイドが評価側を扱っています。本記事は評価が済んだ前提で、次に何を作るかを扱います。
エンタープライズAIデータインフラの中核コンポーネント
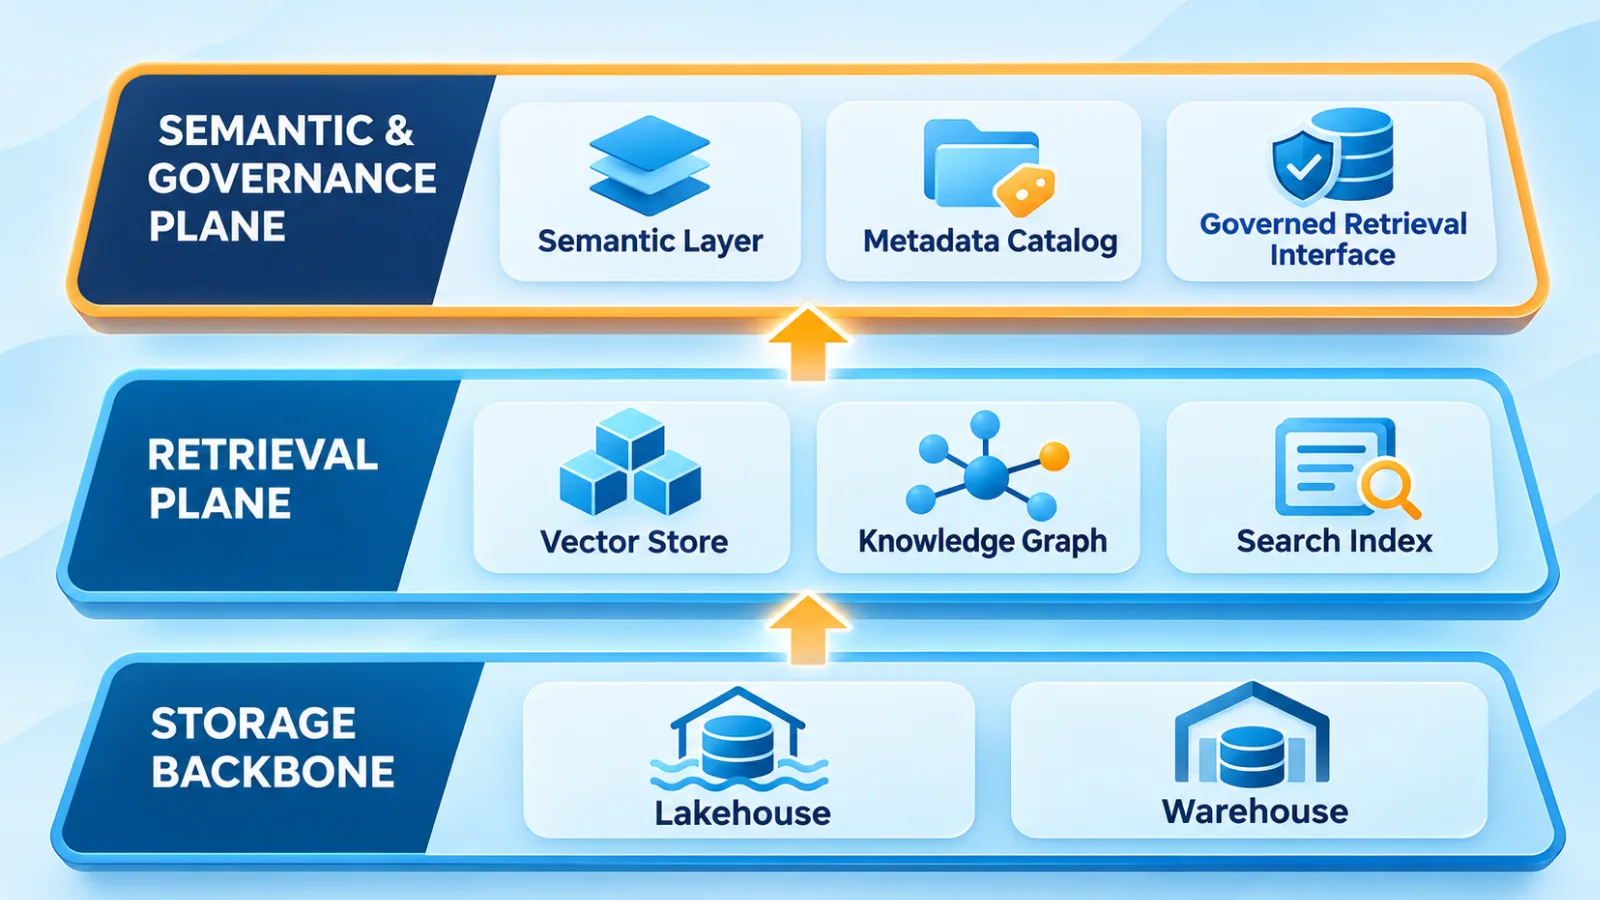
ストレージの骨格
骨格はレイクハウス——オブジェクトストレージ上のオープンテーブルフォーマット——に、統制されたマート用のウェアハウスを補完したものです。データは生のまま着地し、検証・クレンジングされ、ドメインモデルへと成形されます。AIにとっての決定的な特性は容量ではなく回復可能性です。骨格は、すべての派生ストアを再構築できる正準状態です。インデックスが破損したりエンベディングモデルが置き換えられたりしたとき、骨格は復旧を救出作戦ではなくリプレイに変えます。
検索プレーン
3つの派生ストアが異なるクエリ形態に応えます。
- ベクトルストア。非構造化コンテンツに対する意味的検索のための、エンベディング+チャンク参照。
- ナレッジグラフ。トラバーサルと多段クエリのための、エンティティと型付き関係。
- 検索インデックス。キーワード・メタデータ検索。正確な識別子と構造化フィルタには依然として適切なツール。
このプレーンを健全に保つ設計ルール:派生ストアは使い捨てです。正準データの源に昇格させない、再計算できない状態を溜め込まない、変更フィードを迂回する書き込みを受け付けない。
セマンティック&ガバナンスプレーン
ストレージと検索の上にあるのが、システムを一貫させるレイヤーです。ビジネス定義と指標ロジックを担うセマンティックレイヤー、発見とリネージのためのメタデータカタログ、そして統制された検索インターフェース——AIアプリケーションがクエリする唯一のAPIです。このインターフェースは呼び出し元を認証し、権限フィルタを適用し、鮮度制約を強制し、すべてのアクセスを記録します。インターフェースが唯一の門であること——それこそが、ガバナンスを願望ではなく適用可能なものにする理由です。
ベクトルデータベース vs ナレッジグラフ:使い分け
この2つのストアは競合ではなく相補です。混同が起きるのは、両方とも「AIのためのメモリレイヤー」として売られているためですが、答える質問が違います。
| 観点 | ベクトルデータベース | ナレッジグラフ |
|---|---|---|
| 保存するもの | コンテンツチャンクのエンベディングとソース文書への参照 | エンティティと型付き関係(エッジ) |
| クエリ形式 | 意味的類似性——「これに似たものを探して」 | トラバーサル——「これらはどうつながっているか」 |
| 強み | 非構造化テキスト、曖昧な意味的マッチング、大規模ANN検索 | 多段推論、説明可能なパス、安定したエンティティ同一性 |
| 弱み | 明示的関係なし、結果が不透明、モデル変更でエンベディングがドリフト | 初期モデリングコスト、同期が難しい、疎なグラフは性能が落ちる |
| 更新の仕組み | ソース変更時に再チャンク・再エンベッド。削除はトゥームストーンで伝播 | エッジの増分アップサート。大きなトポロジ変更はイベントからリプレイ |
| 代表的な企業用途 | ポリシー、チケット、ドキュメント、ナレッジベース | サプライチェーン、組織構造、データリネージ、依存関係マップ |
「関連コンテンツを探して」が質問ならベクトルストアを選びます——最も多い企業ケースであり、ベクトルインデックスが最初に導入される理由です。「関係をたどって」が質問ならグラフを選びます——依存影響、組織上の責任、由来の連鎖です。実際の質問の多くは両方です。「このサプライヤーに関係するインシデントを探して」は、インシデントを見つける意味的検索と、どの関係が「関係する」に該当するかを確定するグラフトラバーサルの両方を必要とします。
この交点で動作するのがGraphRAGのようなハイブリッドパターンです。ベクトル検索が最初の候補集合を作り、グラフトラバーサルがそれを拡張して結果を説明可能にします。GraphRAG開発者ガイドは実装パターンの1つを説明していますが、技術リファレンスとして扱い、あるベンダーがすべての企業に合うという主張ではありません。境界の注記として、どのストアに問い合わせるかを決めるオーケストレーションロジックは本記事のスコープの一つ上のレイヤーにあります——その検索・アプリケーションレイヤーはエージェンティックRAGアーキテクチャのガイドが扱っています。
AI向けリアルタイムデータパイプラインの設計
鮮度はストレージではなくパイプラインの特性です。古いまま到着したデータをベクトルストアやグラフエンジンが補うことはできません。つまりインジェスション設計が下流のすべてを決定します。
バッチ vs CDC vs イベントストリーミング
| パターン | 典型的な遅延 | ソースへの負荷 | 順序と重複除去 | 最適な用途 |
|---|---|---|---|---|
| スケジュールバッチ(ETL/ELT) | 時間 | 定期的な大量読み取り | 単純 | コールド・参照データ、初期バックフィル |
| チェンジデータキャプチャ(CDC) | 数秒〜数分 | 低い——コミットログを読む | キーごとの順序 | システムオブレコード:ERP、CRM、中核データベース |
| イベントストリーミング | サブ秒〜数秒 | 発行後はゼロ | パーティション順序、at-least-once | イベント発行済みドメイン、テレメトリ、活動 |
CDCはシステムオブレコードからのAI向け同期のデフォルトの骨格です。ログベースのキャプチャはデータベースのコミットログを読み、アプリケーションコードを変更せずに挿入・更新・そして重要な削除を拾い、素朴なポーリングが完全に取りこぼす削除セマンティクスを運びます。イベントストリーミングはすでにビジネスイベントを発行しているドメインに適し、バッチは初期ロードとコールドデータを担い続けます。ストリーム処理の仕組み——ウィンドウ処理、ステートフル結合、配信保証——については、Apache Kafkaによるストリーム処理のドキュメントが堅実な技術リファレンスです。
インクリメンタルインデクシングとエンベディングの更新
ベクトルインデックスの更新ループ:変更イベントが到着し、対象ドキュメントを取得して再チャンクし、変更されたチャンクだけを再エンベッドして安定したドキュメントIDでアップサートします。これを誠実に保つルールが2つあります。第一に、削除はトゥームストーンとして伝播させること——ソースで削除されたドキュメントは同一の遅延ウィンドウ内にインデックスから消えなければなりません。さもなければ古いベクトル経由でアクセスが漏れます。第二に、すべてのベクトルにエンベディングモデルのバージョンを保存し、モデル更新を、鮮度を数日凍結する全インデックス再構築ではなく段階的な再エンベッドとして展開できるようにします。
ナレッジグラフの同期
ここでの難題はエンティティ解決です。「Acme Corp」「ACME Corporation」「ID 4471」として3つのシステムに現れる同じサプライヤーは、エッジが意味を持つ前に正準の同一性が必要です。インジェスション時にエンティティを解決し、エッジを増分アップサートし、関係型をバージョン管理し、トポロジ変更が大きいときはテーブルとグラフ状態を差分比較しようとするのではなくイベントをリプレイします。
正準データ源の一貫性
ドメインごと・エンティティごとに書き込み元は1つ。レイクハウスが正準状態を保持し、派生ストアは設計上結果整合のレプリカです。このモデルでの障害はしばしば静か——発行を止めたコネクタは静かなシステムとまったく同じに見える——ため、突合ジョブが時間ウィンドウごとのレコード数とチェックサムを比較して乖離を早期に検出します。「十分に新しい」を感覚ではなく数字にするため、ドメインごとの遅延予算を公開します。
リトライ、リプレイ、デッドレターキュー
- 冪等なコンシューマー。安定IDでキー付けされたアップサートは再処理を安全にし、あらゆるリトライ戦略の基盤です。
- バックオフ付きリトライ。一時的な障害——エンベディングAPIのレート制限、ネットワーク障害——はエスカレート前に指数バックオフで再試行します。
- デッドレターキュー。ポイズンメッセージはアラート付きのDLQへ。静かな脱落より騒がしい失敗のほうがましです。
- リプレイ能力。生イベントとオフセットを保持し、ソースシステムに触れずに派生ストアを再構築できるようにします——派生ストアを安全に使い捨てにする特性です。
鮮度とインデクシング遅延の監視
エンドツーエンド遅延(ソースコミットからインデックスで検索可能になるまで)、ステージごとの遅延、リトライ率、DLQの深さ、エンベディングカバレッジ(現行モデルバージョンにあるインデックス済みドキュメントの割合)を追跡します。遅延がドメインSLOを超えたらアラートします。死んだパイプラインは検出が容易ですが、生きていて11時間遅れのパイプラインこそ、AIシステムに実害を与える障害形態です。
参照アーキテクチャ:エンタープライズデータをAIシステムへ接続する
下の図は、運用ソースから統制されたAI消費まで、コンポーネントを動く参照フローに組み立てたものです。
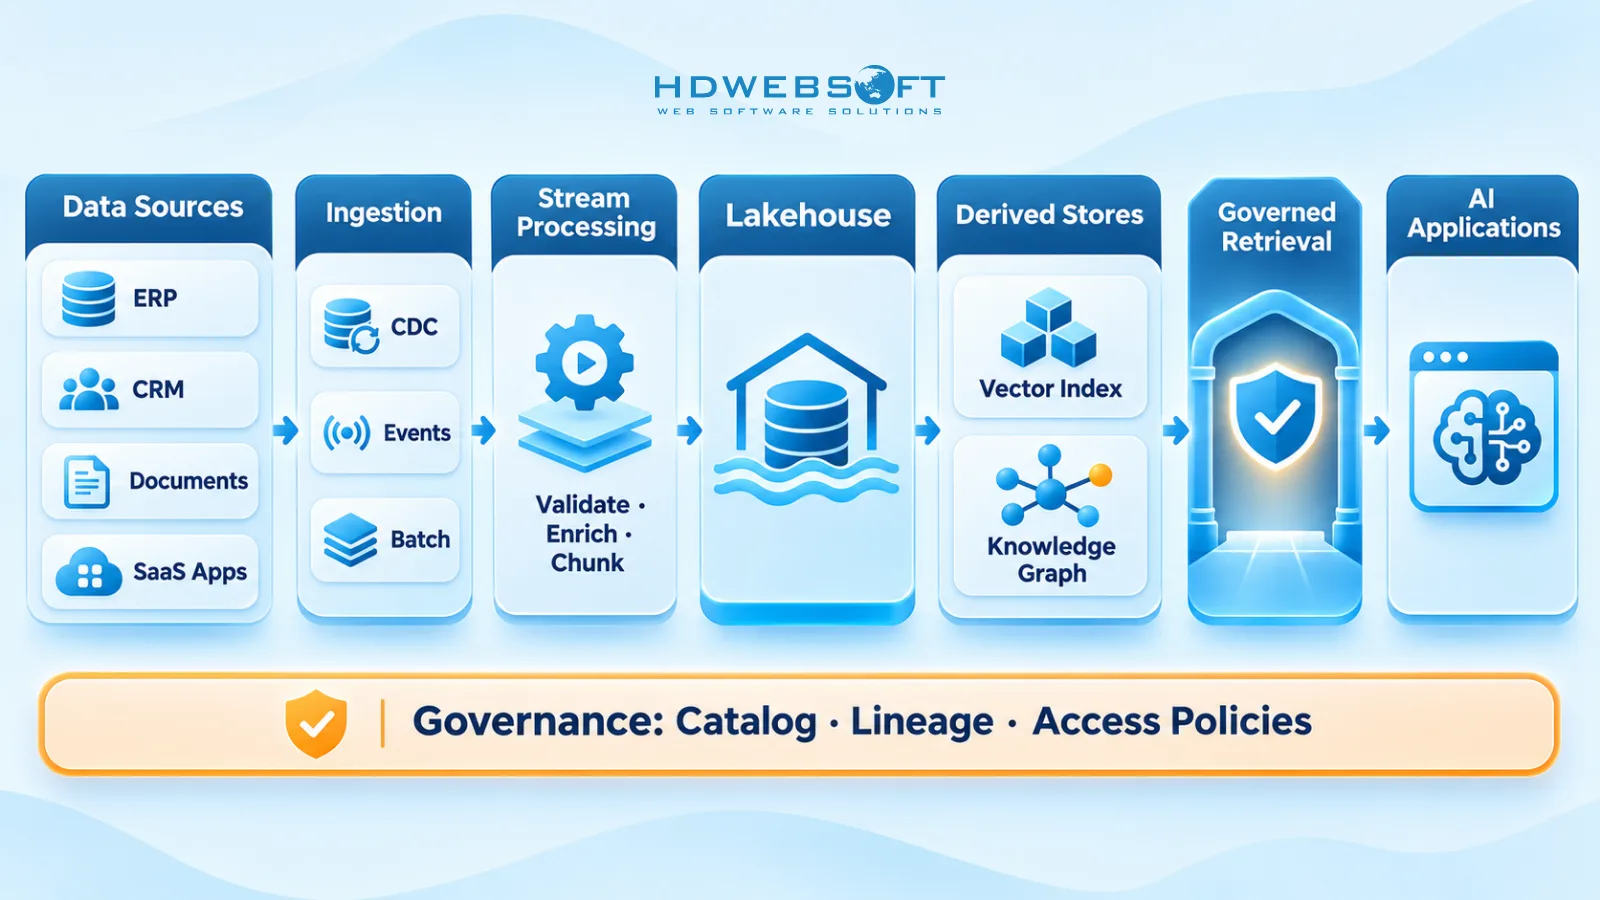
左から右へ読みます。
- ソース。ERP、CRM、文書管理、SaaSアプリケーション、既存ウェアハウス。
- インジェスションと変更キャプチャ。システムオブレコード上のCDCコネクタ、ドメインが発行するイベントストリーム、バックフィルとコールドデータ用バッチローダー。
- ストリーム処理。検証、エンリッチメント、PII分類、チャンク化、エンティティ解決——生の変更がAI消費可能なレコードになる段階。
- レイクハウス。生・クレンジング済み・成形済みのゾーンが正準状態を保持。エンティティごとの書き込み元は1つ。
- 派生ストア。リロードではなく同一の変更フィードから増分更新されるベクトルインデックスとナレッジグラフ。
- ガバナンスプレーン。カタログ、リネージ、アクセスポリシーが全ステージを横断して適用される——後付けではなく横断レイヤー。
- 統制検索インターフェース。AIアプリケーションの唯一の門。呼び出し元を認証し、権限フィルタを適用し、機微ドメインに遅延予算を強制し、すべてのクエリを記録します。
このアーキテクチャには3つの同期経路が走っており、正直に名づけることが大切です。
- ホットパス:ソース → CDC → ストリーム → 派生ストア。数秒〜数分。古さが判断を腐らせるドメイン向け。
- ウォームパス:ストリーム → レイクハウス。数分。正準状態を最新に保つ。
- コールドパス:バッチ → レイクハウス → 派生ストアのバックフィル。時間。参照データと再構築用。
一貫性の境界:派生ストアは結果整合であり、正しさはリプレイ+突合から来ます。遅延ゼロのふりをするのではありません。検索インターフェースが「どれだけ古ければ古すぎるか」をドメインごとに強制する場所です。だからこそ、制御点はインデックスではなくインターフェースなのです。
分断されたエンタープライズデータの上にAIシステムを構築していませんか?信頼できるデータ基盤には、データベースをつなぐ以上のものが必要です。リアルタイムインジェスションとナレッジ同期から統制された検索まで、HDWEBSOFTはエンタープライズシステムと最新のAIアプリケーションを結ぶエンジニアリングソリューションの設計を支援します。
データガバナンス、リネージ、アクセス制御
このレイヤーのガバナンスはポリシー文書ではなく実装上の制御の集合です。
- 所有と登録。すべてのドメインに名指しのオーナーがおり、骨格に入るすべてのデータセットが鮮度SLOとともにカタログ登録されます。
- 権限伝播。ソースのACLはコンテンツとともにインデックスメタデータとして運ばれ、検索時フィルタが結果を返す前に適用します。エンベディングはテキストのコピーであり、同等に機密として扱います。
- PIIの扱い。分類はストリーム処理内部のインジェスション時に行われ、コンテンツがエンベッドされる前にマスキングまたは除外が適用されます。
- リネージ。どのソース行がどのチャンクとエンベディングを生んだかを捕捉します。OpenLineageのドキュメントが説明するようなオープンなイベントモデルは、後で再構築する代わりにパイプラインジョブがリネージを一貫して発行できるようにします。
- 取り消し。アクセス取り消しはデータと同様に伝播します——削除・更新イベント+定期的なACL同期——そして想定ではなく訓練で検証します。
- 監査。統制インターフェース経由のすべての検索が、呼び出し元の同一性、適用フィルタ、コーパスバージョンとともに記録されます。
- ガバナンスとしての鮮度。AIの回答が判断を動かす瞬間、古いデータはコンプライアンスリスクです。遅延監視はops盤だけでなくガバナンスダッシュボードに属します。
実践的な実装ロードマップ
機能する順序立ては意図的に地味です——一度に1ドメイン。
- 価値の高いドメインを1つ選ぶ。サポートナレッジベース、製品カタログ、または単一の運用システム。見返りが見える限定された範囲です。
- そのインジェスションを標準化する。ソースが対応していればCDC。このパイプラインパターンが以後すべての雛形になります。
- そのドメインの検索プレーンを立てる。まずベクトルインデックス。関係クエリが真に見合う場合のみグラフを追加します。
- 拡大前に検証する。実トラフィックで測った鮮度SLO、取り消し訓練で証明した権限伝播、エンドツーエンドで捕捉したリネージ。
- 同一の基盤を通じて拡大する。隣接ドメインは既存のインジェスションパターンに参加します——2本目の個別パイプラインは決して作りません。
各ステップを律する成功指標:
| 指標 | 健全なシグナル |
|---|---|
| エンドツーエンドの鮮度遅延 | ドメインSLO内——ホットドメインで5分未満 |
| 権限伝播遅延 | 取り消しが数分で有効、訓練で検証済み |
| インデックスカバレッジ | スコープ内ドキュメントのほぼ100%が現行エンベディングバージョン |
| パイプライン信頼性 | 一時障害は自動回復、DLQ深さはほぼゼロ |
| 下流の検索品質 | アプリケーションレイヤーの管轄——本記事のスコープ外 |
まとめ
エンタープライズAIにおける耐久資産はモデルではなく、その下のデータ基盤です。このインフラの寿命の間にモデルは何度も入れ替わりますが、残るのはインジェスション基盤、派生ストア、ガバナンスプレーンです。それこそが「SI対応」を投機的な賭けではなく擁護できる姿勢にする理由です。ここで述べたすべての特性——鮮度、権限伝播、リネージ、リプレイ可能なパイプライン——は、5年後に何が来ようと、今日運用しているAIに報います。
実践的な道は段階的です。1ドメイン、1パイプラインパターン、検証済みの制御、そして拡大。AIを1本も本番化する前に基盤全体を作ろうとする企業は、往々にして何も本番化できません。HDWEBSOFTのAI開発サービスはまさにこの交差点をカバーします——データエンジニアリング、システム統合、AIアプリケーションのデリバリー。AIロードマップのためのデータ基盤を描いているなら、お気軽にご相談ください。
よくある質問
SI対応データインフラとは何ですか?
SI対応データインフラとはアーキテクチャ上の方向性であり、能力が増していくAIシステムに対応できるよう設計されたエンタープライズデータインフラを指します。鮮度(ソース変更に応じてインデックスが更新される)、相互運用性(単一のインジェスション基盤がレイクハウス・ベクトルストア・グラフに供給)、発見可能性(メタデータカタログとリネージ)、統制されたアクセス(ソース権限がすべての派生コピーに伝播する)によって定義されます。確立された技術標準ではなく、スーパーインテリジェンスが存在するという証拠でもありません。
エンタープライズAIにおけるベクトルデータベースとナレッジグラフの違いは何ですか?
ベクトルデータベースはコンテンツチャンクのエンベディングを保存し、「これに似たものを探して」という意味的類似性の質問に答えます。ナレッジグラフはエンティティと型付き関係を保存し、「これらはどうつながっているか」というトラバーサル型の質問に答えます。ほとんどの企業は両方を必要とします。ベクトルストアは非構造化テキストを大規模に処理し、グラフは多段推論と説明可能な回答を可能にする明示的な関係を担います。
AIデータパイプラインはバッチ処理とチェンジデータキャプチャのどちらを使うべきですか?
ドメインの温度に応じて両方を使います。チェンジデータキャプチャはシステムオブレコードからのAI向け同期のデフォルトであり、コミットログを読み、ソースへの負荷をほぼかけずに削除を正しく伝播します。イベントストリーミングはすでにイベントを発行しているドメインに適し、バッチは初期バックフィルと、時間単位や日次の鮮度で許容される本当にコールドなデータに適しています。
ソースデータが変化したとき、ベクトルエンベディングを最新に保つにはどうすればよいですか?
変更イベント駆動のインクリメンタルインデクシングで対応します。ソースドキュメントが変更されたらそのドキュメントを再チャンクし、変更チャンクを再エンベッドして安定IDでアップサートします。削除はトゥームストーンとして伝播させる必要があり、ソースで削除されたドキュメントは同一の遅延ウィンドウ内にインデックスから除去しなければなりません。各ベクトルにエンベディングモデルのバージョンを保存しておくと、モデル更新を全面再構築ではなく段階的な再エンベッドとして展開できます。
アクセス権限はベクトルストアやナレッジグラフにどう伝播しますか?
ソースのACLはコンテンツとともにインデックスメタデータとして運ばれ、検索時に適用されます——統制検索インターフェースが呼び出し元を認証し、結果を返す前に権限フィルタを適用します。取り消しもデータと同様に伝播します。削除・更新イベント+定期的なACL同期で、訓練により検証されます。エンベディングはテキストのコピーであり、同等に機密として扱う必要があります。
企業はAI対応データインフラの構築をどこから始めるべきですか?
価値の高い1つのデータドメインから始めます。そのインジェスションを標準化し(ソースが対応していればCDC)、そのドメインだけの検索プレーンを立て、鮮度・権限伝播・エンドツーエンドのリネージを検証してから、同一の基盤を通じて隣接ドメインへ拡大します。AIを1本も本番化する前に基盤全体を作ろうとする企業は、往々にして何も本番化できません。