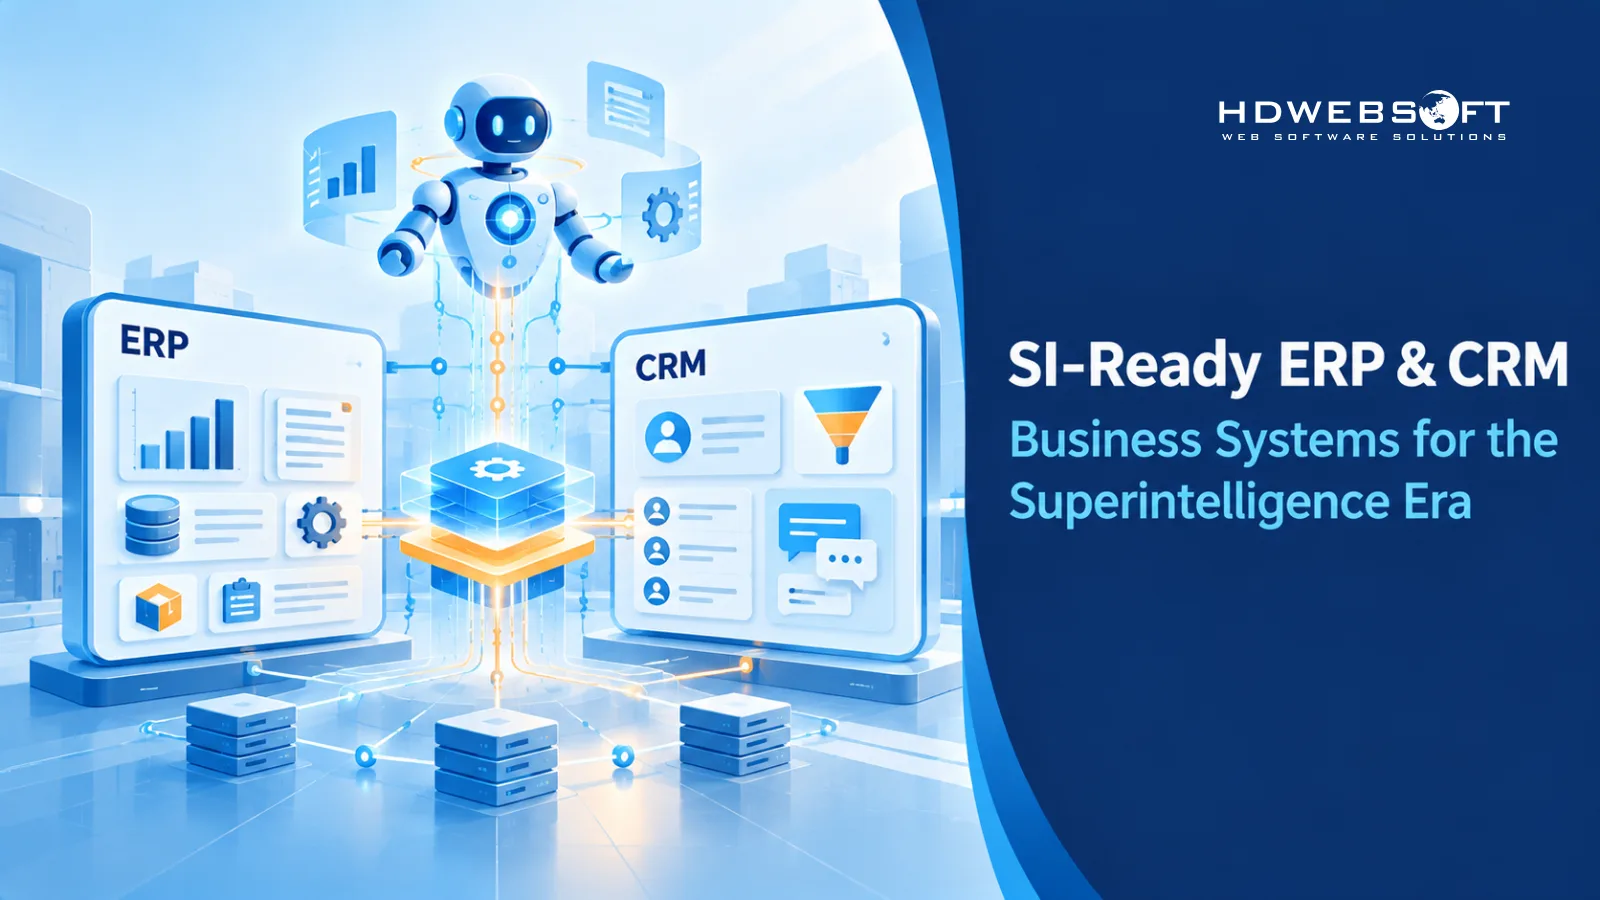
現在のAIコパイロットは、ERPやCRMシステム内で働く人々を支援します。次世代のAIは支援ではなく——運用を担います。企業が人工超知能と、それに先立つ自律性を高めつつあるエージェントへの準備を始める中で、財務・営業・調達・顧客関係を動かす記録システム(システム・オブ・レコード)が重要なボトルネックになります。完璧に推論できるAIエージェントでも、データを読めず、ワークフローを呼び出せず、監査人が信頼できる痕跡を残せなければ無用です。
SI対応ERP・CRMはその問題に対するアーキテクチャ上の回答です。AIエージェントが第一級の運用ユーザーとして機能できるよう設計されたビジネスシステム——意味的にクリーンなデータを読み、ガバナンスされたAPIを通じて行動し、行うすべてのことの機械可読な証拠を残します。製品カテゴリでも認証でもベンダーのチェックボックスでもありません。要件がまだ安く満たせるうちに、いま下す設計上の決定の集合です。
本ガイドでは、ERP・CRMにとってSI対応が実際に何を意味するか、なぜレガシーアーキテクチャがエージェントを阻むのか、システムをエージェントが操作可能にする設計原則、そしてモダナイズ・拡張・再構築の選択方法を解説します。
重要なポイント
- SI対応とは、ERPやCRMがAIエージェントを第一級の運用ユーザーとして扱うこと——機械可読データ、呼び出し可能な機能、追跡可能なアクションを備え——人間専用インターフェースにAIを後付けするのではないことを意味します。
- レガシーシステムでエージェントが失敗するのはAIが足りないからではなく、データが未文書化で、ビジネスロジックがUIに埋もれ、アクションが機械可読の痕跡を残さないからです。
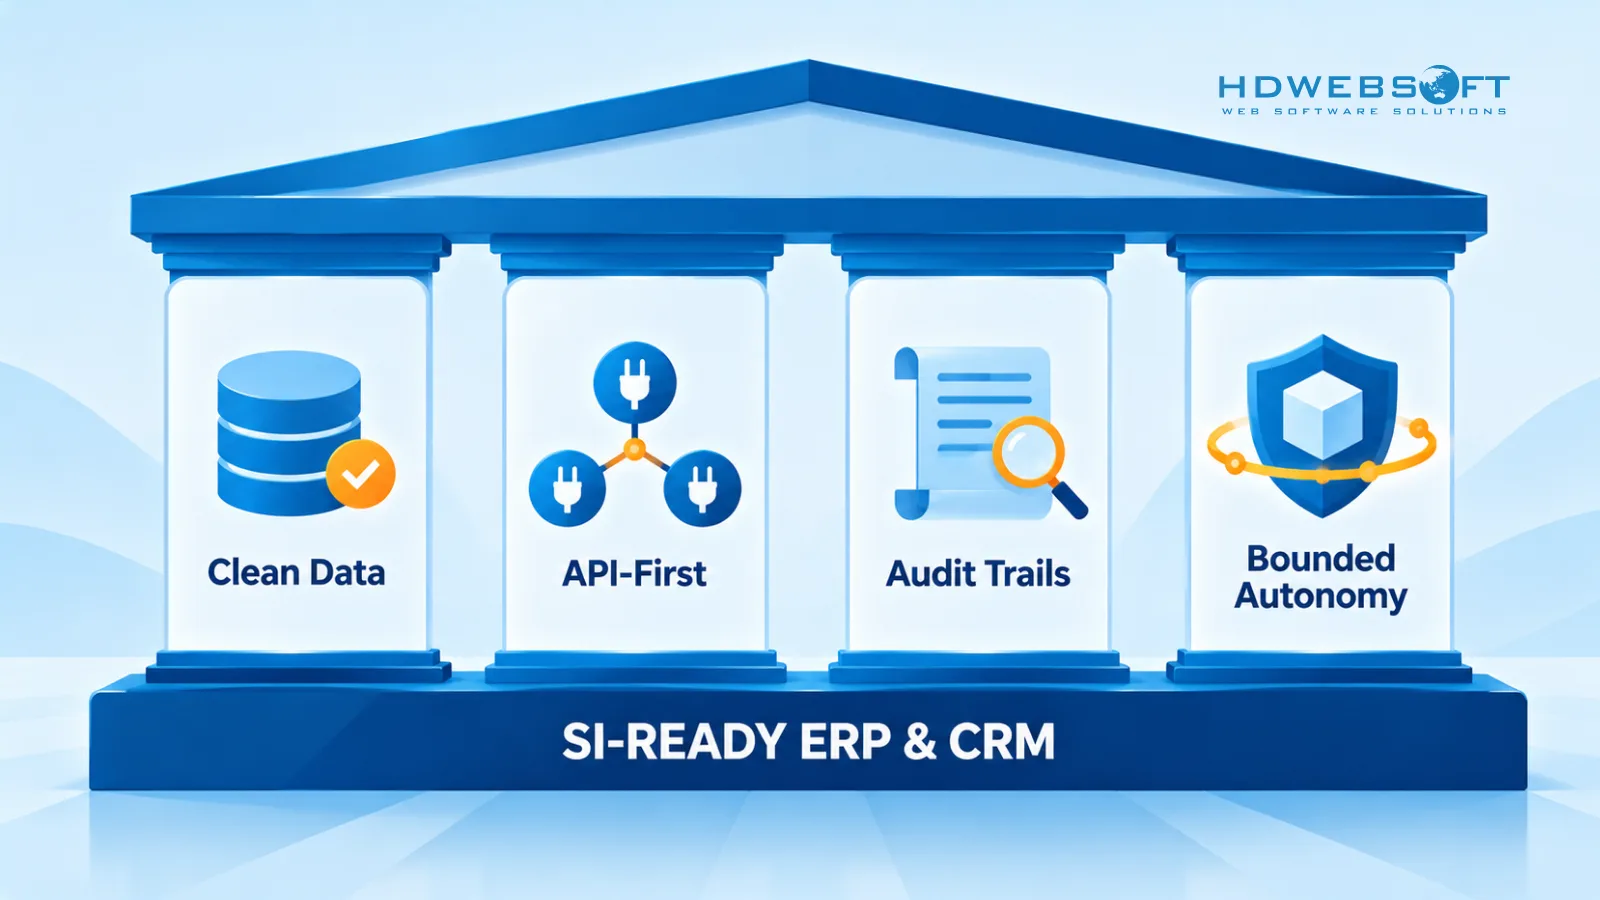
- 4つの設計柱は、クリーンな意味的データ、APIファーストかつイベント駆動の統合、機械可読の監査証跡、人間の監督を伴う制限付き自律性です。
- モダナイズ対再構築は技術的嗜好ではなくTCOと統制力の意思決定です——カスタム開発が最も強いのはデータモデルが競争資産の場合であり、万能の答えではありません。
- 対応度は未来的ではなくアーキテクチャ的なものです。SI対応への一歩一歩が、今日のAI統合も改善します。
ERP・CRMシステムにとって「SI対応」とは何か?
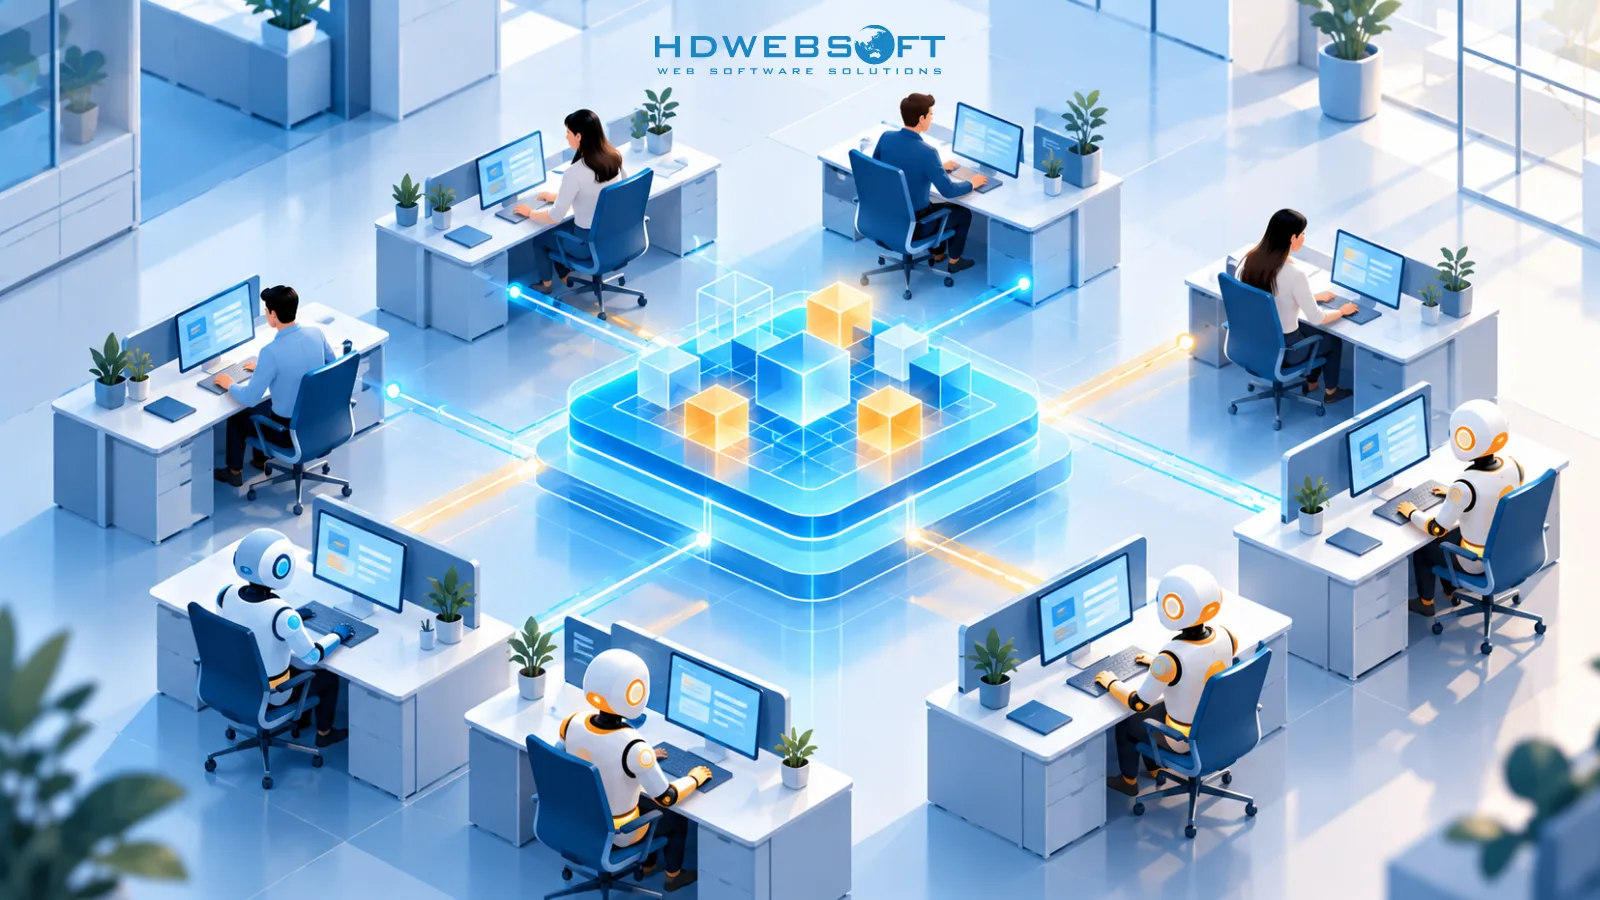
SI対応システムとは、AIエージェントを正当な運用ユーザーとして扱うエンタープライズの記録システムです——本来別の誰かが見るはずの画面を読むプラグインではありません。具体的には、システムが3つの条件を同時に満たすことを意味します。エージェントがデータの意味を理解でき、呼び出し可能な機能を通じてビジネスに作用でき、行ったすべての変更について説明責任を果たせることです。
混同されがちな2つの概念を分けると役立ちます。AI対応は今日ほとんどのベンダーが売っているものを指します。コパイロット、予測機能、埋め込みアシスタントをサポートするシステム——真のオペレーターである人間に助言するツールです。SI対応はさらに先の条件を指します。エージェントが自律的で複数ステップの作業を担うようになっても、システムが操作可能・監査可能・安全であり続け、エージェントの能力が今日は完全に特定できない水準へ進んでもそれを維持する状態です。
正直な留意点があります。「SI対応」は将来を見据えたアーキテクチャ上のアプローチであり、確立された技術標準や認証ではありません。それを定義する業界団体はなく、認定済みのSI対応ERPを売れるベンダーもいません——人工超知能そのものが存在しないのです。この用語が有用に捉えるのは設計の方向性です。エージェントが本物の仕事を要求してきたときに解体せずに済むようなシステムを作ることです。
実際にその方向性を定義する5つの特性があります:
- 意味的にモデル化されたデータ — エンティティ、フィールド、関係が単なる保存形式ではなく機械可読な意味を持ちます。
- 呼び出し可能な機能 — すべての業務操作がAPI経由で公開され、画面の中に閉じ込められていません。
- イベント駆動の統合 — 起きたことを起きた瞬間に発行し、真実を夜間バッチ同期にまとめません。
- 機械可読の監査証跡 — すべての状態変化が、誰が・なぜ・どのデータに対して行動したかを記録します。
- 制限付き自律性 — 権限階層と承認ゲートが、エージェントが人間なしで何をしてよいかを定義します。
ERPとCRMはより広いスタックのアプリケーションレイヤーに位置します。モデルゲートウェイ、オーケストレーションレイヤー、エンタープライズデータプラットフォームとの位置関係を整理しているなら、私たちのエンタープライズ超知能アーキテクチャのブループリントが全体像をカバーしています。本記事は、実際にビジネスが動いている2つのシステムに焦点を絞ります。
なぜレガシーERP・CRMアーキテクチャは高度なAIを阻むのか
レガシーERP・CRMシステムは1つの前提を中心に設計されました。データとすべての意思決定の間に人間が座るという前提です。インターフェースは人が読むレコードを提示し、フォームは人が入力するものを集め、ワークフローは人が従う手順をエンコードします。その前提は20年間よく機能しました——そして、エージェントが代わりに仕事をしようとした瞬間に壊れるものでもあります。
ほぼすべてのレガシー環境に4つの構造的ボトルネックが現れます:
- サイロ化し未文書化のデータ。 同じ顧客がモジュール間で5つの微妙に異なるレコードとして存在します。
CUST_STAT_CDのようなフィールドは、どの文書にも記録されない部族的知識を担っています。人間は経験で補いますが、エージェントにはできません。 - UIに埋もれたビジネスロジック。 「5万ドル超の注文は財務承認が必要」というルールは、フォームスクリプトやストアドプロシージャにあり——エージェントが呼び出せるサービスにはありません。そのロジックを実行する唯一の方法は、ユーザーが画面をクリックする様子をシミュレートすることです。
- ポイントツーポイント統合。 何十年もの特注コネクタにより、データは遅れて届き、異なる形で届き、あるいは届きません。現在の在庫・未処理注文・顧客ステータスを同時に必要とするエージェントは、3つの不整合なスナップショットにぶつかります。
- 機械可読な説明責任の欠如。 監査ログは存在してもレコードが変わったことしか記録せず——誰が変更を承認したか、どんな推論が先行したか、どのデータが根拠になったかは記録しません。人間には「何が起きたか」に答えますが、「なぜ起きたか」には誰にも答えられません。
| レガシーパターン | エージェントの失敗モード |
|---|---|
| 部族的意味論を持つ未文書化フィールド | エージェントがデータを誤解し、間違った前提で——自信満々に——行動する |
| フォームロジックに閉じ込められたビジネスルール | エージェントが制御を迂回するか、人間セッションを偽装して起動せざるを得ない |
| モジュール間の夜間バッチ同期 | エージェントが古く不整合なスナップショットで判断する |
| 推論コンテキストのない変更ログ | 監査が失敗する:エージェントがなぜそうしたのか誰も再構成できない |
| UI権限が唯一のアクセス制御 | エージェントが広範な人間特権を継承する——または完全にブロックされる |
これらすべての根底にあるパターン:システムの知識と機能は人間型のインターフェース経由でしかアクセスできません。ここでエージェントが失敗するのは知性が足りないからではありません。必要なもののどれもが機械からアクセス可能でないからです。
SI対応ERP・CRMアーキテクチャの中核設計原則
4つの設計原則が、記録保持システムをエージェントが真に運用できるシステムへ変えます。どれもより賢いAIを待つ必要はありません——今日の統合でも成果を出します。
クリーンで意味的にモデル化されたデータ
エージェントが消費するのはバイトではなく意味です。SI対応データレイヤーは、顧客・注文・請求書・契約・ケースといった中核エンティティそれぞれに、モジュール間で共有される単一の正準定義を与えます。フィールドには明示的な意味論が付きます。値の意味、使う単位、有効な状態、他エンティティとの関係です。
実務では、誰も読まないWikiではなくデータと一緒に生きる統制されたビジネス用語集を維持することを意味します。フィールドレベルの説明、業務的意味を持つ列挙ステータス値、文書化された関係、各値の出自を示す系譜です。エージェントがstatus = PENDING_CREDITに遭遇したとき、システム自身のメタデータが、保留中の与信が何を意味しその状態でどのアクションが有効かを教えるべきです——そうでなければエージェントは推測し、エンタープライズ規模の推測はインシデントになります。
これは最も地味で最も重大な原則でもあります。後続のすべてのレイヤー——API、監査証跡、自律性制御——は下のデータが解釈可能であることを前提にします。データクリーンアップが地味なのは、まさに基盤だからです。
APIファースト、イベント駆動の統合
データがエージェントの読むものなら、APIはエージェントが触れるものです。SI対応システムは、意味のあるすべての業務機能——注文作成、保留解除、リード評価、返品承認——を、明示的な入出力と権限を持つガバナンスされたエンドポイントとして公開します。有用なテストがあります。訓練された従業員が実行できる操作はすべて、ユーザーインターフェースをシミュレートせずにAPI面経由で実行可能であるべきです。
同じくらい重要なのは変更の伝播方法です。バッチ同期はエージェントに古いスナップショットを与えます。イベント駆動のバックボーン——注文作成、支払い受領、ケースエスカレーション、それぞれが発生と同時に発行される——は、人間が画面を見て得るのと同じリアルタイム認識をエージェントに与えます。エージェントはテーブルをポーリングする代わりにイベントストリームを購読します。これは速いだけでなく、インフラコストも劇的に安くなります。
新興標準がここでの統合コストを下げています。例えばModel Context Protocol(MCP)は、エージェントが外部ツールやデータソースを発見し呼び出す統一方法を定義します。MCPが何をし何をしないか正確であることは重要です。標準化するのはエージェントとシステムの会話——ツール発見、機能記述、呼び出し形式です。あなたのAPI、認可モデル、業務バリデーションを置き換えません。それらはあなたが設計するものです。MCPはよく設計されたAPI面をエージェントが消費可能にしますが、そもそも機能が呼び出せないシステムを救うことはできません。
機械可読の監査証跡
エージェントがレコードを変更したとき、「誰かがこのフィールドを更新した」はもう十分なログエントリではありません。SI対応の監査証跡は、すべての状態変化について完全な証拠チェーンを、機械——そして監査人——が照会できる形で記録します:
- 行為者 — どのエージェント、サービスアカウント、人間が、誰の権限の下で行動したか
- アクション — 実行された操作、その入力と結果としての状態変化
- 根拠 — トリガーとなったイベント、それを正当化したポリシーまたは推論経路、取得した人間の承認
- 触れたデータ — 書き込まれたものだけでなく、意思決定のために読まれたレコード
- 可逆性 — そのアクションをどう取り消せるか、すでに取り消されたか
これは新しい発明ではありません——金融・医療システムは何十年も同等の証拠チェーンを求めてきました。変わるのは行為者です。証跡は、人間の監査人だけでなく監督システムがエージェントの行動を継続的に評価できるよう構造化される必要があります。これらの監査メカニズムは、ポリシー適用・監督レベル・インシデント対応からなるより広い説明責任スタックに直接接続します——超知能ガバナンスで扱っています。
制限付き自律性と人間の監督
最後の原則は、エージェントが単独でできることと、依然として人間を要するものの線を引きます。制限付き自律性とは、権限が「エージェントアクセス:あり/なし」の二値ではなく、結果の階層として表現されることを意味します:
- 階層0 — 読み取りと推奨。 エージェントが分析・下書き・提案し、人間が実行します。今日のほとんどの導入に適しています。
- 階層1 — 可逆的で影響の小さいアクションを実行。 非財務フィールドの更新、ケースの割り振り、スケジューリング——即時ロールバック付き。
- 階層2 — 範囲限定の財務アクションを実行。 しきい値までの返金発行、定義済み範囲内での注文調整——上限超過時は承認が必要。
- 階層3 — 必須承認付きで影響の大きいアクションを実行。 契約変更、支払い解放、マスターデータ変更——エージェントが準備し、人間が署名します。
各階層はアーキテクチャ的に強制されます——エージェントへの指示ではなくAPI認可レイヤーにおいて——。そのためエージェントの範囲拡大は意図的なガバナンス上の決定であり、創発的な振る舞いではありません。しきい値はプロンプトに埋めるのではなく、ビジネスがレビューする設定に置くべきです。
AIエージェントはSI対応ERP・CRM内でどう動作するか
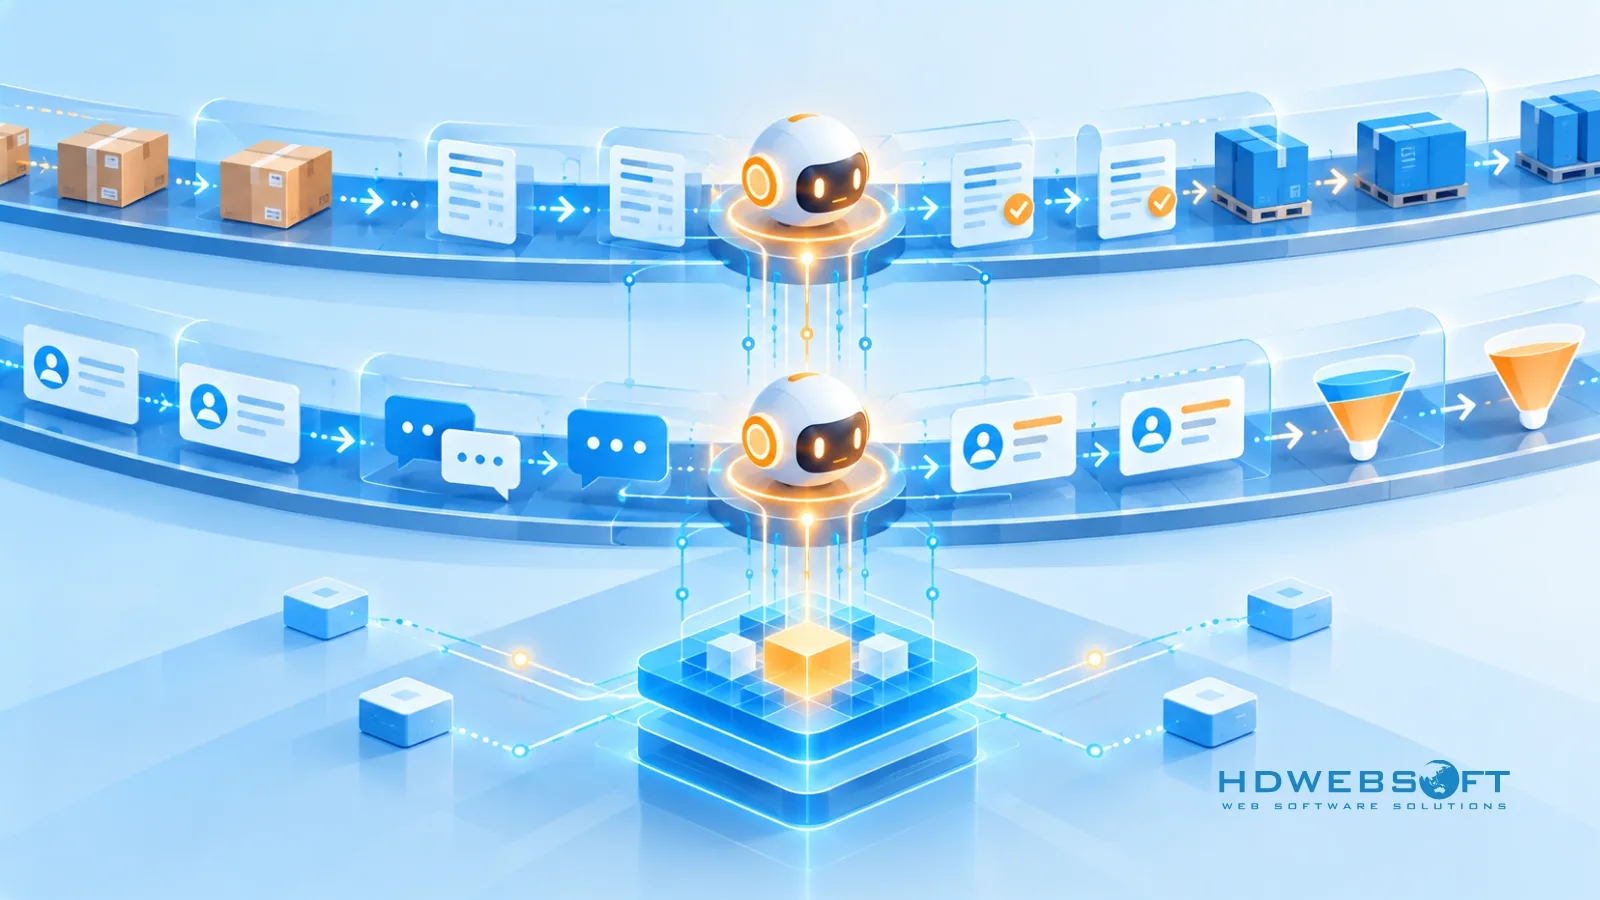
抽象的原則は具体的なワークフローでより実感が湧きます。よく設計されたSI対応基盤の上では、運用パターンは一貫しています。エージェントがイベントを読み、クリーンなデータ上で推論し、APIを通じて行動し、機械可読の痕跡を残し、アクションが自らの階層を超えるたびにエスカレーションします。異なるのはドメインです。
ERP側では、最も価値の高い初期ワークロードはシステム間照合に埋もれているものです:
- 受注から入金までの監視 — エージェントが注文イベントを監視し、出荷済み・請求済み・支払済みの間の不一致を検出し、証拠を添えた状態で照合ケースを開きます。
- 在庫リバランス — 需要シグナルと在庫イベントが提案移動オーダーをトリガーします。リスクしきい値未満なら自動実行、超過なら承認キューに入ります。
- ベンダー照合 — エージェントが請求書・入荷・発注条件を継続的に突き合わせ、人間が月末に探し回る例外にフラグを立てます。
CRM側では、パターンは照合から進行へ——人間が気づくのを待たずに顧客向けの仕事を前へ進める形に変わります:
- リード評価と割り振り — エンゲージメントや企業属性イベントが、スコアリング・強化・割り当てを数日ではなく数秒でトリガーします。
- ケースのトリアージ — 着信ケースが分類・重複排除・コンテキスト組み立て済みで割り振られ、人間はキューではなくケースを受け取ります。
- 見積もり生成 — エージェントが価格ルールと案件コンテキストから見積もりを下書きし営業が承認。半日の作業がレビューに圧縮されます。
これは大手ベンダーがすでに進んでいる方向です。SAP Business AIのようなプラットフォームは、サービス解決・請求書照合・サプライチェーン監視のエージェントをスイート内に組み込んでいます。しかしベンダーのエージェントはベンダーのデータモデル内で、ベンダーの境界内で動作します。あなたのワークフロー・データ意味論・自律性ルールがプラットフォームのデフォルトと異なる場合——通常は異なります——そのギャップはカスタムCRM開発の論拠になります。エージェントが触れられるフィールド・アクション・承認階層を、ベンダーの想定への後付けではなく、あなたのプロセスに合わせて設計するアプローチです。
モダナイズ、拡張、それとも再構築?道の選び方
エージェント対応の名の下にERPとCRMを丸ごと置き換えられる——あるいは置き換えるべき——企業はほとんどありません。現実的な決定はスペクトラム上にあり、正しい位置はあなたのデータモデル、統合資産、プロセスロジックのどれだけが本当に差別化要因かに依存します。
| 道 | 意味 | 最適なケース | 注意点 |
|---|---|---|---|
| 改修 | レガシーシステムをAPI、イベントエミッター、ロギングレイヤーで包む | データモデルが健全。予算とリスク許容度が低い | 浅いラッパーは機能ではなくフィールドを公開するだけ——ロジックは閉じ込められたまま |
| 拡張 | コアを維持し、エージェント向けドメイン用のSI対応モジュールを横に構築 | コアは安定だが特定ドメインが今すぐエージェント運用を必要とする | 2つのアーキテクチャスタイルを維持。境界には規律が必要 |
| 再構築 | 初日からエージェントが運用できるよう設計されたカスタムシステムでコアを置き換える | データモデルが競争資産。ベンダー制約が必要な自律性を阻む | 最も高いコストと移行リスク。持続的差別化がある場合のみ正当化 |
熱意より誠実な評価が大事です。カスタム開発は自動的に最善の答えではありません——特定の条件下で最善になります。プロセス意味論がスイートの得意なモデル化と乖離しているとき、エージェントが推論するデータモデルを直接制御する必要があるとき、ベンダーロードマップが戦略に必要な機能を閉じ込めているときです。実際に決定を左右する比較基準は、5〜10年の総所有コスト、エージェントのユースケースが要求する統合の深さ、稼働中運用への移行リスク、そしてベンダープラットフォームが自律性階層に課す天井です。
再構築の道を行く組織にとって、カスタムERP開発はSI対応に向けた決定的な優位をもたらします。データモデル、API面、イベントバックボーン、監査スキーマが一貫した全体として設計されるからです——ベンダーのアーキテクチャと事後交渉するのではありません。ただし同じ誠実さは逆方向にも適用されます。スイートがすでに必要な90%をカバーしているなら、拡張する方が賢いエンジニアリング判断です。
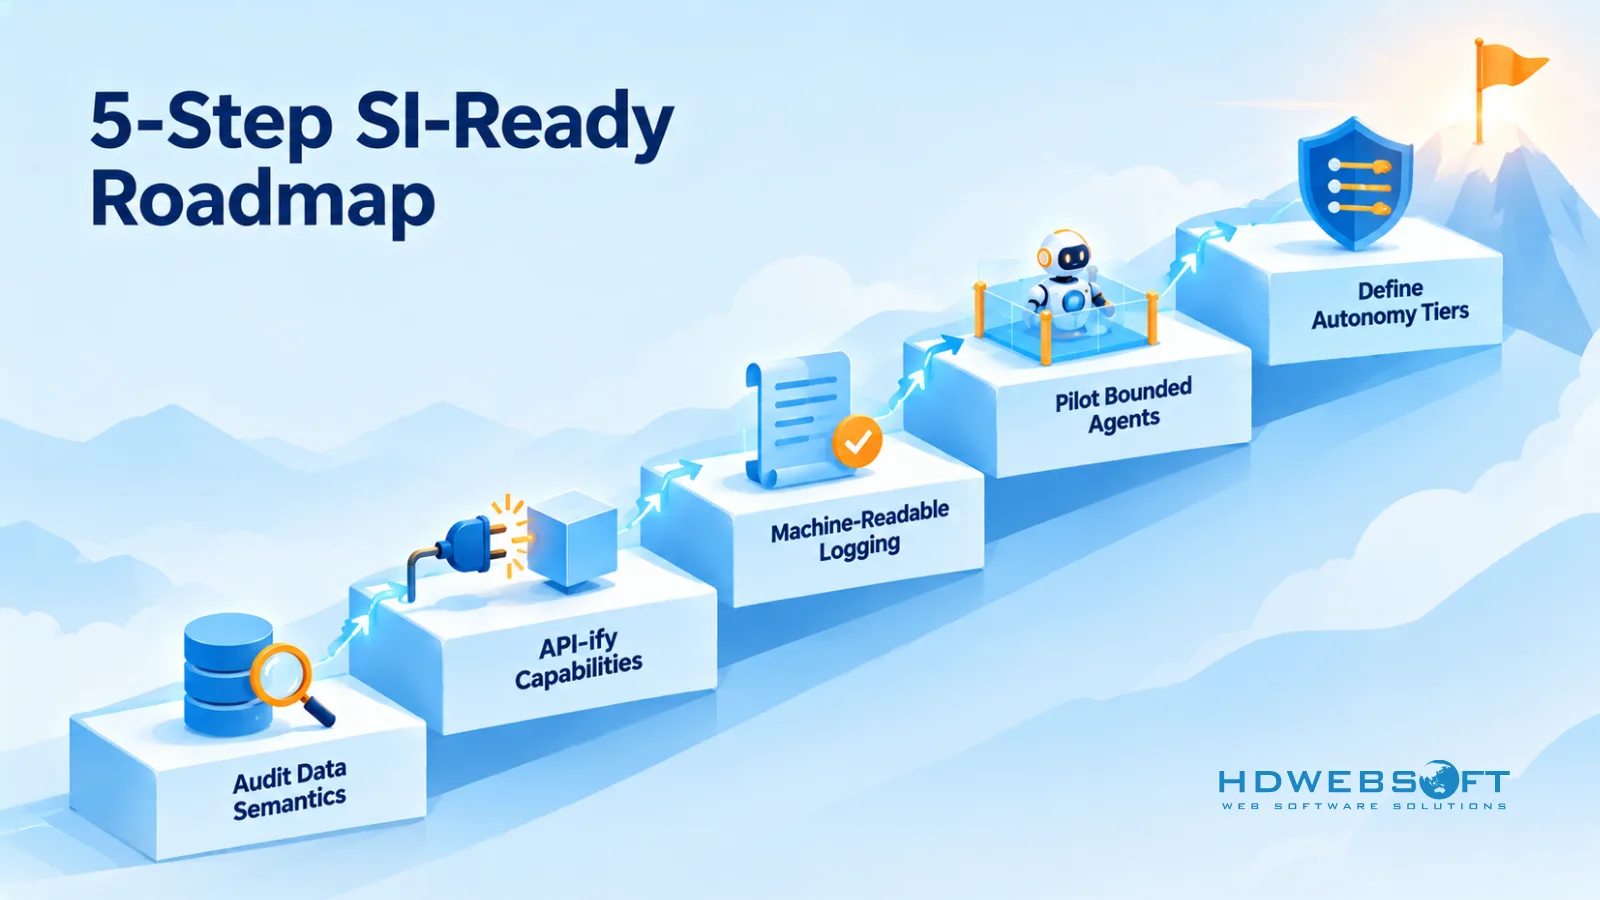
自律型AIに向けてビジネスシステムを準備する方法:5ステップのロードマップ
AI導入とAI対応のギャップはすでに測定可能です。McKinseyのState of AI 2025によると、ほとんどの組織が少なくとも1つの業務機能でAIを使う一方、過半数がスケーリングではなくパイロットに留まり——阻害要因は圧倒的にモデル能力ではなくデータ・ワークフロー・ガバナンスの基盤です。以下の5ステップはまさにその基盤を攻め、それぞれが超知能がいつ——あるいはそもそも——来るかに関わらず価値をもたらします。
- データ意味論を監査する。 中核エンティティ——顧客、注文、製品、ケース——を棚卸しし、それぞれに問います。単一の定義はあるか?フィールドの意味は文書化されているか?並行モジュールは一致しているか?アウトプットはギャップのリストで、多くの場合、以前のAIパイロットが停滞した理由を説明します。
- 重要機能をAPI化する。 エージェントが最初に必要とする10個の操作——初期ユースケースにあるもの——を選び、ガバナンスされ文書化されたエンドポイントとして公開します。すべてを包む必要はありません。最も価値の高い面を呼び出し可能にすればよいのです。
- 機械可読ログを展開する。 最初にAPI化したドメインに、上で述べた行為者-アクション-根拠-データのチェーンを計装します。アクションの理由を再構成できないなら、自動化するには安全ではありませんでした。
- 範囲限定のエージェントユースケースをパイロットする。 高頻度・低リスク・完全可逆のワークフロー——ケーストリアージ、照合フラグ、下書き生成——を選びます。階層0と階層1の自律性のみ。拡大前に人間ベースラインと比較して測定します。
- 自律性階層とガバナンスを定義する。 エージェントがそれらを押し広げる前に、権限階層・承認しきい値・エスカレーション経路を正式化します。インシデントの圧力の下で書かれたガバナンスは、事前に書かれたものより常に劣ります。
順序そのものより順序の論理が重要です。意味論がAPIより先、APIがエージェントより先、ガバナンスが自律性より先。これを逆転するチーム——監査チェーンなしに未文書化データの上にエージェントを展開する——は、設計レビューではなく本番インシデントとして同じ教訓を学びます。
結論:SI対応は期限ではなく決定である
超知能がいつ——あるいはそもそも——来るかを誰もあなたに言えません。知り得ることはより狭く、より有用です。あなたのビジネスが動いているシステムは人間のオペレーター向けに設計されており、毎月、その内部の仕事のより多くが自律的に行動するソフトウェアに委任されています。SI対応ERP・CRMとは、そのオペレーターのために今設計するという決定にほかなりません——エージェントが解釈できるクリーンなデータ、呼び出せるAPI、残さなければならない監査証跡、越えられない境界。
そのアーキテクチャへの一歩一歩は即座に報われます。より良い統合、よりクリーンな移行、より安全な自動化、デモデータではなくあなたのデータで動くAI機能。自律型エージェントをスムーズに受け入れる組織は、確実性を待った組織ではありません——まだ安く済むうちに自分たちのシステムを読み取り可能にした組織です。
HDWEBSOFTは、エージェント対応性を最初から組み込んだカスタムビジネスシステムと統合を設計・構築します——AI開発サービスを通じて、企業が現在のERP・CRM環境を評価し、ここで述べた基盤を構築する支援をしています。モダナイズと再構築を比較検討しているなら、まさにその会話が私たちの出発点です。
FAQ
SI対応ERPシステムとは何ですか?
SI対応ERPシステムとは、自律型AIエージェントが安全に内部で動作できるよう設計された基幹業務プラットフォームです。クリーンで意味的に文書化されたデータ、すべてAPI経由で呼び出せる機能、あらゆる変更に対する機械可読の監査証跡、そして人間の監督ゲートを備えた制限付き自律性を備えます。認定標準ではなく、将来を見据えたアーキテクチャ上のアプローチです。
既存のERP・CRMプラットフォームはSI対応になれますか?
部分的には可能です。既存プラットフォームは、データモデルの整理、APIやイベント経由での機能公開、機械可読ログの追加によりSI対応に近づけられます。ただし、UI駆動のワークフローや独自ロジックを中心に構築されたプラットフォームには構造的な限界があります。改修がどこまで可能かは、データモデルと統合レイヤーへの統制力に依存します。
APIファーストとSI対応アーキテクチャの違いは何ですか?
APIファーストとは、すべてのシステム機能が明確に定義されたインターフェースを通じて公開されることです。SI対応はAPIファーストを基盤に、3つの追加要件を課します。エージェントが解釈できる意味的にモデル化されたデータ、すべてのアクションに対する機械可読の監査証跡、そして人間の承認なしにエージェントが何をしてよいかを定義する制限付き自律性の制御です。
AIエージェントのためにERP・CRMをモダナイズすべきですか、再構築すべきですか?
制約条件次第です。データモデルが健全なら改修の方が安価で低リスクです。コアの安定性を保つ必要がある場合はSI対応の新モジュールで拡張する方法が有効です。データモデルが競争優位の資産であるか、ベンダーの制約が必要な自律性を阻む場合はカスタム再構築が妥当です。決定前にTCO、統合要件、移行リスク、ベンダーロードマップの制約を比較してください。
自律型AIエージェントにはどのような監査証跡の要件がありますか?
エージェントの監査証跡は機械可読である必要があり、すべての状態変化について、どのエージェントまたは人間が行動したか、どのアクションがどういう理由で実行されたか、どのデータが読み取られ変更されたか、どのポリシーがそれを承認したか、そしてそのアクションをどうやって取り消せるかを記録します。これは監査人が金融システムにすでに求めている証拠チェーンと同じものを、人間以外の行為者へ拡張したものです。