โครงสร้างพื้นฐานข้อมูล AI องค์กรคือระบบของ pipeline, ที่เก็บข้อมูล, ดัชนี และกลไกควบคุมที่เปลี่ยนข้อมูลปฏิบัติการที่กระจัดกระจายให้เป็นรากฐานที่ระบบ AI สืบค้นได้อย่างน่าเชื่อถือ — ข้อมูลที่สดใหม่ สอดคล้องกัน มีการกำหนดสิทธิ์ และตระหนักถึงความสัมพันธ์ เมื่อโมเดลเก่งขึ้นเรื่อย ๆ จุดคอขวดใน AI องค์กรกำลังเลื่อนจากคุณภาพโมเดลไปสู่คุณภาพของรากฐานข้อมูล: ระบบ AI น่าเชื่อถือได้แค่ระดับความสดใหม่ของดัชนีและความสมบูรณ์ของการควบคุมการเข้าถึงที่มันอาศัยอยู่
บทความนี้คือการเจาะลึกเชิงเทคนิคของเลเยอร์ Enterprise Data & Knowledge ในพิมพ์เขียวสถาปัตยกรรม superintelligence องค์กร บทความนั้นนิยามโมเดลอ้างอิงหกเลเยอร์ บทความนี้ลงรายละเอียดว่าเลเยอร์ข้อมูลถูกสร้างจริงอย่างไร — ระบบปฏิบัติการป้อนข้อมูลให้ vector store และ knowledge graph เกือบเรียลไทม์อย่างไร สิทธิ์การเข้าถึงแพร่เข้าสู่ดัชนีอนุพันธ์อย่างไร และ pipeline ฟื้นตัวเมื่อล้มอย่างไร ขอชี้แจงตั้งแต่ต้น: “พร้อมสำหรับ SI” คือแนวทางสถาปัตยกรรม — โครงสร้างพื้นฐานที่ออกแบบให้ดูดซับ AI ที่เก่งขึ้นเรื่อย ๆ — ไม่ใช่มาตรฐานเทคนิคที่ได้รับการยอมรับ และไม่ใช่หลักฐานว่า superintelligence มีอยู่จริง
ประเด็นสำคัญ
- โครงสร้างพื้นฐานข้อมูลที่พร้อมสำหรับ SI คือแนวทางสถาปัตยกรรม — ข้อมูลที่ถูกกำกับ สดใหม่ ทำงานร่วมกันได้ เตรียมพร้อมสำหรับ AI ที่เก่งขึ้น — ไม่ใช่มาตรฐานที่รับรองแล้วหรือหลักฐานว่า ASI มีอยู่
- ช่องว่างระหว่างสถาปัตยกรรมข้อมูลแบบเดิมกับโครงสร้างพื้นฐานที่พร้อมสำหรับ AI อยู่ที่ด้านปฏิบัติการ: ความสดใหม่ การแพร่สิทธิ์ และการสร้างแบบจำลองความสัมพันธ์ — ไม่ใช่ความจุจัดเก็บ
- vector store กับ knowledge graph แก้ปัญหาการค้นคืนคนละอย่าง องค์กรส่วนใหญ่ต้องการทั้งคู่หลัง governed retrieval interface เดียว
- change data capture คือกระดูกสันหลังเริ่มต้นสำหรับ pipeline เพื่อ AI; ดัชนีที่ล้าสมัยค่อย ๆ ลดทอนทุกระบบ AI ด้านล่างอย่างเงียบ ๆ
- สร้างทีละขั้น: หนึ่งโดเมนข้อมูล, ingestion ที่เป็นมาตรฐาน, ความสดใหม่และการควบคุมการเข้าถึงที่ตรวจสอบแล้ว — แล้วค่อยขยาย
โครงสร้างพื้นฐานข้อมูลที่พร้อมสำหรับ SI คืออะไร?
โครงสร้างพื้นฐานข้อมูลที่พร้อมสำหรับ AI ถูกสร้างให้ workload AI เป็นผู้บริโภคชั้นหนึ่ง — ไม่ใช่แค่นักวิเคราะห์กับแดชบอร์ด “พร้อมสำหรับ SI” เพิ่มขอบเขตการวางแผน: วิศวกรรมเดียวกัน แต่มีห้องเหลือพอให้รากฐานรอดจากการก้าวกระโดดของความสามารถโมเดลข้างบนโดยไม่ต้องออกแบบใหม่ มีสี่คุณสมบัตินิยามมัน:
- ความสดใหม่ (Freshness) ดัชนีอนุพันธ์อัปเดตเมื่อแหล่งข้อมูลเปลี่ยน — ไม่กี่นาทีสำหรับโดเมนร้อน ไม่ใช่ข้ามคืน ดัชนีคือสำเนา และสำเนาก็เสื่อม
- ความทำงานร่วมกันได้ (Interoperability) ผ้าใบ ingestion เดียวป้อนให้ lakehouse, vector store และ knowledge graph — ไม่ใช่ pipeline เฉพาะต่อ use case
- ความค้นพบได้ (Discoverability) metadata catalog ทำให้หา dataset เจอและพา lineage จากแถวต้นทางถึงชิ้นส่วนที่ถูก index
- การเข้าถึงที่มีการกำกับ (Governed access) สิทธิ์จากแหล่งข้อมูลแพร่ไปยังทุกสำเนาอนุพันธ์ รวมถึง embedding — ซึ่งทั้งทางกฎหมายและทางปฏิบัติคือสำเนาของข้อความ
พร้อมสำหรับ SI เทียบกับพร้อมสำหรับ AI: ความแตกต่างเชิงปฏิบัติ
| มิติ | แบบเดิม | พร้อมสำหรับ AI | แนวทางพร้อมสำหรับ SI |
|---|---|---|---|
| ผู้บริโภคหลัก | รายงานและแดชบอร์ด | โมเดล ML, แอป RAG | เอเจนต์ที่อิสระกว่า; โมเดลอนาคตที่เก่งกว่า |
| ความคาดหวังเรื่องความสดใหม่ | batch รายคืนก็พอ | เกือบเรียลไทม์สำหรับโดเมนร้อน | SLO ความสดใหม่ชัดเจนต่อโดเมน |
| การควบคุมการเข้าถึง | แยกระบบ กระทบยอดด้วยมือ | แพร่ไปยังดัชนี | บังคับตอนค้นคืน; การเพิกถอนมี audit |
| โมเดลข้อมูล | ตารางและไฟล์ | ตารางบวก embedding | บวกความสัมพันธ์ชัดเจนและ semantic layer |
ข้อเตือนใจอย่างตรงไปตรงมา: ไม่มีอะไรในคอลัมน์ขวาได้รับการพิสูจน์ว่าจำเป็นสำหรับ superintelligence — ความสามารถนั้นไม่มีอยู่ แนวทางนี้ปกป้องได้เพราะทุกคุณสมบัติให้ผลกับระบบ AI ปัจจุบัน ไม่ว่าอะไรจะมาถึงภายหลัง
ทำไมสถาปัตยกรรมข้อมูลองค์กรแบบเดิมจึงล้มเหลวกับ AI
คลังข้อมูลองค์กรถูกสร้างมาเพื่อผู้บริโภคอีกแบบหนึ่ง รูปแบบความล้มเหลวห้าอันปรากฏซ้ำเมื่อ AI กลายเป็น workload ชั้นหนึ่ง:
- ความสดใหม่แบบวิเคราะห์ไม่ใช่ความสดใหม่แบบปฏิบัติการ ETL รายคืนสร้าง warehouse ที่ถูกต้อง ณ เมื่อวาน — ดีสำหรับแดชบอร์ดเช้าวันจันทร์ ผิดสำหรับผู้ช่วย AI ที่ตอบคำถามปฏิบัติการตอนบ่ายสาม
- สิทธิ์ไม่แพร่ตาม ระบบต้นทางมี ACL ระดับแถวและระดับออบเจ็กต์; สำเนาอนุพันธ์ — รวมถึง embedding — มักไม่สืบทอดอะไรเลย ทิ้งระบบ AI ที่ดึงเนื้อหาที่ผู้ร้องไม่มีสิทธิ์เห็นได้
- ความสัมพันธ์เป็นเพียงนัย คลังเชิงสัมพันธ์บันทึกเอนทิตี; ความสัมพันธ์ที่สำคัญอยู่ใน foreign key ที่ไม่เคยถูกออกแบบมาให้ไขว่คว้า หรืออยู่ในหัวคน
- หนึ่ง pipeline ต่อผู้บริโภค use case AI ใหม่แต่ละอันได้การสกัดเฉพาะของมัน และทุกสำเนาของข้อมูลเดียวกันค่อย ๆ แยกจากกันเงียบ ๆ
- ไม่มีสัญญาความสดใหม่ ไม่มีใครบอกได้ว่าดัชนีเก่าแค่ไหน — จึงไม่มีใครไว้คำตอบที่สร้างบนมันได้เต็มที่
สังเกตว่าสิ่งเหล่านี้คือความล้มเหลวของการนำไปใช้ ไม่ใช่คำถามของการประเมิน ว่าคลังข้อมูลของคุณพร้อมหรือไม่เป็นอีกปัญหาหนึ่ง — คู่มือความพร้อมข้อมูล AIของเราครอบคลุมด้านการประเมิน บทความนี้สมมติว่าประเมินเสร็จแล้วและครอบคลุมสิ่งที่คุณสร้างต่อไป
ส่วนประกอบหลักของโครงสร้างพื้นฐานข้อมูล AI องค์กร
กระดูกสันหลังจัดเก็บข้อมูล
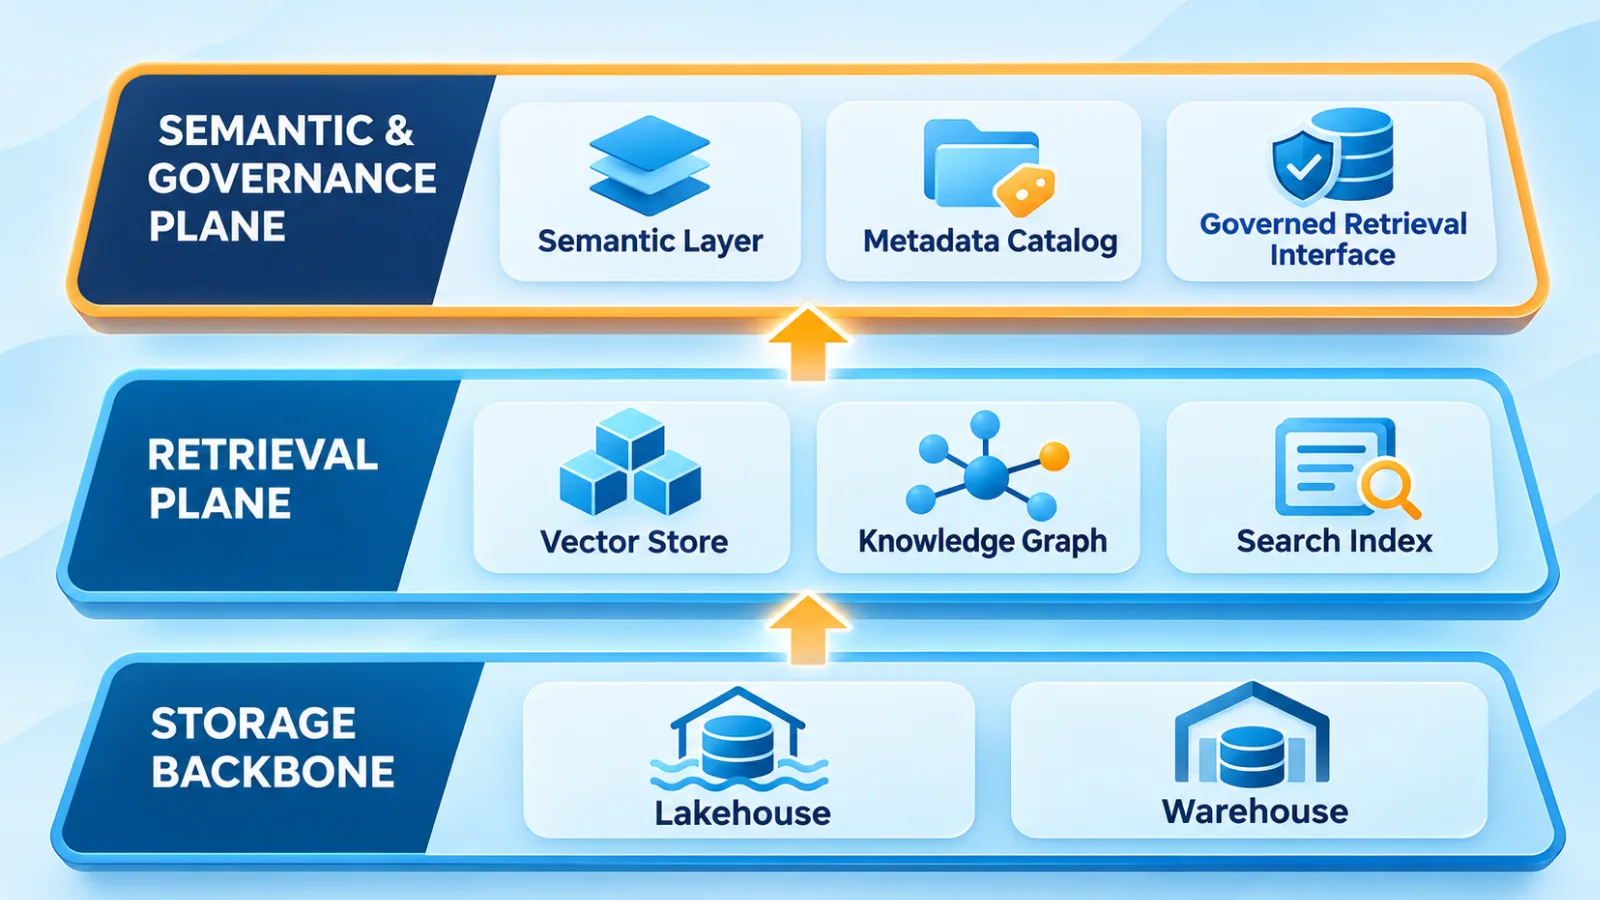
กระดูกสันหลังคือ lakehouse — รูปแบบตารางเปิดบน object storage — เสริมด้วย warehouse สำหรับ mart ที่กำกับแล้ว ข้อมูลเข้ามาดิบ ๆ ถูกตรวจสอบและทำความสะอาด แล้วปรับเป็นโมเดลโดเมน คุณสมบัติกำหนดของมันสำหรับ AI ไม่ใช่ความจุแต่คือความกู้คืนได้: กระดูกสันหลังคือสถานะบัญญัติที่ทุกที่เก็บอนุพันธ์สร้างใหม่ได้ เมื่อดัชนีพังหรือโมเดล embedding ถูกเปลี่ยน กระดูกสันหลังทำให้การกู้คืนเป็นการ replay แทนที่จะเป็นปฏิบัติการกู้ภัย
ระนาบการค้นคืน
ที่เก็บอนุพันธ์สามแบบให้บริการรูปทรงคำถามสามแบบ:
- Vector store embedding บวกการอ้างอิงชิ้นส่วนสำหรับการค้นคืนเชิงความหมายบนเนื้อหาไม่มีโครงสร้าง
- Knowledge graph เอนทิตีและความสัมพันธ์มีชนิดสำหรับการไขว่คว้าและคำถามหลายขั้น
- Search index การค้นคืนคำสำคัญและ metadata ยังเป็นเครื่องมือที่ถูกสำหรับตัวระบุตรง ๆ และตัวกรองเชิงโครงสร้าง
กฎออกแบบที่ทำให้ระนาบนี้แข็งแรง: ที่เก็บอนุพันธ์เป็นของใช้แล้วทิ้ง มันไม่เคยถูกเลื่อนเป็นแหล่งความจริง ไม่สะสมสถานะที่คำนวณใหม่ไม่ได้ และไม่รับการเขียนที่เลี่ยงสายข้อมูลเปลี่ยนแปลง
ระนาบเชิงความหมายและการกำกับ
เหนือการจัดเก็บและการค้นคือเลเยอร์ที่ทำให้ระบบเป็นหนึ่งเดียว: semantic layer ที่พาคำนิยามธุรกิจและตรรกะเมทริกซ์ metadata catalog สำหรับการค้นพบและ lineage และ governed retrieval interface — API เดียวที่แอป AI สืบค้นผ่าน interface นั้นยืนยันตัวผู้เรียก ใส่ตัวกรองสิทธิ์ บังคับข้อจำกัดความสดใหม่ และบันทึกทุกการเข้าถึง interface คือประตูเดียว — และนั่นคือเหตุผลที่การกำกับบังคับใช้ได้จริงแทนที่จะเป็นแค่ความปรารถนา
Vector Database เทียบกับ Knowledge Graph: เมื่อไหร่ใช้อันไหน
ที่เก็บสองแบบนี้เสริมกัน ไม่ใช่แข่งกัน ความสับสนเกิดเพราะทั้งคู่ถูกขายเป็น “เลเยอร์ความจำสำหรับ AI” — แต่มันตอบคำถามคนละอย่าง
| มิติ | vector database | knowledge graph |
|---|---|---|
| เก็บอะไร | embedding ของชิ้นเนื้อหา พร้อมอ้างอิงเอกสารต้นทาง | เอนทิตีและความสัมพันธ์มีชนิด (ขอบ) |
| รูปแบบคำถาม | ความคล้ายเชิงความหมาย — “หาสิ่งที่คล้ายสิ่งนี้” | การไขว่คว้า — “สิ่งเหล่านี้เชื่อมกันอย่างไร” |
| จุดแข็ง | ข้อความไม่มีโครงสร้าง; การจับคู่คลุมเครือเชิงความหมาย; การค้นคืน ANN ระดับใหญ่ | การให้เหตุผลหลายขั้น; เส้นทางอธิบายได้; ตัวตนเอนทิตีเสถียร |
| ข้อจำกัด | ไม่มีความสัมพันธ์ชัดเจน; ผลลัพธ์ทึบ; embedding คลาดเมื่อโมเดลเปลี่ยน | ต้นทุนสร้างแบบจำลองตอนต้น; ซิงก์ยากกว่า; graph เบาบางทำงานแย่ |
| กลไกอัปเดต | re-chunk และ re-embed เมื่อต้นทางเปลี่ยน; การลบแพร่เป็น tombstone | upsert ขอบทีละส่วน; เปลี่ยน topology ใหญ่ก็ replay จาก event |
| การใช้ในองค์กรทั่วไป | นโยบาย, ticket, เอกสาร, ฐานความรู้ | ห่วงโซ่อุปทาน, โครงสร้างองค์กร, ลำดับข้อมูล, แผนที่การพึ่งพา |
เลือก vector store เมื่อคำถามคือ “หาเนื้อหาที่เกี่ยวข้อง” — กรณีองค์กรที่พบมากที่สุด ซึ่งเป็นเหตุที่ดัชนี vector ถูกติดตั้งก่อน เลือก graph เมื่อคำถามคือ “ไล่ตามความสัมพันธ์” — ผลกระทบการพึ่งพา ความรับผิดชอบในองค์กร ห่วงโซ่ต้นกำเนิด คำถามจริงหลายข้อเป็นทั้งคู่: “หาเหตุการณ์ที่เกี่ยวข้องกับซัพพลายเออร์รายนี้” ต้องการการค้นคืนเชิงความหมายเพื่อหาเหตุการณ์ และการไขว่คว้า graph เพื่อกำหนดว่าความสัมพันธ์ไหนนับเป็น “เกี่ยวข้อง”
จุดตัดนั้นคือที่ที่รูปแบบไฮบริดอย่าง GraphRAG ทำงาน — การค้นคืน vector กำหนดชุดผู้สมัครเริ่มต้น แล้วการไขว่คว้า graph ขยายมันและทำให้ผลลัพธ์อธิบายได้ คู่มือนักพัฒนา GraphRAG อธิบายรูปแบบการนำไปใช้หนึ่ง; ถือมันเป็นข้อมูลอ้างอิงเชิงเทคนิค ไม่ใช่การอ้างว่า vendor ใดเหมาะกับทุกองค์กร และข้อสังเกตขอบเขต: ตรรกะการประสานที่ตัดสินใจว่าจะถามที่เก็บไหนอยู่เหนือขอบเขตบทความนี้ไปหนึ่งเลเยอร์ — คู่มือสถาปัตยกรรม agentic RAGของเราครอบคลุมเลเยอร์การค้นคืนและแอปพลิเคชันนั้น
ออกแบบ Pipeline ข้อมูลแบบเรียลไทม์สำหรับ AI
ความสดใหม่เป็นคุณสมบัติของ pipeline ไม่ใช่ของที่จัดเก็บ ไม่มี vector store หรือ graph engine ไหนชดเชยข้อมูลที่มาถึงสาย — ดังนั้นการออกแบบ ingestion จึงกำหนดทุกอย่างด้านล่าง
Batch เทียบกับ CDC เทียบกับ Event Streaming
| รูปแบบ | ความหน่วงทั่วไป | ภาระบนต้นทาง | ลำดับและการตัดซ้ำ | เหมาะสุดกับ |
|---|---|---|---|---|
| batch ตามกำหนดเวลา (ETL/ELT) | ชั่วโมง | การอ่านจำนวนมากเป็นระยะ | ง่าย | ข้อมูลเย็น/อ้างอิง; backfill ครั้งแรก |
| change data capture (CDC) | วินาทีถึงนาที | ต่ำ — อ่าน commit log | ลำดับต่อคีย์ | ระบบต้นทาง: ERP, CRM, ฐานข้อมูลหลัก |
| event streaming | ใต้วินาทีถึงวินาที | ไม่มีหลังปล่อย | ลำดับต่อ partition; at-least-once | โดเมนที่ปล่อย event อยู่แล้ว; telemetry, กิจกรรม |
CDC คือกระดูกสันหลังเริ่มต้นสำหรับการซิงก์เพื่อ AI จากระบบต้นทาง การจับแบบอ่าน log อ่าน commit log ของฐานข้อมูลและเก็บ insert, update และ — สำคัญ — delete โดยไม่แตะโค้ดแอป พาเชิงความหมายของการลบที่ polling ธรรมดาพลาดหมด event streaming เหมาะกับโดเมนที่ปล่อย event ธุรกิจอยู่แล้ว; batch ยังครอบครองการโหลดครั้งแรกและข้อมูลเย็น สำหรับกลไก stream processing — windowing, join มีสถานะ, การรับประกันการส่งมอบ — เอกสารstream processing ด้วย Apache Kafka เป็นอ้างอิงเชิงเทคนิคที่มั่นคง
Incremental Indexing และการรีเฟรช Embedding
วงจรอัปเดตสำหรับดัชนี vector: เหตุการณ์เปลี่ยนมา เอกสารที่โดนถูกดึง re-chunk และเฉพาะชิ้นที่เปลี่ยนถูก re-embed แล้ว upsert ด้วย ID เอกสารเสถียร มีสองกฎที่ทำให้มันตรงไปตรงมา หนึ่ง การลบต้องแพร่เป็น tombstone — เอกสารที่ลบในต้นทางต้องออกจากดัชนีในกรอบเวลาหน่วงเดียวกัน มิฉะนั้นคุณรั่วสิทธิ์ผ่าน vector เก่า สอง เก็บเวอร์ชันโมเดล embedding ไว้กับทุกเวกเตอร์ เพื่อให้อัปเกรดโมเดลออกเป็น re-embed ทีละส่วนแทนการสร้างดัชนีใหม่ทั้งหมดที่แช่ความสดใหม่หลายวัน
การซิงก์ Knowledge Graph
ปัญหายากตรงนี้คือ entity resolution: ซัพพลายเออร์เดียวกันที่ปรากฏเป็น “Acme Corp”, “ACME Corporation” และ ID 4471 ในสามระบบต้องการตัวตนบัญญัติก่อนที่ขอบจะมีความหมาย แก้เอนทิตีตอน ingestion ใส่ upsert ขอบทีละส่วน ทำเวอร์ชันชนิดความสัมพันธ์ และ — เมื่อเปลี่ยน topology ใหญ่ — replay event แทนที่จะพยายาม diff สถานะ graph กับตาราง
ความสอดคล้องของแหล่งความจริง
writer หนึ่งตัวต่อเอนทิตีต่อโดเมน; lakehouse ถือสถานะบัญญัติ; ที่เก็บอนุพันธ์เป็นแบบสอดคล้องเมื่อสุดท้ายตามการออกแบบ เพราะความล้มเหลวในโมเดลนี้มักเงียบ — connector ที่หยุดปล่อยหน้าตาเหมือนระบบที่เงียบเป๊ะ — งานกระทบยอดเปรียบเทียบจำนวนเรคคอร์ดและ checksum ต่อกรอบเวลาเพื่อจับการคลาดตั้งแต่เนิ่น ประกาศงบหน่วงต่อโดเมนเพื่อให้ “สดพอ” เป็นตัวเลข ไม่ใช่ความรู้สึก
Retry, Replay และ Dead-Letter Queue
- consumer idempotent upsert ที่ผูกคีย์ด้วย ID เสถียรทำให้ประมวลผลซ้ำปลอดภัย — รากฐานของทุกกลยุทธ์ retry
- retry แบบ backoff ความล้มเหลวชั่วคราว — rate limit ของ API embedding, ข้อผิดพลาดเครือข่าย — retry ด้วย backoff เลขชี้กำลังก่อน escalate
- dead-letter queue ข้อความพิษไปที่ DLQ พร้อมแจ้งเตือน; เสียงดังดีกว่าหล่นเงียบ ๆ
- ความสามารถ replay เก็บ event ดิบและ offset ไว้เพื่อสร้างที่เก็บอนุพันธ์ใหม่ได้โดยไม่แตะระบบต้นทาง — คุณสมบัติที่ทำให้ที่เก็บอนุพันธ์ทิ้งได้อย่างปลอดภัย
การเฝ้าระวังความสดใหม่และความหน่วง Indexing
ติดตามความหน่วงต้นทางถึงปลายทาง (commit ต้นทางจนค้นได้ในดัชนี) ความหน่วงต่อขั้น อัตรา retry ความลึก DLQ และความครอบคลุม embedding — สัดส่วนเอกสารที่ถูก index บนเวอร์ชันโมเดลปัจจุบัน แจ้งเตือนเมื่อความหน่วงเกิน SLO โดเมน: pipeline ตายเจอง่าย แต่ pipeline ที่ยังมีชีวิตแต่ช้าสิบเอ็ดชั่วโมงคือรูปแบบความล้มเหลวที่ทำร้ายระบบ AI จริง
สถาปัตยกรรมอ้างอิง: เชื่อมข้อมูลองค์กรเข้ากับระบบ AI
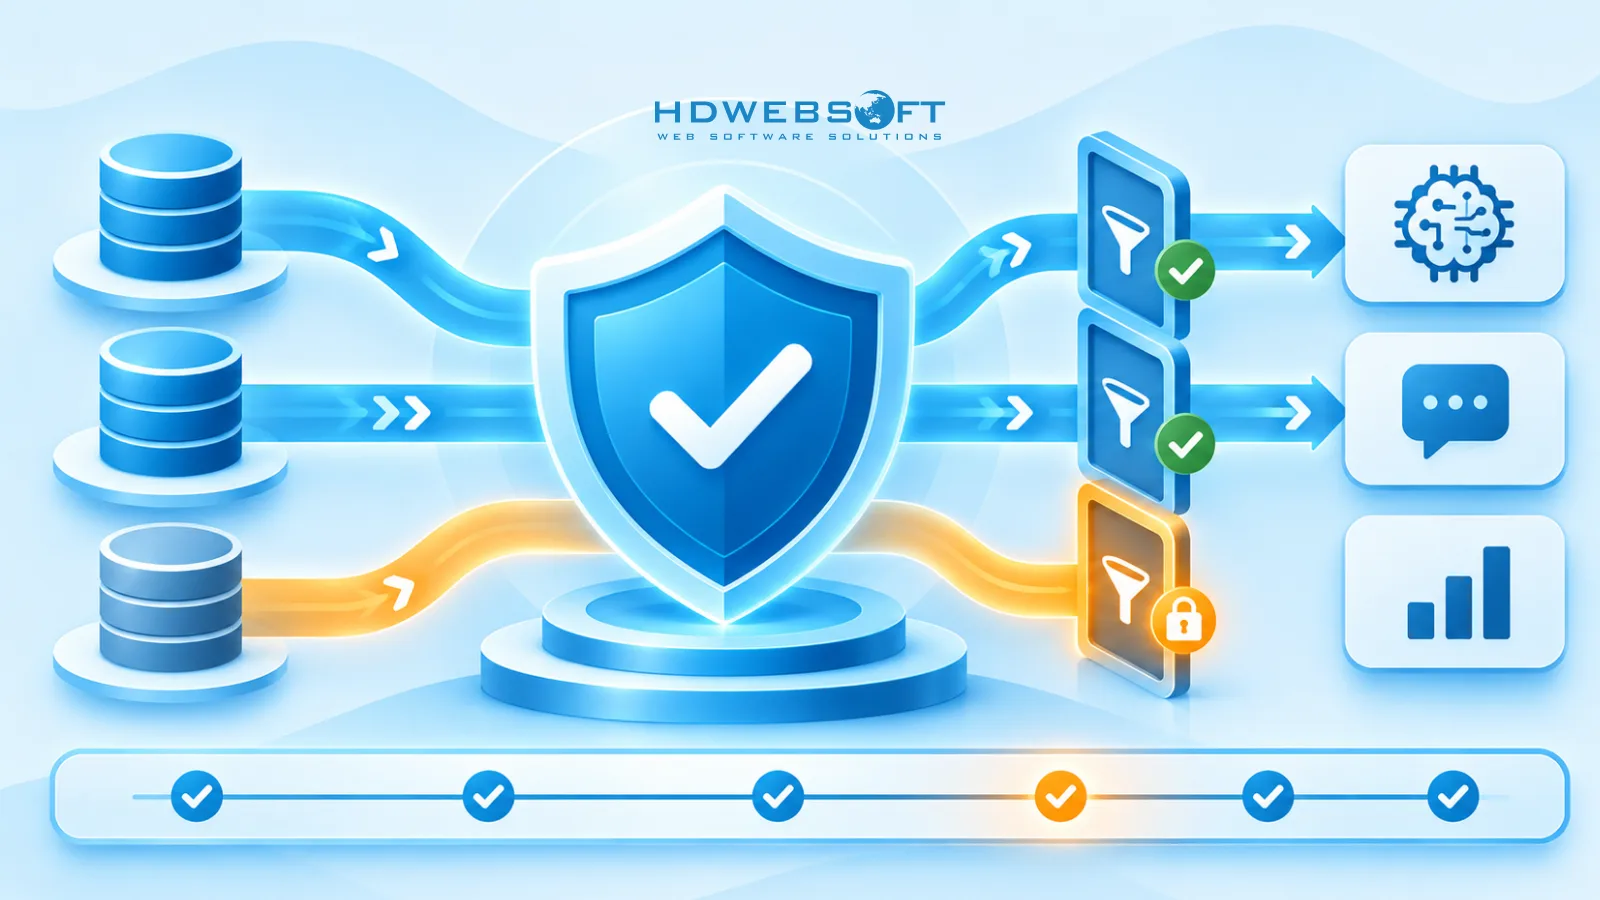
แผนภาพด้านล่างประกอบส่วนต่าง ๆ เป็นโฟลว์อ้างอิงที่ทำงาน จากแหล่งปฏิบัติการถึงการบริโภค AI ที่ถูกกำกับ
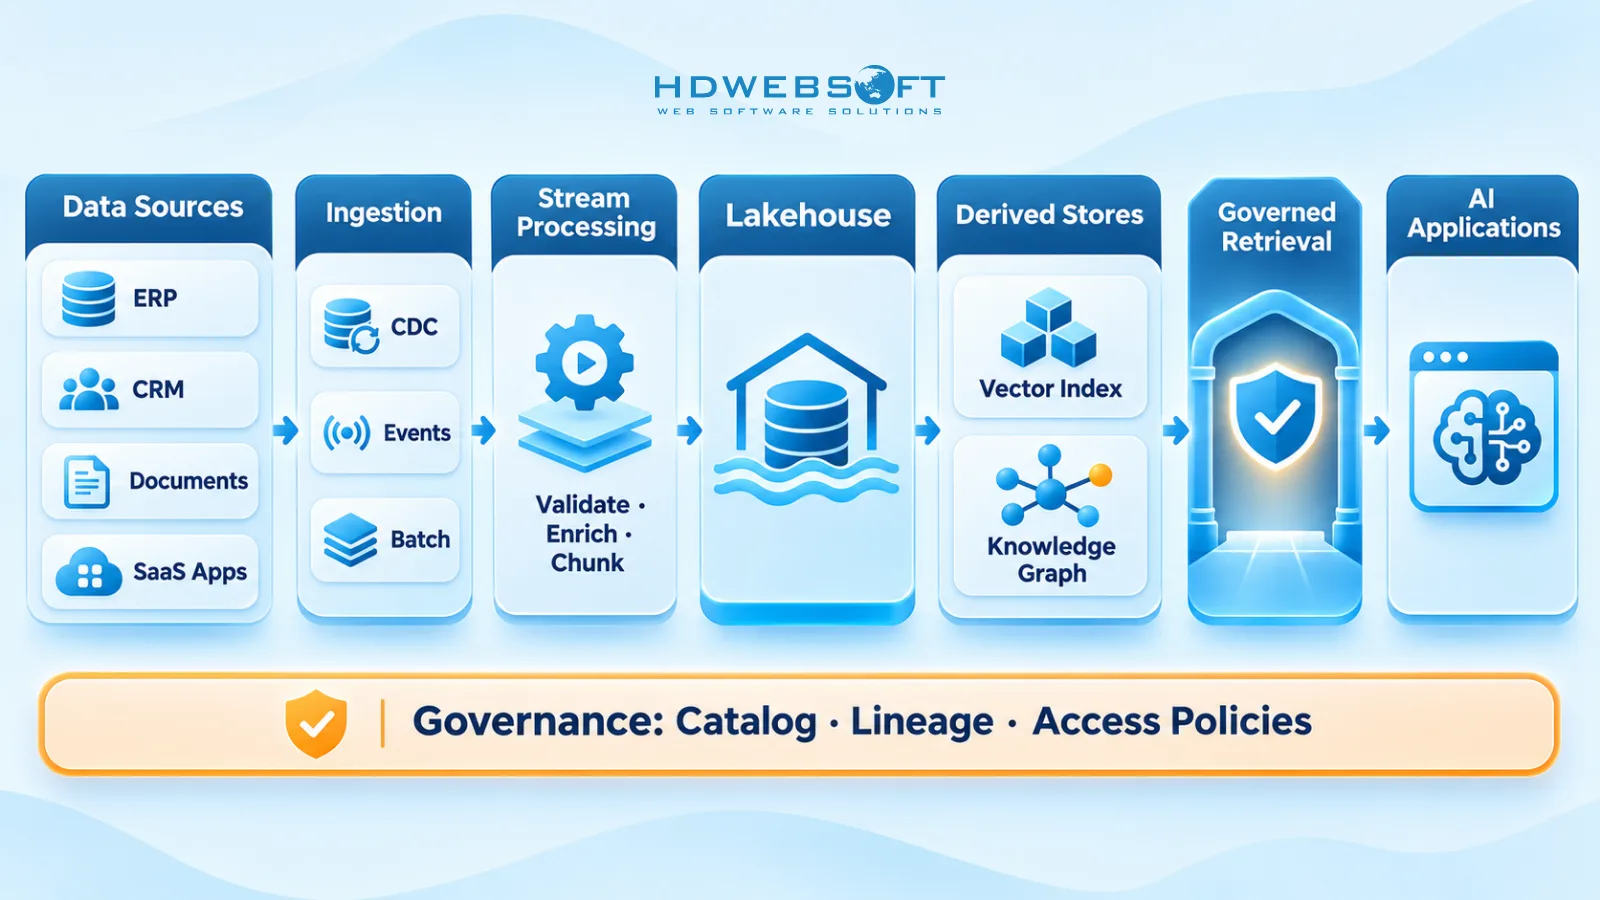
อ่านจากซ้ายไปขวา:
- แหล่งข้อมูล ERP, CRM, การจัดการเอกสาร, แอป SaaS และ warehouse เดิม
- Ingestion และการจับเปลี่ยนแปลง connector CDC บนระบบต้นทาง, event stream ตรงที่โดเมนปล่อย, ตัวโหลด batch สำหรับ backfill และข้อมูลเย็น
- Stream processing การตรวจสอบ, การเสริม, การจำแนก PII, การ chunk และ entity resolution — ขั้นที่การเปลี่ยนดิบกลายเป็นเรคคอร์ดที่ AI ใช้ได้
- Lakehouse โซนดิบ สะอาด และปรับรูปถือสถานะบัญญัติ — writer หนึ่งตัวต่อเอนทิตี
- ที่เก็บอนุพันธ์ ดัชนี vector และ knowledge graph อัปเดตทีละส่วนจากสายเปลี่ยนเดียวกันแทนการโหลดใหม่
- ระนาบการกำกับ catalog, lineage และนโยบายเข้าถึงที่ใช้ข้ามทุกขั้น — เลเยอร์ข้าม ไม่ใช่ของเสริมทีหลัง
- Governed retrieval interface ประตูเดียวสำหรับแอป AI: ยืนยันผู้เรียก ใส่ตัวกรองสิทธิ์ บังคับงบหน่วงบนโดเมนอ่อนไหว และบันทึกทุกคำถาม
สามเส้นทางซิงก์วิ่งผ่านสถาปัตยกรรมนี้ และการตั้งชื่อมันอย่างตรงไปตรงมาสำคัญ:
- เส้นทางร้อน: ต้นทาง → CDC → stream → ที่เก็บอนุพันธ์ — วินาทีถึงนาที สำหรับโดเมนที่ความเก่าทำลายการตัดสินใจ
- เส้นทางอุ่น: stream → lakehouse — นาที รักษาสถานะบัญญัติให้ทัน
- เส้นทางเย็น: batch → lakehouse → backfill ที่เก็บอนุพันธ์ — ชั่วโมง สำหรับข้อมูลอ้างอิงและการสร้างใหม่
ขอบเขตความสอดคล้อง: ที่เก็บอนุพันธ์สอดคล้องเมื่อสุดท้าย และความถูกต้องมาจาก replay บวกการกระทบยอด — ไม่ใช่จากการแกล้งว่าความหน่วงเป็นศูนย์ retrieval interface คือที่ที่ “เก่าแค่ไหนถึงเก่าเกิน” ถูกบังคับต่อโดเมน ซึ่งเป็นเหตุที่มัน — ไม่ใช่ดัชนี — คือจุดควบคุม
กำลังสร้างระบบ AI บนข้อมูลองค์กรที่กระจัดกระจายอยู่หรือ? รากฐานข้อมูลที่เชื่อถือได้ต้องการมากกว่าการต่อฐานข้อมูล ตั้งแต่ ingestion เรียลไทม์และการซิงก์ความรู้ไปจนถึงการค้นคืนที่กำกับ HDWEBSOFT ช่วยธุรกิจออกแบบโซลูชันวิศวกรรมที่เชื่อมระบบองค์กรกับแอปพลิเคชัน AI สมัยใหม่
การกำกับข้อมูล, Lineage และการควบคุมการเข้าถึง
การกำกับที่เลเยอร์นี้คือชุดของการควบคุมการนำไปใช้ ไม่ใช่เอกสารนโยบาย:
- ความเป็นเจ้าของและการลงทะเบียน ทุกโดเมนมีเจ้าของที่ระบุชื่อ; ทุก dataset ที่เข้ากระดูกสันหลังลงทะเบียนใน catalog พร้อม SLO ความสดใหม่
- การแพร่สิทธิ์ ACL ต้นทางเดินทางไปกับเนื้อหาเป็น metadata ของดัชนี; การกรองตอนค้นคืนใช้มันก่อนคืนผล embedding คือสำเนาของข้อความ — ถือมันละเอียดอ่อนเท่ากัน
- การจัดการ PII การจำแนกเกิดที่ ingestion ภายใน stream processing เพื่อให้การปิดบังหรือการยกเว้นใช้ก่อนที่เนื้อหาจะถูก embed เลย
- Lineage บันทึกว่าแถวต้นทางไหนผลิตชิ้นส่วนและ embedding ไหน โมเดล event แบบเปิด — เอกสาร OpenLineage อธิบายหนึ่งแบบ — ให้งาน pipeline ปล่อย lineage สม่ำเสมอแทนที่จะสร้างย้อนหลัง
- การเพิกถอน การเพิกถอนสิทธิ์แพร่เหมือนข้อมูล — เหตุการณ์ลบ/อัปเดตบวกการซิงก์ ACL เป็นระยะ — และมันถูกทดสอบด้วยการซ้อม ไม่ใช่สันนิษฐาน
- Audit ทุกการค้นคืนผ่าน interface ที่กำกับถูกบันทึกพร้อมตัวตนผู้เรียก ตัวกรองที่ใช้ และเวอร์ชันคลัง
- ความสดใหม่ในฐานะการกำกับ เมื่อคำตอบ AI ขับการตัดสินใจ ข้อมูลเก่าคือความเสี่ยงการปฏิบัติตาม — การเฝ้าระวังความหน่วงอยู่บนแดชบอร์ดการกำกับ ไม่ใช่แค่บอร์ด ops
แผนงานนำไปใช้จริง
ลำดับที่ได้ผลตั้งใจให้ไม่หวือหวา — ทีละโดเมน:
- เลือกโดเมนมูลค่าสูงหนึ่งโดเมน ฐานความรู้สนับสนุน แคตตาล็อกผลิตภัณฑ์ หรือระบบปฏิบัติการเดียว — ขอบเขตจำกัดที่เห็นผล
- ทำให้ ingestion ของมันเป็นมาตรฐาน CDC ถ้าแหล่งข้อมูลรองรับ; รูปแบบ pipeline นี้กลายเป็นแม่แบบของทุกอย่างต่อไป
- ตั้งระนาบการค้นคืนสำหรับโดเมนนั้น ดัชนี vector ก่อน; เพิ่ม graph เฉพาะเมื่อคำถามความสัมพันธ์คุ้มจริง ๆ
- ตรวจสอบก่อนขยาย SLO ความสดใหม่วัดบนทราฟฟิกจริง การแพร่สิทธิ์พิสูจน์ด้วยการซ้อมเพิกถอน lineage จับต้นทางถึงปลายทาง
- ขยายผ่านผ้าใบเดิม โดเมนใกล้เคียงเข้าร่วมรูปแบบ ingestion เดิม — ไม่มี pipeline เฉพาะเส้นที่สอง
เมทริกซ์ความสำเร็จที่ยึดแต่ละขั้น:
| เมทริกซ์ | สัญญาณดี |
|---|---|
| ความหน่วงความสดใหม่ต้นทางถึงปลายทาง | อยู่ใน SLO โดเมน — ต่ำกว่าห้านาทีสำหรับโดเมนร้อน |
| ความหน่วงการแพร่สิทธิ์ | เพิกถอนมีผลในนาที ตรวจสอบด้วยการซ้อม |
| ความครอบคลุมดัชนี | ประมาณ 100% ของเอกสารในขอบเขตบนเวอร์ชัน embedding ปัจจุบัน |
| ความเชื่อถือ pipeline | ความล้มเหลวชั่วคราวฟื้นเอง; ความลึก DLQ ใกล้ศูนย์ |
| คุณภาพการค้นคืนด้านล่าง | อยู่ที่เลเยอร์แอปพลิเคชัน — นอกขอบเขตบทความนี้ |
บทสรุป
ทรัพย์สินที่ทนใน AI องค์กรไม่ใช่โมเดล — มันคือรากฐานข้อมูลข้างล่าง โมเดลจะถูกเปลี่ยนหลายครั้งตลอดอายุของโครงสร้างพื้นฐานนี้; ผ้าใบ ingestion ที่เก็บอนุพันธ์ และระนาบการกำกับคือสิ่งที่อยู่รอด นั่นก็คือเหตุที่ “พร้อมสำหรับ SI” เป็นท่าทีที่ปกป้องได้มากกว่าการเดิมพันเชิงคาดเดา: ทุกคุณสมบัติที่บรรยายไว้ — ความสดใหม่ การแพร่สิทธิ์ lineage pipeline ที่ replay ได้ — ให้ผลกับ AI ที่คุณรันอยู่วันนี้ ไม่ว่าอีกห้าปีจะมีอะไรมา
เส้นทางปฏิบัติคือค่อยเป็นค่อยไป: หนึ่งโดเมน หนึ่งรูปแบบ pipeline การควบคุมที่ตรวจสอบแล้ว แล้วขยาย องค์กรที่พยายามสร้างรากฐานทั้งหมดก่อนเอา AI ขึ้นใช้งานจริงมักไม่ได้เอาอะไรขึ้นเลย บริการพัฒนา AI ของ HDWEBSOFT ครอบคลุมจุดตัดนี้พอดี — วิศวกรรมข้อมูล การบูรณาการระบบ และการส่งมอบแอป AI ถ้าคุณกำลังกำหนดขอบเขตรากฐานข้อมูลสำหรับแผนงาน AI ของคุณ ติดต่อทีมของเรา เพื่อรับคำปรึกษาทางเทคนิค
คำถามที่พบบ่อย
โครงสร้างพื้นฐานข้อมูลที่พร้อมสำหรับ SI คืออะไร?
โครงสร้างพื้นฐานข้อมูลที่พร้อมสำหรับ SI คือแนวทางสถาปัตยกรรม: โครงสร้างพื้นฐานข้อมูลองค์กรที่ออกแบบมาเพื่อรองรับระบบ AI ที่เก่งขึ้นเรื่อย ๆ มันถูกนิยามด้วยความสดใหม่ (ดัชนีอัปเดตเมื่อแหล่งข้อมูลเปลี่ยน) ความทำงานร่วมกันได้ (ผ้าใบ ingestion เดียวป้อนให้ lakehouse, vector store และ graph) ความค้นพบได้ (metadata catalog และ lineage) และการเข้าถึงที่มีการกำกับ (สิทธิ์ต้นทางแพร่ไปยังทุกสำเนาอนุพันธ์) มันไม่ใช่มาตรฐานเทคนิคที่ยอมรับแล้ว และไม่ใช่หลักฐานว่า superintelligence มีอยู่
vector database กับ knowledge graph ต่างกันอย่างไรสำหรับ AI องค์กร?
vector database เก็บ embedding ของชิ้นเนื้อหาและตอบคำถามความคล้ายเชิงความหมาย — “หาสิ่งที่คล้ายสิ่งนี้” knowledge graph เก็บเอนทิตีและความสัมพันธ์มีชนิดและตอบคำถามการไขว่คว้า — “สิ่งเหล่านี้เชื่อมกันอย่างไร” องค์กรส่วนใหญ่ต้องการทั้งคู่: vector store จัดการข้อความไม่มีโครงสร้างในระดับใหญ่ ส่วน graph ถือความสัมพันธ์ชัดเจนที่ทำให้การให้เหตุผลหลายขั้นและคำตอบที่อธิบายได้เป็นไปได้
pipeline ข้อมูล AI ควรใช้การประมวลผลแบบ batch หรือ change data capture?
ทั้งคู่ ตามอุณหภูมิของโดเมน change data capture คือตัวเลือกเริ่มต้นสำหรับการซิงก์เพื่อ AI จากระบบต้นทาง — มันอ่าน commit log แทบไม่สร้างภาระให้ต้นทาง และส่งต่อการลบอย่างถูกต้อง event streaming เหมาะกับโดเมนที่ปล่อย event อยู่แล้ว ส่วน batch ยังเหมาะกับ backfill ครั้งแรกและข้อมูลที่เย็นจริง ๆ ซึ่งความสดใหม่รายชั่วโมงหรือรายคืนยอมรับได้
ทำอย่างไรให้ vector embedding สดใหม่เสมอเมื่อข้อมูลต้นทางเปลี่ยน?
ผ่าน incremental indexing ที่ขับเคลื่อนด้วยเหตุการณ์เปลี่ยน: เมื่อเอกสารต้นทางเปลี่ยน ให้ re-chunk เอกสารนั้น re-embed ชิ้นที่เปลี่ยน และ upsert ด้วย ID เสถียร การลบต้องแพร่เป็น tombstone — เอกสารที่ลบในต้นทางต้องออกจากดัชนีในกรอบเวลาหน่วงเดียวกัน การเก็บเวอร์ชันโมเดล embedding ไว้กับทุกเวกเตอร์ให้อัปเกรดโมเดลเป็น re-embed ทีละส่วนแทนการสร้างใหม่ทั้งหมด
สิทธิ์การเข้าถึงแพร่ไปยัง vector store และ knowledge graph อย่างไร?
ACL ต้นทางถูกพาไปกับเนื้อหาเป็น metadata ของดัชนี แล้วบังคับตอนค้นคืน — governed retrieval interface ยืนยันตัวผู้เรียกและใส่ตัวกรองสิทธิ์ก่อนคืนผล การเพิกถอนแพร่เหมือนข้อมูล: เหตุการณ์ลบ/อัปเดตบวกการซิงก์ ACL เป็นระยะ ตรวจสอบด้วยการซ้อม embedding คือสำเนาของข้อความและต้องถือว่าละเอียดอ่อนเท่ากัน
องค์กรควรเริ่มสร้างโครงสร้างพื้นฐานข้อมูลสำหรับ AI จากตรงไหน?
จากโดเมนข้อมูลมูลค่าสูงหนึ่งโดเมน ทำให้ ingestion ของมันเป็นมาตรฐาน — CDC ถ้าแหล่งข้อมูลรองรับ — ตั้งระนาบการค้นคืนสำหรับโดเมนนั้นเพียงอย่างเดียว และตรวจสอบความสดใหม่ การแพร่สิทธิ์ และ lineage ต้นทางถึงปลายทางก่อนขยายไปโดเมนใกล้เคียงผ่านผ้าใบเดิม องค์กรที่พยายามสร้างรากฐานทั้งหมดก่อนเอา AI ขึ้นใช้งานจริงมักไม่ได้เอาอะไรขึ้นเลย