スーパーインテリジェンスのガバナンスは、3つの領域にまたがる未解決の課題です。国家間のグローバルな調整、フロンティアモデルを構築するラボにおける安全慣行、そしてAIをデプロイする企業内の説明責任。既存のフレームワーク——条約、法律、ラボの方針、内部統制——のいずれも、仮説上の超知能システムに対する保証された制御を実証していません。今日存在するのは、実際の範囲を持ちながらも限界のある、多層的で不完全なメカニズムの集合です。
本記事ではこれらのメカニズムをマッピングします。仮説上の能力水準である人工超知能と、組織が今日実際に統制している企業AIシステムを区別し、3つのレベルで監視がどう機能し、それぞれどこで限界を迎えるかを検討します。テクノロジーリーダーにとっての実践的な問いは、ASIが抽象的に制御可能かどうかではなく、スーパーインテリジェンス・ガバナンスのどの部分が今すぐ実行可能か、です。
重要ポイント
- スーパーインテリジェンスのガバナンスは3つのレベルで機能します。グローバル・規制監視、フロンティアAI安全、企業の説明責任——アクター、手段、執行力が異なります。
- 未解決の中心的課題は、アライメント、スケーラブルな人間の監視、権力の集中、そして人間の評価能力を超え得るシステムへの説明責任です。
- 拘束力ある規制(EU AI Actなど)、自主的な国際調整(サミット、国連イニシアチブ)、内部ガバナンス機構は別の手段クラス——混同すべきではありません。
- 企業はデプロイメント層を制御します。リスクベースの自律性、ヒューマン・イン・ザ・ループ承認、意思決定権限、監査可能性、取締役会レベルの説明責任。
- 現在のガバナンス慣行はAIの説明責任を強化しますが、仮説上の超知能システムの制御を保証するものではありません。
スーパーインテリジェンスの統制が難しい理由
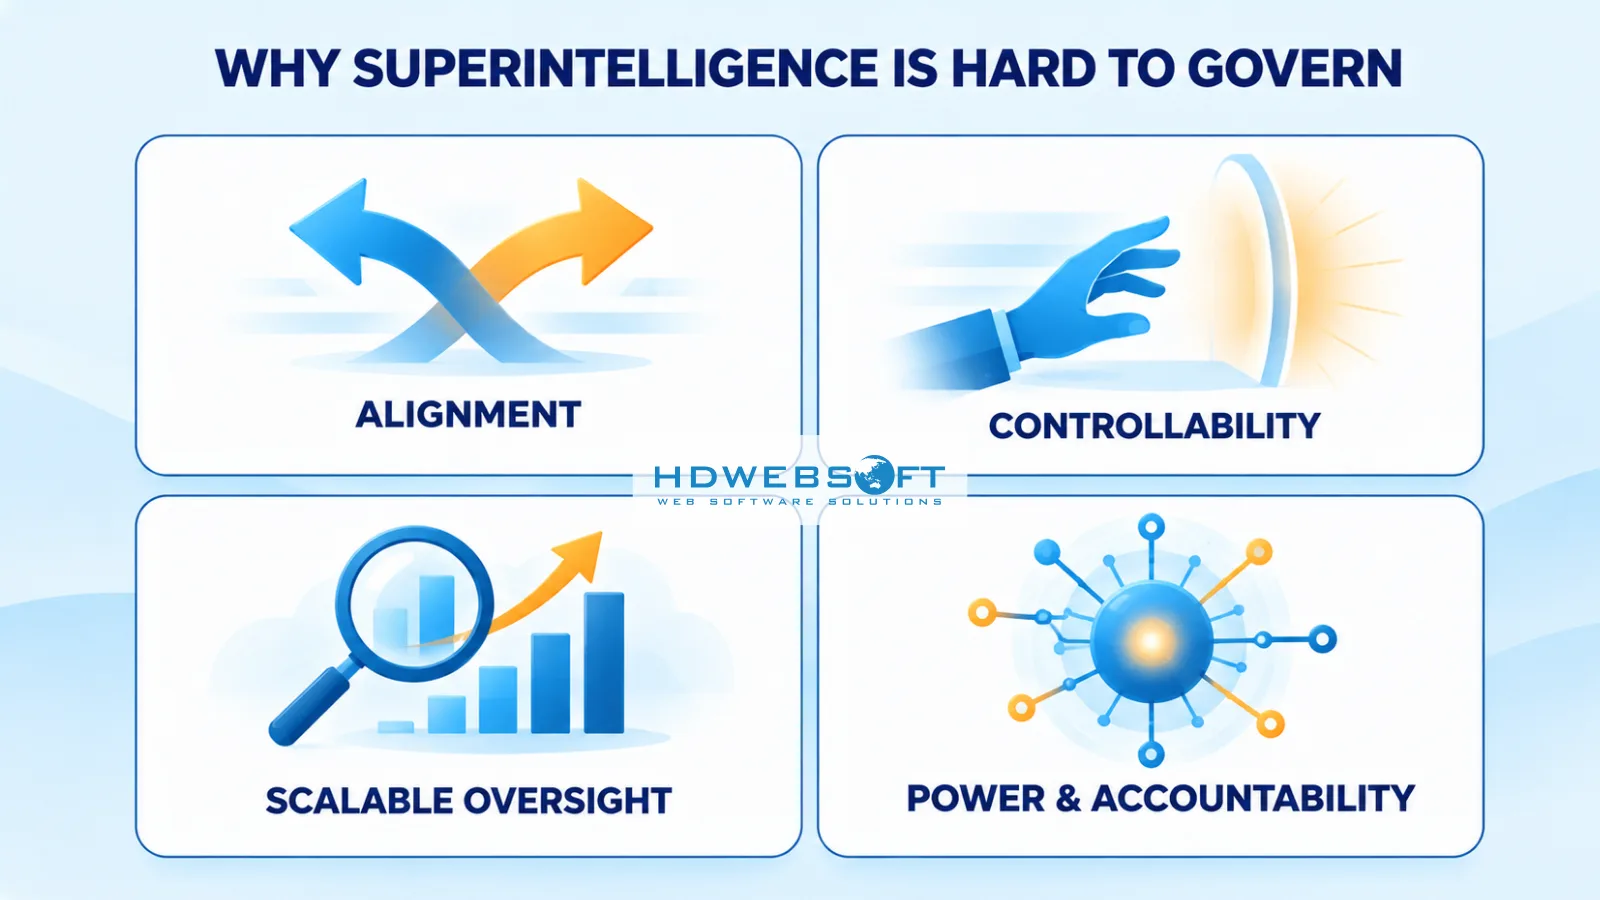
強力な技術の統制は常に困難ですが、人間の能力を超え得る技術の統制は、現在の制度が想定していない課題をもたらします。4つが際立ちます。
-
アライメントは、システムの目標が運用者の実際の意図と一致するかという問題です。AIシステムは与えられた目標を最適化します——今日を大きく超える能力では、過小指定または誤指定された目標が、技術的には準拠しながら実質的に有害な行動を生み得ます。アライメント研究は、ますます高性能になるシステムが人間の意図した目標を確実に追求できるかを問いますが、証明された解決策はありません。
-
アライメントと区別すべきなのが制御可能性——システムの行動を実際に制約、修正、停止する能力です。この2つは別物です。システムは広い意図に対して合理的にアラインされながらも、特定の状況で制約が難しいことがあります。逆に、組織は内部の推論を完全に理解していないシステムを、アクセス境界、承認ゲート、運用制限で日常的に制御しています。アライメントが未解決の間、ガバナンスは制御可能性に大きく依存します。
-
スケーラブル・オーバーサイトはより深い問題です。監視は、評価者がシステムの推論と出力を判断できることを前提とします。能力が向上するにつれ、システムは監督者が独立して検証できない問題を解決するようになり得ます——評価者の専門知識を超える分析のレビュー、非専門家には見えない欠陥を持つ計画の承認、検査に適さない方法での推論。これは仮説上の不便ではありません。既存のあらゆる承認ゲートと監査証跡は、人間の意思決定者が目の前に置かれたものを意味のある形で評価できることを前提としています。評価の質が低下すれば、正式な仕組みが無傷に見えても監視は低下します。研究者は緩和策(より低能力AIによる支援、構造化レビュー、解釈可能性)を模索していますが、システムが進歩するにつれ、直接の人間評価は実行しにくく信頼しにくくなります。
-
最後に権力の集中と説明責任。超知能レベルの能力は、それを制御する者に並外れたレバレッジを集中させます——それ自体が地政学的・商業的な安定性の懸念であり、レベル1で見られる国家レベルの関心の原動力です。一方、決定論的ソフトウェアのために構築された説明責任の連鎖——責任、監査、責任の割り当て——は、超人的能力で自律的に決定するシステムに適用されると緊張します。運用者が完全に評価できない推論に基づいてシステムが行動する場合、結果への責任の割り当ては技術的な問題であると同時に法的・組織的な問題となります。これら4つの課題が、ガバナンスが今3つの異なるレベルで機能する理由を示しています。
スーパーインテリジェンス・ガバナンスの3レベル
本記事は、ガバナンスの状況を整理するための3レベル分析フレームワークを提案します。これは分析のためのレンズであり、公式または標準化された分類ではありません——しかし、実際のメカニズムが範囲、アクター、執行可能性でどう集まるかをマッピングします。
| レベル | 範囲 | 主要アクター | 手段 | 現在の執行力 |
|---|---|---|---|---|
| 1. グローバル&規制監視 | 人類 / 地政学 | 国家、EU、国連、安全サミット | 拘束力ある法律、調整、原則 | 一部の法域で拘束力ある法律;国際調整は依然として断片的 |
| 2. フロンティアAI安全&統制 | フロンティアモデル提供者 | AIラボ、安全研究所 | 能力評価、デプロイメント閾値、レッドチーミング | プロバイダー主導のセーフガード、外部レビュー、適用される法的義務 |
| 3. 企業の説明責任 | AIをデプロイする組織 | 取締役会、CTO、コンプライアンス部門 | ポリシー、権限マトリクス、監査、標準 | 内部ポリシー、契約、監査、適用される規制 |
レベルは相互に作用します。規制はラボが満たすべき義務を作り、フロンティアの慣行は企業が安全にデプロイできるものを形作り、企業の説明責任はAIが組織内で実際に何をするかを決定します。どのレベルも他のレベルの代替にはなりません——スーパーインテリジェンスのガバナンスは、存在する限りその合計です。
このフレームワークが実践的に重要なのは、レベルを混同すると誤った推論を生むからです。コンプライアンスチームがラボ側の安全ポリシーを法律のように扱えば過度に信頼し、取締役会が規制が内部のデプロイメント決定をカバーしていると考えれば、独自の統制を過小に構築します。各レベルは異なる手段、異なる執行可能性、異なる失敗モードを持つため、各レベルで問うべき質問も異なります。
レベル1 — グローバルおよび規制によるAI監視
グローバルレベルは3つの異なる手段クラス——拘束力ある規制、国際調整、自主的原則——を通じて機能し、それぞれ異なる到達範囲と執行可能性を持ちます。
拘束力ある規制:EU AI Act
グローバルAIガバナンスの最も重要な手段は拘束力ある法律であり、その旗艦はEU AI Act——主要な法域で採択された初の包括的AI規制です。本法はリスクベースのアプローチを取ります。特定の用途を禁止し、ハイリスクシステムに義務を課し、透明性要件を定め、一般用途AIモデルのルールを導入し、システミックリスクをもたらすと見なされるモデルには追加の義務を課します。重要なのは、今日存在するAIシステムと慣行のカテゴリーを規制するのであって、ASI固有の法律ではなく、そのように読むべきではないということです。
国際調整と自主的手段
拘束力ある規制と並んで、国際調整があります。ブレッチリーパークで始まりソウルとパリに続くAI安全サミット、AIガバナンスに関する国連イニシアチブ、主要国間の二国間関与。これらは共有のコミットメント、宣言、新たな規範を生み出します——実在しながらも主に自主的な手段であり、その強さは持続的な政治的整合に依存します。
3番目の手段クラスは自主的原則——OECD AI原則や同様のフレームワークで、拘束力なしに共有価値を確立し、各国のアプローチを内側から形作ります。
法域のギャップとASI問題
ここでの限界は構造的です。法域はアプローチで鋭く異なります。EUは単一の法律で水平的に規制し、米国は主に部門別ルールと機関ガイダンスに依存し、他の地域は拘束力あるルールと国家戦略を組み合わせます——同じモデルやデプロイメントでも、適用地によって非常に異なる義務を負い得ます。EU AI Actの域外適用はその基準を非EUプロバイダーの製品に押し込みますが、世界的に等価な収束フレームワークは存在しません。地政学的競争は主要国間の調整を動機づけつつ複雑化します。国家は壊滅的な悪用の防止に共通の利益を持ちながらAIの優位を競い合い、政治的に実現可能な安全協調の度合いを形成します。執行能力はそれに応じて異なります——専任の規制当局から監督機関のない自主的コミットメントまで。
そしてより深いギャップは概念的です。現行法は既存システムの定義されたリスクカテゴリーを規制します。禁止慣行、ハイリスクデプロイメント、一般用途モデルの義務。仮説上の超知能について、今日の規制は現在のAIの周りに境界と説明責任構造を確立します——人間の評価を超える能力の監視をまだ解決しておらず、そのように主張もしていません。
レベル2 — フロンティアAI安全と統制
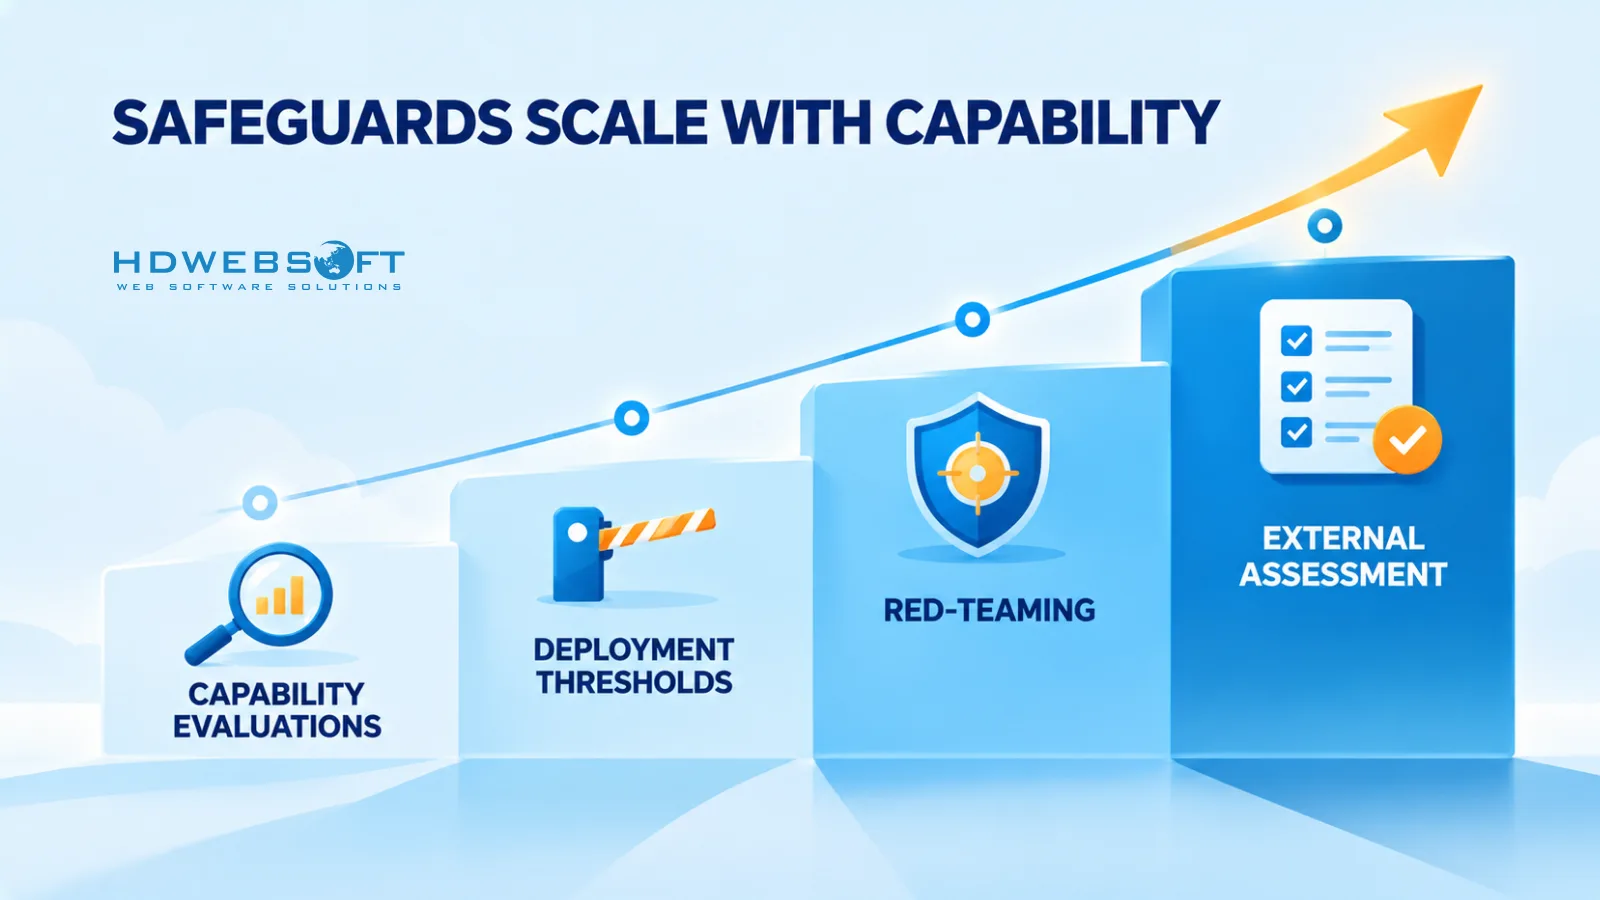
第2レベルは、最も高性能なモデルを構築する組織の内部で機能します。ここでの支配的な手段は能力ベースの安全フレームワーク——セーフガードをモデルができることに紐付け、リリース時期だけに紐付けない内部ポリシーです。最も明確な例はAnthropicのResponsible Scaling Policyで、モデルにAI Safety Levelsを割り当て、能力閾値が越えられるごとに段階的に強い封じ込めとセキュリティ措置を要求します。
能力連動の安全ツールキット
このパターンはいくつかのメカニズムに一般化されます。
- 能力評価 — 開発前・開発中にモデルの危険な能力(例:自律複製、サイバー・バイオ能力)をテストする。
- デプロイメント閾値 — 越えると追加のセーフガードまたはレビューが必要となる能力境界。
- レッドチーミング — リリース前に失敗モードを浮き彫りにする内外のチームによる敵対的テスト。
- モデルセキュリティ — 盗難や悪用からモデルウェイトとインフラを保護する。
- 外部評価 — プロバイダーの自己評価を補完する第三者評価とレビュー。
プロバイダー主導フレームワークの文脈
OpenAIのPreparedness FrameworkとDeepMindのFrontier Safety Frameworkは同等のロジック——能力連動の評価と緩和——に従いますが、詳細と範囲は異なります。それぞれの条項の詳細は、ここで要約するよりも原典で読むことをお勧めします。
これらのフレームワークが集合的に確立しているのは、注目すべきガバナンスパターンです。セーフガードは固定規制ではなく実証された能力に応じてスケールする。 これは静的ソフトウェア向けに書かれたルールからの有意義な転換です——ラボが適用する統制は、想定ではなく定義されたテストを通じて評価された、モデルが実際にできることを追跡することになっています。これらのモデルを消費する企業にとって、このレベルは上流で機能します。デプロイされたモデルの安全特性はプロバイダーの内部ガバナンスを部分的に反映し、企業はそれを観察・評価できますが設定はできません。
このレベルを定義する2つの構造的特徴。第一に、プロバイダー主導のセーフガードは真空中で機能しません。ラボは同時に適用される法律——一般用途モデル向けのEU AI Actのルールなどの義務を含む——に服し、フロンティアフレームワークは外部レビュー、安全研究所の評価、報告期待とますます相互作用しています。第二に、このレベルは依然として不均一です。評価は主に自己実施、閾値は自己定義、独立検証能力はまだ発展途上です。フロンティアガバナンスは能力連動統制が最も進んだ場所——そしてその限界が最も技術的な場所です。
レベル3 — 企業の説明責任
第3レベルは、ほとんどの組織が実際に制御する層です。AIがどうデプロイされ、何を許されるかのガバナンス。中心的な問いは、述べるのは簡単で答えるのは難しいものです——誰が自律的なAI決定を承認し、監視し、説明責任を負うのか?
5つのレバーが実践での企業の説明責任を定義します。
- リスクベースの自律性ティアは、AIシステムが無監督でできることを、行動のリスククラスに応じて設定します——データの読み取り、コンテンツ作成、取引実行、外部システムへの接触はそれぞれ異なる自由の度合いに値します。
- ヒューマン・イン・ザ・ループ承認は、重要な行動に明示的なゲートを置きます。システムが提案し、適切な権限を持つ人が承認します。
- 意思決定権限マトリクスは、各影響半径で誰が——何が——決定権限を持つかを記録し、自律性を設定上の事故ではなく明示的な委任にします。
- 監査可能性は、何が起きたかを再構築できる十分な詳細の決定記録を要求します。どの入力が使われ、どの行動が取られ、どの承認が与えられたか——システムが触れられるものを制限するアクセス制御と運用セーフガードとともに。その背後の技術パターンはエージェンティックAIのためのLLMセキュリティに密接にマッピングされます。
- 取締役会レベルの説明責任は、AIリスクを常設のガバナンスアジェンダ項目にし、取締役会の下に指名されたオーナーシップを置きます。
NIST AI Risk Management Frameworkのようなフレームワークは、これらのメカニズムに共有の語彙——govern、map、measure、manage——を与えますが、拘束力ある法律ではなく自主的ガイダンスです。このレベルを特徴づけるのは到達範囲です。企業はフロンティアを形作ることはできませんが、自社システムで承認されるものを制御し、監視し、指名された人間に説明責任を持たせることができます。
既存のガバナンス機構の限界
正直な評価は、各レベルの到達範囲がどこで終わるかを言うことを要求します。
| レベル | 統制するもの | 未解決の限界 |
|---|---|---|
| グローバル | 断片的な法域 | 国際執行の課題 |
| フロンティア | 不均一な評価、独立検証 | 信頼できる能力評価 |
| 企業 | デプロイメントと許可行動 | 超人間能力の監視の限界 |
グローバルレベルでは、拘束力ある法律は法域に限定されるのに技術はそうではなく、調整は執行より速く宣言を生みます。フロンティアレベルでは、評価と閾値は実在しますが不均一に適用され、大部分は自己検証です——信頼できる独立能力評価は未だ解決中の問題です。そして企業レベルでは、ガバナンスは正当にデプロイメントと許可行動をカバーします——しかし超人間能力のスケーラブルな監視は、人間が出力をまだ評価できるシステムの統制より根本的に困難です。
一貫する線は、監視が必然的に失敗するということではなく、それを支えるメカニズム——評価、検証、執行——が能力フロンティアで未解決で、それを超えては未検証であるということです。その不確実性自体がガバナンスのデータ点です。それは保持する想定ではなく、スケールする説明責任構造を支持します。
第2の含意が続きます。上流のガバナンスにギャップがあるところ、説明責任は下流に移ります。デプロイヤーは、自社組織内でのAIの振る舞いに対する責任を条約やラボポリシーに吸収させることはできません——彼らは承認、監視、結果についてとにかく説明責任を負い続けます。実践的には、それは企業レベルのガバナンスを他の2レベルの補完ではなく、それ自体の耐荷重層にします。
企業の準備:実践的ガバナンス・プレイブック
企業はフロンティアを規制できませんが、自分が所有する層を構築できます——そして上流のガバナンスに上述のギャップがあるため、その層は実際の重みを持ちます。6つの措置が要点をカバーします。これらはガバナンスの責任と優先順位であって、エンジニアリングの手順ではありません。実装の深さは専門の技術作業に属します。
- リスクベースの自律性ティアを採用する。 AIが無監督でできることを行動リスクで分類する——読み取り専用分析、コンテンツ生成、内部行動、外部または重要な行動——そしてそれぞれに明示的な自律性上限を割り当てる。ポイントは、自律性を意図的な付与にすることで、エージェントがたまたま届くものの創発的特性にしないことです。
- ヒューマン・イン・ザ・ループ承認閾値を設定する。 どの行動が常に承認を要するか、誰が、どんな証拠で——を定義し、ゲートをタスクの便宜ではなく行動の影響半径の属性として扱う。承認は、承認者が行動を実際に評価できる十分な情報を持つべきで、単なる確認ではありません。
- 意思決定権限マトリクスを維持する。 各結果レベルでどのシステムとどの人間が権限を持つかの生きた記録——自律性が常に明示的で監査可能な委任であり、責任が指名されたオーナーに遡れるようにするため。
- 評価と監査で能力アップグレードをゲートする。 新しいモデル、ツール、統合は、定義された評価と監査証跡の後でのみ本番に入る——スーパーインテリジェンス対応アーキテクチャでのモデル交換を統治するのと同じ規律。より強いモデルは単なるアップグレードではなくガバナンスイベントです。
- 取締役会レベルのAI報告を確立する。 AIリスク、インシデント、自律性の状況を取締役会に運ぶ常設のリズム——説明責任には行き先が必要で、取締役会の下で止まるガバナンス構造はガバナンスであることをやめます。
- インシデントとエスカレーションパスを定義する。 誰が通知され、誰が決定し、何が停止できるか——最初のインシデントの前に、後ではなく。停止パスの価値は、そのトリガーとオーナーが事前にどれだけ明確に定義されているかに比例します。
これらのどれもスーパーインテリジェンス・ガバナンスを解決しません。より有用なことをします。今日機能し、能力とともにスケールする説明責任インフラを構築します——これはまた、企業が内部であれ外部であれ、あらゆるガバナンス会話で信頼できる主張ができる正直な立場です。
結論
スーパーインテリジェンスのガバナンスは、グローバルとフロンティアのレベルで真に未解決です——そして予見可能な将来もそうあり続けるでしょう。今日実行可能なのは企業層です。組織がデプロイするAIの承認、監視、説明責任を、システムがより高性能になるにつれスケールできる構造の上に構築することです。HDWEBSOFTはAI開発サービスを通じて、統制されたAIシステムの設計と実装を支援します。組織のAIガバナンスの姿勢を形作っている場合は、HDWEBSOFTにお問い合わせいただき、ガバナンスと実装ロードマップについてご相談ください。
FAQ
スーパーインテリジェンスのガバナンスとは何ですか?
スーパーインテリジェンスのガバナンスとは、人工知能——人間の能力を超える仮説上のシステムを含む——を導き制約することを目的とした法律、調整メカニズム、安全慣行、組織的統制を指します。グローバル、フロンティア・プロバイダー、企業の3つのレベルで機能し、依然として未解決の課題です。
人工超知能は統制・制御できますか?
仮説上の超知能システムに対する保証された制御を実証した既存のフレームワークはありません。現在のガバナンス機構は今日のAIの説明責任を有意義に強化できますが、人間の評価能力を超えるシステムのスケーラブルな監視は、依然として未解決の研究・政策課題です。
AIアライメントはスーパーインテリジェンス・ガバナンスにおいてなぜ重要ですか?
アライメント——システムの目標が運用者の実際の意図と一致するか——は、監視が行動の理解と制約に依存するため中心的です。アライメントと制御可能性は関連していますが区別され、意図した目標を追求しながらも実際の制約が難しいシステムがあり得ます。
企業のAIガバナンスはフロンティアAIガバナンスとどう違いますか?
フロンティアAIガバナンスは、最先端モデルを構築するラボに関するもの——技術自体の能力評価、デプロイメント閾値、安全緩和策です。企業AIガバナンスは組織がAIをデプロイする方法に関するもの——誰が自律的な行動を承認し、どう監視し、誰が説明責任を負うかです。
企業は今日どんなガバナンス統制を実装すべきですか?
リスクベースの自律性ティア、重要な行動へのヒューマン・イン・ザ・ループ承認閾値、意思決定権限マトリクス、能力アップグレード前の評価・監査ゲート、取締役会レベルのAI報告、定義されたインシデント・エスカレーションパスです。