La infraestructura de datos IA empresarial es el sistema de pipelines, almacenes, índices y controles de gobernanza que convierte datos operativos fragmentados en una base que los sistemas de IA pueden consultar de forma fiable: datos frescos, consistentes, con permisos y conscientes de las relaciones. A medida que los modelos se vuelven más capaces, el factor limitante en la IA empresarial se está desplazando de la calidad del modelo a la calidad de la base de datos: un sistema de IA solo es tan fiable como la frescura de sus índices y la integridad de sus controles de acceso.
Este artículo es el análisis técnico en profundidad de la capa Enterprise Data & Knowledge del blueprint de arquitectura de superinteligencia empresarial. Aquel post definió un modelo de referencia de seis capas; este detalla cómo se construye realmente la capa de datos: cómo los sistemas operativos alimentan vector stores y knowledge graphs casi en tiempo real, cómo se propagan los permisos de acceso a los índices derivados y cómo se recuperan los pipelines cuando fallan. Una aclaración desde el principio: “listo para SI” es una orientación arquitectónica — infraestructura diseñada para absorber IA cada vez más capaz — no un estándar técnico establecido ni evidencia de que la superinteligencia exista.
Puntos Clave
- La infraestructura de datos lista para SI es una orientación arquitectónica — datos gobernados, frescos e interoperables preparados para IA cada vez más capaz — no un estándar certificado ni evidencia de que la ASI exista.
- La brecha entre la arquitectura de datos tradicional y la infraestructura lista para IA es operativa: frescura, propagación de permisos y modelado de relaciones — no capacidad de almacenamiento.
- Los vector stores y los knowledge graphs resuelven problemas de recuperación distintos; la mayoría de las empresas necesita ambos detrás de una única interfaz de recuperación gobernada.
- Change data capture es la columna vertebral por defecto para pipelines orientados a IA; los índices obsoletos degradan silenciosamente cada sistema de IA aguas abajo.
- Construye incrementalmente: un dominio de datos, ingesta estandarizada, frescura y controles de acceso verificados — luego expande.
¿Qué Es la Infraestructura de Datos Lista para SI?
La infraestructura de datos lista para IA está construida para cargas de trabajo de IA como consumidores de primera clase — no solo analistas y dashboards. “Lista para SI” añade un horizonte de planificación: la misma ingeniería, pero con suficiente margen para que la base sobreviva a los saltos de capacidad de los modelos superiores sin rediseñarse. Cuatro propiedades la definen:
- Frescura. Los índices derivados se actualizan cuando cambian las fuentes — minutos para dominios calientes, no de un día para otro. Un índice es una copia, y las copias decaen.
- Interoperabilidad. Una sola estructura de ingesta alimenta el lakehouse, el vector store y el knowledge graph — no un pipeline a medida por caso de uso.
- Descubribilidad. Un catálogo de metadatos hace localizables los datasets y lleva el linaje desde las filas de origen hasta los fragmentos indexados.
- Acceso gobernado. Los permisos de origen se propagan a cada copia derivada, incluidos los embeddings — que son, legal y prácticamente, copias de texto.
Lista para SI vs. Lista para IA: Una Distinción Práctica
| Dimensión | Tradicional | Lista para IA | Orientación lista para SI |
|---|---|---|---|
| Consumidor principal | Informes y dashboards | Modelos ML, aplicaciones RAG | Agentes más autónomos; modelos futuros más capaces |
| Expectativa de frescura | Batch nocturno aceptable | Casi tiempo real en dominios calientes | SLO de frescura explícitos por dominio |
| Control de acceso | Por sistema, reconciliado manualmente | Propagado a índices | Forzado en la recuperación; revocación auditada |
| Modelo de datos | Tablas y archivos | Tablas más embeddings | Más relaciones explícitas y una capa semántica |
La advertencia honesta: nada en la columna de la derecha está probado como necesario para la superinteligencia — esa capacidad no existe. La dirección es defendible porque cada propiedad rinde beneficios para los sistemas de IA actuales, ocurra lo que ocurra después.
Por Qué la Arquitectura de Datos Empresarial Tradicional Falla con la IA
Los patrimonios de datos empresariales se construyeron para un consumidor distinto. Cinco modos de fallo aparecen repetidamente cuando la IA se convierte en carga de trabajo de primera clase:
- La frescura analítica no es frescura operativa. Un ETL nocturno produce un warehouse correcto hasta ayer — bien para un dashboard del lunes, mal para un asistente de IA que responde preguntas operativas a las 3 p.m.
- Los permisos no se propagan. Los sistemas de origen llevan ACL a nivel de fila y objeto; las copias derivadas — incluidos los embeddings — normalmente no heredan ninguna, dejando un sistema de IA capaz de recuperar contenido que el solicitante no tiene derecho a ver.
- Las relaciones son implícitas. Los almacenes relacionales registran entidades; las relaciones que importan viven en claves foráneas nunca diseñadas para ser recorridas, o en la cabeza de las personas.
- Un pipeline por consumidor. Cada nuevo caso de uso de IA obtiene una extracción a medida, y cada copia de los mismos datos diverge silenciosamente de las demás.
- Sin contrato de frescura. Nadie puede decir cuán obsoleto está un índice — así que nadie puede confiar del todo en una respuesta construida sobre él.
Observa que estos son fallos de implementación, no preguntas de evaluación. Si tu patrimonio de datos está listo es un problema distinto — nuestra guía sobre preparación de datos para IA cubre la evaluación. Este artículo asume que la evaluación está hecha y cubre lo que construyes a continuación.
Componentes Centrales de la Infraestructura de Datos IA Empresarial
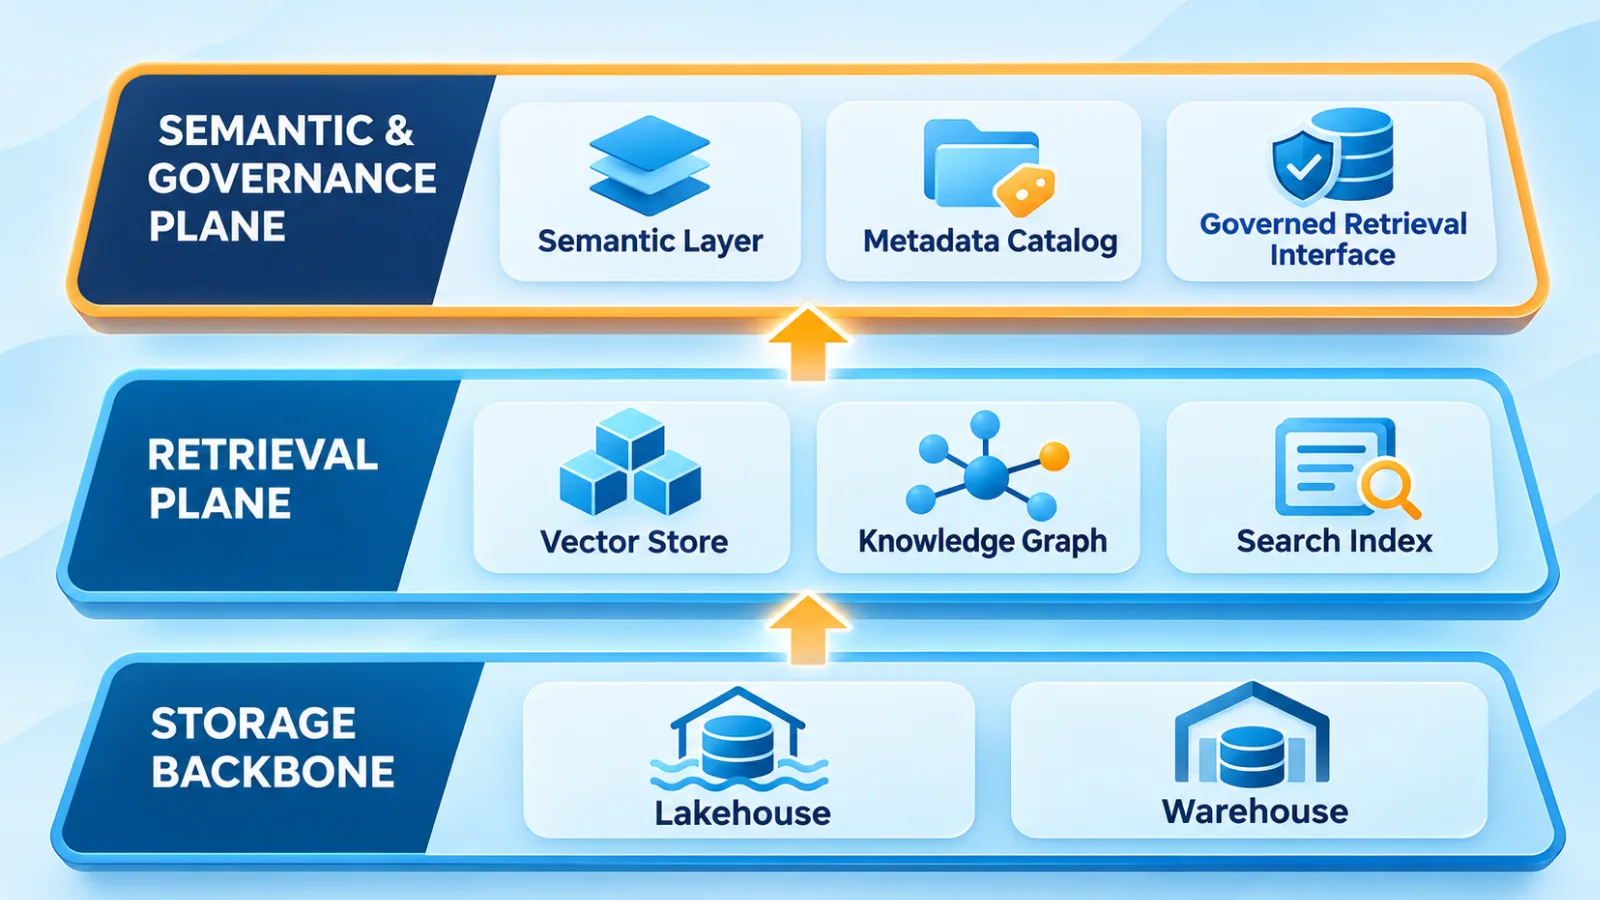
La Columna Vertebral de Almacenamiento
La columna vertebral es un lakehouse — formatos de tabla abiertos sobre object storage — complementado por un warehouse para marts gobernados. Los datos llegan en crudo, se validan y limpian, y luego se conforman en modelos de dominio. Su propiedad definitoria para la IA no es la capacidad sino la recuperabilidad: la columna vertebral es el estado canónico desde el que se puede reconstruir cada almacén derivado. Cuando un índice se corrompe o un modelo de embedding se reemplaza, la columna vertebral convierte la recuperación en un replay y no en una misión de rescate.
El Plano de Recuperación
Tres almacenes derivados sirven a tres formas de consulta distintas:
- Vector store. Embeddings más referencias a fragmentos para recuperación semántica sobre contenido no estructurado.
- Knowledge graph. Entidades y relaciones tipadas para recorridos y consultas multi-salto.
- Search index. Recuperación por palabra clave y metadatos, todavía la herramienta adecuada para identificadores exactos y filtros estructurados.
La regla de diseño que mantiene sano este plano: los almacenes derivados son desechables. Nunca se promueven a fuente de verdad, nunca acumulan estado que no pueda recomputarse y nunca reciben escrituras que eviten el feed de cambios.
El Plano Semántico y de Gobernanza
Sobre almacenamiento y recuperación se sitúa la capa que hace coherente el sistema: una capa semántica con definiciones de negocio y lógica de métricas, un catálogo de metadatos para descubrimiento y linaje, y la interfaz de recuperación gobernada — la única API a través de la cual consultan las aplicaciones de IA. Esa interfaz autentica al llamante, aplica filtros de permisos, fuerza restricciones de frescura y registra cada acceso. La interfaz es la única puerta — que es exactamente lo que hace la gobernanza exigible en lugar de aspiracional.
Bases de Datos Vectoriales vs. Knowledge Graphs: Cuándo Usar Cada Una
Estos dos almacenes son complementarios, no competidores. La confusión surge porque ambos se venden como “la capa de memoria para IA” — pero responden preguntas diferentes.
| Dimensión | Base de datos vectorial | Knowledge graph |
|---|---|---|
| Qué almacena | Embeddings sobre fragmentos de contenido, con referencias a documentos de origen | Entidades y relaciones tipadas (aristas) |
| Estilo de consulta | Similitud semántica — “encuentra cosas como esta” | Recorrido — “cómo se conectan estas cosas” |
| Fortalezas | Texto no estructurado; coincidencia semántica difusa; recuperación ANN a escala | Razonamiento multi-salto; caminos explicables; identidad de entidad estable |
| Limitaciones | Sin relaciones explícitas; resultados opacos; los embeddings derivan cuando cambia el modelo | Esfuerzo de modelado inicial; más difícil de sincronizar; grafos dispersos rinden peor |
| Mecánica de actualización | Re-fragmentar y re-embeder al cambiar el origen; borrados se propagan como tombstones | Upserts incrementales de aristas; cambios grandes de topología se reproducen desde eventos |
| Usos empresariales típicos | Políticas, tickets, documentación, bases de conocimiento | Cadenas de suministro, estructuras organizativas, linaje de datos, mapas de dependencias |
Elige el vector store cuando la pregunta es “encuentra contenido relevante” — el caso empresarial dominante, por eso los índices vectoriales se despliegan primero. Elige el grafo cuando la pregunta es “sigue la relación” — impacto de dependencias, responsabilidad organizativa, cadenas de procedencia. Muchas preguntas reales son ambas: “encuentra los incidentes relacionados con este proveedor” necesita recuperación semántica para encontrar los incidentes y recorrido del grafo para establecer qué relaciones cuentan como “relacionados”.
Esa intersección es donde operan patrones híbridos como GraphRAG — la recuperación vectorial establece el conjunto inicial de candidatos, luego el recorrido del grafo lo expande y hace explicable el resultado. La guía para desarrolladores de GraphRAG describe un patrón de implementación; trátala como referencia técnica, no como afirmación de que algún vendor convenga a toda empresa. Y una nota de frontera: la lógica de orquestación que decide qué almacén consultar vive una capa por encima del alcance de este artículo — nuestra guía de arquitectura RAG agéntica cubre esa capa de recuperación y aplicación.
Diseñando Pipelines de Datos en Tiempo Real para IA
La frescura es una propiedad del pipeline, no del almacenamiento. Ningún vector store ni motor de grafos puede compensar datos que llegan obsoletos — así que el diseño de ingesta determina todo lo que viene después.
Batch vs. CDC vs. Event Streaming
| Patrón | Latencia típica | Carga sobre los orígenes | Orden y deduplicación | Mejor encaje |
|---|---|---|---|---|
| Batch programado (ETL/ELT) | Horas | Lecturas masivas periódicas | Simple | Datos fríos y de referencia; backfills iniciales |
| Change data capture (CDC) | Segundos a minutos | Baja — lee commit logs | Orden por clave | Sistemas de registro: ERP, CRM, bases de datos centrales |
| Event streaming | Sub-segundo a segundos | Ninguna tras la emisión | Orden por partición; at-least-once | Dominios que ya emiten eventos; telemetría, actividad |
CDC es la columna vertebral por defecto para la sincronización orientada a IA desde sistemas de registro. La captura basada en logs lee el commit log de la base de datos y recoge inserts, updates y — críticamente — deletes sin modificar el código de la aplicación, llevando la semántica de borrado que el polling ingenuo pierde por completo. El event streaming encaja en dominios que ya emiten eventos de negocio; el batch sigue siendo dueño de las cargas iniciales y los datos fríos. Para la mecánica del stream processing — windowing, joins con estado, garantías de entrega — la documentación sobre stream processing con Apache Kafka es una referencia técnica sólida.
Indexación Incremental y Refresco de Embeddings
El bucle de actualización para índices vectoriales: llega un evento de cambio, se obtiene el documento afectado, se re-fragmenta, y solo los fragmentos modificados se re-embeden y actualizan bajo IDs de documento estables. Dos reglas mantienen esto honesto. Primero, los borrados deben propagarse como tombstones — un documento eliminado en el origen debe salir del índice dentro de la misma ventana de latencia, o estás filtrando acceso a través de vectores obsoletos. Segundo, almacena la versión del modelo de embedding con cada vector, de modo que las actualizaciones del modelo se desplieguen como re-embeds graduales en lugar de reconstrucciones de todo el índice que congelan la frescura durante días.
Sincronización del Knowledge Graph
El problema difícil aquí es la resolución de entidades: el mismo proveedor que aparece como “Acme Corp”, “ACME Corporation” e ID 4471 en tres sistemas necesita identidad canónica antes de que las aristas signifiquen algo. Resuelve entidades en la ingesta, aplica upserts incrementales de aristas, versiona los tipos de relación y — cuando los cambios de topología son grandes — reproduce eventos en lugar de intentar diferenciar el estado del grafo contra tablas.
Consistencia de la Fuente de Verdad
Un escritor por entidad por dominio; el lakehouse mantiene el estado canónico; los almacenes derivados son réplicas eventualmente consistentes por diseño. Como los fallos en este modelo suelen ser silenciosos — un conector que deja de emitir se ve exactamente igual que un sistema tranquilo — los trabajos de reconciliación comparan recuentos de registros y checksums por ventana de tiempo para detectar divergencias pronto. Publica un presupuesto de latencia por dominio para que “suficientemente fresco” sea un número, no una sensación.
Reintentos, Replay y Dead-Letter Queues
- Consumidores idempotentes. Los upserts con clave por IDs estables hacen seguro el reprocesamiento — la base de toda estrategia de reintento.
- Reintentos con backoff. Los fallos transitorios — límites de rate de la API de embeddings, fallos de red — se reintentan con backoff exponencial antes de escalar.
- Dead-letter queues. Los mensajes envenenados van a una DLQ con alertas; un fallo ruidoso es mejor que una caída silenciosa.
- Capacidad de replay. Retén eventos crudos y offsets para poder reconstruir cualquier almacén derivado sin tocar los sistemas de origen — la propiedad que hace a los almacenes derivados desechables con seguridad.
Monitorización de Frescura y Latencia de Indexación
Rastrea la latencia de extremo a extremo (commit en origen hasta recuperable en el índice), latencia por etapa, tasas de reintento, profundidad de DLQ y cobertura de embeddings — la proporción de documentos indexados con la versión actual del modelo. Alerta cuando la latencia incumpla el SLO del dominio: un pipeline muerto es fácil de detectar, pero un pipeline vivo con once horas de retraso es el modo de fallo que realmente daña a los sistemas de IA.
Arquitectura de Referencia: Conectando Datos Empresariales a Sistemas de IA
El diagrama siguiente ensambla los componentes en un flujo de referencia funcional, desde fuentes operativas hasta consumo gobernado de IA.
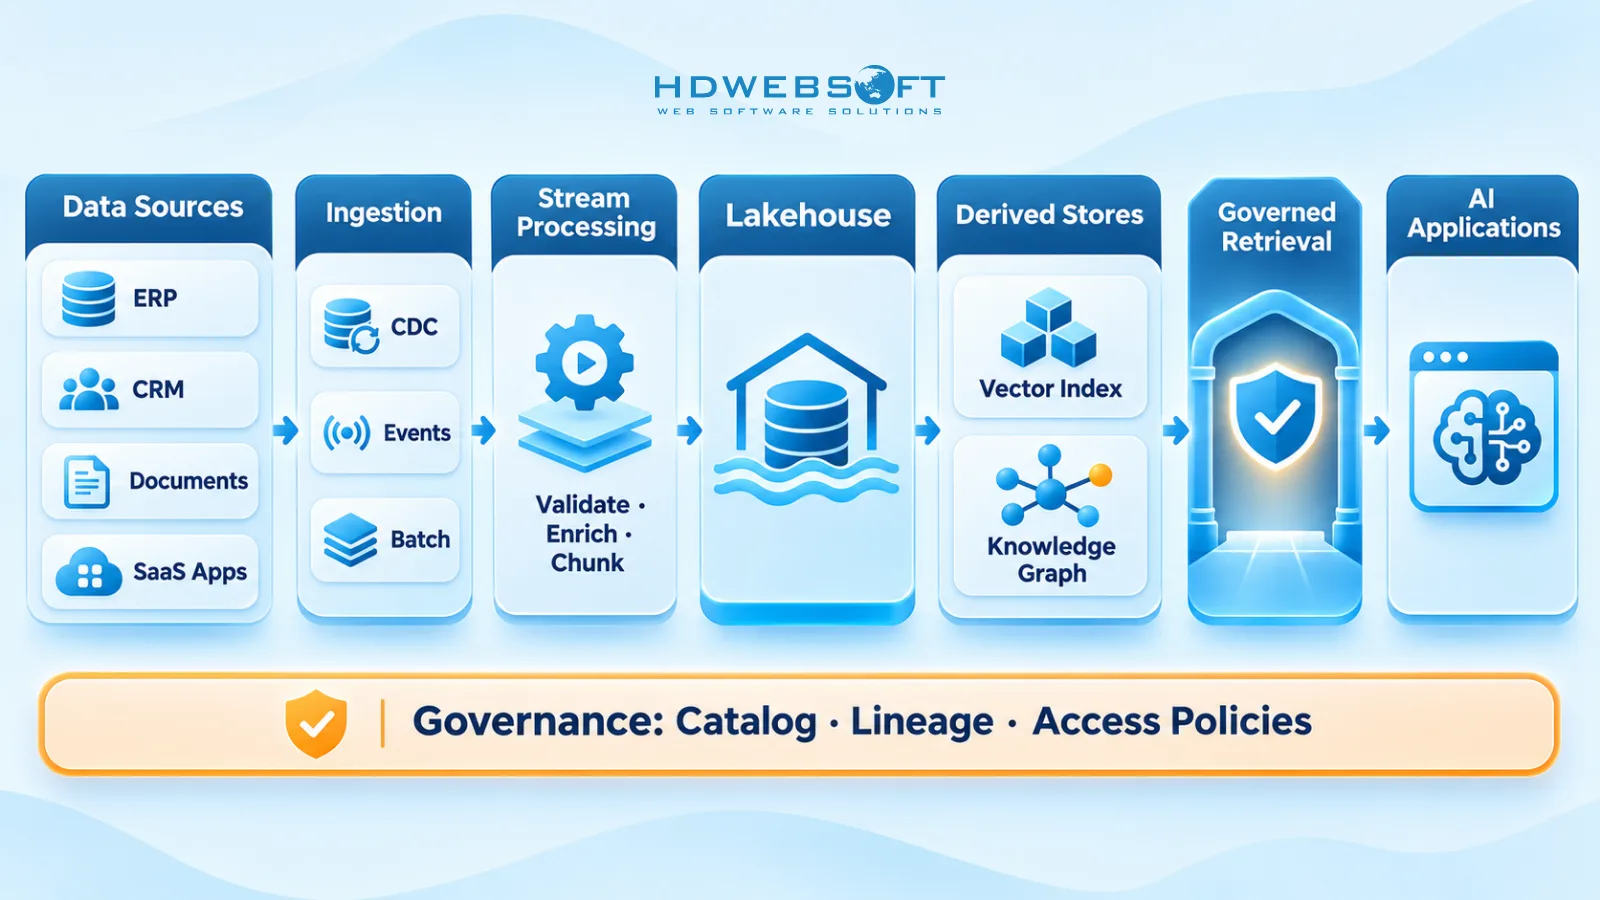
Leyéndolo de izquierda a derecha:
- Fuentes. ERP, CRM, gestión documental, aplicaciones SaaS y el warehouse existente.
- Ingesta y captura de cambios. Conectores CDC en sistemas de registro, event streams donde los dominios los emiten, cargadores batch para backfill y datos fríos.
- Stream processing. Validación, enriquecimiento, clasificación de PII, fragmentación y resolución de entidades — la etapa donde los cambios crudos se convierten en registros consumibles por IA.
- Lakehouse. Zonas cruda, limpia y conformada que mantienen el estado canónico — un escritor por entidad.
- Almacenes derivados. El índice vectorial y el knowledge graph, actualizados incrementalmente desde el mismo feed de cambios en lugar de recargarse.
- Plano de gobernanza. Catálogo, linaje y políticas de acceso aplicadas a través de cada etapa — una capa transversal, no un añadido.
- Interfaz de recuperación gobernada. La única puerta para las aplicaciones de IA: autentica llamantes, aplica filtros de permisos, fuerza presupuestos de latencia en dominios sensibles y registra cada consulta.
Tres rutas de sincronización atraviesan esta arquitectura, y nombrarlas con honestidad importa:
- Ruta caliente: fuente → CDC → stream → almacenes derivados — segundos a minutos, para dominios donde la obsolescencia corrompe decisiones.
- Ruta templada: stream → lakehouse — minutos, manteniendo el estado canónico actualizado.
- Ruta fría: batch → lakehouse → backfill de almacenes derivados — horas, para datos de referencia y reconstrucciones.
La frontera de consistencia: los almacenes derivados son eventualmente consistentes, y la corrección viene de la capacidad de replay más la reconciliación — no de fingir que la latencia es cero. La interfaz de recuperación es donde “cuán obsoleto es demasiado obsoleto” se fuerza por dominio, por eso es ella — no el índice — el punto de control.
¿Construyendo sistemas de IA sobre datos empresariales fragmentados? Una base de datos fiable requiere más que conectar bases de datos. Desde la ingesta en tiempo real y la sincronización de conocimiento hasta la recuperación gobernada, HDWEBSOFT ayuda a las empresas a diseñar soluciones de ingeniería que conectan sistemas empresariales con aplicaciones de IA modernas.
Gobernanza de Datos, Linaje y Controles de Acceso
La gobernanza en esta capa es un conjunto de controles de implementación, no documentos de política:
- Propiedad y registro. Cada dominio tiene un propietario con nombre; cada dataset que entra a la columna vertebral se registra en el catálogo con su SLO de frescura.
- Propagación de permisos. Las ACL de origen viajan con el contenido como metadatos del índice; el filtrado en tiempo de recuperación las aplica antes de devolver resultados. Los embeddings son copias de texto — trátalos como igualmente sensibles.
- Manejo de PII. La clasificación ocurre en la ingesta, dentro del stream processing, de modo que el enmascaramiento o la exclusión se apliquen antes de que el contenido se embeda.
- Linaje. Captura qué filas de origen produjeron qué fragmentos y embeddings. Los modelos de eventos abiertos — la documentación de OpenLineage describe uno — permiten a los trabajos del pipeline emitir linaje de forma consistente en lugar de reconstruirlo después.
- Revocación. La revocación de acceso se propaga como los datos — eventos de borrado y actualización más sincronización periódica de ACL — y se prueba con simulacros, no se asume.
- Auditoría. Cada recuperación a través de la interfaz gobernada se registra con la identidad del llamante, los filtros aplicados y las versiones del corpus.
- Frescura como gobernanza. Cuando una respuesta de IA impulsa una decisión, los datos obsoletos son una exposición de cumplimiento — la monitorización de latencia pertenece al dashboard de gobernanza, no solo al tablero de operaciones.
Roadmap de Implementación Práctica
La secuenciación que funciona es deliberadamente poco glamurosa — un dominio cada vez:
- Elige un dominio de alto valor. Una base de conocimiento de soporte, un catálogo de productos o un único sistema operativo — alcance acotado con retorno visible.
- Estandariza su ingesta. CDC donde el origen lo permita; este patrón de pipeline se convierte en la plantilla para todo lo que sigue.
- Levanta el plano de recuperación para ese dominio. Índice vectorial primero; añade el grafo solo si las consultas de relaciones realmente lo justifican.
- Verifica antes de expandir. SLO de frescura medido contra tráfico real, propagación de permisos probada con un simulacro de revocación, linaje capturado de extremo a extremo.
- Expande a través de la misma estructura. Los dominios adyacentes se unen al patrón de ingesta existente — nunca un segundo pipeline a medida.
Métricas de éxito a las que sujetar cada paso:
| Métrica | Señal saludable |
|---|---|
| Latencia de frescura extremo a extremo | Dentro del SLO del dominio — menos de cinco minutos en dominios calientes |
| Latencia de propagación de permisos | Revocación efectiva en minutos, verificada con simulacro |
| Cobertura del índice | Aproximadamente 100% de los documentos en alcance con la versión actual de embeddings |
| Fiabilidad del pipeline | Fallos transitorios auto-recuperados; profundidad de DLQ cerca de cero |
| Calidad de recuperación aguas abajo | Propiedad de la capa de aplicación — fuera del alcance de este artículo |
Conclusión
El activo duradero en la IA empresarial no es el modelo — es la base de datos debajo de él. Los modelos se cambiarán muchas veces a lo largo de la vida de esta infraestructura; la estructura de ingesta, los almacenes derivados y el plano de gobernanza son lo que persiste. Eso es también lo que hace de “lista para SI” una postura defendible en lugar de una apuesta especulativa: cada propiedad descrita aquí — frescura, propagación de permisos, linaje, pipelines reproducibles — rinde beneficios para la IA que ejecutas hoy, ocurra lo que ocurra en cinco años.
El camino práctico es incremental: un dominio, un patrón de pipeline, controles verificados, luego expansión. Las empresas que intentan construir toda la base antes de poner en producción cualquier IA normalmente no ponen nada en producción. Los servicios de desarrollo de IA de HDWEBSOFT cubren exactamente esta intersección — ingeniería de datos, integración de sistemas y entrega de aplicaciones de IA. Si estás delimitando la base de datos para tu roadmap de IA, contacta con nuestro equipo para una consulta técnica.
Preguntas Frecuentes
¿Qué es la infraestructura de datos lista para SI?
La infraestructura de datos lista para SI es una orientación arquitectónica: infraestructura de datos empresarial diseñada para servir a sistemas de IA cada vez más capaces. Se define por frescura (los índices se actualizan cuando cambian las fuentes), interoperabilidad (una sola estructura de ingesta alimenta lakehouse, vector store y grafo), descubribilidad (catálogo de metadatos y linaje) y acceso gobernado (los permisos de origen se propagan a cada copia derivada). No es un estándar técnico establecido ni evidencia de que la superinteligencia exista.
¿Cuál es la diferencia entre una base de datos vectorial y un knowledge graph para IA empresarial?
Una base de datos vectorial almacena embeddings sobre fragmentos de contenido y responde preguntas de similitud semántica — “encuentra cosas como esta”. Un knowledge graph almacena entidades y relaciones tipadas y responde preguntas de recorrido — “cómo se conectan estas cosas”. La mayoría de las empresas necesita ambas: los vector stores manejan texto no estructurado a escala, mientras los grafos cargan las relaciones explícitas que hacen posible el razonamiento multi-paso y las respuestas explicables.
¿Los pipelines de datos de IA deberían usar procesamiento batch o change data capture?
Ambos, según la temperatura del dominio. Change data capture es la opción por defecto para la sincronización orientada a IA desde sistemas de registro — lee los commit logs, introduce una carga casi nula en el origen y propaga los borrados correctamente. El event streaming encaja en dominios que ya emiten eventos. El batch sigue siendo adecuado para backfills iniciales y datos genuinamente fríos donde la frescura horaria o nocturna es aceptable.
¿Cómo mantener los embeddings vectoriales actualizados cuando cambian los datos de origen?
Mediante indexación incremental impulsada por eventos de cambio: cuando un documento de origen cambia, se re-fragmenta ese documento, se re-embeden los fragmentos modificados y se actualizan bajo IDs estables. Los borrados deben propagarse como tombstones — un documento eliminado en el origen debe salir del índice dentro de la misma ventana de latencia. Almacenar la versión del modelo de embedding con cada vector permite que las actualizaciones del modelo se desplieguen como re-embeds graduales en lugar de reconstrucciones totales.
¿Cómo se propagan los permisos de acceso a vector stores y knowledge graphs?
Las ACL de origen viajan con el contenido como metadatos del índice y se aplican en el momento de la recuperación — la interfaz de recuperación gobernada autentica al llamante y aplica filtros de permisos antes de devolver resultados. La revocación se propaga como los datos: eventos de borrado y actualización más sincronización periódica de ACL, verificada con simulacros. Los embeddings son copias de texto y deben tratarse como igualmente sensibles.
¿Por dónde debería empezar una empresa a construir infraestructura de datos para IA?
Por un dominio de datos de alto valor. Estandariza su ingesta — CDC donde el origen lo permita — levanta un plano de recuperación solo para ese dominio, y verifica frescura, propagación de permisos y linaje de extremo a extremo antes de expandir a dominios adyacentes a través de la misma estructura. Las empresas que intentan construir toda la base antes de poner en producción cualquier IA normalmente no ponen nada en producción.