L’infrastructure de données IA d’entreprise est le système de pipelines, magasins, index et contrôles de gouvernance qui transforme des données opérationnelles fragmentées en une fondation que les systèmes IA peuvent interroger de façon fiable — des données fraîches, cohérentes, permissionnées et conscientes des relations. À mesure que les modèles deviennent plus capables, le facteur limitant dans l’IA d’entreprise se déplace de la qualité du modèle vers la qualité de la fondation de données : un système IA n’est fiable qu’à hauteur de la fraîcheur de ses index et de l’intégrité de ses contrôles d’accès.
Cet article est l’analyse technique approfondie de la couche Enterprise Data & Knowledge du blueprint d’architecture de superintelligence d’entreprise. Ce billet définissait un modèle de référence à six couches ; celui-ci détaille comment la couche de données est réellement construite — comment les systèmes opérationnels alimentent vector stores et knowledge graphs en quasi temps réel, comment les permissions d’accès se propagent dans les index dérivés et comment les pipelines se relèvent d’une panne. Une clarification d’emblée : « prêt pour la SI » est une orientation architecturale — une infrastructure conçue pour absorber une IA de plus en plus capable — pas une norme technique établie, ni une preuve que la superintelligence existe.
Points Clés
- L’infrastructure de données prête pour la SI est une orientation architecturale — des données gouvernées, fraîches et interopérables préparées pour une IA de plus en plus capable — pas une norme certifiée ni une preuve que l’ASI existe.
- L’écart entre l’architecture de données traditionnelle et l’infrastructure prête pour l’IA est opérationnel : fraîcheur, propagation des permissions et modélisation des relations — pas capacité de stockage.
- Les vector stores et les knowledge graphs résolvent des problèmes de récupération différents ; la plupart des entreprises ont besoin des deux derrière une seule interface de récupération gouvernée.
- Le change data capture est l’épine dorsale par défaut des pipelines orientés IA ; des index obsolètes dégradent silencieusement chaque système IA en aval.
- Construisez progressivement : un domaine de données, une ingestion standardisée, une fraîcheur et des contrôles d’accès vérifiés — puis étendez.
Qu’est-ce que l’Infrastructure de Données Prête pour la SI ?
L’infrastructure de données prête pour l’IA est construite pour les charges de travail IA en tant que consommateurs de première classe — pas seulement les analystes et les dashboards. « Prête pour la SI » ajoute un horizon de planification : la même ingénierie, mais avec assez de marge pour que la fondation survive aux sauts de capacité des modèles au-dessus sans être repensée. Quatre propriétés la définissent :
- Fraîcheur. Les index dérivés se mettent à jour quand les sources changent — minutes pour les domaines chauds, pas du jour au lendemain. Un index est une copie, et les copies se dégradent.
- Interopérabilité. Une seule couche d’ingestion alimente le lakehouse, le vector store et le knowledge graph — pas un pipeline sur mesure par cas d’usage.
- Découvrabilité. Un catalogue de métadonnées rend les datasets trouvables et porte le lignage des lignes source jusqu’aux fragments indexés.
- Accès gouverné. Les permissions source se propagent dans chaque copie dérivée, y compris les embeddings — qui sont, juridiquement et pratiquement, des copies de texte.
Prête pour la SI vs. Prête pour l’IA : Une Distinction Pratique
| Dimension | Traditionnelle | Prête pour l’IA | Orientation prête pour la SI |
|---|---|---|---|
| Consommateur principal | Rapports et dashboards | Modèles ML, applications RAG | Agents plus autonomes ; modèles futurs plus capables |
| Attente de fraîcheur | Batch nocturne acceptable | Quasi temps réel sur les domaines chauds | SLO de fraîcheur explicites par domaine |
| Contrôle d’accès | Par système, réconcilié manuellement | Propagé aux index | Appliqué à la récupération ; révocation auditée |
| Modèle de données | Tables et fichiers | Tables plus embeddings | Plus relations explicites et une couche sémantique |
La réserve honnête : rien dans la colonne de droite n’est prouvé nécessaire pour la superintelligence — cette capacité n’existe pas. La direction est défendable parce que chaque propriété paie pour les systèmes IA d’aujourd’hui, quoi qu’il arrive ensuite.
Pourquoi l’Architecture de Données d’Entreprise Traditionnelle Échoue avec l’IA
Les patrimoines de données d’entreprise ont été construits pour un autre consommateur. Cinq modes de défaillance apparaissent de façon répétée quand l’IA devient une charge de première classe :
- La fraîcheur analytique n’est pas la fraîcheur opérationnelle. Un ETL nocturne produit un warehouse correct jusqu’à hier — bien pour un dashboard du lundi, faux pour un assistant IA répondant à des questions opérationnelles à 15 h.
- Les permissions ne se propagent pas. Les systèmes source portent des ACL au niveau ligne et objet ; les copies dérivées — y compris les embeddings — n’en héritent généralement aucune, laissant un système IA capable de récupérer du contenu que le demandeur n’a pas le droit de voir.
- Les relations sont implicites. Les magasins relationnels enregistrent des entités ; les relations qui comptent vivent dans des clés étrangères jamais conçues pour être parcourues, ou dans les têtes.
- Un pipeline par consommateur. Chaque nouveau cas d’usage IA obtient une extraction sur mesure, et chaque copie des mêmes données diverge silencieusement des autres.
- Pas de contrat de fraîcheur. Personne ne peut dire à quel point un index est obsolète — donc personne ne peut pleinement faire confiance à une réponse construite dessus.
Remarquez qu’il s’agit de défaillances d’implémentation, pas de questions d’évaluation. Que votre patrimoine de données soit prêt est un autre problème — notre guide sur la préparation des données pour l’IA couvre l’évaluation. Cet article suppose l’évaluation faite et couvre ce que vous construisez ensuite.
Composants Clés de l’Infrastructure de Données IA d’Entreprise
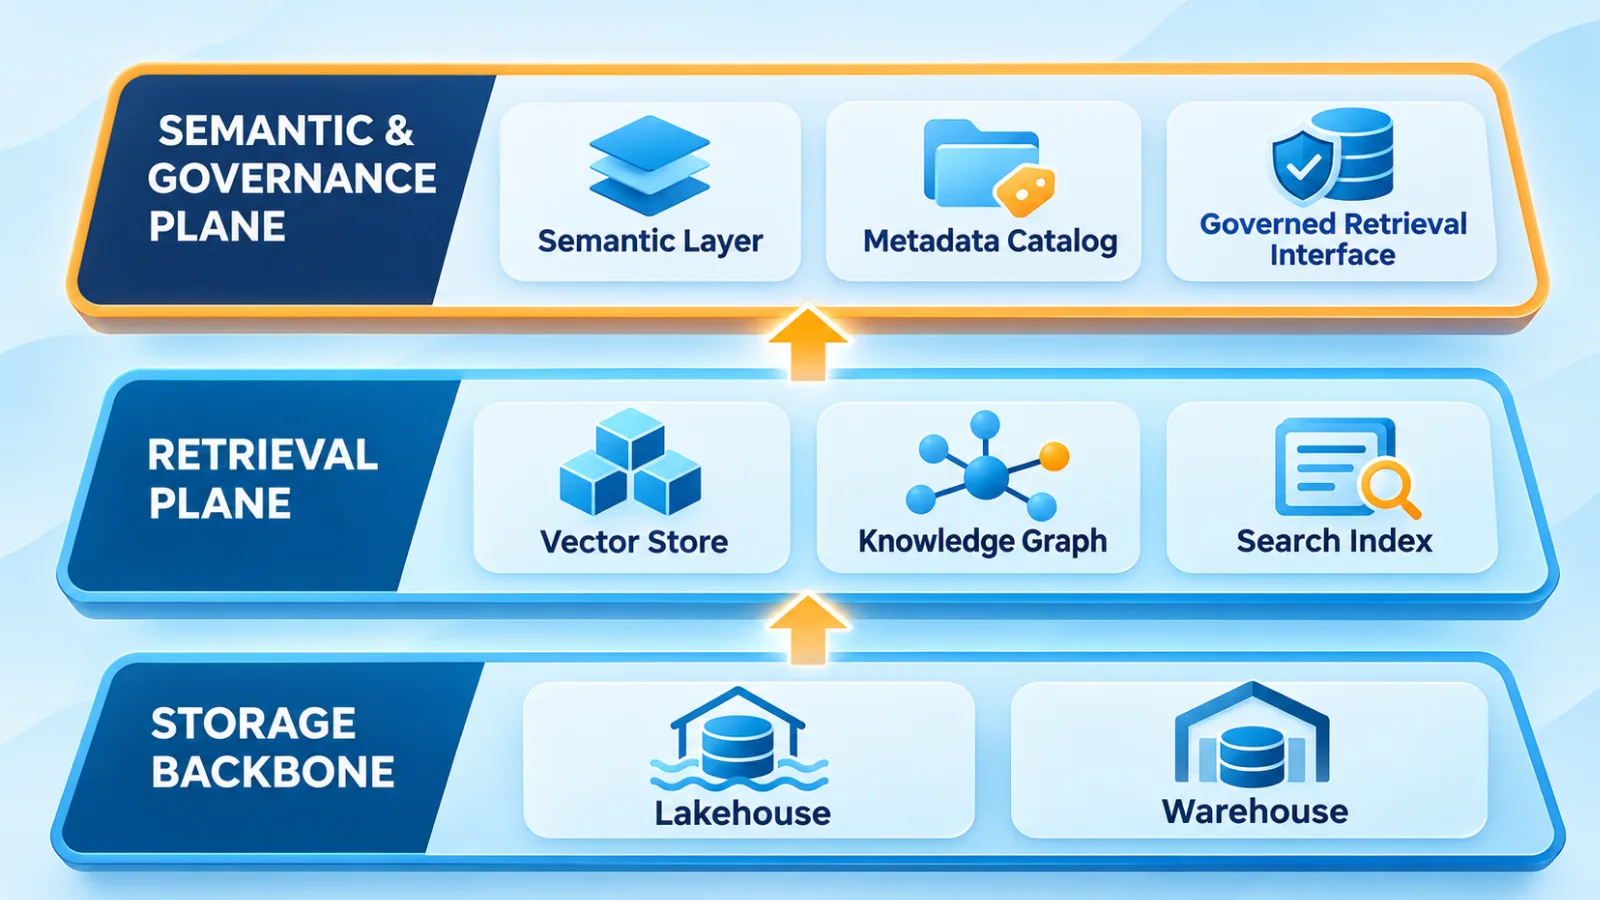
L’Épine Dorsale de Stockage
L’épine dorsale est un lakehouse — formats de table ouverts sur object storage — complété par un warehouse pour les marts gouvernés. Les données arrivent brutes, sont validées et nettoyées, puis conformées en modèles de domaine. Sa propriété décisive pour l’IA n’est pas la capacité mais la récupérabilité : l’épine dorsale est l’état canonique à partir duquel tout magasin dérivé peut être reconstruit. Quand un index est corrompu ou qu’un modèle d’embedding est remplacé, l’épine dorsale transforme la reprise en un replay plutôt qu’en une mission de sauvetage.
Le Plan de Récupération
Trois magasins dérivés servent trois formes de requête différentes :
- Vector store. Embeddings plus références de fragments pour la récupération sémantique sur contenu non structuré.
- Knowledge graph. Entités et relations typées pour le parcours et les requêtes multi-sauts.
- Search index. Récupération par mot-clé et métadonnées, toujours le bon outil pour les identifiants exacts et les filtres structurés.
La règle de conception qui garde ce plan sain : les magasins dérivés sont jetables. Ils ne sont jamais promus source de vérité, n’accumulent jamais d’état qui ne puisse être recalculé, et ne reçoivent jamais d’écritures contournant le flux de changements.
Le Plan Sémantique et de Gouvernance
Au-dessus du stockage et de la récupération se trouve la couche qui rend le système cohérent : une couche sémantique portant définitions métier et logique de métriques, un catalogue de métadonnées pour la découverte et le lignage, et l’interface de récupération gouvernée — la seule API par laquelle les applications IA interrogent. Cette interface authentifie l’appelant, applique les filtres de permissions, impose les contraintes de fraîcheur et journalise chaque accès. L’interface est la seule porte — ce qui est exactement ce qui rend la gouvernance applicable plutôt qu’aspirationnelle.
Bases de Données Vectorielles vs. Knowledge Graphs : Quand Utiliser Chacun
Ces deux magasins sont complémentaires, pas concurrents. La confusion vient de ce que les deux sont vendus comme « la couche mémoire pour l’IA » — mais ils répondent à des questions différentes.
| Dimension | Base de données vectorielle | Knowledge graph |
|---|---|---|
| Ce qu’elle stocke | Embeddings sur des fragments de contenu, avec références aux documents source | Entités et relations typées (arêtes) |
| Style de requête | Similarité sémantique — « trouve des choses comme celle-ci » | Parcours — « comment ces choses sont-elles connectées » |
| Points forts | Texte non structuré ; correspondance sémantique floue ; récupération ANN à grande échelle | Raisonnement multi-sauts ; chemins explicables ; identité d’entité stable |
| Limites | Pas de relations explicites ; résultats opaques ; les embeddings dérivent quand le modèle change | Effort de modélisation initial ; plus difficile à synchroniser ; les graphes clairsemés sous-performent |
| Mécanique de mise à jour | Re-fragmenter et ré-embedder au changement source ; suppressions propagées en tombstones | Upserts incrémentaux d’arêtes ; grands changements de topologie rejoués depuis les événements |
| Usages d’entreprise typiques | Politiques, tickets, documentation, bases de connaissances | Chaînes d’approvisionnement, structures organisationnelles, lignage de données, cartes de dépendances |
Choisissez le vector store quand la question est « trouve du contenu pertinent » — le cas d’entreprise dominant, raison pour laquelle les index vectoriels se déploient en premier. Choisissez le graphe quand la question est « suis la relation » — impact de dépendances, responsabilité organisationnelle, chaînes de provenance. Beaucoup de vraies questions sont les deux : « trouve les incidents liés à ce fournisseur » exige la récupération sémantique pour trouver les incidents et le parcours du graphe pour établir quelles relations comptent comme « liées ».
Cette intersection est où opèrent les patterns hybrides comme GraphRAG — la récupération vectorielle établit l’ensemble initial de candidats, puis le parcours du graphe l’étend et rend le résultat explicable. Le guide développeur GraphRAG décrit un pattern d’implémentation ; traitez-le comme une référence technique, pas comme l’affirmation qu’un éditeur convient à toute entreprise. Et une note de frontière : la logique d’orchestration qui décide quel magasin interroger vit une couche au-dessus du périmètre de cet article — notre guide d’architecture RAG agentique couvre cette couche de récupération et d’application.
Concevoir des Pipelines de Données Temps Réel pour l’IA
La fraîcheur est une propriété du pipeline, pas du stockage. Aucun vector store ni moteur de graphe ne peut compenser des données qui arrivent obsolètes — donc le design d’ingestion détermine tout ce qui suit.
Batch vs. CDC vs. Event Streaming
| Pattern | Latence typique | Charge sur les sources | Ordre et déduplication | Meilleur usage |
|---|---|---|---|---|
| Batch planifié (ETL/ELT) | Heures | Lectures massives périodiques | Simple | Données froides et de référence ; backfills initiaux |
| Change data capture (CDC) | Secondes à minutes | Faible — lit les commit logs | Ordre par clé | Systèmes de référence : ERP, CRM, bases centrales |
| Event streaming | Sous-seconde à secondes | Nulle après émission | Ordonné par partition ; at-least-once | Domaines émettant des événements ; télémétrie, activité |
CDC est l’épine dorsale par défaut pour la synchronisation orientée IA depuis les systèmes de référence. La capture basée sur les logs lit le commit log de la base et prend les inserts, updates et — surtout — deletes sans modifier le code applicatif, portant la sémantique de suppression que le polling naïf perd entièrement. L’event streaming convient aux domaines qui émettent déjà des événements métier ; le batch garde les chargements initiaux et les données froides. Pour la mécanique du stream processing — fenêtrage, joins étatiques, garanties de livraison — la documentation sur le stream processing avec Apache Kafka est une référence technique solide.
Indexation Incrémentale et Rafraîchissement des Embeddings
La boucle de mise à jour des index vectoriels : un événement de changement arrive, le document affecté est récupéré, re-fragmenté, et seuls les fragments modifiés sont ré-embeddés et mis à jour sous des IDs de document stables. Deux règles gardent cela honnête. D’abord, les suppressions doivent se propager en tombstones — un document supprimé à la source doit quitter l’index dans la même fenêtre de latence, sinon vous faites fuiter l’accès via des vecteurs obsolètes. Ensuite, stockez la version du modèle d’embedding avec chaque vecteur, pour que les mises à niveau du modèle se déploient en ré-embeds graduels plutôt qu’en reconstructions d’index complet qui gèlent la fraîcheur des jours durant.
Synchronisation du Knowledge Graph
Le problème difficile ici est la résolution d’entités : le même fournisseur apparaissant comme « Acme Corp », « ACME Corporation » et ID 4471 dans trois systèmes a besoin d’une identité canonique avant que les arêtes signifient quelque chose. Résolvez les entités à l’ingestion, appliquez des upserts incrémentaux d’arêtes, versionnez vos types de relations et — quand les changements de topologie sont importants — rejouez les événements plutôt que d’essayer de différer l’état du graphe contre des tables.
Cohérence de la Source de Vérité
Un writer par entité par domaine ; le lakehouse détient l’état canonique ; les magasins dérivés sont des réplicas éventuellement cohérents par design. Parce que les pannes dans ce modèle sont souvent silencieuses — un connecteur qui cesse d’émettre ressemble exactement à un système calme — des jobs de réconciliation comparent nombres d’enregistrements et checksums par fenêtre de temps pour détecter la divergence tôt. Publiez un budget de latence par domaine pour que « assez frais » soit un chiffre, pas une impression.
Retries, Replay et Dead-Letter Queues
- Consommateurs idempotents. Des upserts clés par IDs stables rendent le retraitement sûr — la base de toute stratégie de retry.
- Retries avec backoff. Les pannes transitoires — rate limits de l’API d’embedding, fautes réseau — sont retentées avec backoff exponentiel avant escalade.
- Dead-letter queues. Les messages empoisonnés vont dans une DLQ avec alerting ; une panne bruyante bat une perte silencieuse.
- Capacité de replay. Conservez événements bruts et offsets pour reconstruire tout magasin dérivé sans toucher aux systèmes source — la propriété qui rend les magasins dérivés sûrement jetables.
Surveillance de la Fraîcheur et de la Latence d’Indexation
Suivez la latence de bout en bout (commit source jusqu’à récupérable dans l’index), la latence par étape, les taux de retry, la profondeur de la DLQ et la couverture des embeddings — la part des documents indexés à la version du modèle courante. Alertez quand la latence dépasse le SLO du domaine : un pipeline mort est facile à détecter, mais un pipeline vivant avec onze heures de retard est le mode de panne qui nuit vraiment aux systèmes IA.
Architecture de Référence : Connecter les Données d’Entreprise aux Systèmes IA
Le diagramme ci-dessous assemble les composants en un flux de référence fonctionnel, des sources opérationnelles à la consommation IA gouvernée.
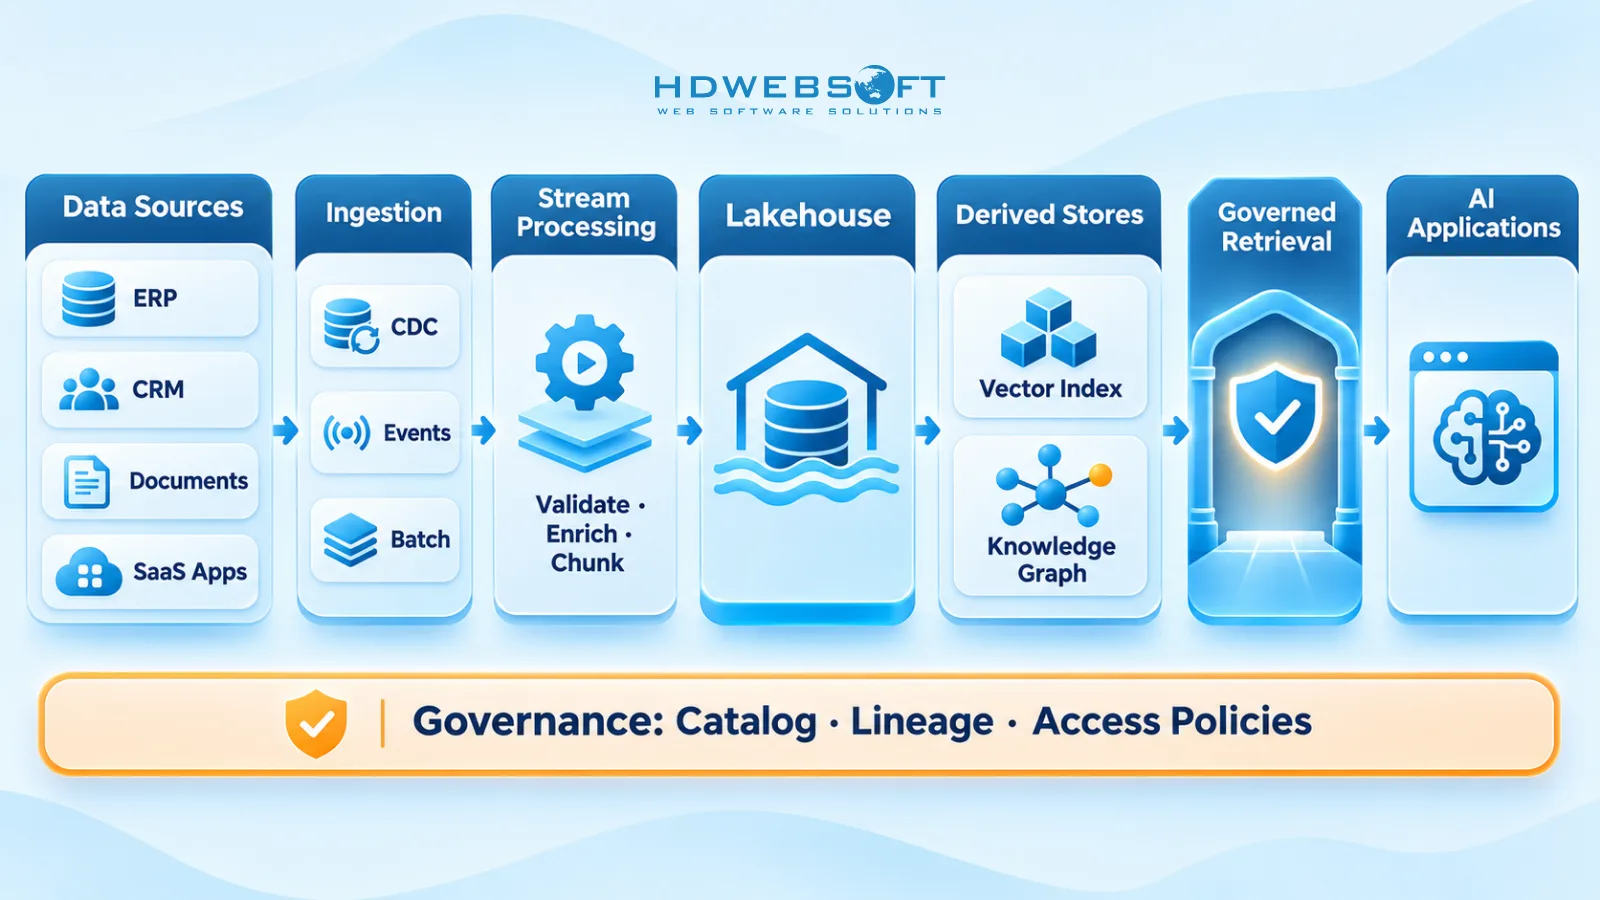
En le lisant de gauche à droite :
- Sources. ERP, CRM, gestion documentaire, applications SaaS et le warehouse existant.
- Ingestion et capture de changements. Connecteurs CDC sur les systèmes de référence, event streams là où les domaines en émettent, chargeurs batch pour le backfill et les données froides.
- Stream processing. Validation, enrichissement, classification PII, fragmentation et résolution d’entités — l’étape où les changements bruts deviennent des enregistrements consommables par l’IA.
- Lakehouse. Zones brute, nettoyée et conformée détenant l’état canonique — un writer par entité.
- Magasins dérivés. L’index vectoriel et le knowledge graph, mis à jour incrémentalement depuis le même flux de changements plutôt que rechargés.
- Plan de gouvernance. Catalogue, lignage et politiques d’accès appliqués à travers chaque étape — une couche transversale, pas un ajout.
- Interface de récupération gouvernée. La seule porte pour les applications IA : elle authentifie les appelants, applique les filtres de permissions, impose des budgets de latence sur les domaines sensibles et journalise chaque requête.
Trois chemins de synchronisation traversent cette architecture, et les nommer honnêtement compte :
- Chemin chaud : source → CDC → stream → magasins dérivés — secondes à minutes, pour les domaines où l’obsolescence corrompt les décisions.
- Chemin tiède : stream → lakehouse — minutes, gardant l’état canonique à jour.
- Chemin froid : batch → lakehouse → backfill des magasins dérivés — heures, pour les données de référence et les reconstructions.
La frontière de cohérence : les magasins dérivés sont éventuellement cohérents, et l’exactitude vient du replay plus la réconciliation — pas de faire semblant que la latence est nulle. L’interface de récupération est là où « à quel point obsolète est trop obsolète » s’impose par domaine — c’est pourquoi c’est elle, pas l’index, qui est le point de contrôle.
Vous construisez des systèmes IA sur des données d’entreprise fragmentées ? Une fondation de données fiable exige plus que connecter des bases. De l’ingestion temps réel et de la synchronisation de connaissances à la récupération gouvernée, HDWEBSOFT aide les entreprises à concevoir des solutions d’ingénierie qui connectent les systèmes d’entreprise aux applications IA modernes.
Gouvernance des Données, Lignage et Contrôles d’Accès
La gouvernance à cette couche est un ensemble de contrôles d’implémentation, pas des documents de politique :
- Propriété et enregistrement. Chaque domaine a un propriétaire nommé ; chaque dataset entrant dans l’épine dorsale est enregistré au catalogue avec son SLO de fraîcheur.
- Propagation des permissions. Les ACL source voyagent avec le contenu comme métadonnées d’index ; le filtrage au moment de la récupération les applique avant de renvoyer les résultats. Les embeddings sont des copies de texte — traitez-les comme également sensibles.
- Gestion des PII. La classification se fait à l’ingestion, dans le stream processing, pour que le masquage ou l’exclusion s’applique avant que le contenu ne soit embeddé.
- Lignage. Capturez quelles lignes source ont produit quels fragments et embeddings. Les modèles d’événements ouverts — la documentation OpenLineage en décrit un — permettent aux jobs du pipeline d’émettre le lignage de façon cohérente plutôt que de le reconstruire après.
- Révocation. La révocation d’accès se propage comme les données — événements de suppression et de mise à jour plus synchronisation périodique des ACL — et elle se teste par des exercices, pas par supposition.
- Audit. Chaque récupération par l’interface gouvernée est journalisée : identité de l’appelant, filtres appliqués et versions du corpus.
- Fraîcheur comme gouvernance. Dès qu’une réponse IA pilote une décision, les données obsolètes sont une exposition de conformité — la surveillance de latence appartient au tableau de gouvernance, pas seulement au tableau ops.
Feuille de Route d’Implémentation Pratique
Le séquencement qui marche est volontairement peu glamour — un domaine à la fois :
- Choisissez un domaine à forte valeur. Une base de connaissances support, un catalogue produits ou un seul système opérationnel — périmètre borné avec retour visible.
- Standardisez son ingestion. CDC là où la source le permet ; ce pattern de pipeline devient le gabarit de tout le reste.
- Déployez le plan de récupération pour ce domaine. Index vectoriel d’abord ; ajoutez le graphe seulement si les requêtes de relations le justifient vraiment.
- Vérifiez avant d’étendre. SLO de fraîcheur mesuré sur trafic réel, propagation des permissions prouvée par un exercice de révocation, lignage capturé de bout en bout.
- Étendez via la même couche. Les domaines adjacents rejoignent le pattern d’ingestion existant — jamais un second pipeline sur mesure.
Métriques de succès auxquelles tenir chaque étape :
| Métrique | Signal sain |
|---|---|
| Latence de fraîcheur de bout en bout | Dans le SLO du domaine — moins de cinq minutes pour les domaines chauds |
| Latence de propagation des permissions | Révocation effective en minutes, vérifiée par exercice |
| Couverture de l’index | Environ 100 % des documents du périmètre à la version d’embedding courante |
| Fiabilité du pipeline | Pannes transitoires auto-corrigées ; profondeur DLQ proche de zéro |
| Qualité de récupération en aval | Relevée à la couche application — hors du périmètre de cet article |
Conclusion
L’actif durable dans l’IA d’entreprise n’est pas le modèle — c’est la fondation de données en dessous. Les modèles seront remplacés de nombreuses fois sur la durée de vie de cette infrastructure ; la couche d’ingestion, les magasins dérivés et le plan de gouvernance sont ce qui persiste. C’est aussi ce qui fait de « prête pour la SI » une posture défendable plutôt qu’un pari spéculatif : chaque propriété décrite ici — fraîcheur, propagation des permissions, lignage, pipelines rejouables — paie pour l’IA que vous faites tourner aujourd’hui, quoi qu’il arrive dans cinq ans.
Le chemin pratique est incrémental : un domaine, un pattern de pipeline, des contrôles vérifiés, puis l’expansion. Les entreprises qui tentent de construire toute la fondation avant de mettre une IA en production n’en mettent généralement aucune en production. Les services de développement IA de HDWEBSOFT couvrent exactement cette intersection — data engineering, intégration de systèmes et livraison d’applications IA. Si vous délimitez la fondation de données de votre feuille de route IA, contactez notre équipe pour une consultation technique.
Questions Fréquentes
Qu’est-ce que l’infrastructure de données prête pour la SI ?
L’infrastructure de données prête pour la SI est une orientation architecturale : une infrastructure de données d’entreprise conçue pour servir des systèmes IA de plus en plus capables. Elle se définit par la fraîcheur (les index se mettent à jour quand les sources changent), l’interopérabilité (une seule couche d’ingestion alimente lakehouse, vector store et graphe), la découvrabilité (catalogue de métadonnées et lignage) et l’accès gouverné (les permissions source se propagent dans chaque copie dérivée). Ce n’est ni une norme technique établie ni une preuve que la superintelligence existe.
Quelle est la différence entre une base de données vectorielle et un knowledge graph pour l’IA d’entreprise ?
Une base de données vectorielle stocke des embeddings sur des fragments de contenu et répond aux questions de similarité sémantique — « trouve des choses comme celle-ci ». Un knowledge graph stocke des entités et des relations typées et répond aux questions de parcours — « comment ces choses sont-elles connectées ». La plupart des entreprises ont besoin des deux : les vector stores gèrent le texte non structuré à grande échelle, tandis que les graphes portent les relations explicites qui rendent possibles le raisonnement multi-sauts et les réponses explicables.
Les pipelines de données IA doivent-ils utiliser le traitement batch ou le change data capture ?
Les deux, selon la température du domaine. Le change data capture est le choix par défaut pour la synchronisation orientée IA depuis les systèmes de référence — il lit les commit logs, introduit une charge quasi nulle sur la source et propage les suppressions correctement. L’event streaming convient aux domaines qui émettent déjà des événements. Le batch reste adapté aux backfills initiaux et aux données vraiment froides où une fraîcheur horaire ou nocturne est acceptable.
Comment garder les embeddings vectoriels à jour quand les données source changent ?
Par l’indexation incrémentale pilotée par les événements de changement : quand un document source change, ce document est re-fragmenté, les fragments modifiés ré-embeddés et mis à jour sous des IDs stables. Les suppressions doivent se propager en tombstones — un document supprimé à la source doit quitter l’index dans la même fenêtre de latence. Stocker la version du modèle d’embedding avec chaque vecteur permet des mises à niveau du modèle en ré-embeds graduels plutôt qu’en reconstructions complètes.
Comment les permissions d’accès se propagent-elles aux vector stores et knowledge graphs ?
Les ACL source voyagent avec le contenu comme métadonnées d’index, puis sont appliquées au moment de la récupération — l’interface de récupération gouvernée authentifie l’appelant et applique les filtres de permissions avant de renvoyer les résultats. La révocation se propage comme les données : événements de suppression et de mise à jour plus synchronisation périodique des ACL, vérifiée par des exercices. Les embeddings sont des copies de texte et doivent être traités comme également sensibles.
Par où une entreprise devrait-elle commencer à construire une infrastructure de données pour l’IA ?
Par un domaine de données à forte valeur. Standardisez son ingestion — CDC là où la source le permet — déployez un plan de récupération pour ce seul domaine, et vérifiez la fraîcheur, la propagation des permissions et le lignage de bout en bout avant d’étendre aux domaines adjacents via la même couche. Les entreprises qui tentent de construire toute la fondation avant de mettre une IA en production n’en mettent généralement aucune en production.