Enterprise-KI-Dateninfrastruktur ist das System aus Pipelines, Speichern, Indizes und Governance-Kontrollen, das fragmentierte operative Daten in eine Grundlage verwandelt, die KI-Systeme zuverlässig abfragen können — Daten, die aktuell, konsistent, berechtigt und beziehungsbewusst sind. Während Modelle leistungsfähiger werden, verschiebt sich der begrenzende Faktor in der Unternehmens-KI von der Modellqualität zur Qualität der Datengrundlage: Ein KI-System ist nur so vertrauenswürdig wie die Aktualität seiner Indizes und die Integrität seiner Zugriffskontrollen.
Dieser Artikel ist der technische Deep Dive zur Enterprise Data & Knowledge Layer des Enterprise-Superintelligenz-Architektur-Blueprints. Jener Beitrag definierte ein Sechs-Schichten-Referenzmodell; dieser beschreibt, wie die Datenschicht tatsächlich gebaut wird — wie operative Systeme Vector Stores und Knowledge Graphs nahezu in Echtzeit speisen, wie Zugriffsberechtigungen in abgeleitete Indizes propagiert werden und wie Pipelines sich bei Ausfällen erholen. Eine Klarstellung vorab: „SI-fähig” ist eine Architekturorientierung — Infrastruktur, die zunehmend leistungsfähige KI aufnehmen kann — kein etablierter technischer Standard und kein Beleg dafür, dass Superintelligenz existiert.
Zentrale Erkenntnisse
- SI-fähige Dateninfrastruktur ist eine Architekturorientierung — gesteuerte, aktuelle, interoperable Daten vorbereitet für zunehmend leistungsfähige KI — kein zertifizierter Standard und kein Beleg dafür, dass ASI existiert.
- Die Lücke zwischen traditioneller Datenarchitektur und KI-bereiter Infrastruktur ist operativ: Aktualität, Berechtigungspropagation und Beziehungsmodellierung — nicht Speicherkapazität.
- Vector Stores und Knowledge Graphs lösen unterschiedliche Retrieval-Probleme; die meisten Unternehmen brauchen beide hinter einer einzigen gesteuerten Retrieval-Schnittstelle.
- Change Data Capture ist das Standard-Rückgrat für KI-orientierte Pipelines; veraltete Indizes degradieren still jedes nachgelagerte KI-System.
- Inkrementell bauen: eine Datendomäne, standardisierte Ingestion, verifizierte Aktualität und Zugriffskontrollen — dann erweitern.
Was ist SI-fähige Dateninfrastruktur?
KI-bereite Dateninfrastruktur ist für KI-Workloads als erstklassige Konsumenten gebaut — nicht nur für Analysten und Dashboards. „SI-fähig” fügt einen Planungshorizont hinzu: dieselbe Technik, aber mit genug Reserve, damit das Fundament Leistungssprünge der Modelle darüber ohne Redesign übersteht. Vier Eigenschaften definieren es:
- Aktualität. Abgeleitete Indizes aktualisieren sich, wenn Quellen sich ändern — Minuten für heiße Domänen, nicht über Nacht. Ein Index ist eine Kopie, und Kopien veralten.
- Interoperabilität. Eine Ingestionsschicht speist Lakehouse, Vector Store und Knowledge Graph — nicht eine Maßanfertigung pro Use Case.
- Auffindbarkeit. Ein Metadatenkatalog macht Datasets auffindbar und trägt Lineage von Quellzeilen bis zu indexierten Chunks.
- Gesteuerte Zugriffe. Quellberechtigungen propagieren in jede abgeleitete Kopie, einschließlich Embeddings — die rechtlich und praktisch Kopien von Text sind.
SI-fähig vs. KI-bereit: Eine praktische Unterscheidung
| Dimension | Traditionell | KI-bereit | SI-fähige Orientierung |
|---|---|---|---|
| Hauptkonsument | Berichte und Dashboards | ML-Modelle, RAG-Anwendungen | Autonomere Agenten; zukünftige, leistungsfähigere Modelle |
| Aktualitätserwartung | Nächtlicher Batch akzeptabel | Nahe Echtzeit für heiße Domänen | Explizite Aktualitäts-SLOs pro Domäne |
| Zugriffskontrolle | Pro System, manuell abgeglichen | In Indizes propagiert | Zum Abrufzeitpunkt erzwungen; Widerruf auditiert |
| Datenmodell | Tabellen und Dateien | Tabellen plus Embeddings | Plus explizite Beziehungen und eine semantische Schicht |
Das ehrliche Vorbehalt: Nichts in der rechten Spalte ist als notwendig für Superintelligenz bewiesen — diese Fähigkeit existiert nicht. Die Richtung ist vertretbar, weil jede Eigenschaft sich für heutige KI-Systeme auszahlt, egal was später kommt.
Warum traditionelle Unternehmensdatenarchitektur bei KI scheitert
Unternehmensdatenbestände wurden für einen anderen Konsumenten gebaut. Fünf Fehlermuster treten wiederholt auf, wenn KI zur erstklassigen Workload wird:
- Analytische Aktualität ist keine operative Aktualität. Nächtliches ETL produziert ein Warehouse, das bis gestern korrekt ist — gut für ein Montag-Dashboard, falsch für einen KI-Assistenten, der um 15 Uhr operative Fragen beantwortet.
- Berechtigungen propagieren nicht. Quellsysteme tragen ACLs auf Zeilen- und Objektebene; abgeleitete Kopien — einschließlich Embeddings — erben typischerweise keine davon, was ein KI-System hinterlässt, das Inhalte abrufen kann, die der Anfragende nicht sehen darf.
- Beziehungen sind implizit. Relationale Speicher erfassen Entitäten; die Beziehungen, die zählen, leben in Fremdschlüsseln, die nie für Traversierung gedacht waren, oder in Köpfen.
- Eine Pipeline pro Konsument. Jeder neue KI-Use-Case bekommt eine eigene Extraktion, und jede Kopie derselben Daten divergiert still von den anderen.
- Kein Aktualitätsvertrag. Niemand kann sagen, wie veraltet ein Index ist — also kann niemand einer Antwort voll vertrauen, die darauf aufbaut.
Beachten Sie: Das sind Implementierungsfehler, keine Assessment-Fragen. Ob Ihr Datenbestand bereit ist, ist ein anderes Problem — unser Leitfaden zu KI-Datenbereitschaft behandelt die Bewertung. Dieser Artikel setzt voraus, dass das Assessment abgeschlossen ist, und behandelt, was Sie als Nächstes bauen.
Kernkomponenten der Enterprise-KI-Dateninfrastruktur
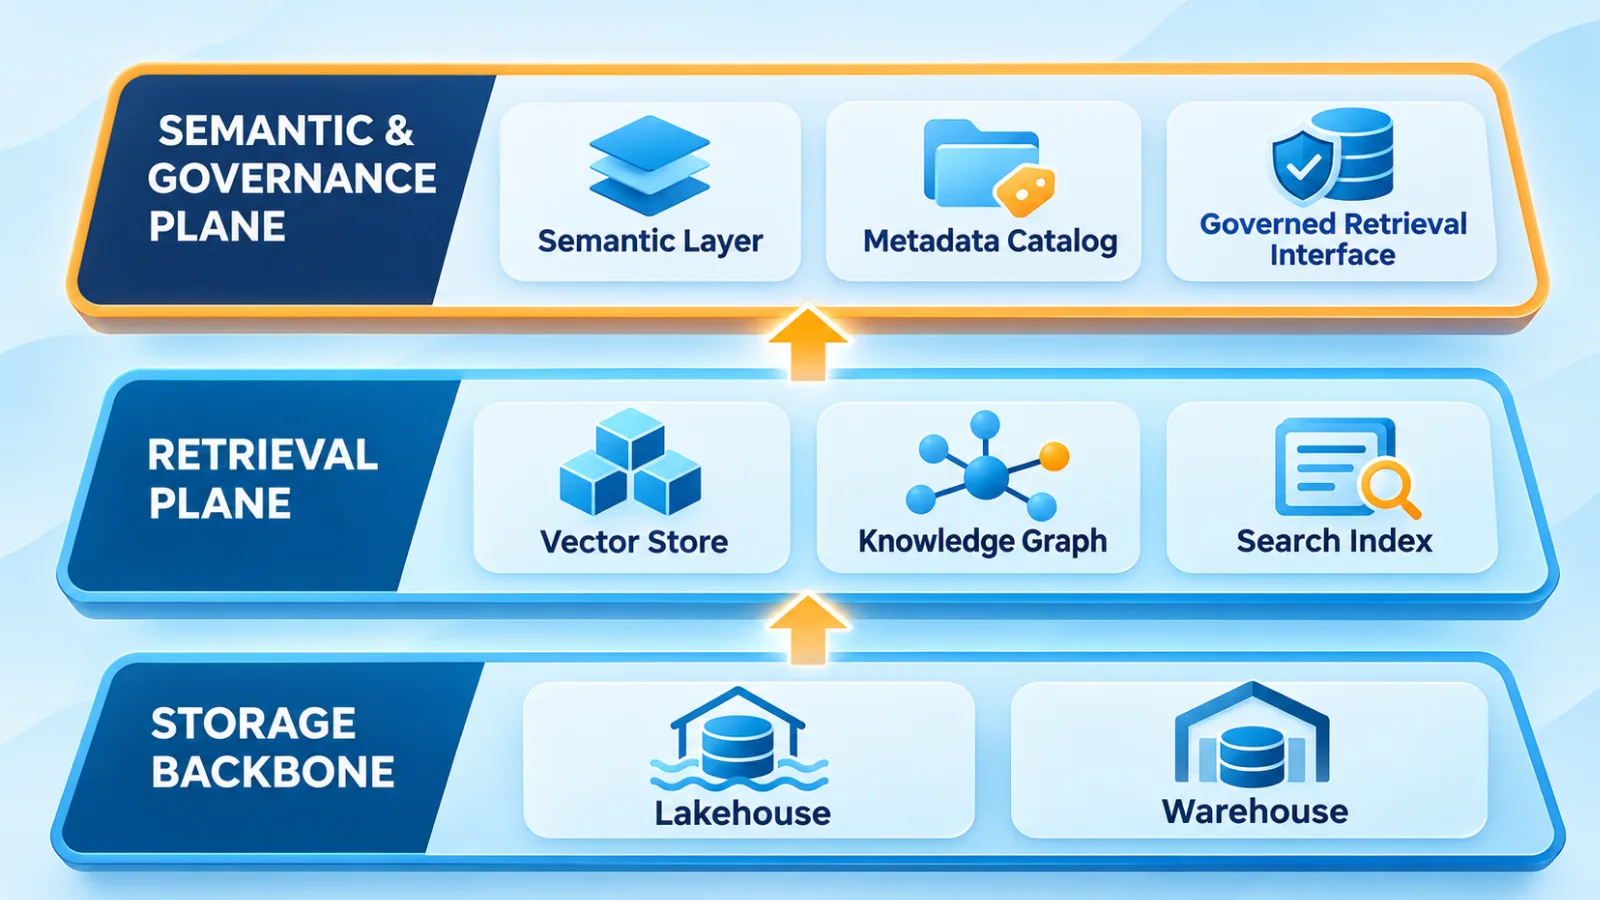
Das Speicher-Rückgrat
Das Rückgrat ist ein Lakehouse — offene Tabellenformate auf Objektspeicher — ergänzt durch ein Warehouse für gesteuerte Marts. Daten landen roh, werden validiert und bereinigt und dann in Domänenmodelle konformiert. Ihre entscheidende Eigenschaft für KI ist nicht Kapazität, sondern Wiederherstellbarkeit: Das Rückgrat ist der kanonische Zustand, aus dem jeder abgeleitete Speicher neu gebaut werden kann. Wenn ein Index korrupt ist oder ein Embedding-Modell ersetzt wird, macht das Rückgrat die Wiederherstellung zu einem Replay statt zu einer Rettungsaktion.
Die Retrieval-Ebene
Drei abgeleitete Speicher bedienen drei unterschiedliche Abfrageformen:
- Vector Store. Embeddings plus Chunk-Referenzen für semantisches Retrieval über unstrukturierte Inhalte.
- Knowledge Graph. Entitäten und typisierte Beziehungen für Traversierung und Multi-Hop-Abfragen.
- Search Index. Keyword- und Metadaten-Retrieval, weiterhin das richtige Werkzeug für exakte Identifikatoren und strukturierte Filter.
Die Designregel, die diese Ebene gesund hält: Abgeleitete Speicher sind wegwerfbar. Sie werden nie zur Source of Truth befördert, sammeln nie Zustand an, der nicht neu berechnet werden kann, und empfangen nie Schreibvorgänge, die den Änderungs-Feed umgehen.
Die semantische und Governance-Ebene
Über Speicher und Retrieval liegt die Schicht, die das System kohärent macht: eine semantische Schicht mit Geschäftsdefinitionen und Metriklogik, ein Metadatenkatalog für Discovery und Lineage, und das gesteuerte Retrieval-Interface — die einzige API, über die KI-Anwendungen abfragen. Dieses Interface authentifiziert den Aufrufer, wendet Berechtigungsfilter an, erzwingt Aktualitätsrestriktionen und protokolliert jeden Zugriff. Das Interface ist die einzige Tür — und genau das macht Governance durchsetzbar statt aspirational.
Vektordatenbanken vs. Knowledge Graphs: Wann welche einsetzen
Diese beiden Speicher sind komplementär, nicht konkurrierend. Die Verwirrung entsteht, weil beide als „Gedächtnisschicht für KI” vermarktet werden — aber sie beantworten unterschiedliche Fragen.
| Dimension | Vektordatenbank | Knowledge Graph |
|---|---|---|
| Was sie speichert | Embeddings über Inhalts-Chunks, mit Referenzen auf Quelldokumente | Entitäten und typisierte Beziehungen (Kanten) |
| Abfragestil | Semantische Ähnlichkeit — „finde Dinge wie dieses” | Traversierung — „wie sind diese Dinge verbunden” |
| Stärken | Unstrukturierter Text; unscharfes semantisches Matching; ANN-Retrieval im großen Maßstab | Multi-Hop-Reasoning; erklärbare Pfade; stabile Entitätsidentität |
| Grenzen | Keine expliziten Beziehungen; Ergebnisse sind opak; Embeddings driften bei Modellwechsel | Modellierungsaufwand zu Beginn; schwerer synchron zu halten; dünne Graphen performen schlecht |
| Update-Mechanik | Re-Chunken und Re-Embeden bei Quelländerung; Löschungen propagieren als Tombstones | Inkrementelle Kanten-Upserts; große Topologieänderungen werden aus Events replayed |
| Typische Enterprise-Anwendungen | Richtlinien, Tickets, Dokumentation, Wissensdatenbanken | Lieferketten, Organisationsstrukturen, Daten-Lineage, Abhängigkeitskarten |
Wählen Sie den Vector Store, wenn die Frage „finde relevanten Inhalt” lautet — der dominante Enterprise-Fall, weshalb Vektorindizes zuerst eingeführt werden. Wählen Sie den Graphen, wenn die Frage „verfolge die Beziehung” lautet — Abhängigkeitsauswirkungen, organisatorische Verantwortung, Herkunftsketten. Viele echte Fragen sind beides: „finde die Vorfälle zu diesem Lieferanten” braucht semantisches Retrieval, um Vorfälle zu finden, und Graph-Traversierung, um festzulegen, welche Beziehungen als „zugehörig” zählen.
An dieser Schnittstelle arbeiten Hybridmuster wie GraphRAG — Vektor-Retrieval bildet die initiale Kandidatenmenge, dann erweitert Graph-Traversierung sie und macht das Ergebnis erklärbar. Der GraphRAG-Entwicklerleitfaden beschreibt ein Implementierungsmuster; betrachten Sie ihn als technische Referenz, nicht als Behauptung, ein Anbieter passe zu jedem Unternehmen. Und ein Grenzhinweis: Die Orchestrierungslogik, die entscheidet, welcher Speicher abgefragt wird, liegt eine Ebene über dem Rahmen dieses Artikels — unser Leitfaden zu agentischer RAG-Architektur behandelt diese Retrieval- und Anwendungsebene.
Echtzeit-Datenpipelines für KI designen
Aktualität ist eine Pipeline-Eigenschaft, keine Speichereigenschaft. Kein Vector Store und keine Graph-Engine können Daten kompensieren, die veraltet ankommen — also bestimmt das Ingestions-Design alles Nachgelagerte.
Batch vs. CDC vs. Event Streaming
| Muster | Typische Latenz | Last auf Quellen | Reihenfolge und Deduplizierung | Beste Passung |
|---|---|---|---|---|
| Geplanter Batch (ETL/ELT) | Stunden | Periodische Massenlesevorgänge | Einfach | Kalte und Referenzdaten; initiale Backfills |
| Change Data Capture (CDC) | Sekunden bis Minuten | Gering — liest Commit-Logs | Reihenfolge pro Schlüssel | Systems of Record: ERP, CRM, Kerndatenbanken |
| Event Streaming | Subsekunde bis Sekunden | Keine nach Emission | Partitionsgeordnet; at-least-once | Domänen mit Event-Emission; Telemetrie, Aktivität |
CDC ist das Standard-Rückgrat für KI-orientierte Synchronisation aus Systems of Record. Log-basierte Erfassung liest das Commit-Log der Datenbank und nimmt Inserts, Updates und — entscheidend — Deletes auf, ohne Anwendungscode zu ändern, und trägt die Löschsemantik, die naives Polling vollständig verliert. Event Streaming passt zu Domänen, die bereits Geschäftsereignisse emittieren; Batch besitzt weiterhin Erstlade und kalte Daten. Für Stream-Processing-Mechanik — Windowing, Stateful Joins, Zustellgarantien — ist die Dokumentation zu Stream Processing mit Apache Kafka eine solide technische Referenz.
Inkrementelle Indexierung und Embedding-Auffrischung
Die Update-Schleife für Vektorindizes: Ein Änderungsereignis trifft ein, das betroffene Dokument wird geholt, neu gechunkt, und nur die geänderten Chunks werden neu embedded und unter stabilen Dokument-IDs aktualisiert. Zwei Regeln halten das ehrlich. Erstens müssen Löschungen als Tombstones propagieren — ein im Quellsystem gelöschtes Dokument muss den Index innerhalb desselben Latenzfensters verlassen, sonst leaken Sie Zugriff über veraltete Vektoren. Zweitens speichern Sie die Embedding-Modellversion bei jedem Vektor, damit Modell-Upgrades als gestufte Re-Embeds ausgerollt werden statt als Vollindex-Neuaufbau, der die Aktualität tagelang einfriert.
Knowledge-Graph-Synchronisation
Das schwierige Problem hier ist Entity Resolution: Derselbe Lieferant, der in drei Systemen als „Acme Corp”, „ACME Corporation” und ID 4471 erscheint, braucht kanonische Identität, bevor Kanten etwas bedeuten. Lösen Sie Entitäten bei der Ingestion auf, wenden Sie inkrementelle Kanten-Upserts an, versionieren Sie Beziehungstypen und — bei großen Topologieänderungen — replayen Sie Events, statt zu versuchen, Graph-Zustand gegen Tabellen zu diffen.
Source-of-Truth-Konsistenz
Ein Writer pro Entität pro Domäne; der Lakehouse hält den kanonischen Zustand; abgeleitete Speicher sind per Design eventually consistent. Da Fehler in diesem Modell oft still sind — ein Connector, der aufhört zu emittieren, sieht exakt aus wie ein ruhiges System — vergleichen Reconciliation-Jobs Datensatzanzahlen und Checksums pro Zeitfenster, um Divergenz früh zu erkennen. Veröffentlichen Sie ein Latenz-Budget pro Domäne, damit „aktuell genug” eine Zahl ist und kein Gefühl.
Retries, Replay und Dead-Letter Queues
- Idempotente Consumer. Upserts mit Schlüssel über stabile IDs machen Wiederaufbereitung sicher — die Basis jeder Retry-Strategie.
- Backoff-Retries. Transiente Fehler — Rate-Limits der Embedding-API, Netzwerkfehler — werden mit exponentiellem Backoff wiederholt, bevor sie eskalieren.
- Dead-Letter Queues. Poison Messages gehen in eine DLQ mit Alerting; ein lauter Fehler schlägt einen stillen Verlust.
- Replay-Fähigkeit. Rohereignisse und Offsets aufbewahren, damit jeder abgeleitete Speicher neu gebaut werden kann, ohne Quellsysteme anzufassen — die Eigenschaft, die abgeleitete Speicher sicher wegwerfbar macht.
Monitoring von Aktualität und Indexierungslatenz
Verfolgen Sie End-to-End-Latenz (Quell-Commit bis abrufbar im Index), Latenz pro Stufe, Retry-Raten, DLQ-Tiefe und Embedding-Coverage — den Anteil indexierter Dokumente auf der aktuellen Modellversion. Alertieren Sie, wenn die Latenz das Domänen-SLO verletzt: Eine tote Pipeline ist leicht zu erkennen, aber eine Pipeline, die lebt und elf Stunden zurückliegt, ist das Fehlermuster, das KI-Systeme wirklich schadet.
Referenzarchitektur: Unternehmensdaten mit KI-Systemen verbinden
Das Diagramm unten setzt die Komponenten zu einem funktionierenden Referenzfluss zusammen, von operativen Quellen bis zum gesteuerten KI-Konsum.
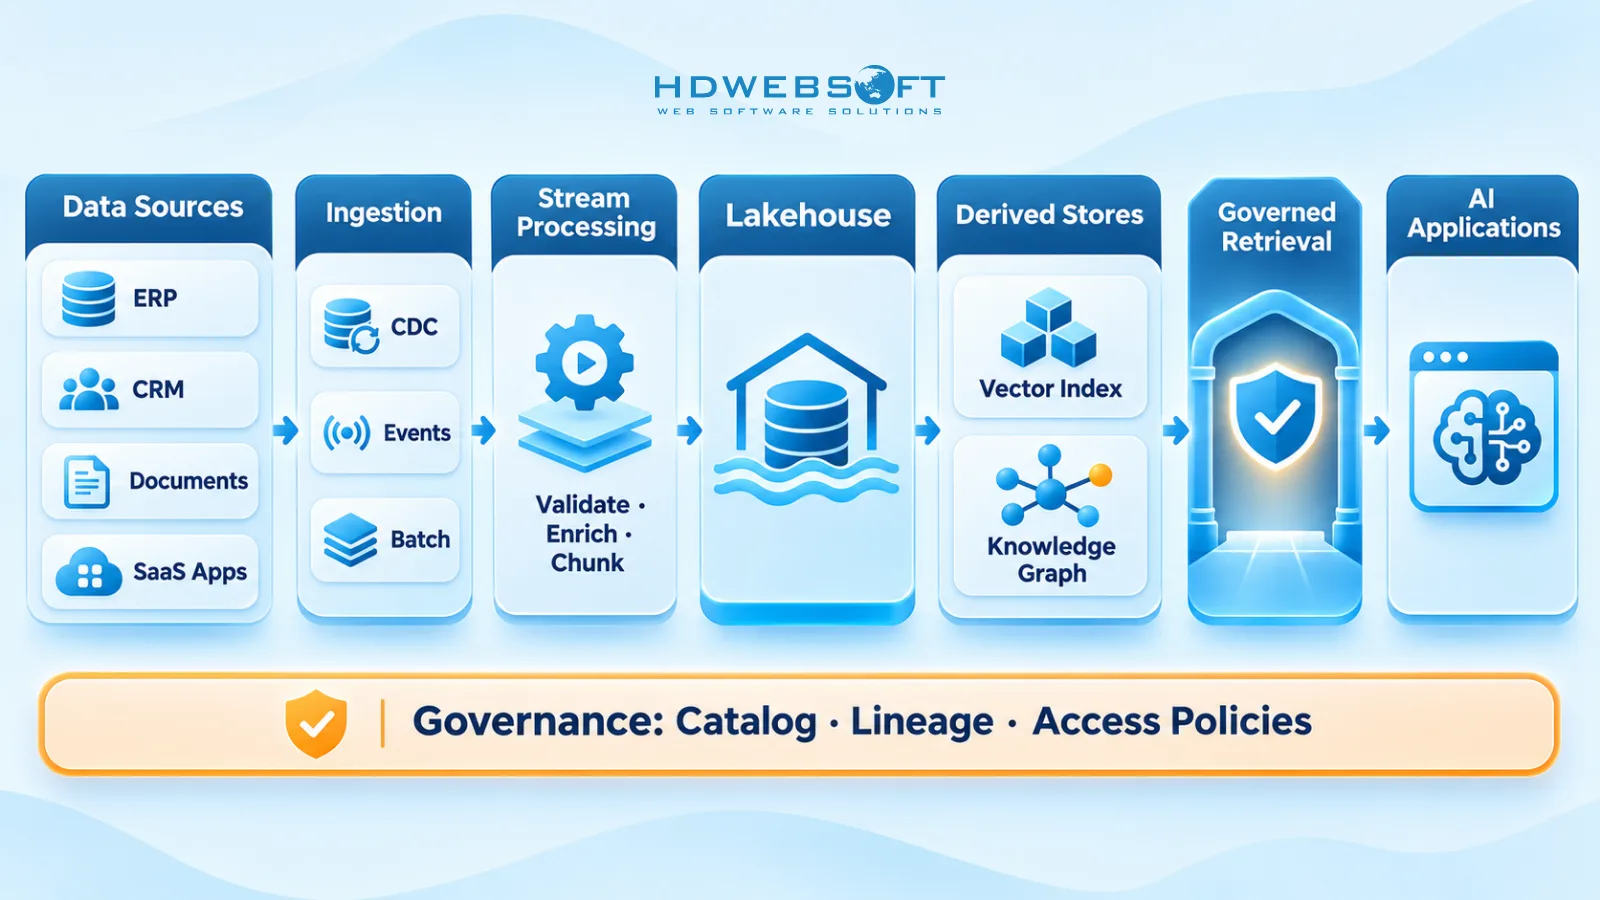
Von links nach rechts gelesen:
- Quellen. ERP, CRM, Dokumentenmanagement, SaaS-Anwendungen und das bestehende Warehouse.
- Ingestion und Change Capture. CDC-Connectoren auf Systems of Record, Event Streams, wo Domänen sie emittieren, Batch-Loader für Backfill und kalte Daten.
- Stream Processing. Validierung, Anreicherung, PII-Klassifikation, Chunking und Entity Resolution — die Stufe, in der rohe Änderungen zu KI-konsumierbaren Datensätzen werden.
- Lakehouse. Roh-, bereinigte und konformierte Zonen, die den kanonischen Zustand halten — ein Writer pro Entität.
- Abgeleitete Speicher. Vektorindex und Knowledge Graph, inkrementell aus demselben Änderungs-Feed aktualisiert statt neu geladen.
- Governance-Ebene. Katalog, Lineage und Zugriffsrichtlinien über jede Stufe hinweg angewendet — eine Querschnittsebene, kein Nachträgliches.
- Gesteuertes Retrieval-Interface. Die einzige Tür für KI-Anwendungen: Es authentifiziert Aufrufer, wendet Berechtigungsfilter an, erzwingt Latenz-Budgets auf sensiblen Domänen und protokolliert jede Abfrage.
Drei Synchronisationspfade laufen durch diese Architektur, und sie ehrlich zu benennen zählt:
- Heißer Pfad: Quelle → CDC → Stream → abgeleitete Speicher — Sekunden bis Minuten, für Domänen, in denen Veralterung Entscheidungen korrumpiert.
- Warmer Pfad: Stream → Lakehouse — Minuten, hält den kanonischen Zustand aktuell.
- Kalte Pfad: Batch → Lakehouse → Backfill abgeleiteter Speicher — Stunden, für Referenzdaten und Neuaufbauten.
Die Konsistenzgrenze: Abgeleitete Speicher sind eventually consistent, und Korrektheit kommt aus Replay plus Reconciliation — nicht davon, Latenz null zu spielen. Das Retrieval-Interface ist, wo „wie veraltet ist zu veraltet” pro Domäne erzwungen wird — weshalb es, nicht der Index, der Kontrollpunkt ist.
Sie bauen KI-Systeme auf fragmentierten Unternehmensdaten? Ein verlässliches Datenfundament erfordert mehr als das Verbinden von Datenbanken. Von Echtzeit-Ingestion und Wissenssynchronisation bis zu gesteuertem Retrieval hilft HDWEBSOFT Unternehmen, Engineering-Lösungen zu entwerfen, die Unternehmenssysteme mit modernen KI-Anwendungen verbinden.
Daten-Governance, Lineage und Zugriffskontrollen
Governance auf dieser Ebene ist ein Satz von Implementierungskontrollen, keine Richtliniendokumente:
- Ownership und Registrierung. Jede Domäne hat eine namentliche Besitzerin; jedes Dataset, das ins Rückgrat eintritt, wird im Katalog mit seinem Aktualitäts-SLO registriert.
- Berechtigungspropagation. Quell-ACLs reisen mit dem Inhalt als Index-Metadaten; Retrieval-Zeit-Filterung wendet sie an, bevor Ergebnisse zurückkommen. Embeddings sind Kopien von Text — behandeln Sie sie als gleichermaßen sensibel.
- PII-Behandlung. Klassifikation passiert bei der Ingestion, im Stream Processing, damit Maskierung oder Ausschluss greifen, bevor Inhalt je embedded wird.
- Lineage. Erfassen Sie, welche Quellzeilen welche Chunks und Embeddings erzeugten. Offene Eventmodelle — die OpenLineage-Dokumentation beschreibt eines — lassen Pipeline-Jobs Lineage konsistent emittieren statt später rekonstruieren zu müssen.
- Widerruf. Zugriffswiderruf propagiert wie Daten — Lösch- und Aktualisierungsereignisse plus periodische ACL-Synchronisation — und wird mit Übungen getestet, nicht angenommen.
- Audit. Jeder Abruf über das gesteuerte Interface wird protokolliert: Aufruferidentität, angewendete Filter und Corpus-Versionen.
- Aktualität als Governance. Sobald eine KI-Antwort eine Entscheidung treibt, sind veraltete Daten ein Compliance-Risiko — Latenz-Monitoring gehört aufs Governance-Dashboard, nicht nur ans Ops-Board.
Praktische Implementierungs-Roadmap
Die Sequenzierung, die funktioniert, ist bewusst unglamourös — eine Domäne nach der anderen:
- Wählen Sie eine hochwertige Domäne. Eine Support-Wissensdatenbank, einen Produktkatalog oder ein einzelnes operatives System — begrenzter Umfang mit sichtbarem Nutzen.
- Standardisieren Sie ihre Ingestion. CDC, wo die Quelle es unterstützt; dieses Pipeline-Muster wird zur Vorlage für alles danach.
- Richten Sie die Retrieval-Ebene für diese Domäne ein. Vektorindex zuerst; den Graphen nur hinzufügen, wenn Beziehungsabfragen es wirklich rechtfertigen.
- Verifizieren Sie vor der Erweiterung. Aktualitäts-SLO an echtem Traffic gemessen, Berechtigungspropagation durch eine Widerruf-Übung bewiesen, Lineage durchgängig erfasst.
- Erweitern Sie über dieselbe Schicht. Angrenzende Domänen treten dem bestehenden Ingestionsmuster bei — nie eine zweite Maß-Pipeline.
Erfolgsmetriken, an die jeder Schritt gebunden wird:
| Metrik | Gesundes Signal |
|---|---|
| End-to-End-Aktualitätslatenz | Innerhalb des Domänen-SLO — unter fünf Minuten für heiße Domänen |
| Latenz der Berechtigungspropagation | Widerruf in Minuten wirksam, durch Übung verifiziert |
| Index-Coverage | Etwa 100 % der in-scope Dokumente auf der aktuellen Embedding-Version |
| Pipeline-Zuverlässigkeit | Transiente Fehler selbst-geheilt; DLQ-Tiefe nahe null |
| Nachgelagerte Retrieval-Qualität | In der Anwendungsebene angesiedelt — außerhalb des Rahmens dieses Artikels |
Fazit
Das dauerhafte Asset in der Unternehmens-KI ist nicht das Modell — es ist die Datengrundlage darunter. Modelle werden über die Lebensdauer dieser Infrastruktur viele Male getauscht; die Ingestionsschicht, die abgeleiteten Speicher und die Governance-Ebene sind das, was bleibt. Das macht „SI-fähig” auch zu einer vertretbaren Haltung statt zu einer spekulativen Wette: Jede hier beschriebene Eigenschaft — Aktualität, Berechtigungspropagation, Lineage, replaybare Pipelines — zahlt sich für die KI aus, die Sie heute betreiben, egal was in fünf Jahren kommt.
Der praktische Weg ist inkrementell: eine Domäne, ein Pipeline-Muster, verifizierte Kontrollen, dann Erweiterung. Unternehmen, die versuchen, das gesamte Fundament zu bauen, bevor sie irgendeine KI in Produktion bringen, bringen meist gar nichts in Produktion. HDWEBSOFTs KI-Entwicklungsdienstleistungen decken genau diese Schnittstelle ab — Data Engineering, Systemintegration und KI-Anwendungslieferung. Wenn Sie die Datengrundlage für Ihre KI-Roadmap skizzieren, kontaktieren Sie unser Team für eine technische Beratung.
Häufige Fragen
Was ist SI-fähige Dateninfrastruktur?
SI-fähige Dateninfrastruktur ist eine Architekturorientierung: Unternehmensdateninfrastruktur, die für zunehmend leistungsfähige KI-Systeme ausgelegt ist. Sie wird definiert durch Aktualität (Indizes aktualisieren sich bei Quelländerungen), Interoperabilität (eine Ingestionsschicht versorgt Lakehouse, Vector Store und Graph), Auffindbarkeit (Metadatenkatalog und Lineage) und gesteuerten Zugriff (Quellberechtigungen propagieren in jede abgeleitete Kopie). Sie ist kein etablierter technischer Standard und kein Beleg dafür, dass Superintelligenz existiert.
Was ist der Unterschied zwischen einer Vektordatenbank und einem Knowledge Graph für Enterprise-KI?
Eine Vektordatenbank speichert Embeddings über Inhalts-Chunks und beantwortet semantische Ähnlichkeitsfragen — „finde Dinge wie dieses”. Ein Knowledge Graph speichert Entitäten und typisierte Beziehungen und beantwortet Traversierungsfragen — „wie sind diese Dinge verbunden”. Die meisten Unternehmen brauchen beides: Vector Stores verarbeiten unstrukturierten Text in großem Maßstab, während Graphen die expliziten Beziehungen tragen, die Multi-Hop-Reasoning und erklärbare Antworten ermöglichen.
Sollten KI-Datenpipelines Batch-Verarbeitung oder Change Data Capture nutzen?
Beides, abgestimmt auf die Temperatur der Domäne. Change Data Capture ist die Standardwahl für KI-orientierte Synchronisation aus Systems of Record — es liest Commit-Logs, erzeugt fast keine Quelllast und propagiert Löschungen korrekt. Event Streaming passt zu Domänen, die bereits Events emittieren. Batch bleibt richtig für initiale Backfills und wirklich kalte Daten, bei denen stündliche oder nächtliche Aktualität akzeptabel ist.
Wie hält man Vektor-Embeddings aktuell, wenn sich Quelldaten ändern?
Durch inkrementelle Indexierung auf Basis von Änderungsereignissen: Wenn ein Quelldokument sich ändert, wird dieses Dokument neu gechunkt, die geänderten Chunks neu embedded und unter stabilen IDs aktualisiert. Löschungen müssen als Tombstones propagieren — ein im Quellsystem gelöschtes Dokument muss den Index innerhalb desselben Latenzfensters verlassen. Das Speichern der Embedding-Modellversion bei jedem Vektor ermöglicht Modell-Upgrades als gestufte Re-Embeds statt Komplett-Neuaufbau.
Wie werden Zugriffsberechtigungen auf Vector Stores und Knowledge Graphs übertragen?
Quell-ACLs werden mit dem Inhalt als Index-Metadaten mitgeführt und zur Abrufzeit durchgesetzt — das gesteuerte Retrieval-Interface authentifiziert den Aufrufer und wendet Berechtigungsfilter an, bevor Ergebnisse zurückgegeben werden. Widerruf propagiert wie Daten: Lösch- und Aktualisierungsereignisse plus periodische ACL-Synchronisation, durch Übungen verifiziert. Embeddings sind Kopien von Text und müssen als gleichermaßen sensibel behandelt werden.
Wo sollte ein Unternehmen mit dem Aufbau KI-bereiter Dateninfrastruktur beginnen?
Mit einer hochwertigen Datendomäne. Standardisieren Sie deren Ingestion — CDC, wo die Quelle es unterstützt — richten Sie eine Retrieval-Ebene nur für diese Domäne ein und verifizieren Sie Aktualität, Berechtigungspropagation und durchgängige Lineage, bevor Sie über dieselbe Schicht auf angrenzende Domänen erweitern. Unternehmen, die versuchen, das gesamte Fundament zu bauen, bevor sie irgendeine KI in Produktion bringen, bringen meist gar nichts in Produktion.