Hạ tầng dữ liệu AI doanh nghiệp là hệ thống gồm pipeline, kho lưu trữ, index và các cơ chế kiểm soát, biến dữ liệu vận hành phân mảnh thành một nền tảng mà hệ thống AI có thể truy vấn một cách đáng tin — dữ liệu tươi mới, nhất quán, có phân quyền và nhận biết quan hệ. Khi model ngày càng mạnh, điểm nghẽn trong AI doanh nghiệp đang dịch chuyển từ chất lượng model sang chất lượng nền tảng dữ liệu: một hệ thống AI chỉ đáng tin bằng độ tươi của index và tính toàn vẹn của kiểm soát truy cập mà nó dựa vào.
Bài viết này là phần phân tích kỹ thuật chuyên sâu cho tầng Enterprise Data & Knowledge trong bản thiết kế kiến trúc superintelligence doanh nghiệp. Bài kia định nghĩa mô hình tham chiếu sáu tầng; bài này đi vào chi tiết tầng dữ liệu được xây như thế nào — các hệ thống vận hành cung cấp dữ liệu cho vector store và knowledge graph gần thời gian thực ra sao, quyền truy cập lan truyền vào index dẫn xuất thế nào, và pipeline phục hồi khi lỗi ra sao. Một lưu ý ngay từ đầu: “sẵn sàng cho SI” là một định hướng kiến trúc — hạ tầng được thiết kế để hấp thụ các hệ thống AI ngày càng mạnh — chứ không phải một tiêu chuẩn kỹ thuật đã được xác lập, và cũng không phải bằng chứng rằng superintelligence đã tồn tại.
Điểm Chính
- Hạ tầng dữ liệu sẵn sàng cho SI là một định hướng kiến trúc — dữ liệu được quản trị, tươi mới, tương tác tốt, chuẩn bị cho AI ngày càng mạnh — chứ không phải tiêu chuẩn đã chứng nhận hay bằng chứng rằng ASI tồn tại.
- Khoảng cách giữa kiến trúc dữ liệu truyền thống và hạ tầng sẵn sàng cho AI nằm ở khía cạnh vận hành: độ tươi, lan truyền quyền, và mô hình hóa quan hệ — không phải dung lượng lưu trữ.
- Vector store và knowledge graph giải hai bài toán truy xuất khác nhau; phần lớn doanh nghiệp cần cả hai đứng sau một giao diện truy xuất có kiểm soát duy nhất.
- Change data capture là xương sống mặc định cho pipeline phục vụ AI; index cũ kỹ âm thầm làm suy giảm mọi hệ thống AI phía dưới.
- Xây dựng từng bước: một miền dữ liệu, thu nạp được chuẩn hóa, độ tươi và kiểm soát truy cập đã kiểm chứng — rồi mới mở rộng.
Hạ Tầng Dữ Liệu Sẵn Sàng Cho SI Là Gì?
Hạ tầng dữ liệu AI-ready là hạ tầng được xây cho khối lượng công việc AI như một đối tượng tiêu dùng hạng nhất — không chỉ cho nhà phân tích và dashboard. “SI-ready” thêm một chân trời lập kế hoạch: cùng kỹ thuật đó, nhưng có đủ dư địa để nền tảng tồn tại qua các bước nhảy năng lực của model phía trên mà không cần thiết kế lại. Bốn thuộc tính định nghĩa nó:
- Độ tươi (freshness). Index dẫn xuất cập nhật khi nguồn thay đổi — vài phút cho miền nóng, không phải qua đêm. Index là một bản sao, và bản sao thì lỗi thời.
- Khả năng tương tác (interoperability). Một nền tảng thu nạp chung cung cấp cho lakehouse, vector store và knowledge graph — không phải một pipeline riêng cho mỗi trường hợp sử dụng.
- Khả năng khám phá (discoverability). Catalog metadata giúp tìm được dataset và mang theo lineage từ dòng nguồn đến chunk đã được index.
- Truy cập có kiểm soát (governed access). Quyền từ hệ thống nguồn lan truyền sang mọi bản sao dẫn xuất, kể cả embedding — vốn về pháp lý lẫn thực tế đều là bản sao của văn bản.
Sẵn Sàng Cho SI So Với Sẵn Sàng Cho AI: Một Cách Phân Biệt Thực Dụng
| Tiêu chí | Truyền thống | AI-ready | Định hướng SI-ready |
|---|---|---|---|
| Đối tượng tiêu dùng chính | Báo cáo và dashboard | Model ML, ứng dụng RAG | Agent tự chủ hơn; model tương lai mạnh hơn |
| Kỳ vọng độ tươi | Batch qua đêm là chấp nhận được | Gần thời gian thực cho miền nóng | SLO độ tươi tường minh theo từng miền |
| Kiểm soát truy cập | Theo từng hệ thống, đối chiếu thủ công | Lan truyền sang index | Ép tại thời điểm truy xuất; thu hồi có audit |
| Mô hình dữ liệu | Bảng và file | Bảng cộng embedding | Cộng thêm quan hệ tường minh và tầng ngữ nghĩa |
Lưu ý trung thực: không có gì trong cột bên phải được chứng minh là cần thiết cho superintelligence — năng lực đó không tồn tại. Định hướng này đáng đi theo vì mọi thuộc tính đều đem lại lợi ích cho hệ thống AI hiện tại, bất kể tương lai ra sao.
Vì Sao Kiến Trúc Dữ Liệu Doanh Nghiệp Truyền Thống Thất Bại Với AI
Hệ thống dữ liệu doanh nghiệp được xây cho một đối tượng tiêu dùng khác. Năm kiểu thất bại lặp đi lặp lại khi AI trở thành khối lượng công việc hạng nhất:
- Độ tươi kiểu phân tích không phải độ tươi kiểu vận hành. ETL qua đêm tạo ra warehouse đúng tính đến hôm qua — ổn cho dashboard sáng thứ Hai, sai cho trợ lý AI trả lời câu hỏi vận hành lúc 3 giờ chiều.
- Quyền không lan truyền. Hệ thống nguồn mang ACL cấp dòng và cấp đối tượng; bản sao dẫn xuất — kể cả embedding — thường không kế thừa gì, khiến hệ thống AI có thể truy xuất nội dung mà người yêu cầu không được quyền xem.
- Quan hệ chỉ ngầm ẩn. Kho quan hệ lưu thực thể; các quan hệ quan trọng nằm trong khóa ngoại không bao giờ được thiết kế để duyệt, hoặc trong đầu con người.
- Mỗi đối tượng tiêu dùng một pipeline. Mỗi trường hợp sử dụng AI mới lại có một luồng trích xuất riêng, và mọi bản sao của cùng một dữ liệu lặng lẽ khác nhau.
- Không có hợp đồng độ tươi. Không ai nói được index cũ đến mức nào — nên không ai hoàn toàn tin được câu trả lời dựa trên nó.
Lưu ý rằng đây là những lỗi triển khai, không phải câu hỏi đánh giá. Việc hệ thống dữ liệu của bạn đã sẵn sàng hay chưa là một bài toán khác — hướng dẫn về độ sẵn sàng dữ liệu AI trình bày phần đánh giá. Bài này giả định việc đánh giá đã xong và đi vào phần bạn xây tiếp theo.
Các Thành Phần Cốt Lõi Của Hạ Tầng Dữ Liệu AI Doanh Nghiệp
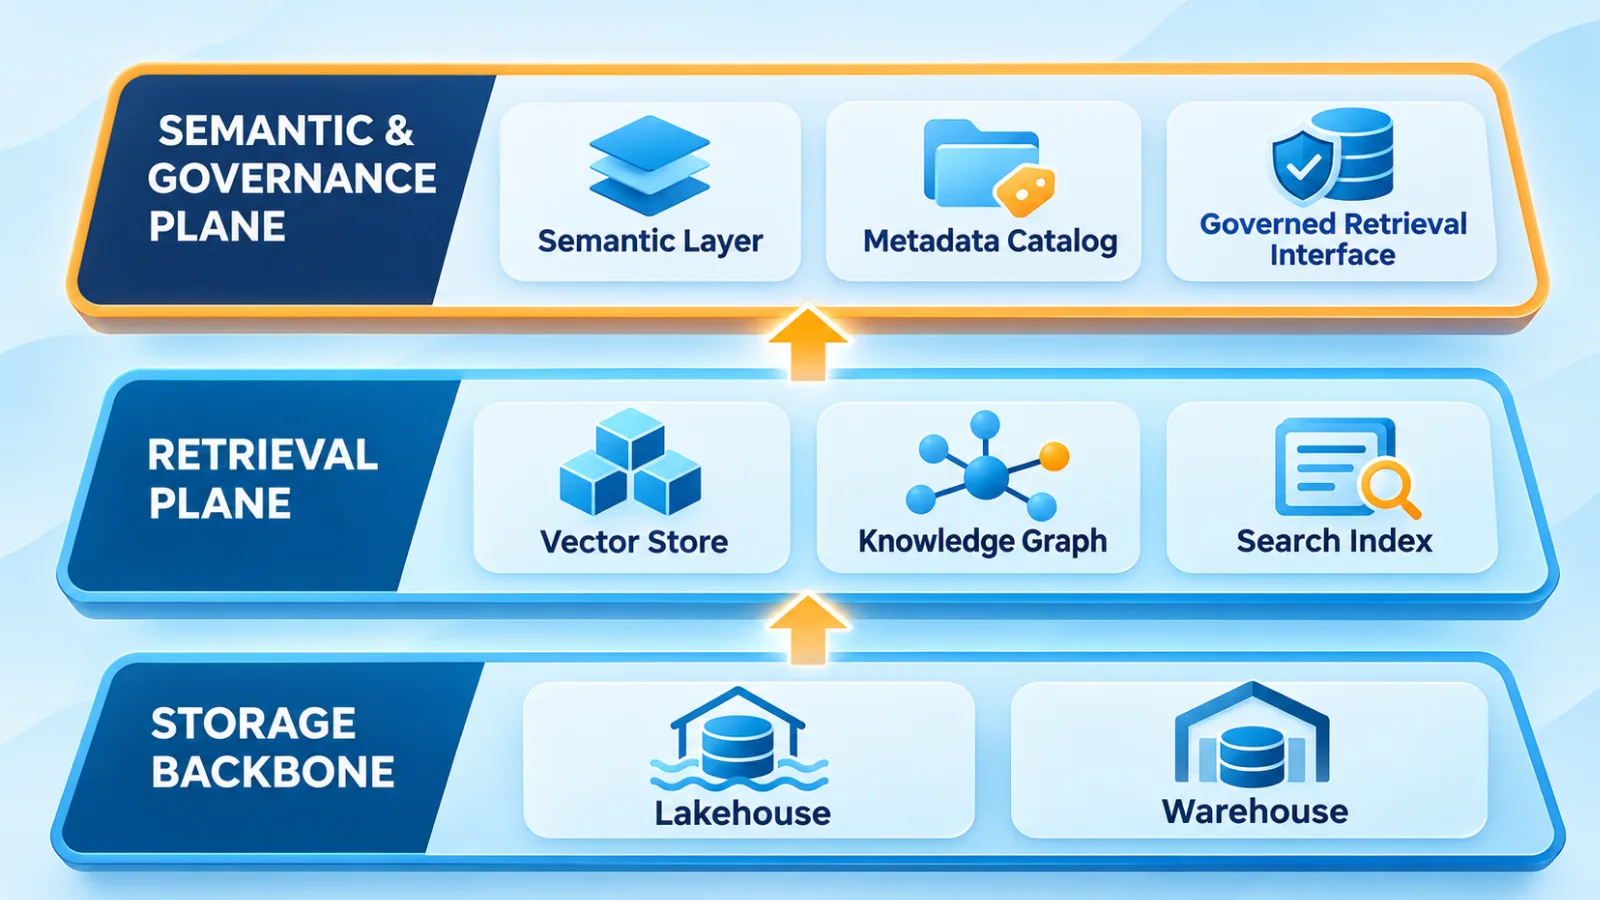
Xương Sống Lưu Trữ
Xương sống là một lakehouse — định dạng bảng mở trên object storage — bổ sung bởi warehouse cho các mart đã quản trị. Dữ liệu đổ về dạng thô, được kiểm tra và làm sạch, rồi chuẩn hóa thành mô hình miền. Thuộc tính quyết định của nó đối với AI không phải dung lượng mà là khả năng khôi phục: xương sống là trạng thái chuẩn để dựng lại mọi kho dẫn xuất. Khi một index hỏng hay một model embedding được thay thế, xương sống biến việc phục hồi thành một lần replay thay vì một chiến dịch cứu hộ.
Tầng Truy Xuất
Ba kho dẫn xuất phục vụ ba dạng truy vấn khác nhau:
- Vector store. Embedding cộng tham chiếu chunk cho truy xuất ngữ nghĩa trên nội dung phi cấu trúc.
- Knowledge graph. Thực thể và quan hệ có kiểu cho duyệt đồ thị và truy vấn nhiều bước.
- Search index. Truy xuất từ khóa và metadata, vẫn là công cụ đúng cho định danh chính xác và bộ lọc cấu trúc.
Nguyên tắc thiết kế giữ tầng này khỏe mạnh: kho dẫn xuất là đồ dùng một lần — có thể vứt bỏ. Chúng không bao giờ được nâng lên làm nguồn chuẩn xác, không tích lũy trạng thái không thể tính lại, và không nhận ghi trực tiếp lách luồng thay đổi.
Tầng Ngữ Nghĩa Và Quản Trị
Phía trên lưu trữ và truy xuất là tầng khiến hệ thống mạch lạc: một tầng ngữ nghĩa mang định nghĩa nghiệp vụ và logic chỉ số, một catalog metadata cho khám phá và lineage, và giao diện truy xuất có kiểm soát (governed retrieval interface) — API duy nhất mà ứng dụng AI truy vấn qua. Giao diện đó xác thực người gọi, áp bộ lọc quyền, ép ràng buộc độ tươi và ghi nhật ký mọi truy cập. Giao diện là cánh cửa duy nhất — và đó chính xác là lý do quản trị có thể ép được chứ không chỉ là nguyện vọng.
Vector Database So Với Knowledge Graph: Khi Nào Dùng Cái Nào
Hai kho này bổ sung cho nhau, không cạnh tranh. Sự nhầm lẫn xuất phát từ việc cả hai đều được marketing như “tầng bộ nhớ cho AI” — nhưng chúng trả lời những câu hỏi khác nhau.
| Tiêu chí | Vector database | Knowledge graph |
|---|---|---|
| Lưu gì | Embedding của các chunk nội dung, kèm tham chiếu tới tài liệu nguồn | Thực thể và quan hệ có kiểu (cạnh) |
| Kiểu truy vấn | Tương đồng ngữ nghĩa — “tìm thứ giống thứ này” | Duyệt quan hệ — “những thứ này liên kết ra sao” |
| Điểm mạnh | Văn bản phi cấu trúc; đối sánh mờ theo ngữ nghĩa; tìm láng giềng gần đúng (ANN) ở quy mô lớn | Suy luận nhiều bước; đường đi có thể giải thích; định danh thực thể ổn định |
| Giới hạn | Không có quan hệ tường minh; kết quả không trong suốt; embedding trôi khi model thay đổi | Chi phí mô hình hóa ban đầu; khó đồng bộ; graph thưa thì kém hiệu quả |
| Cơ chế cập nhật | Chia lại chunk và tạo lại embedding khi nguồn đổi; thao tác xóa lan truyền dạng tombstone | Upsert cạnh từng phần; thay đổi topology lớn thì replay từ sự kiện |
| Trường hợp sử dụng điển hình | Chính sách, ticket, tài liệu, kho tri thức | Chuỗi cung ứng, cơ cấu tổ chức, lineage dữ liệu, bản đồ phụ thuộc |
Chọn vector store khi câu hỏi là “tìm nội dung liên quan” — trường hợp phổ biến nhất trong doanh nghiệp, và là lý do vector index được triển khai đầu tiên. Chọn graph khi câu hỏi là “lần theo quan hệ” — tác động phụ thuộc, trách nhiệm tổ chức, chuỗi nguồn gốc. Nhiều câu hỏi thực tế là cả hai: “tìm các sự cố liên quan đến nhà cung cấp này” cần truy xuất ngữ nghĩa để tìm sự cố và duyệt graph để xác định quan hệ nào được tính là “liên quan”.
Điểm giao đó là nơi các mẫu hybrid như GraphRAG hoạt động — truy xuất vector xác lập tập ứng viên ban đầu, rồi duyệt graph để mở rộng và khiến kết quả có thể giải thích. Hướng dẫn dành cho nhà phát triển GraphRAG mô tả một mẫu triển khai; hãy coi nó là tài liệu kỹ thuật tham khảo, không phải khẳng định một vendor nào đó phù hợp với mọi doanh nghiệp. Và một lưu ý ranh giới: logic điều phối quyết định truy vấn kho nào nằm ở tầng trên phạm vi bài này — hướng dẫn về kiến trúc agentic RAG trình bày tầng truy xuất và ứng dụng đó.
Thiết Kế Pipeline Dữ Liệu Thời Gian Thực Cho AI
Độ tươi là thuộc tính của pipeline, không phải của kho lưu trữ. Không vector store hay graph engine nào bù được dữ liệu đến đã cũ — nên thiết kế thu nạp quyết định mọi thứ phía dưới.
Batch So Với CDC So Với Event Streaming
| Mẫu | Độ trễ điển hình | Tải lên nguồn | Thứ tự & khử trùng | Phù hợp nhất |
|---|---|---|---|---|
| Batch theo lịch (ETL/ELT) | Hàng giờ | Đợt đọc lớn định kỳ | Đơn giản | Dữ liệu nguội/tham chiếu; nạp bù ban đầu |
| Change data capture (CDC) | Vài giây đến vài phút | Thấp — đọc commit log | Thứ tự theo khóa | Hệ thống gốc: ERP, CRM, database lõi |
| Event streaming | Dưới giây đến vài giây | Không có sau khi phát | Thứ tự theo partition; at-least-once | Miền đã phát sự kiện; telemetry, hoạt động |
CDC là xương sống mặc định cho đồng bộ phục vụ AI từ hệ thống gốc. Cơ chế đọc log lấy commit log của database và nhận các thao tác thêm, cập nhật và — quan trọng — cả xóa mà không sửa code ứng dụng, mang theo ngữ nghĩa xóa mà polling đơn thuần bỏ sót hoàn toàn. Event streaming phù hợp với miền đã phát sự kiện nghiệp vụ; batch vẫn giữ phần nạp ban đầu và dữ liệu nguội. Về cơ chế stream processing — xử lý theo cửa sổ, join có trạng thái, đảm bảo giao nhận — tài liệu về stream processing với Apache Kafka là tham khảo kỹ thuật chắc chắn.
Index Từng Phần Và Làm Mới Embedding
Vòng cập nhật cho vector index: sự kiện thay đổi đến, tài liệu bị ảnh hưởng được lấy ra, chia lại thành các chunk, và chỉ các chunk thay đổi mới được tạo lại embedding rồi upsert theo ID tài liệu ổn định. Hai quy tắc giữ quy trình này đúng. Thứ nhất, thao tác xóa phải lan truyền dưới dạng tombstone — tài liệu bị xóa ở nguồn phải rời index trong cùng cửa sổ độ trễ, nếu không bạn đang rò rỉ quyền truy cập qua vector cũ. Thứ hai, lưu phiên bản model embedding cùng mỗi vector, để nâng cấp model chạy dạng tạo lại embedding từng phần thay vì dựng lại toàn index — vốn sẽ đóng băng độ tươi nhiều ngày.
Đồng Bộ Knowledge Graph
Bài toán khó ở đây là phân giải thực thể (entity resolution): cùng một nhà cung cấp xuất hiện là “Acme Corp”, “ACME Corporation” và ID 4471 ở ba hệ thống cần định danh chuẩn trước khi cạnh có nghĩa. Phân giải thực thể ngay tại bước thu nạp, áp upsert cạnh từng phần, đặt phiên bản cho kiểu quan hệ, và — khi thay đổi topology lớn — replay sự kiện thay vì cố so sánh trạng thái graph với bảng.
Nhất Quán Nguồn Chuẩn Xác
Một bên ghi cho mỗi thực thể trong mỗi miền; lakehouse giữ trạng thái chuẩn; kho dẫn xuất là bản sao nhất quán-cuối-cùng theo thiết kế. Vì lỗi trong mô hình này thường âm thầm — một connector ngừng phát trông hệt một hệ thống yên ả — tác vụ đối chiếu (reconciliation) so sánh số bản ghi và checksum theo từng cửa sổ thời gian để phát hiện lệch sớm. Công bố ngân sách độ trễ theo từng miền để “đủ tươi” là một con số chứ không phải cảm giác.
Thử Lại, Replay Và Hàng Đợi Thư Chết
- Consumer lũy đẳng (idempotent). Upsert gắn khóa bằng ID ổn định khiến xử lý lại an toàn — nền của mọi chiến lược thử lại.
- Thử lại với backoff. Lỗi tạm thời — giới hạn tốc độ của API embedding, lỗi mạng — được thử lại với backoff lũy tiến mũ trước khi leo thang.
- Hàng đợi thư chết (dead-letter queue — DLQ). Thông điệp không xử lý được đi vào DLQ kèm cảnh báo; lỗi ồn ào tốt hơn rơi rụng âm thầm.
- Khả năng replay. Giữ sự kiện thô và offset để dựng lại bất kỳ kho dẫn xuất nào mà không chạm hệ thống nguồn — thuộc tính khiến kho dẫn xuất có thể vứt bỏ an toàn.
Giám Sát Độ Tươi Và Độ Trễ Index
Theo dõi độ trễ đầu-cuối (commit ở nguồn tới khi truy xuất được trong index), độ trễ từng giai đoạn, tỷ lệ thử lại, độ sâu DLQ, và độ phủ embedding — tỷ lệ tài liệu đã index ở phiên bản model hiện tại. Cảnh báo khi độ trễ vượt SLO miền: pipeline chết dễ phát hiện, nhưng pipeline còn sống mà trễ mười một giờ mới là kiểu lỗi thực sự làm hại hệ thống AI.
Kiến Trúc Tham Chiếu: Kết Nối Dữ Liệu Doanh Nghiệp Tới Hệ Thống AI
Sơ đồ dưới lắp ráp các thành phần thành một luồng tham chiếu hoạt động, từ nguồn vận hành đến tiêu dùng AI có kiểm soát.
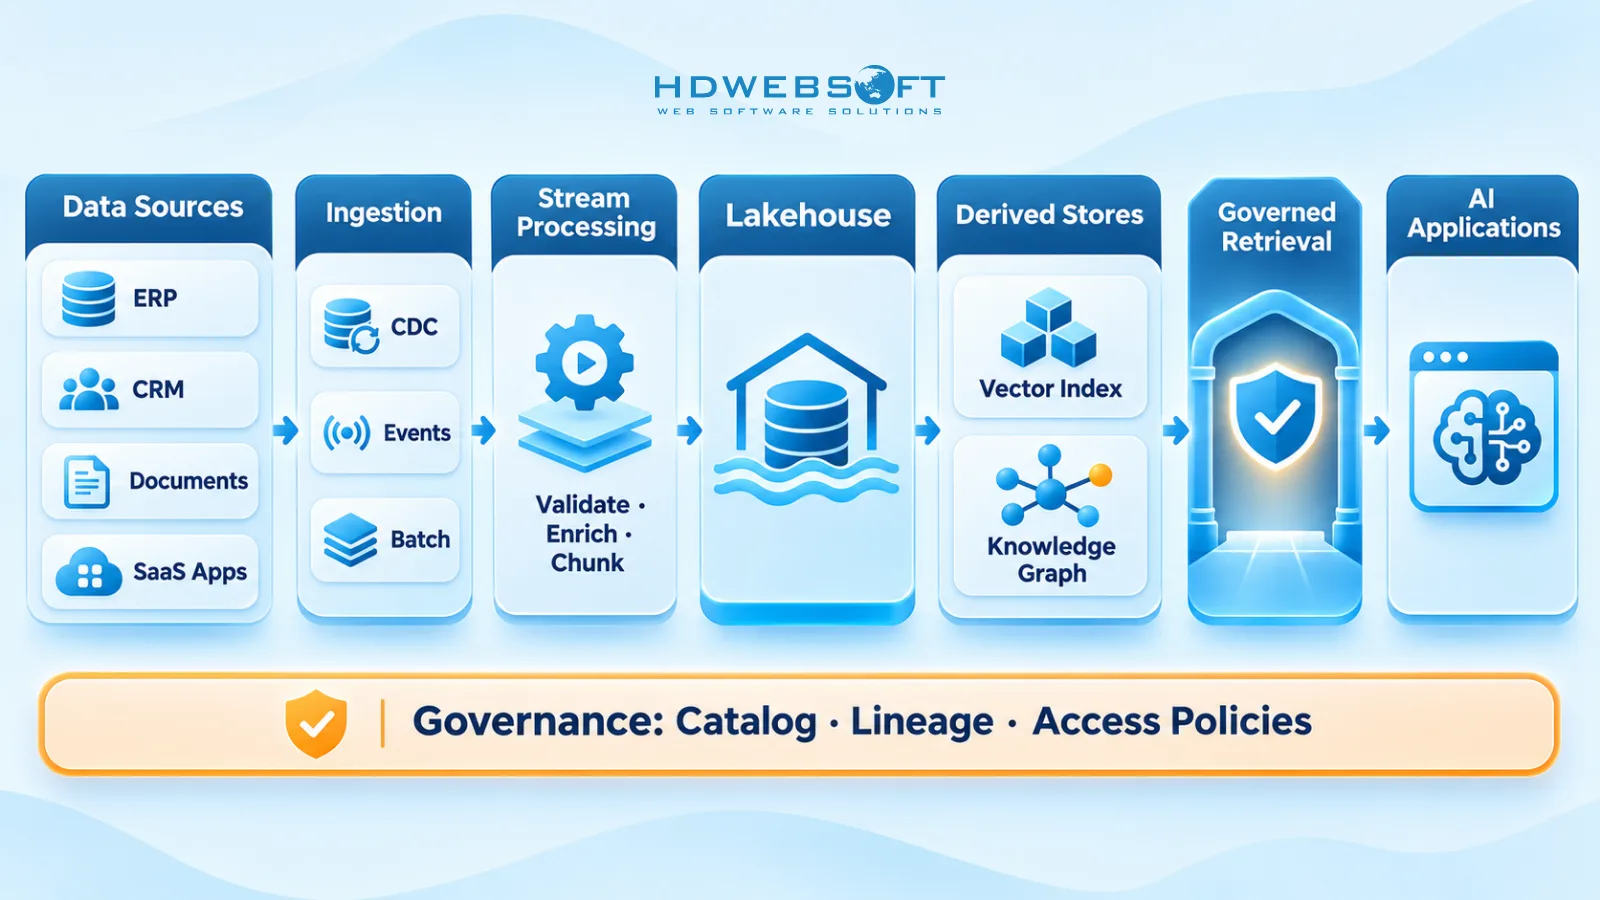
Đọc từ trái sang phải:
- Nguồn. ERP, CRM, quản lý tài liệu, ứng dụng SaaS, và warehouse hiện có.
- Thu nạp và bắt thay đổi. Connector CDC trên hệ thống gốc, luồng sự kiện nơi miền phát sự kiện, trình nạp batch cho nạp bù và dữ liệu nguội.
- Xử lý luồng. Kiểm tra, làm giàu, phân loại PII, chia chunk, và phân giải thực thể — giai đoạn nơi thay đổi thô trở thành bản ghi AI dùng được.
- Lakehouse. Các vùng thô, đã làm sạch, đã chuẩn hóa giữ trạng thái chuẩn — một bên ghi cho mỗi thực thể.
- Kho dẫn xuất. Vector index và knowledge graph, cập nhật từng phần từ cùng một luồng thay đổi thay vì nạp lại.
- Tầng quản trị. Catalog, lineage và chính sách truy cập áp xuyên suốt mọi giai đoạn — một tầng xuyên cắt, không phải bổ sung sau.
- Giao diện truy xuất có kiểm soát. Cánh cửa duy nhất cho ứng dụng AI: xác thực người gọi, áp bộ lọc quyền, ép ngân sách độ trễ trên miền nhạy cảm, và ghi nhật ký mọi truy vấn.
Ba đường đồng bộ chạy qua kiến trúc này, và gọi tên chúng một cách trung thực rất quan trọng:
- Đường nóng: nguồn → CDC → luồng → kho dẫn xuất — vài giây đến vài phút, cho miền nơi dữ liệu cũ làm hỏng quyết định.
- Đường ấm: luồng → lakehouse — vài phút, giữ trạng thái chuẩn luôn mới.
- Đường nguội: batch → lakehouse → nạp bù kho dẫn xuất — hàng giờ, cho dữ liệu tham chiếu và dựng lại.
Ranh giới nhất quán: kho dẫn xuất là nhất quán-cuối-cùng, và độ đúng đến từ khả năng replay cộng đối chiếu — không phải từ việc giả vờ độ trễ bằng không. Giao diện truy xuất là nơi “cũ đến mức nào là quá cũ” được ép theo từng miền, và đó là lý do nó — chứ không phải index — là điểm kiểm soát.
Đang xây hệ thống AI trên dữ liệu doanh nghiệp phân mảnh? Một nền tảng dữ liệu đáng tin đòi hỏi nhiều hơn là nối các database. Từ thu nạp thời gian thực và đồng bộ tri thức đến truy xuất có kiểm soát, HDWEBSOFT giúp doanh nghiệp thiết kế giải pháp kỹ thuật kết nối hệ thống doanh nghiệp với ứng dụng AI hiện đại.
Quản Trị Dữ Liệu, Lineage Và Kiểm Soát Truy Cập
Quản trị ở tầng này là một tập kiểm soát triển khai, không phải văn bản chính sách:
- Sở hữu và đăng ký. Mỗi miền có chủ rõ ràng; mọi dataset vào xương sống đều đăng ký trong catalog kèm SLO độ tươi.
- Lan truyền quyền. ACL nguồn đi cùng nội dung dưới dạng metadata index; lọc tại thời điểm truy xuất áp chúng trước khi trả kết quả. Embedding là bản sao của văn bản — coi chúng nhạy cảm tương đương.
- Xử lý PII. Phân loại ngay tại bước thu nạp, bên trong xử lý luồng, để che hoặc loại trừ áp dụng trước khi nội dung được tạo embedding.
- Lineage. Ghi lại dòng nguồn nào tạo ra chunk và embedding nào. Các mô hình sự kiện mở — tài liệu OpenLineage mô tả một mô hình — cho phép tác vụ pipeline phát lineage nhất quán thay vì dựng lại sau.
- Thu hồi quyền. Thu hồi quyền lan truyền như dữ liệu — sự kiện xóa/cập nhật cộng đồng bộ ACL định kỳ — và được kiểm tra bằng diễn tập, không phải giả định.
- Audit. Mọi truy xuất qua giao diện có kiểm soát được ghi nhật ký kèm định danh người gọi, bộ lọc đã áp và phiên bản kho dữ liệu.
- Độ tươi như một phần quản trị. Khi câu trả lời AI điều khiển một quyết định, dữ liệu cũ là rủi ro tuân thủ — giám sát độ trễ thuộc dashboard quản trị, không chỉ bảng vận hành.
Lộ Trình Triển Khai Thực Tế
Trình tự hiệu quả cố tình không hào nhoáng — từng miền một:
- Chọn một miền giá trị cao. Kho tri thức hỗ trợ, catalog sản phẩm, hoặc một hệ thống vận hành đơn lẻ — phạm vi gọn với kết quả nhìn thấy được.
- Chuẩn hóa thu nạp của nó. CDC nếu nguồn hỗ trợ; mẫu pipeline này trở thành khuôn cho mọi thứ sau đó.
- Dựng tầng truy xuất cho miền đó. Vector index trước; chỉ thêm graph nếu truy vấn quan hệ thực sự xứng đáng.
- Kiểm chứng trước khi mở rộng. SLO độ tươi đo trên lưu lượng thật, lan truyền quyền chứng minh bằng diễn tập thu hồi, lineage chụp đầu-cuối.
- Mở rộng qua cùng một nền tảng. Các miền liền kề gia nhập mẫu thu nạp hiện có — không bao giờ một pipeline riêng thứ hai.
Chỉ số thành công để giữ mỗi bước:
| Chỉ số | Tín hiệu khỏe |
|---|---|
| Độ trễ độ tươi đầu-cuối | Trong SLO từng miền — dưới năm phút cho miền nóng |
| Độ trễ lan truyền quyền | Thu hồi có hiệu lực trong vài phút, kiểm chứng bằng diễn tập |
| Độ phủ index | Khoảng 100% tài liệu trong phạm vi ở phiên bản embedding hiện tại |
| Độ tin cậy pipeline | Lỗi tạm thời tự phục hồi; độ sâu DLQ gần không |
| Chất lượng truy xuất đầu ra | Thuộc tầng ứng dụng — ngoài phạm vi bài này |
Kết Luận
Tài sản bền trong AI doanh nghiệp không phải model — mà là nền tảng dữ liệu bên dưới nó. Model sẽ bị thay nhiều lần trong vòng đời hạ tầng này; nền tảng thu nạp, kho dẫn xuất và tầng quản trị mới là thứ tồn tại. Đó cũng là lý do “sẵn sàng cho SI” là một lập trường đáng đi theo chứ không phải cược đầu cơ: mọi thuộc tính trong bài — độ tươi, lan truyền quyền, lineage, pipeline có thể replay — đều sinh lợi cho AI bạn đang chạy hôm nay, bất kể năm năm nữa có gì đến.
Con đường thực tế là tăng dần: một miền, một mẫu pipeline, kiểm soát đã kiểm chứng, rồi mở rộng. Doanh nghiệp cố xây toàn bộ nền tảng trước khi đưa AI nào vào chạy thường không đưa được gì vào chạy cả. Dịch vụ phát triển AI của HDWEBSOFT bao phủ đúng điểm giao này — kỹ thuật dữ liệu, tích hợp hệ thống và triển khai ứng dụng AI. Nếu bạn đang hoạch định nền tảng dữ liệu cho lộ trình AI của mình, liên hệ đội ngũ của chúng tôi để được tư vấn kỹ thuật.
Câu Hỏi Thường Gặp
Hạ tầng dữ liệu sẵn sàng cho SI là gì?
Hạ tầng dữ liệu sẵn sàng cho SI là một định hướng kiến trúc: hạ tầng dữ liệu doanh nghiệp được thiết kế để phục vụ các hệ thống AI ngày càng mạnh. Nó được định nghĩa bởi độ tươi (index cập nhật khi nguồn thay đổi), khả năng tương tác (một nền tảng thu nạp chung cung cấp cho lakehouse, vector store và graph), khả năng khám phá (catalog metadata và lineage), và truy cập có kiểm soát (quyền nguồn lan truyền sang mọi bản sao dẫn xuất). Đây không phải tiêu chuẩn đã xác lập, và cũng không phải bằng chứng superintelligence tồn tại.
Vector database và knowledge graph khác nhau thế nào trong AI doanh nghiệp?
Vector database lưu embedding của các chunk nội dung và trả lời câu hỏi tương đồng ngữ nghĩa — “tìm thứ giống thứ này”. Knowledge graph lưu thực thể và quan hệ có kiểu, trả lời câu hỏi duyệt — “những thứ này liên kết ra sao”. Phần lớn doanh nghiệp cần cả hai: vector store xử lý văn bản phi cấu trúc ở quy mô lớn, còn graph giữ quan hệ tường minh giúp suy luận nhiều bước và câu trả lời có thể giải thích.
Pipeline dữ liệu AI nên dùng xử lý batch hay change data capture?
Cả hai, tùy mức độ nóng của từng miền. Change data capture là mặc định cho đồng bộ phục vụ AI từ hệ thống gốc — nó đọc commit log, gần như không tạo tải lên nguồn, và truyền thao tác xóa chính xác. Event streaming phù hợp với miền đã phát sự kiện. Batch vẫn đúng cho nạp bù ban đầu và dữ liệu thực sự nguội, nơi độ tươi theo giờ hoặc theo đêm là chấp nhận được.
Làm sao để vector embedding luôn mới khi dữ liệu nguồn thay đổi?
Qua index từng phần dựa trên sự kiện thay đổi: khi tài liệu nguồn đổi, chia lại tài liệu đó thành chunk, tạo lại embedding cho các chunk bị đổi và upsert theo ID ổn định. Thao tác xóa phải lan truyền dạng tombstone — tài liệu bị xóa ở nguồn phải rời index trong cùng cửa sổ độ trễ. Lưu phiên bản model embedding cùng mỗi vector giúp nâng cấp model chạy dạng tạo lại embedding từng phần thay vì dựng lại toàn bộ.
Quyền truy cập lan truyền sang vector store và knowledge graph thế nào?
ACL nguồn được mang theo nội dung dưới dạng metadata index, rồi ép tại thời điểm truy xuất — giao diện truy xuất có kiểm soát xác thực người gọi và áp bộ lọc quyền trước khi trả kết quả. Thu hồi lan truyền như dữ liệu: sự kiện xóa/cập nhật cộng đồng bộ ACL định kỳ, kiểm chứng bằng diễn tập. Embedding là bản sao của văn bản và phải được coi là nhạy cảm tương đương.
Doanh nghiệp nên bắt đầu xây hạ tầng dữ liệu AI từ đâu?
Từ một miền dữ liệu giá trị cao. Chuẩn hóa thu nạp của nó — CDC nếu nguồn hỗ trợ — dựng tầng truy xuất chỉ cho miền đó, và kiểm chứng độ tươi, lan truyền quyền, lineage đầu-cuối trước khi mở rộng sang các miền liền kề qua cùng nền tảng. Doanh nghiệp cố xây toàn bộ nền tảng trước khi đưa AI nào vào chạy thường không đưa được gì vào chạy cả.