L’infrastruttura dati AI aziendale è il sistema di pipeline, store, indici e controlli di governance che trasforma dati operativi frammentati in una fondazione che i sistemi AI possono interrogare in modo affidabile — dati freschi, coerenti, con permessi e consapevoli delle relazioni. Man mano che i modelli diventano più capaci, il fattore limitante nell’AI aziendale si sta spostando dalla qualità del modello alla qualità della fondazione dati: un sistema AI è affidabile solo quanto la freschezza dei suoi indici e l’integrità dei suoi controlli di accesso.
Questo articolo è l’approfondimento tecnico del livello Enterprise Data & Knowledge del blueprint di architettura di superintelligenza aziendale. Quel post definiva un modello di riferimento a sei livelli; questo dettaglia come il livello dati viene effettivamente costruito — come i sistemi operativi alimentano vector store e knowledge graph quasi in tempo reale, come i permessi di accesso si propagano negli indici derivati e come le pipeline si riprendono quando falliscono. Una chiarificazione fin da subito: “pronta per la SI” è un orientamento architetturale — infrastruttura progettata per assorbire AI sempre più capace — non uno standard tecnico consolidato, né la prova che la superintelligenza esista.
Punti Chiave
- L’infrastruttura dati pronta per la SI è un orientamento architetturale — dati governati, freschi e interoperabili preparati per un’AI sempre più capace — non uno standard certificato né la prova che l’ASI esista.
- Il divario tra l’architettura dati tradizionale e l’infrastruttura pronta per l’AI è operativo: freschezza, propagazione dei permessi e modellazione delle relazioni — non capacità di storage.
- Vector store e knowledge graph risolvono problemi di retrieval diversi; la maggior parte delle aziende ne ha bisogno di entrambi dietro un’unica interfaccia di retrieval governata.
- Il change data capture è la spina dorsale predefinita per le pipeline orientate all’AI; indici obsoleti degradano silenziosamente ogni sistema AI a valle.
- Costruite in modo incrementale: un dominio di dati, ingestion standardizzata, freschezza e controlli di accesso verificati — poi espandete.
Cos’è l’Infrastruttura Dati Pronta per la SI?
L’infrastruttura dati pronta per l’AI è costruita per i workload AI come consumatori di prima classe — non solo analisti e dashboard. “Pronta per la SI” aggiunge un orizzonte di pianificazione: la stessa ingegneria, ma con margine sufficiente perché la fondazione sopravviva ai salti di capacità dei modelli sopra di essa senza essere riprogettata. Quattro proprietà la definiscono:
- Freschezza. Gli indici derivati si aggiornano quando le fonti cambiano — minuti per i domini caldi, non da un giorno all’altro. Un indice è una copia, e le copie decadono.
- Interoperabilità. Un unico tessuto di ingestion alimenta lakehouse, vector store e knowledge graph — non una pipeline su misura per ogni caso d’uso.
- Reperibilità. Un catalogo di metadati rende i dataset trovabili e porta il lineage dalle righe sorgente ai frammenti indicizzati.
- Accesso governato. I permessi delle fonti si propagano in ogni copia derivata, compresi gli embeddings — che sono, legalmente e praticamente, copie di testo.
Pronta per la SI vs. Pronta per l’AI: Una Distinzione Pratica
| Dimensione | Tradizionale | Pronta per l’AI | Orientamento pronto per la SI |
|---|---|---|---|
| Consumatore principale | Report e dashboard | Modelli ML, applicazioni RAG | Agenti più autonomi; modelli futuri più capaci |
| Aspettativa di freschezza | Batch notturno accettabile | Quasi tempo reale sui domini caldi | SLO di freschezza espliciti per dominio |
| Controllo degli accessi | Per sistema, riconciliato manualmente | Propagato agli indici | Applicato al retrieval; revoca auditata |
| Modello di dati | Tabelle e file | Tabelle più embeddings | Più relazioni esplicite e un livello semantico |
L’avvertenza onesta: nulla nella colonna di destra è provato come necessario per la superintelligenza — quella capacità non esiste. La direzione è difendibile perché ogni proprietà ripaga i sistemi AI odierni, qualunque cosa arrivi dopo.
Perché l’Architettura Dati Aziendale Tradizionale Fallisce con l’AI
I patrimoni di dati aziendali sono stati costruiti per un consumatore diverso. Cinque modalità di fallimento si ripetono quando l’AI diventa un workload di prima classe:
- La freschezza analitica non è freschezza operativa. Un ETL notturno produce un warehouse corretto fino a ieri — bene per una dashboard del lunedì, sbagliato per un assistente AI che risponde a domande operative alle 15:00.
- I permessi non si propagano. I sistemi di origine portano ACL a livello di riga e oggetto; le copie derivate — compresi gli embeddings — tipicamente non ne ereditano nessuna, lasciando un sistema AI capace di recuperare contenuti che il richiedente non ha diritto di vedere.
- Le relazioni sono implicite. Gli store relazionali registrano entità; le relazioni che contano vivono in chiavi esterne mai progettate per essere attraversate, o nella testa delle persone.
- Una pipeline per consumatore. Ogni nuovo caso d’uso AI ottiene un’estrazione su misura, e ogni copia degli stessi dati diverge silenziosamente dalle altre.
- Nessun contratto di freschezza. Nessuno può dire quanto è obsoleto un indice — quindi nessuno può fidarsi pienamente di una risposta costruita su di esso.
Notate che questi sono fallimenti di implementazione, non domande di valutazione. Se il vostro patrimonio di dati è pronto è un problema diverso — la nostra guida alla preparazione dei dati per l’AI copre la valutazione. Questo articolo assume la valutazione fatta e copre ciò che costruite dopo.
Componenti Fondamentali dell’Infrastruttura Dati AI Aziendale
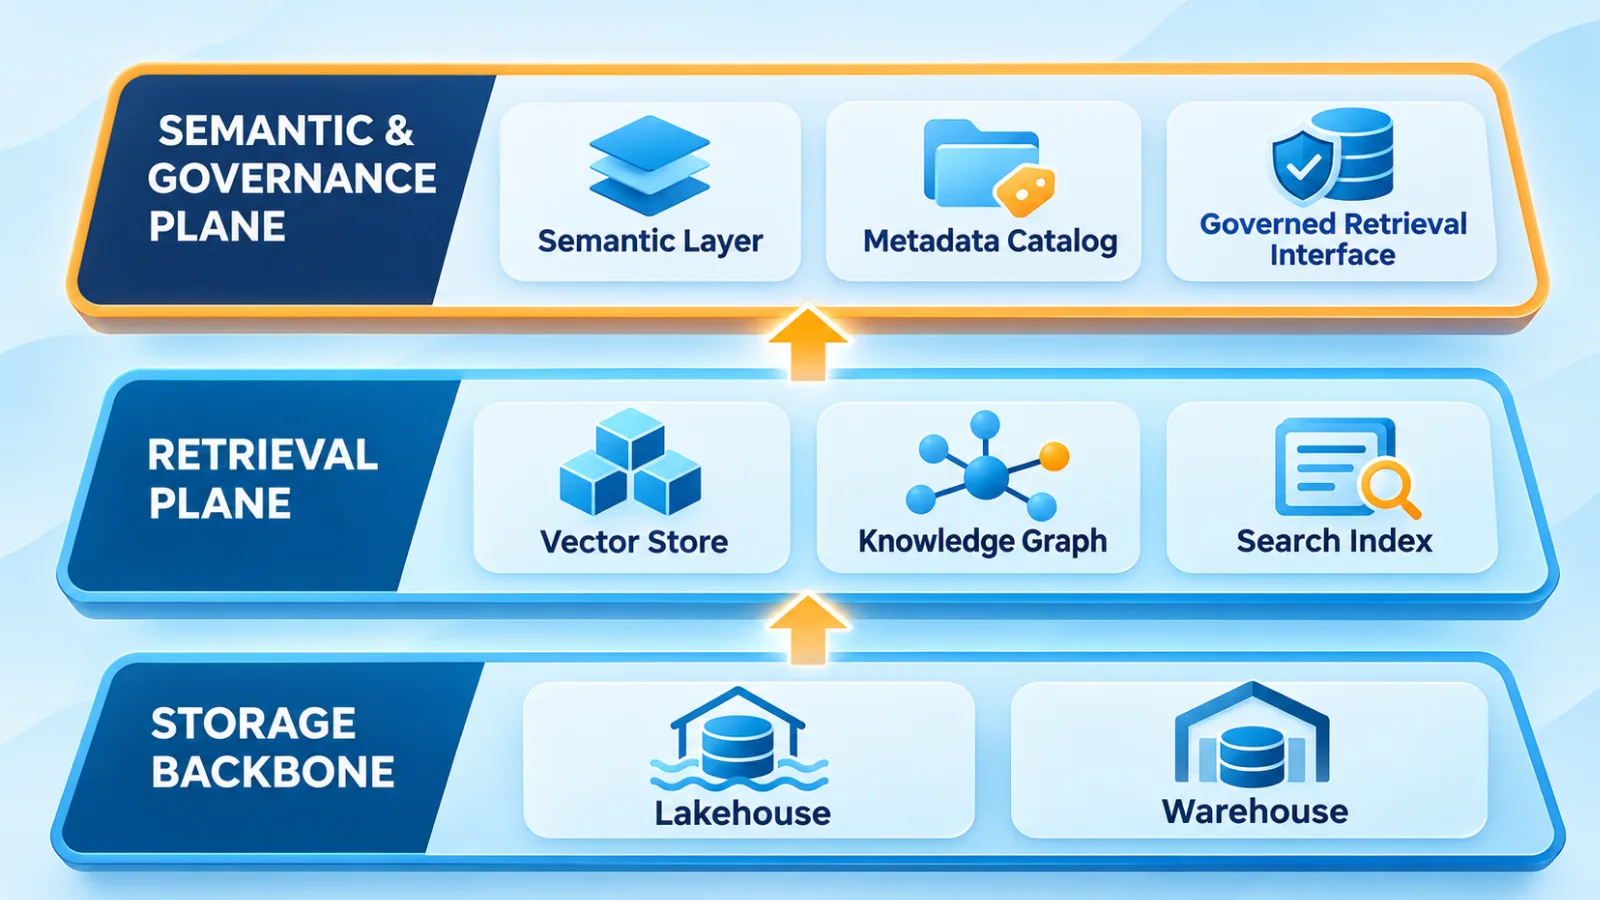
La Spina Dorsale di Storage
La spina dorsale è un lakehouse — formati di tabella aperti su object storage — integrato da un warehouse per i mart governati. I dati arrivano grezzi, vengono validati e puliti, poi conformati in modelli di dominio. La sua proprietà decisiva per l’AI non è la capacità ma la recuperabilità: la spina dorsale è lo stato canonico da cui ogni store derivato può essere ricostruito. Quando un indice si corrompe o un modello di embedding viene sostituito, la spina dorsale rende il recupero un replay anziché una missione di salvataggio.
Il Piano di Retrieval
Tre store derivati servono tre forme di query diverse:
- Vector store. Embeddings più riferimenti ai frammenti per il retrieval semantico su contenuto non strutturato.
- Knowledge graph. Entità e relazioni tipate per l’attraversamento e le query multi-hop.
- Search index. Retrieval per parola chiave e metadati, ancora lo strumento giusto per identificatori esatti e filtri strutturati.
La regola di progettazione che mantiene sano questo piano: gli store derivati sono usa e getta. Non vengono mai promossi a fonte di verità, non accumulano mai stato che non possa essere ricalcolato e non ricevono mai scritture che aggirino il feed di cambiamenti.
Il Piano Semantico e di Governance
Sopra storage e retrieval si trova il livello che rende il sistema coerente: un livello semantico che porta definizioni di business e logica delle metriche, un catalogo di metadati per la scoperta e il lineage, e l’interfaccia di retrieval governata — l’unica API attraverso cui le applicazioni AI interrogano. Quell’interfaccia autentica il chiamante, applica i filtri di permesso, impone vincoli di freschezza e registra ogni accesso. L’interfaccia è l’unica porta — che è esattamente ciò che rende la governance applicabile invece che aspirazionale.
Database Vettoriali vs. Knowledge Graph: Quando Usare Ognuno
Questi due store sono complementari, non concorrenti. La confusione nasce perché entrambi vengono venduti come “il livello di memoria per l’AI” — ma rispondono a domande diverse.
| Dimensione | Database vettoriale | Knowledge graph |
|---|---|---|
| Cosa memorizza | Embeddings su frammenti di contenuto, con riferimenti ai documenti sorgente | Entità e relazioni tipate (archi) |
| Stile di query | Similarità semantica — “trova cose come questa” | Attraversamento — “come sono connesse queste cose” |
| Punti di forza | Testo non strutturato; matching semantico sfumato; retrieval ANN su larga scala | Ragionamento multi-hop; percorsi spiegabili; identità di entità stabile |
| Limiti | Nessuna relazione esplicita; risultati opachi; gli embeddings derivano quando il modello cambia | Sforzo di modellazione iniziale; più difficile da sincronizzare; grafi sparsi sottoperformano |
| Meccanica di aggiornamento | Ri-frammentare e ri-embeddare al cambio sorgente; cancellazioni propagate come tombstone | Upsert incrementali di archi; grandi cambiamenti di topologia replicati dagli eventi |
| Usi aziendali tipici | Policy, ticket, documentazione, knowledge base | Catene di fornitura, strutture organizzative, lineage dei dati, mappe di dipendenze |
Scegliete il vector store quando la domanda è “trova contenuto rilevante” — il caso aziendale dominante, ecco perché gli indici vettoriali vengono rilasciati per primi. Scegliete il grafo quando la domanda è “segui la relazione” — impatto delle dipendenze, responsabilità organizzativa, catene di provenienza. Molte domande reali sono entrambe: “trova gli incidenti legati a questo fornitore” richiede il retrieval semantico per trovare gli incidenti e l’attraversamento del grafo per stabilire quali relazioni contano come “legate”.
Quell’intersezione è dove operano i pattern ibridi come GraphRAG — il retrieval vettoriale stabilisce l’insieme iniziale di candidati, poi l’attraversamento del grafo lo espande e rende il risultato spiegabile. La guida per sviluppatori GraphRAG descrive un pattern di implementazione; trattatela come riferimento tecnico, non come affermazione che un vendor vada bene per ogni azienda. E una nota di confine: la logica di orchestrazione che decide quale store interrogare vive un livello sopra lo scopo di questo articolo — la nostra guida all’architettura RAG agentica copre quel livello di retrieval e applicazione.
Progettare Pipeline di Dati in Tempo Reale per l’AI
La freschezza è una proprietà della pipeline, non dello storage. Nessun vector store né motore di grafo può compensare dati che arrivano obsoleti — quindi il design di ingestion determina tutto ciò che segue.
Batch vs. CDC vs. Event Streaming
| Pattern | Latenza tipica | Carico sulle fonti | Ordinamento e deduplicazione | Miglior uso |
|---|---|---|---|---|
| Batch pianificato (ETL/ELT) | Ore | Letture massicce periodiche | Semplice | Dati freddi e di riferimento; backfill iniziali |
| Change data capture (CDC) | Secondi a minuti | Basso — legge i commit log | Ordine per chiave | Sistemi di riferimento: ERP, CRM, database core |
| Event streaming | Sotto-secondo a secondi | Nessuno dopo l’emissione | Ordinato per partizione; at-least-once | Domini che emettono eventi; telemetria, attività |
CDC è la spina dorsale predefinita per la sincronizzazione orientata all’AI dai sistemi di riferimento. La cattura basata su log legge il commit log del database e raccoglie insert, update e — soprattutto — delete senza modificare il codice applicativo, portando la semantica di cancellazione che il polling ingenuo perde completamente. L’event streaming si adatta ai domini che emettono già eventi di business; il batch mantiene i caricamenti iniziali e i dati freddi. Per la meccanica dello stream processing — windowing, join con stato, garanzie di consegna — la documentazione su stream processing con Apache Kafka è un solido riferimento tecnico.
Indicizzazione Incrementale e Refresh degli Embeddings
Il ciclo di aggiornamento per gli indici vettoriali: arriva un evento di cambiamento, il documento interessato viene recuperato, ri-frammentato, e solo i frammenti modificati vengono ri-embedded e aggiornati sotto ID documento stabili. Due regole mantengono questo onesto. Primo, le cancellazioni devono propagarsi come tombstone — un documento eliminato nella fonte deve lasciare l’indice entro la stessa finestra di latenza, o state facendo trapelare l’accesso attraverso vettori obsoleti. Secondo, memorizzate la versione del modello di embedding con ogni vettore, così gli upgrade del modello si distribuiscono come re-embed graduali anziché ricostruzioni dell’intero indice che congelano la freschezza per giorni.
Sincronizzazione del Knowledge Graph
Il problema difficile qui è la risoluzione delle entità: lo stesso fornitore che appare come “Acme Corp”, “ACME Corporation” e ID 4471 in tre sistemi ha bisogno di un’identità canonica prima che gli archi significhino qualcosa. Risolvete le entità all’ingestion, applicate upsert incrementali di archi, versionate i tipi di relazione e — quando i cambiamenti di topologia sono grandi — replicate gli eventi anziché cercare di differenziare lo stato del grafo contro le tabelle.
Coerenza della Fonte di Verità
Un writer per entità per dominio; il lakehouse detiene lo stato canonico; gli store derivati sono repliche eventualmente coerenti per design. Poiché i guasti in questo modello sono spesso silenziosi — un connettore che smette di emettere sembra esattamente come un sistema tranquillo — i job di riconciliazione confrontano conteggi di record e checksum per finestra temporale per rilevare la divergenza presto. Pubblicate un budget di latenza per dominio così che “abbastanza fresco” sia un numero, non una sensazione.
Retry, Replay e Dead-Letter Queue
- Consumer idempotenti. Upsert con chiave su ID stabili rende sicuro il riprocessamento — la base di ogni strategia di retry.
- Retry con backoff. I guasti transitori — rate limit dell’API di embedding, errori di rete — vengono riprovati con backoff esponenziale prima dell’escalation.
- Dead-letter queue. I messaggi avvelenati vanno in una DLQ con alerting; un guasto rumoroso batte una perdita silenziosa.
- Capacità di replay. Conservate eventi grezzi e offset per ricostruire qualsiasi store derivato senza toccare i sistemi sorgente — la proprietà che rende gli store derivati sicuramente usa e getta.
Monitoraggio di Freschezza e Latenza di Indicizzazione
Tracciate la latenza end-to-end (dal commit sorgente al recuperabile nell’indice), la latenza per fase, i tassi di retry, la profondità della DLQ e la copertura degli embeddings — la quota di documenti indicizzati alla versione corrente del modello. Allertate quando la latenza viola l’SLO del dominio: una pipeline morta è facile da rilevare, ma una pipeline viva con undici ore di ritardo è la modalità di guasto che fa davvero male ai sistemi AI.
Architettura di Riferimento: Connettere i Dati Aziendali ai Sistemi AI
Il diagramma sotto assembla i componenti in un flusso di riferimento funzionante, dalle fonti operative al consumo AI governato.
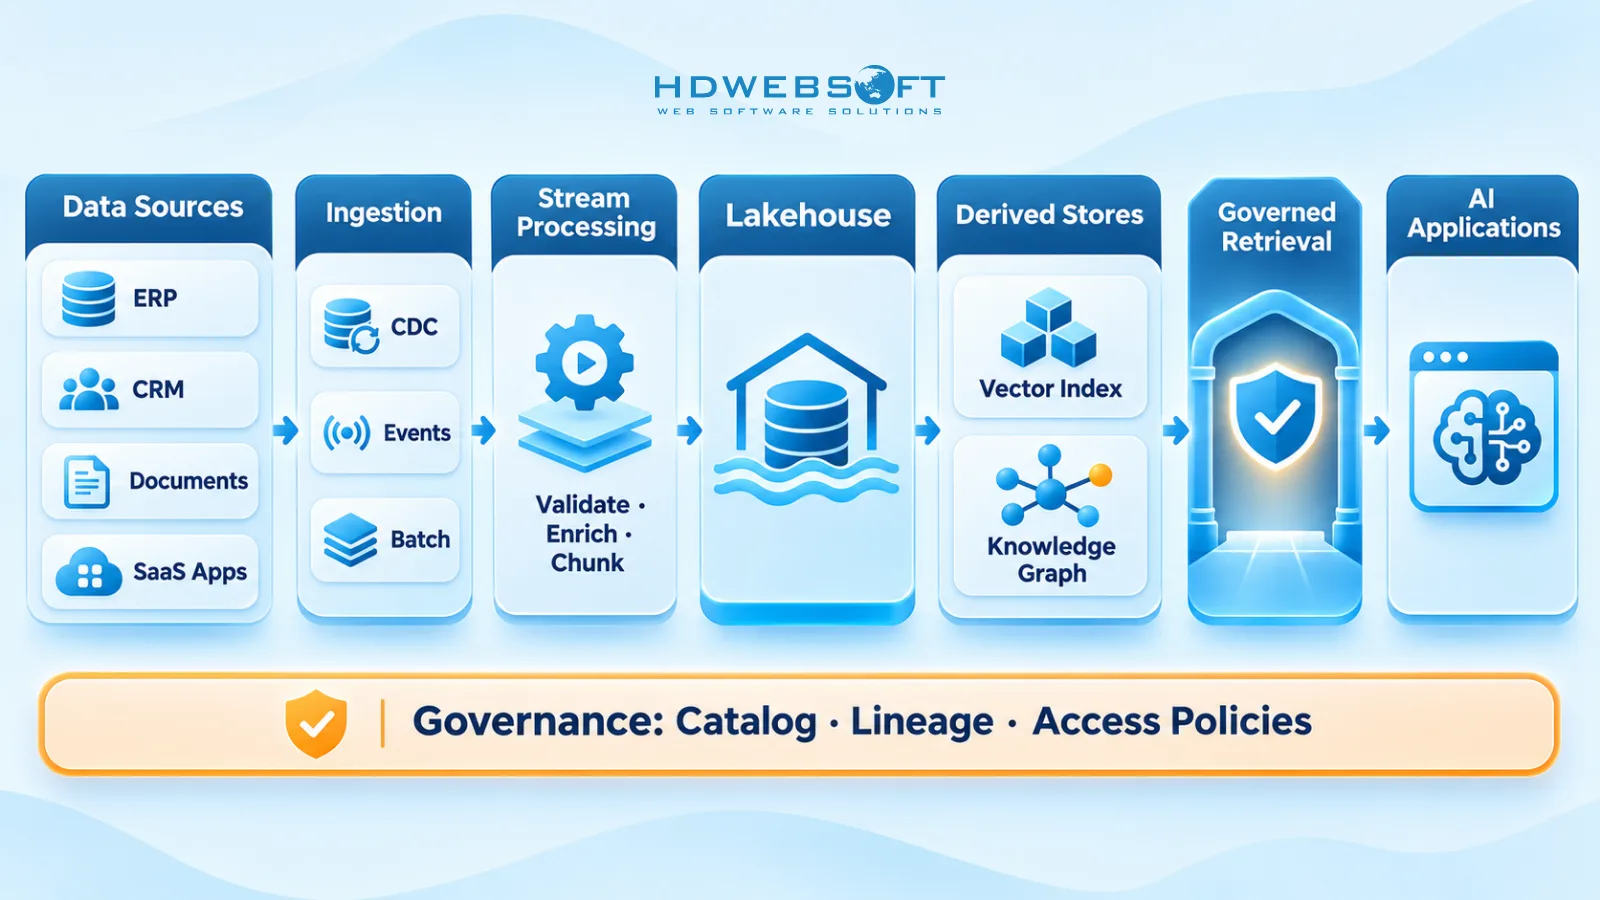
Leggendolo da sinistra a destra:
- Fonti. ERP, CRM, gestione documentale, applicazioni SaaS e il warehouse esistente.
- Ingestion e cattura dei cambiamenti. Connettori CDC sui sistemi di riferimento, event stream dove i domini li emettono, loader batch per backfill e dati freddi.
- Stream processing. Validazione, arricchimento, classificazione PII, frammentazione e risoluzione delle entità — la fase in cui i cambiamenti grezzi diventano record consumabili dall’AI.
- Lakehouse. Zone grezza, pulita e conformata che detengono lo stato canonico — un writer per entità.
- Store derivati. L’indice vettoriale e il knowledge graph, aggiornati incrementalmente dallo stesso feed di cambiamenti invece che ricaricati.
- Piano di governance. Catalogo, lineage e policy di accesso applicati attraverso ogni fase — un livello trasversale, non un’aggiunta.
- Interfaccia di retrieval governata. L’unica porta per le applicazioni AI: autentica i chiamanti, applica i filtri di permesso, impone budget di latenza sui domini sensibili e registra ogni query.
Tre percorsi di sincronizzazione attraversano questa architettura, e nominarli onestamente conta:
- Percorso caldo: fonte → CDC → stream → store derivati — secondi a minuti, per domini dove l’obsolescenza corrompe le decisioni.
- Percorso tiepido: stream → lakehouse — minuti, mantenendo lo stato canonico aggiornato.
- Percorso freddo: batch → lakehouse → backfill degli store derivati — ore, per dati di riferimento e ricostruzioni.
Il confine di coerenza: gli store derivati sono eventualmente coerenti, e la correttezza viene dal replay più la riconciliazione — non dal fingere che la latenza sia zero. L’interfaccia di retrieval è dove “quanto obsoleto è troppo obsoleto” viene imposto per dominio — ecco perché è lei, non l’indice, il punto di controllo.
State costruendo sistemi AI su dati aziendali frammentati? Una fondazione dati affidabile richiede più che connettere database. Dall’ingestion in tempo reale e la sincronizzazione della conoscenza al retrieval governato, HDWEBSOFT aiuta le aziende a progettare soluzioni ingegneristiche che connettono i sistemi aziendali con le moderne applicazioni AI.
Governance dei Dati, Lineage e Controlli di Accesso
La governance a questo livello è un insieme di controlli di implementazione, non documenti di policy:
- Proprietà e registrazione. Ogni dominio ha un proprietario nominato; ogni dataset che entra nella spina dorsale è registrato nel catalogo con il suo SLO di freschezza.
- Propagazione dei permessi. Le ACL di origine viaggiano con il contenuto come metadati dell’indice; il filtraggio al momento del retrieval le applica prima di restituire i risultati. Gli embeddings sono copie di testo — trattateli come ugualmente sensibili.
- Gestione delle PII. La classificazione avviene all’ingestion, dentro lo stream processing, così mascheramento o esclusione si applicano prima che il contenuto venga embedded.
- Lineage. Catturate quali righe sorgente hanno prodotto quali frammenti ed embeddings. I modelli di eventi aperti — la documentazione OpenLineage ne descrive uno — permettono ai job della pipeline di emettere lineage in modo coerente invece di ricostruirlo dopo.
- Revoca. La revoca dell’accesso si propaga come i dati — eventi di eliminazione e aggiornamento più sincronizzazione periodica delle ACL — e viene testata con esercitazioni, non presunta.
- Audit. Ogni retrieval attraverso l’interfaccia governata viene registrato: identità del chiamante, filtri applicati e versioni del corpus.
- Freschezza come governance. Nel momento in cui una risposta AI guida una decisione, i dati obsoleti sono un’esposizione di conformità — il monitoraggio della latenza appartiene alla dashboard di governance, non solo al pannello ops.
Roadmap di Implementazione Pratica
Il sequenziamento che funziona è deliberatamente poco glamour — un dominio alla volta:
- Scegliete un dominio ad alto valore. Una knowledge base di supporto, un catalogo prodotti o un singolo sistema operativo — ambito delimitato con ritorno visibile.
- Standardizzate la sua ingestion. CDC dove la fonte lo supporta; questo pattern di pipeline diventa il template per tutto il resto.
- Allestite il piano di retrieval per quel dominio. Indice vettoriale prima; aggiungete il grafo solo se le query di relazione lo giustificano davvero.
- Verificate prima di espandere. SLO di freschezza misurato su traffico reale, propagazione dei permessi provata con un’esercitazione di revoca, lineage catturato end-to-end.
- Espandete attraverso lo stesso tessuto. I domini adiacenti entrano nel pattern di ingestion esistente — mai una seconda pipeline su misura.
Metriche di successo a cui tenere ogni passo:
| Metrica | Segnale sano |
|---|---|
| Latenza di freschezza end-to-end | Entro l’SLO del dominio — sotto i cinque minuti per i domini caldi |
| Latenza di propagazione dei permessi | Revoca efficace in minuti, verificata con esercitazione |
| Copertura dell’indice | Circa il 100% dei documenti nell’ambito alla versione di embedding corrente |
| Affidabilità della pipeline | Guasti transitori auto-recuperati; profondità DLQ vicina a zero |
| Qualità del retrieval a valle | Di proprietà del livello applicativo — fuori dallo scopo di questo articolo |
Conclusione
L’asset durevole nell’AI aziendale non è il modello — è la fondazione dati sotto di esso. I modelli verranno sostituiti molte volte nella vita di questa infrastruttura; il tessuto di ingestion, gli store derivati e il piano di governance sono ciò che persiste. Questo è anche ciò che rende “pronta per la SI” una postura difendibile anziché una scommessa speculativa: ogni proprietà descritta qui — freschezza, propagazione dei permessi, lineage, pipeline replicabili — ripaga per l’AI che fate girare oggi, qualunque cosa arrivi tra cinque anni.
Il percorso pratico è incrementale: un dominio, un pattern di pipeline, controlli verificati, poi l’espansione. Le aziende che cercano di costruire tutta la fondazione prima di mettere in produzione qualsiasi AI di solito non ne mettono in produzione nessuna. I servizi di sviluppo AI di HDWEBSOFT coprono esattamente questa intersezione — data engineering, integrazione di sistemi e consegna di applicazioni AI. Se state delineando la fondazione dati per la vostra roadmap AI, contattate il nostro team per una consulenza tecnica.
Domande Frequenti
Cos’è un’infrastruttura dati pronta per la SI?
Un’infrastruttura dati pronta per la SI è un orientamento architetturale: un’infrastruttura dati aziendale progettata per servire sistemi AI sempre più capaci. È definita da freschezza (gli indici si aggiornano quando le fonti cambiano), interoperabilità (un unico tessuto di ingestion alimenta lakehouse, vector store e grafo), reperibilità (catalogo di metadati e lineage) e accesso governato (i permessi delle fonti si propagano in ogni copia derivata). Non è uno standard tecnico consolidato né la prova che la superintelligenza esista.
Qual è la differenza tra un database vettoriale e un knowledge graph per l’AI aziendale?
Un database vettoriale memorizza embeddings su frammenti di contenuto e risponde a domande di similarità semantica — “trova cose come questa”. Un knowledge graph memorizza entità e relazioni tipate e risponde a domande di attraversamento — “come sono connesse queste cose”. La maggior parte delle aziende ne ha bisogno di entrambi: i vector store gestiscono testo non strutturato su larga scala, mentre i grafi portano le relazioni esplicite che rendono possibili ragionamento multi-hop e risposte spiegabili.
Le pipeline di dati AI dovrebbero usare elaborazione batch o change data capture?
Entrambe, in base alla temperatura del dominio. Il change data capture è la scelta predefinita per la sincronizzazione orientata all’AI dai sistemi di riferimento — legge i commit log, introduce un carico quasi nullo sulla fonte e propaga le cancellazioni correttamente. L’event streaming si adatta ai domini che emettono già eventi. Il batch resta giusto per i backfill iniziali e i dati davvero freddi dove la freschezza oraria o notturna è accettabile.
Come mantenere aggiornati gli embeddings vettoriali quando i dati di origine cambiano?
Tramite indicizzazione incrementale guidata dagli eventi di cambiamento: quando un documento sorgente cambia, quel documento viene ri-frammentato, i frammenti modificati ri-embedded e aggiornati sotto ID stabili. Le cancellazioni devono propagarsi come tombstone — un documento eliminato nella fonte deve lasciare l’indice entro la stessa finestra di latenza. Memorizzare la versione del modello di embedding con ogni vettore permette aggiornamenti del modello come re-embed graduali anziché ricostruzioni complete.
Come si propagano i permessi di accesso a vector store e knowledge graph?
Le ACL di origine viaggiano con il contenuto come metadati dell’indice, poi vengono applicate al momento del retrieval — l’interfaccia di retrieval governata autentica il chiamante e applica i filtri di permesso prima di restituire i risultati. La revoca si propaga come i dati: eventi di eliminazione e aggiornamento più sincronizzazione periodica delle ACL, verificata con esercitazioni. Gli embeddings sono copie di testo e devono essere trattati come ugualmente sensibili.
Da dove dovrebbe iniziare un’azienda a costruire un’infrastruttura dati per l’AI?
Da un dominio di dati ad alto valore. Standardizzate la sua ingestion — CDC dove la fonte lo supporta — allestite un piano di retrieval solo per quel dominio, e verificate freschezza, propagazione dei permessi e lineage end-to-end prima di espandere ai domini adiacenti attraverso lo stesso tessuto. Le aziende che cercano di costruire tutta la fondazione prima di mettere in produzione qualsiasi AI di solito non ne mettono in produzione nessuna.