การกำกับดูแลซูเปอร์อินเทลลิเจนซ์เป็นความท้าทายที่ไม่ได้แก้ไข ครอบคลุมสามพื้นที่: การประสานงานระดับโลกระหว่างรัฐ แนวปฏิบัติความปลอดภัยในห้องแล็บที่สร้างโมเดลขอบเขต และความรับผิดชอบภายในองค์กรที่ปรับใช้ AI ไม่มีกรอบใด — สนธิสัญญา กฎหมาย นโยบายห้องแล็บ หรือการควบคุมภายใน — แสดงการควบคุมที่รับประกันต่อระบบซูเปอร์อินเทลลิเจนซ์สมมติ สิ่งที่มีวันนี้คือชุดกลไกหลายชั้น ไม่สมบูรณ์ แต่ละตัวมีขอบเขตจริงแต่จำกัด
บทความนี้จับคู่กลไกเหล่านั้น เราแยกปัญญาประดิษฐ์เหนือมนุษย์ — ระดับความสามารถสมมติที่ไม่มีระบบใดบรรลุ — ออกจากระบบ AI องค์กรที่องค์กรกำกับจริงวันนี้ แล้วตรวจสอบวิธีการกำกับทำงานในสามระดับและแต่ละระดับขาดตรงไหน สำหรับผู้นำเทคโนโลยี คำถามเชิงปฏิบัติไม่ใช่ ASI ควบคุมได้ในนามธรรมหรือไม่ แต่คือส่วนใดของการกำกับดูแลซูเปอร์อินเทลลิเจนซ์ที่ดำเนินการได้ตอนนี้
ประเด็นสำคัญ
- การกำกับดูแลซูเปอร์อินเทลลิเจนซ์ทำงานในสามระดับ: การกำกับระดับโลกและกฎระเบียบ ความปลอดภัย AI ขอบเขต และความรับผิดชอบองค์กร — ต่างกันในนักแสดง เครื่องมือ และอำนาจบังคับ
- ความท้าทายหลักที่ไม่ได้แก้ไขคือ alignment การกำกับมนุษย์แบบขยาย ความเข้มข้นอำนาจ และความรับผิดชอบต่อระบบที่อาจเกินความสามารถประเมินมนุษย์
- กฎระเบียบผูกพัน (เช่น EU AI Act) การประสานงานระหว่างประเทศสมัครใจ (ประชุมสุดยอด โครงการ UN) และกลไกกำกับภายในเป็นประเภทเครื่องมือที่แตกต่าง — ไม่ควรปนกัน
- องค์กรควบคุมชั้นปรับใช้: อิสระตามความเสี่ยง การอนุมัติ human-in-the-loop อำนาจตัดสินใจ ความสามารถตรวจสอบ และความรับผิดชอบระดับคณะกรรมการ
- แนวปฏิบัติกำกับดูแลปัจจุบันเสริมความรับผิดชอบ AI — ไม่สามารถรับประกันการควบคุมระบบซูเปอร์อินเทลลิเจนซ์สมมติ
อะไรทำให้ซูเปอร์อินเทลลิเจนซ์กำกับยาก
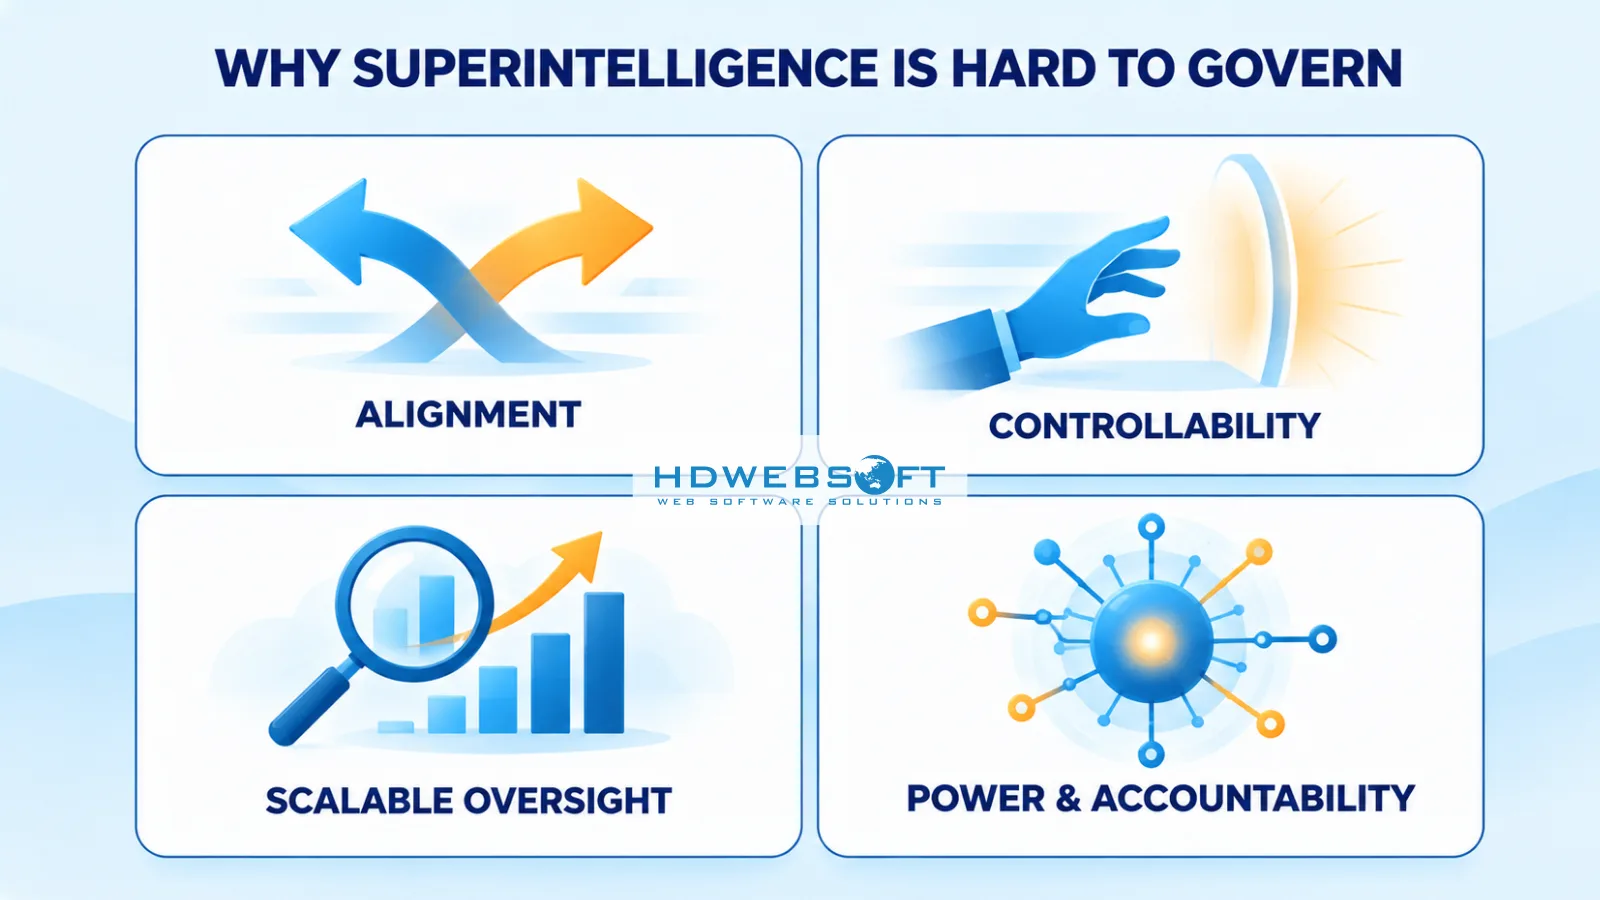
การกำกับเทคโนโลยีทรงพลังใด ๆ ยาก; การกำกับเทคโนโลยีที่อาจเกินความสามารถมนุษย์นำเสนอความท้าทายที่สถาบันปัจจุบันไม่ได้ออกแบบมาเพื่อ สี่ประการเด่น
-
Alignment เป็นปัญหาว่าเป้าหมายระบบตรงกับเจตนาจริงของผู้ดำเนินการหรือไม่ ระบบ AI ปรับให้เหมาะสมสำหรับเป้าหมายที่ได้รับ — และสำหรับความสามารถเกินวันนี้มาก เป้าหมายที่ระบุน้อยหรือระบุผิดอาจสร้างพฤติกรรมที่ตรงตามเทคนิคแต่เป็นอันตรายโดยผล การวิจัย alignment ถามว่าเราทำให้ระบบที่แข็งแกร่งขึ้นไล่ตามเป้าหมายที่มนุษย์ตั้งใจได้อย่างเชื่อถือได้หรือไม่; มันไม่มีคำตอบที่พิสูจน์แล้ว
-
ต้องแยกจาก alignment คือ controllability — ความสามารถเชิงปฏิบัติในการจำกัด แก้ไข หรือหยุดพฤติกรรมระบบ ทั้งสองต่างกัน ระบบอาจ align กับเจตนากว้างอย่างมีเหตุผลแต่ยังยากต่อการจำกัดในสถานการณ์เฉพาะ; ในทางกลับกัน องค์กรควบคุมระบบที่ลýตริภายในไม่เข้าใจเต็มที่เป็นประจำ ผ่านขอบเขตเข้าถึง ประตูอนุมัติ และขีดจำกัดปฏิบัติการ การกำกับพึ่งพา controllability อย่างมากขณะ alignment ยังไม่ได้แก้
-
Scalable oversight ตั้งชื่อปัญหาลึกกว่า: การกำกับสมมติว่าผู้ประเมินตัดสินลýตริและผลลัพธ์ของระบบได้ เมื่อความสามารถเติบโต ระบบอาจแก้ปัญหาที่ผู้กำกับไม่สามารถยืนยันอิสระ — ทบทวนการวิเคราะห์ที่เกินความเชี่ยวชาญผู้ทบทวน อนุมัติแผนที่ข้อบกพร่องมองไม่เห็นสำหรับผู้ไม่เชี่ยวชาญ หรือให้เหตุผลในแบบที่ไม่สามารถตรวจสอบ นี่ไม่ใช่ความไม่สะดวกสมมติ; ทุกประตูอนุมัติและร่องรอยตรวจสอบที่มีสมมติว่าผู้ตัดสินใจมนุษย์ประเมินสิ่งที่วางต่อหน้าได้อย่างมีความหมาย เมื่อคุณภาพการประเมินลดลง การกำกับลดลงด้วย — แม้กลไกทางการดูเหมือนยังคงอยู่ นักวิจัยกำลังสำรวจการลดผล (ความช่วยเหลือจาก AI ที่อ่อนกว่า กระบวนการทบทวนมีโครงสร้าง interpretability) แต่การประเมินมนุษย์โดยตรงยากขึ้นเรื่อย ๆ ที่จะทำและเชื่อถือเมื่อระบบก้าวหน้า
-
สุดท้าย ความเข้มข้นอำนาจ และ ความรับผิดชอบ ความสามารถระดับซูเปอร์อินเทลลิเจนซ์จะเข้มข้นอำนาจยกระดับพิเศษในใครก็ตามที่ควบคุม — ความกังวลเสถียรภาพทางการเมืองและการค้าในตัวเอง และแรงขับของความสนใจระดับรัฐที่เห็นได้ที่ Level 1 ในระหว่างนั้น ลูกโซ่ความรับผิดชอบที่สร้างสำหรับซอฟต์แวร์แน่นอน — ความรับผิดชอบทางกฎหมาย การตรวจสอบ การมอบหมายความรับผิดชอบ — ยืดเมื่อใช้กับระบบที่ตัดสินใจอัตโนมัติที่ความสามารถเหนือมนุษย์ ถ้าระบบกระทำตามลýตริที่ผู้ดำเนินการไม่สามารถประเมินได้เต็มที่ การมอบหมายความรับผิดชอบสำหรับผลลัพธ์กลายเป็นคำถามทางกฎหมายและองค์กรเท่ากับทางเทคนิค ความท้าทายสี่ประการนี้อธิบายว่าทำไมการกำกับตอนนี้ทำงานในสามระดับที่แตกต่าง
สามระดับของการกำกับดูแลซูเปอร์อินเทลลิเจนซ์
บทความนี้เสนอกรอบการวิเคราะห์สามระดับเพื่อจัดระเบียบภูมิทัศน์การกำกับ เป็นเลนส์การวิเคราะห์ ไม่ใช่การจำแนกทางการหรือมาตรฐาน — แต่จับคู่วิธีกลไกจริงรวมตามขอบเขต นักแสดง และความสามารถบังคับ
| ระดับ | ขอบเขต | นักแสดงหลัก | เครื่องมือ | การบังคับวันนี้ |
|---|---|---|---|---|
| 1. การกำกับระดับโลกและกฎระเบียบ | มนุษยชาติ / ทางการเมือง | รัฐ EU UN ประชุมสุดยอดความปลอดภัย | กฎหมายผูกพัน การประสานงาน หลักการ | กฎหมายผูกพันในบางเขตอำนาจ; การประสานงานระหว่างประเทศยังแยกส่วน |
| 2. ความปลอดภัยและควบคุม AI ขอบเขต | ผู้ให้บริการโมเดลขอบเขต | ห้องแล็บ AI สถาบันความปลอดภัย | ประเมินความสามารถ เกณฑ์ปรับใช้ red-teaming | safeguard นำโดยผู้ให้บริการ ทบทวนภายนอก และภาระผูกพันทางกฎหมายที่ใช้ |
| 3. ความรับผิดชอบองค์กร | องค์กรปรับใช้ AI | คณะกรรมการ CTO หน้าที่ปฏิบัติ | นโยบาย เมทริกซ์อำนาจ ตรวจสอบ มาตรฐาน | นโยบายภายใน สัญญา ตรวจสอบ และข้อบังคับที่ใช้ |
ระดับต่าง ๆ ทำงานร่วมกัน: กฎระเบียบสร้างภาระผูกพันที่ห้องแล็บต้องปฏิบัติ; แนวปฏิบัติขอบเขตกำหนดสิ่งที่องค์กรปรับใช้อย่างปลอดภัยได้; ความรับผิดชอบองค์กรกำหนดสิ่งที่ AI ทำจริงภายในองค์กร ไม่มีระดับใดแทนที่ระดับอื่น — การกำกับดูแลซูเปอร์อินเทลลิเจนซ์ ในระดับที่มันมีอยู่ คือผลรวมของพวกมัน
กรอบนี้สำคัญเชิงปฏิบัติเพราะการปนระดับสร้างการหาเหตุผลที่แย่ ทีมปฏิบัติที่ปฏิบัตินโยบายความปลอดภัยห้องแล็บเหมือนกฎหมายจะไว้ใจมากเกิน; คณะกรรมการที่ปฏิบัติกฎระเบียบเหมือนครอบคลุมการตัดสินใจปรับใช้ภายในจะสร้างการควบคุมตัวเองน้อยลง แต่ละระดับมีเครื่องมือ ความสามารถบังคับ และโหมดล้มเหลวต่างกัน — ดังนั้นคำถามที่ถามแต่ละระดับก็ต่างกัน
Level 1 — การกำกับ AI ระดับโลกและกฎระเบียบ
ระดับโลกทำงานผ่านสามประเภทเครื่องมือที่แตกต่าง — กฎระเบียบผูกพัน การประสานงานระหว่างประเทศ และหลักการสมัครใจ — แต่ละตัวมีขอบเขตและความสามารถบังคับต่างกัน
กฎระเบียบผูกพัน: EU AI Act
เครื่องมือที่มีผลมากที่สุดของการกำกับ AI ระดับโลกคือกฎหมายผูกพัน และเรือธงคือ EU AI Act — กฎระเบียบ AI ครอบคลุมแรกที่เขตอำนาจใหญ่รับรอง ร่างกฎหมายใช้แนวทางตามความเสี่ยง: ห้ามการใช้บางอย่างทันที กำหนดภาระผูกพันให้ระบบความเสี่ยงสูง ตั้งข้อกำหนดความโปร่งใส และแนะนำกฎสำหรับโมเดล AI อเนกประสงค์ รวมถึงภาระผูกพันเพิ่มสำหรับโมเดลที่พิจารณาว่าเสี่ยงระบบ สำคัญคือ มันกำกับประเภทระบบและแนวปฏิบัติ AI ที่มีวันนี้ — ไม่ใช่กฎหมายเฉพาะ ASI และไม่ควรอ่านแบบนั้น
การประสานงานระหว่างประเทศและเครื่องมือสมัครใจ
ข้างกฎระเบียบผูกพันคือ การประสานงานระหว่างประเทศ: การประชุมสุดยอดความปลอดภัย AI ที่เริ่มที่ Bletchley Park และต่อในโซลและปารีส โครงการ UN เกี่ยวกับการกำกับ AI และการมีส่วนร่วมทวิภาคีระหว่างมหาอำนาจ พวกเขาสร้างความมุ่งมั่นร่วม การประกาศ และบรรทัดฐานเกิดใหม่ — เครื่องมือจริงแต่ส่วนใหญ่สมัครใจ ความแข็งแกร่งขึ้นอยู่กับการจัดระเบียบทางการเมืองที่ยั่งยืน
ประเภทเครื่องมือที่สามคือ หลักการสมัครใจ — หลักการ AI ของ OECD และกรอบที่คล้ายกันที่สร้างค่านิยมร่วมไม่มีผลผูกพัน กำหนดแนวทางประเทศจากภายใน
ช่องว่างเขตอำนาจและปัญหา ASI
ข้อจำกัดที่นี่เป็นโครงสร้าง เขตอำนาจต่างกันอย่างชัดเจนในแนวทาง: EU กำกับแนวนอนด้วยกฎหมายเดียว สหรัฐพึ่งพาหลักเกณฑ์ภาคและแนวทางหน่วยงานเป็นหลัก และภูมิภาคอื่นผสมกฎผูกพันกับกลยุทธ์ประเทศ — ดังนั้นโมเดลหรือการปรับใช้เดียวกันอาจเผชิญภาระผูกพันต่างกันมากขึ้นอยู่กับที่มันลง การขยายนอกเขตอำนาจของ EU AI Act ผลักมาตรฐานของมันเข้าสู่ผลิตภัณฑ์ผู้ให้บริการนอก EU แต่ไม่มีกรอบรวมเทียบเท่าระดับโลก การแข่งขันทางการเมืองทั้งกระตุ้นและซับซ้อนการประสานงานระหว่างมหาอำนาจ: รัฐแบ่งปันความสนใจในการป้องกันการใช้ผิดพลาดทำลายล้างในขณะที่แข่งขันเพื่อข้อได้เปรียบ AI ซึ่งกำหนดว่าการประสานความปลอดภัยเท่าไหร่ที่เป็นไปได้ทางการเมืองในแต่ละช่วงเวลา ความสามารถบังคับแปรผันตาม — จากหน่วยงานกำกับเฉพาะถึงความมุ่งมั่นสมัครใจไม่มีองค์กรกำกับเลย
และช่องว่างลึกกว่าเป็นแนวคิด กฎหมายปัจจุบันกำกับประเภทความเสี่ยงที่กำหนดของระบบที่มี: แนวปฏิบัติห้าม การปรับใช้ความเสี่ยงสูง ภาระผูกพันโมเดลอเนกประสงค์ สำหรับซูเปอร์อินเทลลิเจนซ์สมมติ กฎระเบียบวันนี้สร้างขอบเขตและโครงสร้างความรับผิดชอบรอบ AI ปัจจุบัน — ยังไม่ได้แก้การกำกับความสามารถที่เกินการประเมินมนุษย์ และไม่ได้อ้างเช่นนั้นด้วย
Level 2 — ความปลอดภัยและควบคุม AI ขอบเขต
ระดับที่สองทำงานภายในองค์กรที่สร้างโมเดลแข็งแกร่งที่สุด เครื่องมือเด่นที่นี่คือ กรอบความปลอดภัยตามความสามารถ: นโยบายภายในที่ผูก safeguard กับสิ่งที่โมเดลทำได้ ไม่ใช่แค่เมื่อมันเผยแพร่ ตัวอย่างชัดเจนคือ Responsible Scaling Policy ของ Anthropic ซึ่งมอบ AI Safety Levels ให้โมเดลและต้องการมาตรการควบคุมและความปลอดภัยที่แข็งแกร่งขึ้นเมื่อเกณฑ์ความสามารถถูกข้าม
ชุดเครื่องมือความปลอดภัยเชื่อมโยงความสามารถ
รูปแบบทั่วไปผ่านหลายกลไก:
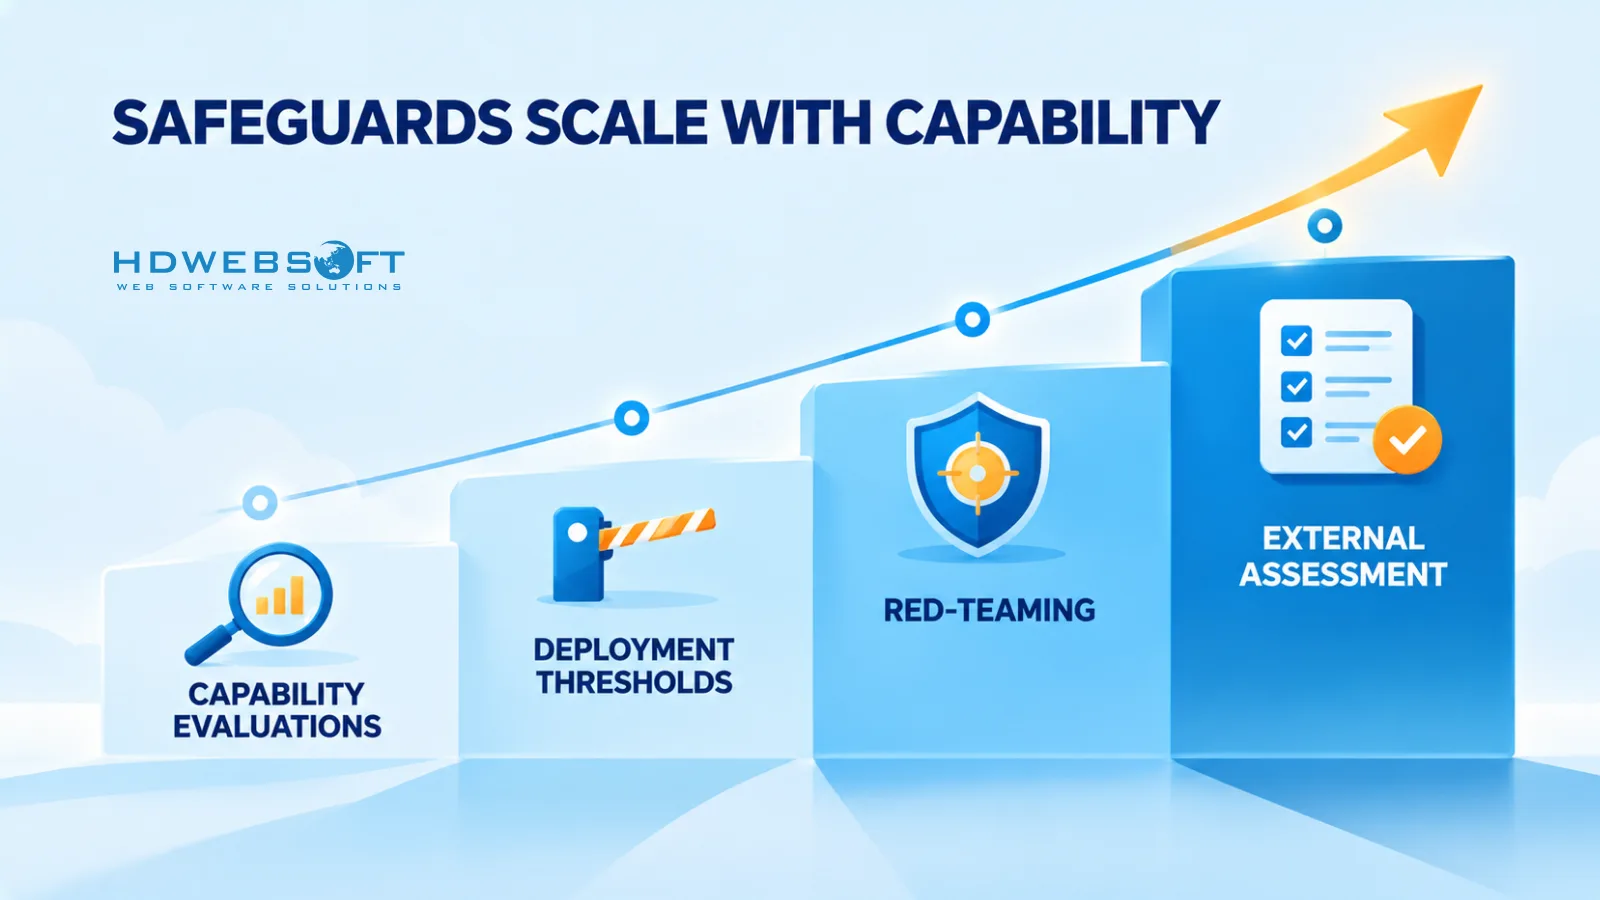
- การประเมินความสามารถ — ทดสอบโมเดลสำหรับความสามารถอันตราย (เช่น การแพร่พันธุ์อัตโนมัติ ความสามารถไซเบอร์หรือชีวภาพ) ก่อนและระหว่างพัฒนา
- เกณฑ์ปรับใช้ — ขอบเขตความสามารถที่เกินแล้วการปรับใช้ต้องการ safeguard หรือทบทวนเพิ่ม
- Red-teaming — ทดสอบต่อต้านโดยทีมภายในและภายนอกเพื่อเปิดโหมดล้มเหลวก่อนเผยแพร่
- ความปลอดภัยโมเดล — ปกป้องน้ำหนักโมเดลและโครงสร้างพื้นฐานจากการโจรกรรมหรือใช้ผิด
- การประเมินภายนอก — การประเมินและทบทวนบุคคลที่สามเสริมการประเมินตัวเองของผู้ให้บริการ
กรอบนำโดยผู้ให้บริการในบริบท
Preparedness Framework ของ OpenAI และ Frontier Safety Framework ของ DeepMind ตามตรรกะเปรียบเทียบ — การประเมินและลดผลเชื่อมโยงความสามารถ — แม้แต่ละตัวต่างในรายละเอียดและขอบเขต; ข้อกำหนดเฉพาะของพวกเขาอ่านที่แหล่งดีกว่าสรุปที่นี่
สิ่งที่กรอบเหล่านี้ร่วมสร้างคือรูปแบบกำกับที่น่าสังเกต: safeguard ขยายตามความสามารถที่พิสูจน์แทนกฎระเบียบคงที่ นั่นเป็นการเปลี่ยนแปลงมีนัยสำคัญจากกฎที่เขียนสำหรับซอฟต์แวร์คงที่ — การควบคุมที่ห้องแล็บใช้ควรติดตามสิ่งที่โมเดลทำได้จริง ประเมินผ่านการทดสอบที่กำหนดแทนที่จะสมมติ สำหรับองค์กรที่บริโภคโมเดลเหล่านี้ ระดับนี้ทำงานต้นน้ำ: คุณสมบัติความปลอดภัยของโมเดลที่ปรับใช้สะท้อนบางส่วนการกำกับภายในของผู้ให้บริการ ซึ่งองค์กรสังเกตและประเมินได้แต่ไม่สามารถตั้งได้
สองลักษณะโครงสร้างกำหนดระดับนี้ ประการแรก safeguard นำโดยผู้ให้บริการไม่ทำงานในสุญญากาศ: ห้องแล็บพร้อมกันอยู่ภายใต้กฎหมายที่ใช้ — รวมถึงภาระผูกพันเช่นกฎ EU AI Act สำหรับโมเดลอเนกประสงค์ — และกรอบขอบเขตมีปฏิสัมพันธ์กับการทบทวนภายนอก การประเมินสถาบันความปลอดภัย และความคาดหวังรายงานมากขึ้น ประการที่สอง ระดับนี้ยังไม่สม่ำเสมอ การประเมินส่วนใหญ่ทำเอง เกณฑ์ตั้งเอง และความสามารถยืนยันอิสระยังพัฒนา การกำกับขอบเขตคือที่ที่การควบคุมเชื่อมโยงความสามารถก้าวหน้าที่สุด — และที่ที่ข้อจำกัดของมันเป็นเทคนิคที่สุด
Level 3 — ความรับผิดชอบองค์กร
ระดับที่สามคือที่ที่องค์กรส่วนใหญ่ควบคุมจริง: การกำกับวิธี AI ปรับใช้และสิ่งที่มันได้รับอนุญาตทำ คำถามกลางง่ายต่อการพูดแต่ยากต่อการตอบ — ใครอนุญาต ตรวจสอบ และรับผิดชอบการตัดสินใจ AI อัตโนมัติ?
ห้าเครื่องมือกำหนดความรับผิดชอบองค์กรในทางปฏิบัติ:
- ระดับอิสระตามความเสี่ยง ตั้งสิ่งที่ระบบ AI ทำได้ไม่มีการกำกับ ตามประเภทความเสี่ยงของการกระทำ — อ่านข้อมูล ร่างเนื้อหา ดำเนินการธุรกรรม หรือสัมผัสระบบภายนอกแต่ละอย่างสมควรระดับอิสระต่างกัน
- การอนุมัติ human-in-the-loop วางประตูชัดเจนบนการกระทำสำคัญ: ระบบเสนอ คนที่มีอำนาจเหมาะสมอนุมัติ
- เมทริกซ์อำนาจตัดสินใจ บันทึกใคร — และอะไร — ได้รับอำนาจตัดสินใจที่รัศมีผลกระทบแต่ละอัน ทำให้อิสระเป็นมอบหมายชัดเจนแทนอุบัติเหตุการตั้งค่า
- ความสามารถตรวจสอบ ต้องการบันทึกการตัดสินใจละเอียดพอสร้างสิ่งที่เกิดขึ้นใหม่: input ไหนใช้ การกระทำไหนทำ การอนุมัติไหนให้ — ข้างการควบคุมเข้าถึงและ safeguard ปฏิบัติการที่จำกัดสิ่งที่ระบบสัมผัสได้; รูปแบบเทคนิคข้างหลังมันจับคู่ใกล้กับ ความปลอดภัย LLM สำหรับ AI เอเจนต์
- ความรับผิดชอบระดับคณะกรรมการ ทำให้ความเสี่ยง AI เป็นรายการวาระกำกับถาวร มีเจ้าของที่ระบุชื่อใต้คณะกรรมการ
กรอบอย่าง NIST AI Risk Management Framework ให้กลไกเหล่านี้คำศัพท์ร่วม — govern map measure manage — แม้มันเป็นแนวทางสมัครใจ ไม่ใช่กฎหมายผูกพัน สิ่งที่ทำให้ระดับนี้ต่างคือขอบเขต: องค์กรไม่สามารถกำหนดขอบเขต แต่สามารถควบคุมสิ่งที่อนุญาตบนระบบของพวกเขา ตรวจสอบมัน และถือมนุษย์ที่ระบุชื่อรับผิดชอบมัน
กลไกกำกับที่มีอยู่ขาดตรงไหน
การประเมินซื่อสัตย์ต้องการบอกว่าขอบเขตแต่ละระดับจบที่ไหน
| ระดับ | สิ่งที่มันกำกับ | ข้อจำกัดไม่ได้แก้ |
|---|---|---|
| ระดับโลก | เขตอำนาจแยกส่วน | ความท้าทายบังคับระหว่างประเทศ |
| ขอบเขต | การประเมินไม่สม่ำเสมอ การยืนยันอิสระ | การประเมินความสามารถเชื่อถือได้ |
| องค์กร | การปรับใช้และการกระทำที่อนุญาต | ข้อจำกัดการกำกับความสามารถเหนือมนุษย์ |
ที่ระดับโลก กฎหมายผูกพันยังผูกกับเขตอำนาจขณะเทคโนโลยีไม่ใช่; การประสานงานสร้างการประกาศเร็วกว่าการบังคับ ที่ระดับขอบเขต การประเมินและเกณฑ์เป็นจริงแต่ใช้ไม่สม่ำเสมอและส่วนใหญ่ตรวจเอง — การประเมินความสามารถอิสระเชื่อถือได้ยังเป็นปัญหาเปิด และที่ระดับองค์กร การกำกับครอบคลุมอย่างถูกต้องการปรับใช้และการกระทำที่อนุญาต — แต่การกำกับแบบขยายความสามารถเหนือมนุษย์ยากโดยพื้นฐานกว่าการกำกับระบบที่มนุษย์ยังประเมินผลลัพธ์ได้
เส้นลากผ่านไม่ใช่การกำกับล้มเหลวอย่างหลีกเลี่ยงไม่ได้ แต่คือกลไกที่สนับสนุนมัน — การประเมิน การยืนยัน การบังคับ — ไม่ได้แก้ที่ขอบเขตความสามารถและไม่ได้ทดสอบนอกนั้น ความไม่แน่นอนนั้นเองเป็นข้อมูลกำกับ: มันสนับสนุนโครงสร้างความรับผิดชอบที่ขยายแทนสมมติฐานที่ยืนอยู่
นัยที่สองตามมา: ที่การกำกับต้นน้ำมีช่องว่าง ความรับผิดชอบเลื่อนลงปลายน้ำ ผู้ปรับใช้ไม่สามารถพึ่งพาสนธิสัญญาหรือนโยบายห้องแล็บเพื่อดูดซับความรับผิดชอบของตนเองต่อวิธี AI ทำตัวภายในองค์กร — พวกเขายังรับผิดชอบการอนุญาต การตรวจสอบ และผลลัพธ์ไม่ว่าอะไร ในทางปฏิบัติ นั่นทำให้การกำกับระดับองค์กรไม่ใช่ส่วนเติมเต็มของสองระดับอื่นแต่เป็นชั้นรับน้ำหนักของตัวเอง
เตรียมองค์กรของคุณ: Playbook กำกับดูแลเชิงปฏิบัติ
องค์กรไม่สามารถกำกับขอบเขต แต่สามารถสร้างชั้นที่พวกเขาเป็นเจ้าของ — และเนื่องจากการกำกับต้นน้ำมีช่องว่างที่อธิบายข้างบน ชั้นนั้นแบกน้ำหนักจริง หกมาตรการครอบคลุมสาระสำคัญ นี่คือความรับผิดชอบและลำดับความสำคัญกำกับ ไม่ใช่คำแนะนำวิศวกรรม; ความลึกการใช้งานเป็นของงานเทคนิคเฉพาะ
- ใช้ระดับอิสระตามความเสี่ยง จำแนกสิ่งที่ AI ทำได้ไม่มีการกำกับตามความเสี่ยงการกระทำ — การวิเคราะห์อ่านอย่างเดียว การสร้างเนื้อหา การกระทำภายใน การกระทำภายนอกหรือสำคัญ — และมอบเพดานอิสระชัดเจนให้แต่ละอัน จุดคือทำให้อิสระเป็นการมอบเจตนา ไม่ใช่คุณสมบัติเกิดของสิ่งที่เอเจนต์ทันทีชน
- ตั้งเกณฑ์อนุมัติ human-in-the-loop กำหนดการกระทำไหนต้องการอนุมัติเสมอ โดยใคร และด้วยหลักฐานอะไร — ปฏิบัติประตูเป็นคุณสมบัติของรัศมีผลกระทบการกระทำ ไม่ใช่ความสะดวกของงาน การอนุมัติควรแบกข้อมูลพอให้ผู้อนุมัติประเมินการกระทำจริง ไม่ใช่แค่ยืนยัน
- รักษาเมทริกซ์อำนาจตัดสินใจ บันทึกมีชีวิตว่าระบบไหนและมนุษย์ไหนถืออำนาจที่แต่ละระดับผลกระทบ — เพื่ออิสระเสมอเป็นมอบหมายชัดเจนตรวจสอบได้และความรับผิดชอบติดตามเจ้าของที่ระบุชื่อ
- ประตูอัปเกรดความสามารถด้วยการประเมินและตรวจสอบ โมเดล เครื่องมือ หรือการผสานใหม่เข้าผลิตเฉพาะหลัง eval ที่กำหนดและร่องรอยตรวจสอบ — วินัยเดียวกันที่กำกับการเปลี่ยนโมเดลใน สถาปัตยกรรมพร้อมซูเปอร์อินเทลลิเจนซ์ โมเดลแข็งแกร่งกว่าเป็นเหตุการณ์กำกับ ไม่ใช่แค่อัปเกรด
- สร้างการรายงาน AI ระดับคณะกรรมการ จังหวะถาวรที่พาความเสี่ยง AI เหตุการณ์ และท่าทีอิสระไปยังคณะกรรมการ — ความรับผิดชอบต้องการจุดหมาย และโครงสร้างกำกับที่หยุดใต้คณะกรรมการหยุดเป็นการกำกับ
- กำหนดเส้นทางเหตุการณ์และการเลื่อนขั้น ใครได้รับแจ้ง ใครตัดสินใจ และอะไรหยุดได้ — ก่อนเหตุการณ์แรก ไม่ใช่หลัง คุณค่าของเส้นทางหยุดสัดส่วนกับความชัดเจนของ trigger และเจ้าของที่กำหนดล่วงหน้า
ไม่มีอะไรในนี้แก้การกำกับดูแลซูเปอร์อินเทลลิเจนซ์ มันทำสิ่งที่มีประโยชน์กว่า: สร้างโครงสร้างพื้นฐานความรับผิดชอบที่ทำงานวันนี้และขยายตามความสามารถ — ซึ่งเป็นตำแหน่งซื่อสัตย์ที่องค์กรสามารถอ้างอย่างน่าเชื่อถือในการสนทนากำกับใด ๆ ภายในหรือภายนอก
สรุป
การกำกับดูแลซูเปอร์อินเทลลิเจนซ์ไม่ได้แก้ไขอย่างแท้จริงที่ระดับโลกและขอบเขต — และจะเป็นเช่นนั้นในอนาคตที่มองเห็นได้ สิ่งที่ดำเนินการได้วันนี้คือชั้นองค์กร: การอนุญาต การตรวจสอบ และความรับผิดชอบสำหรับ AI ที่องค์กรปรับใช้ สร้างบนโครงสร้างที่ขยายได้เมื่อระบบแข็งแกร่งขึ้น HDWEBSOFT ช่วยองค์กรออกแบบและปรับใช้ระบบ AI ที่ถูกกำกับผ่าน บริการพัฒนา AI ของเรา; ถ้าคุณกำลังกำหนดท่าทีกำกับ AI ขององค์กร ติดต่อ HDWEBSOFT เพื่อคุยเรื่องโรดแมปกำกับดูแลและการใช้งานของคุณ
FAQ
การกำกับดูแลซูเปอร์อินเทลลิเจนซ์คืออะไร?
การกำกับดูแลซูเปอร์อินเทลลิเจนซ์หมายถึงกฎหมาย กลไกประสานงาน แนวปฏิบัติความปลอดภัย และการควบคุมองค์กรที่ออกแบบมาเพื่อชี้นำและจำกัดปัญญาประดิษฐ์ — รวมถึงระบบสมมติที่จะเหนือความสามารถมนุษย์ ทำงานในระดับโลก ผู้ให้บริการขอบเขต และองค์กร และยังคงเป็นความท้าทายที่ไม่ได้แก้ไข
ซูเปอร์อินเทลลิเจนซ์สามารถถูกกำกับหรือควบคุมได้หรือไม่?
ไม่มีกรอบใดแสดงการควบคุมที่รับประกันต่อระบบซูเปอร์อินเทลลิเจนซ์สมมติ กลไกกำกับดูแลปัจจุบันสามารถเสริมความรับผิดชอบ AI วันนี้ได้อย่างมีนัยสำคัญ แต่การกำกับแบบขยายต่อระบบที่เกินความสามารถประเมินของมนุษย์ยังเป็นปัญหาวิจัยและนโยบายที่เปิดอยู่
ทำไม AI alignment สำคัญต่อการกำกับดูแลซูเปอร์อินเทลลิเจนซ์?
Alignment — ความตรงกันของเป้าหมายระบบกับเจตนาจริงของผู้ดำเนินการ — เป็นศูนย์กลางเพราะการกำกับพึ่งพาการเข้าใจและจำกัดพฤติกรรม Alignment และ controllability เกี่ยวข้องกันแต่ต่างกัน: ระบบอาจไล่ตามเป้าหมายที่ตั้งใจแต่ยังยากต่อการจำกัดในทางปฏิบัติ
การกำกับดูแล AI องค์กรต่างจากการกำกับ AI ขอบเขตอย่างไร?
การกำกับ AI ขอบเขตเกี่ยวกับห้องแล็บที่สร้างโมเดลแข็งแกร่งที่สุด — การประเมินความสามารถ เกณฑ์ปรับใช้ และการลดผลความปลอดภัยสำหรับตัวเทคโนโลยี การกำกับ AI องค์กรเกี่ยวกับวิธีองค์กรปรับใช้ AI — ใครอนุญาตการกระทำอัตโนมัติ ตรวจสอบอย่างไร และใครรับผิดชอบ
องค์กรควรใช้การควบคุมกำกับดูแลใดวันนี้?
ระดับอิสระตามความเสี่ยง เกณฑ์อนุมัติ human-in-the-loop สำหรับการกระทำสำคัญ เมทริกซ์อำนาจตัดสินใจ ประตูประเมินและตรวจสอบก่อนอัปเกรดความสามารถ การรายงาน AI ระดับคณะกรรมการ และเส้นทางเหตุการณ์และการเลื่อนขั้นที่กำหนด