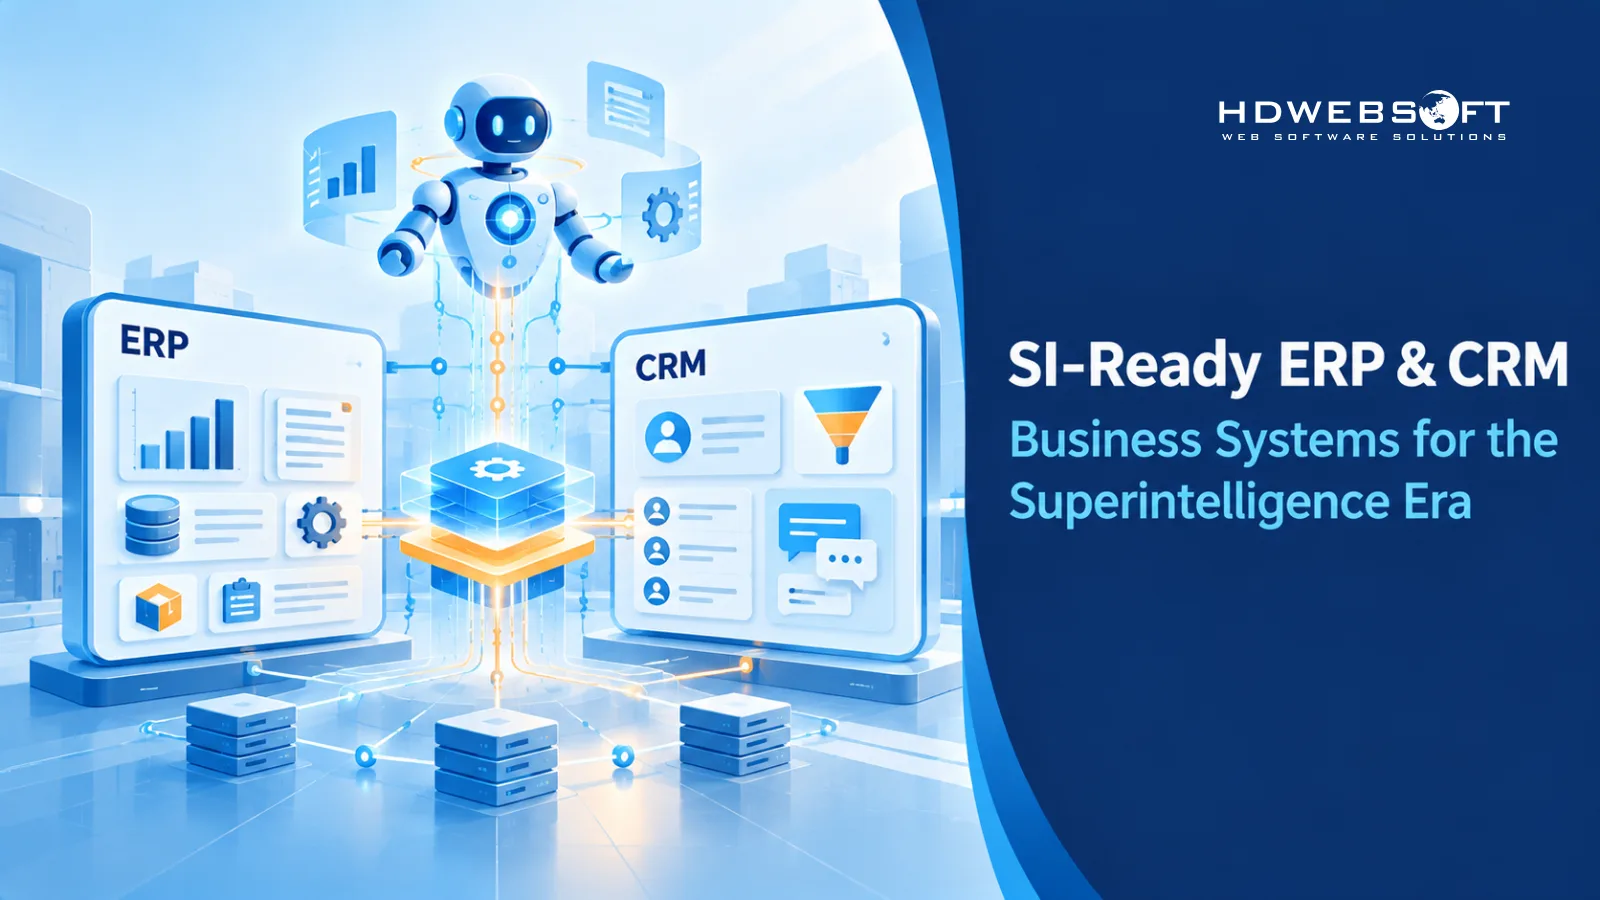
Heutige KI-Copiloten unterstützen Menschen, die in ERP- und CRM-Systemen arbeiten. Die nächste KI-Generation wird nicht unterstützen — sie wird operieren. Während Unternehmen beginnen, sich auf künstliche Superintelligenz und die zunehmend autonomen Agenten vorzubereiten, die ihr vorausgehen, werden die System-of-Record-Systeme, die Finanzen, Vertrieb, Beschaffung und Kundenbeziehungen steuern, zum kritischen Engpass. Ein KI-Agent, der perfekt schlussfolgern kann, bleibt nutzlos, wenn er Ihre Daten nicht lesen, Ihre Workflows nicht aufrufen oder keine Spur hinterlassen kann, der ein Prüfer vertraut.
SI-fähiges ERP und CRM ist die architektonische Antwort auf dieses Problem: Geschäftssysteme, die so konzipiert sind, dass KI-Agenten als erstklassige operative Nutzer funktionieren können — semantisch saubere Daten lesen, über kontrollierte APIs handeln und maschinenlesbare Nachweise für alles hinterlassen, was sie tun. Es ist keine Produktkategorie, keine Zertifizierung und kein Anbieter-Häkchen. Es ist eine Reihe von Designentscheidungen, die Sie jetzt treffen, solange die Anforderungen noch günstig zu erfüllen sind.
Dieser Leitfaden erklärt, was SI-fähig für ERP und CRM tatsächlich bedeutet, warum Legacy-Architekturen Agenten blockieren, welche Designprinzipien Systeme für Agenten bedienbar machen und wie Sie zwischen Modernisieren, Erweitern oder Neuaufbau wählen.
Die wichtigsten Erkenntnisse
- SI-fähig bedeutet, dass ein ERP oder CRM KI-Agenten als erstklassige operative Nutzer behandelt — mit maschinenlesbaren Daten, aufrufbaren Funktionen und nachvollziehbaren Aktionen — statt KI an rein menschliche Oberflächen anzuflanschen.
- Legacy-Systeme scheitern an Agenten nicht wegen fehlender KI, sondern weil Daten undokumentiert sind, Geschäftslogik in UIs vergraben liegt und Aktionen keine maschinenlesbare Spur hinterlassen.
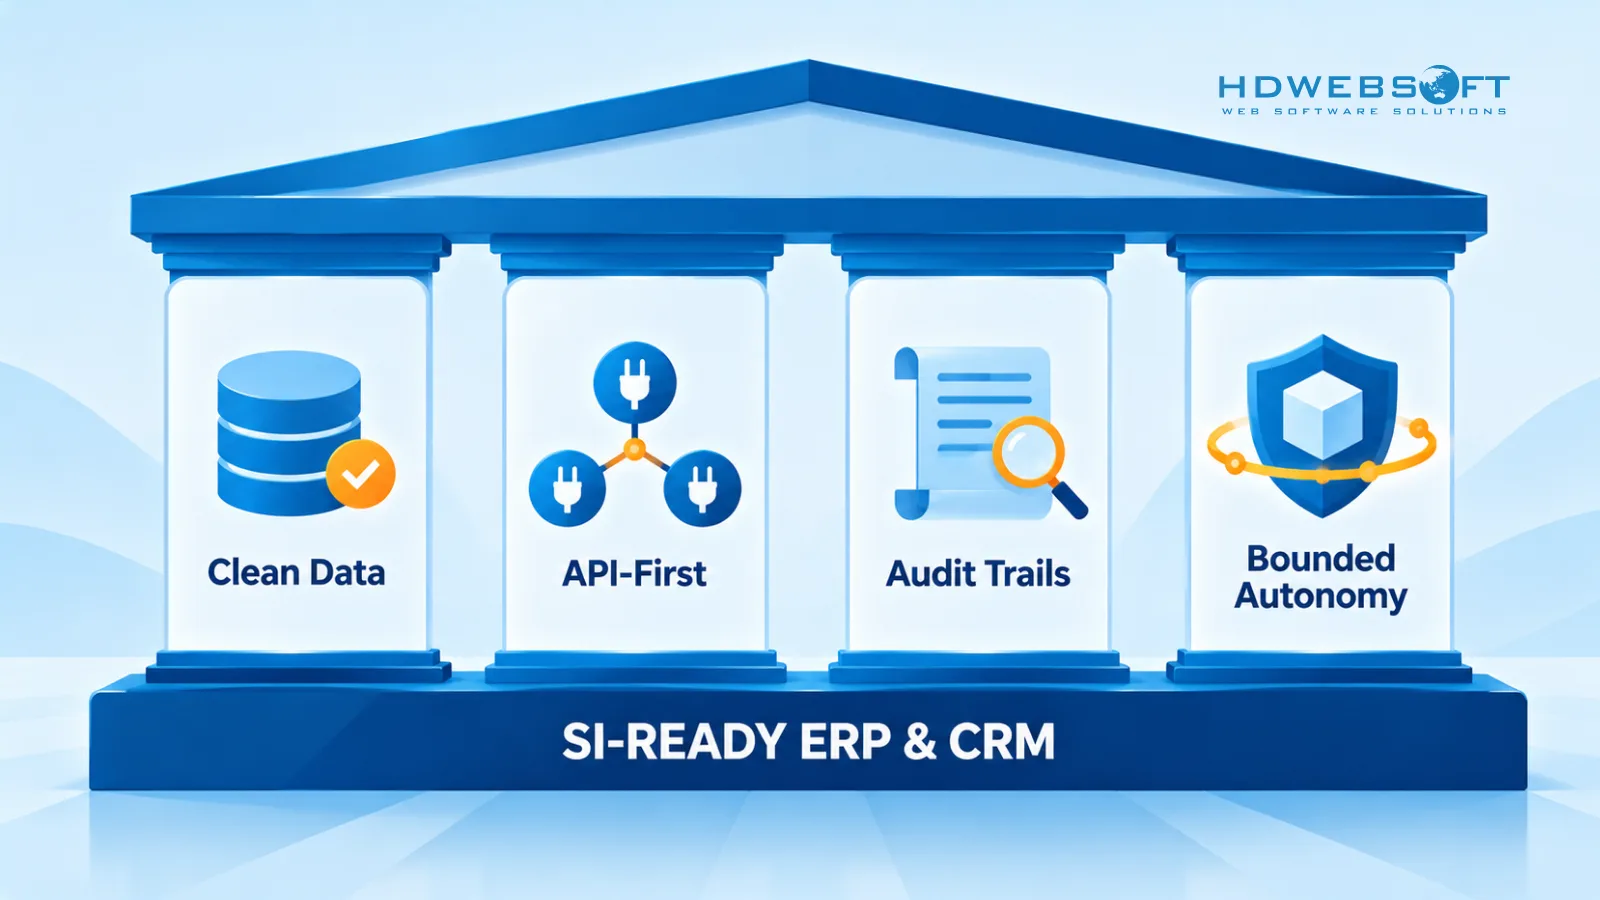
- Die vier Designpfeiler sind saubere semantische Daten, API-first- und ereignisgesteuerte Integration, maschinenlesbare Audit-Trails und begrenzte Autonomie mit menschlicher Aufsicht.
- Modernisieren versus Neuaufbau ist eine TCO- und Kontrollentscheidung, keine Technologiepräferenz — Individualentwicklung ist am stärksten, wenn Ihr Datenmodell ein Wettbewerbsvorteil ist, keine Universalantwort.
- Fähigkeit ist architektonisch, nicht futuristisch: Jeder Schritt Richtung SI-Fähigkeit verbessert auch die heutigen KI-Integrationen.
Was bedeutet „SI-fähig” für ERP- und CRM-Systeme?
Ein SI-fähiges System ist ein unternehmerisches System of Record, das KI-Agenten als legitime operative Nutzer behandelt — nicht als Plugins, die einen Bildschirm lesen, der für jemand anderen gedacht war. Konkret bedeutet das, dass das System drei Bedingungen gleichzeitig erfüllt: Agenten können verstehen, was die Daten bedeuten, über aufrufbare Funktionen auf das Geschäft einwirken und für jede Änderung, die sie vornehmen, Rechenschaft ablegen.
Es hilft, zwei oft vermischte Ideen zu trennen. KI-fähig beschreibt, was die meisten Anbieter heute verkaufen: ein System, das Copiloten, Prognosefunktionen oder eingebettete Assistenten unterstützt — Werkzeuge, die Menschen beraten, die die eigentlichen Operatoren bleiben. SI-fähig beschreibt eine weitergehende Bedingung: Das System bleibt bedienbar, prüfbar und sicher, wenn Agenten autonome, mehrstufige Arbeit übernehmen — und bleibt es auch, wenn die Agentenfähigkeit auf Niveaus zulegt, die wir heute nicht vollständig spezifizieren können.
Ein ehrlicher Vorbehalt gilt: „SI-fähig” ist ein zukunftsgerichteter Architekturansatz, kein etablierter technischer Standard oder eine Zertifizierung. Kein Branchenverband definiert ihn, und kein Anbieter kann Ihnen ein zertifiziert SI-fähiges ERP verkaufen — künstliche Superintelligenz selbst existiert nicht. Was der Begriff sinnvoll erfasst, ist eine Designdirektion: Systeme so bauen, dass sie nicht auseinandergerissen werden müssen, wenn Agenten echte Arbeit verlangen.
Fünf Merkmale definieren diese Richtung in der Praxis:
- Semantisch modellierte Daten — Entitäten, Felder und Beziehungen tragen maschinenlesbare Bedeutung, nicht nur Speicherformate.
- Aufrufbare Funktionen — jede Geschäftsoperation ist über APIs zugänglich, nicht in Bildschirmen eingeschlossen.
- Ereignisgesteuerte Integration — das System publiziert, was passiert, sobald es passiert, statt die Wahrheit in nächtliche Syncs zu bündeln.
- Maschinenlesbare Audit-Trails — jede Zustandsänderung protokolliert, wer gehandelt hat, warum und auf welchen Daten.
- Begrenzte Autonomie — Berechtigungsstufen und Genehmigungsschwellen legen fest, was ein Agent ohne Mensch tun darf.
ERP und CRM sitzen auf der Anwendungsschicht eines größeren Stacks. Wenn Sie einordnen möchten, wie diese Systeme neben Modell-Gateways, Orchestrierungsschichten und Unternehmensdatenplattformen liegen, deckt unser Blueprint zur Superintelligenz-Architektur für Unternehmen das Gesamtbild ab; dieser Artikel bleibt auf die zwei Systeme fokussiert, auf denen Ihr Geschäft tatsächlich läuft.
Warum Legacy-ERP- und CRM-Architekturen fortgeschrittene KI blockieren
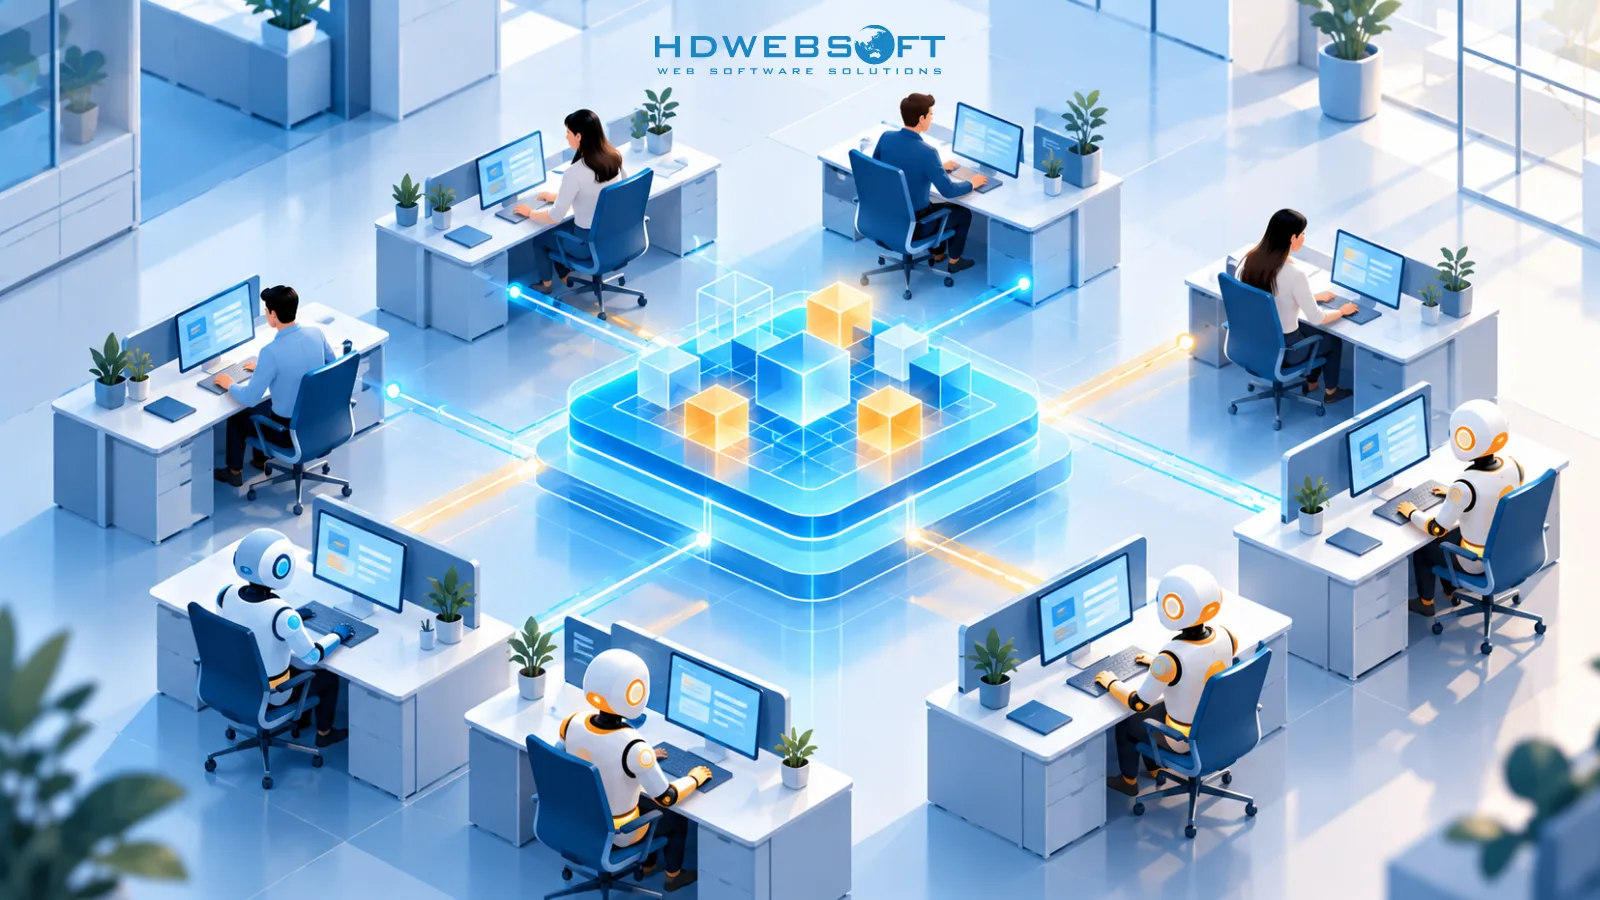
Legacy-ERP- und CRM-Systeme wurden um eine einzige Annahme herum entworfen: Ein Mensch sitzt zwischen den Daten und jeder Entscheidung. Oberflächen präsentieren Datensätze zum Lesen; Formulare sammeln, was Menschen tippen; Workflows kodieren die Schritte, denen Menschen folgen. Diese Annahme hat zwei Jahrzehnte gut gedient — und ist genau das, was bricht, wenn stattdessen ein Agent die Arbeit versucht.
Vier strukturelle Engpässe tauchen in fast jeder Legacy-Umgebung auf:
- Siloartige und undokumentierte Daten. Derselbe Kunde existiert als fünf leicht unterschiedliche Datensätze über Module hinweg. Felder wie
CUST_STAT_CDtragen informelles Erfahrungswissen, das keine Dokumentation erfasst. Menschen kompensieren mit Erfahrung; Agenten können das nicht. - In UIs vergrabene Geschäftslogik. Die Regel „Bestellungen über 50.000 Dollar brauchen eine Finanzfreigabe” lebt in einem Formularskript oder einer Stored Procedure — nicht in einem Service, den ein Agent aufrufen kann. Der einzige Weg, die Logik auszuführen, ist, einen Nutzer durch Bildschirme klicken zu simulieren.
- Punkt-zu-Punkt-Integration. Jahrzehnte maßgeschneiderter Konnektoren bedeuten, dass Daten spät, anders oder gar nicht ankommen. Ein Agent, der gleichzeitig aktuellen Bestand, offene Bestellungen und Kundenstatus braucht, trifft auf drei inkonsistente Schnappschüsse.
- Keine maschinenlesbare Verantwortlichkeit. Audit-Logs, wo sie existieren, protokollieren, dass ein Datensatz geändert wurde — nicht wer die Änderung autorisiert hat, welche Begründung ihr vorausging oder welche Daten sie gespeist haben. Sie beantworten „was ist passiert” für Menschen; sie können „warum ist es passiert” für niemanden beantworten.
| Legacy-Muster | Fehlermodus des Agenten |
|---|---|
| Undokumentierte Felder mit informeller Semantik | Agent interpretiert Daten falsch und handelt auf einer falschen Prämisse — selbstbewusst |
| Geschäftsregeln in Formularlogik eingeschlossen | Agent umgeht Kontrollen oder muss eine menschliche Sitzung vortäuschen, um sie auszulösen |
| Nächtliche Batch-Synchronisation zwischen Modulen | Agent trifft Entscheidungen auf veralteten, inkonsistenten Schnappschüssen |
| Änderungslogs ohne Begründungskontext | Audits scheitern: Niemand kann rekonstruieren, warum der Agent tat, was er tat |
| UI-Berechtigungen als einzige Zugriffskontrolle | Agent erbt weitreichende menschliche Privilegien — oder wird vollständig blockiert |
Das Muster unter all dem: Das Wissen und die Fähigkeiten des Systems sind nur über menschlich geformte Schnittstellen zugänglich. Agenten scheitern hier nicht, weil ihnen Intelligenz fehlt. Sie scheitern, weil nichts, was sie brauchen, maschinell zugänglich ist.
Zentrale Designprinzipien SI-fähiger ERP- und CRM-Architektur
Vier Designprinzipien verwandeln ein System zur Datenspeicherung in ein System, das Agenten wirklich bedienen können. Keines erfordert, auf intelligentere KI zu warten — jedes zahlt sich auch in heutigen Integrationen aus.
Saubere, semantisch modellierte Daten
Agenten konsumieren Bedeutung, nicht Bytes. Eine SI-fähige Datenschicht gibt jeder Kernentität — Kunde, Bestellung, Rechnung, Vertrag, Fall — eine einzige kanonische Definition, die über Module geteilt wird, mit Feldern, die explizite Semantik tragen: was der Wert bedeutet, welche Einheiten er nutzt, welche Zustände zulässig sind und wie er sich zu anderen Entitäten verhält.
In der Praxis heißt das, ein kontrolliertes Business-Glossar zu pflegen, das mit den Daten lebt, nicht in einem Wiki, das niemand liest: Beschreibungen auf Feldebene, enumerierte Statuswerte mit ihrer Geschäftsbedeutung, dokumentierte Beziehungen und Herkunftsnachweis, der zeigt, wo jeder Wert entstanden ist. Wenn ein Agent auf status = PENDING_CREDIT trifft, sollten die eigenen Metadaten des Systems ihm sagen, was ausstehender Kredit bedeutet und welche Aktionen in diesem Zustand gültig sind — sonst rät der Agent, und Raten auf Unternehmensebene wird zu Vorfällen.
Das ist zugleich das unscheinbarste und folgenreichste Prinzip. Jede nachfolgende Schicht — APIs, Audit-Trails, Autonomiekontrollen — setzt voraus, dass die darunterliegenden Daten interpretierbar sind. Datenbereinigung ist unscheinbar, gerade weil sie fundamental ist.
API-first, ereignisgesteuerte Integration
Wenn Daten das sind, was Agenten lesen, sind APIs das, was sie berühren. SI-fähige Systeme stellen jede bedeutsame Geschäftsfunktion — Bestellung anlegen, Sperre lösen, Lead qualifizieren, Retoure genehmigen — als kontrollierten Endpunkt mit expliziten Ein- und Ausgaben sowie Berechtigungen bereit. Ein nützlicher Test: Jede Operation, die ein geschulter Mitarbeiter ausführen kann, sollte über die API-Fläche ausführbar sein, ohne eine Benutzeroberfläche zu simulieren.
Ebenso wichtig ist, wie sich Änderungen ausbreiten. Batch-Sync gibt Agenten veraltete Schnappschüsse; ein ereignisgesteuertes Rückgrat — Bestellung angelegt, Zahlung eingegangen, Fall eskaliert, jeweils im Moment des Geschehens publiziert — gibt Agenten dasselbe Echtzeitbewusstsein, das ein Mensch vom Blick auf den Bildschirm erhält. Agenten abonnieren Event-Streams, statt Tabellen abzufragen — das ist schneller und dramatisch günstiger für die Infrastruktur.
Aufkommende Standards senken hier die Integrationskosten. Das Model Context Protocol (MCP) zum Beispiel definiert eine einheitliche Art, wie Agenten externe Werkzeuge und Datenquellen entdecken und aufrufen. Es lohnt sich, präzise zu sein, was MCP tut und nicht tut: Es standardisiert die Konversation zwischen Agent und System — Werkzeugentdeckung, Fähigkeitsbeschreibung, Aufrufformat. Es ersetzt nicht Ihre APIs, Ihr Autorisierungsmodell oder Ihre Geschäftsvalidierungen. Die bleiben Ihre Aufgabe. MCP macht eine gut gestaltete API-Fläche für Agenten nutzbar; es kann kein System retten, dessen Fähigkeiten von vornherein nicht aufrufbar sind.
Maschinenlesbare Audit-Trails
Wenn ein Agent einen Datensatz ändert, ist „jemand hat dieses Feld aktualisiert” kein ausreichender Log-Eintrag mehr. SI-fähige Audit-Trails erfassen die vollständige Beweiskette für jede Zustandsänderung, in einer Form, die Maschinen — und Prüfer — auswerten können:
- Akteur — welcher Agent, welches Servicekonto oder welcher Mensch gehandelt hat und unter wessen Autorität
- Aktion — die ausgeführte Operation, mit ihren Eingaben und der resultierenden Zustandsänderung
- Begründung — das auslösende Ereignis, die Richtlinie oder Begründungskette, die sie rechtfertigte, und etwaige eingeholte menschliche Genehmigungen
- Berührte Daten — welche Datensätze zur Entscheidungsfindung gelesen wurden, nicht nur welche geschrieben wurden
- Reversibilität — wie die Aktion rückgängig gemacht werden kann und ob sie es bereits wurde
Das ist keine neue Erfindung — Finanz- und Gesundheitssysteme verlangen seit Jahrzehnten gleichwertige Beweisketten. Was sich ändert, ist der Akteur: Die Spur muss so strukturiert sein, dass Aufsichtssysteme, nicht nur menschliche Prüfer, das Agentenverhalten kontinuierlich bewerten können. Diese Audit-Mechanik verbindet sich direkt mit dem breiteren Verantwortungsstack — Richtliniendurchsetzung, Aufsichtsebenen und Vorfallreaktion — den wir in Superintelligenz-Governance behandeln.
Begrenzte Autonomie & menschliche Aufsicht
Das letzte Prinzip zieht die Grenze zwischen dem, was Agenten allein tun dürfen, und dem, was weiterhin einen Menschen erfordert. Begrenzte Autonomie bedeutet, dass Berechtigungen als Stufen der Tragweite ausgedrückt werden, nicht als binäres „Agentenzugriff: ja/nein”:
- Stufe 0 — Lesen und empfehlen. Agenten analysieren, entwerfen und schlagen vor; Menschen führen aus. Passend für die meisten heutigen Einsätze.
- Stufe 1 — Reversible, geringfügige Aktionen ausführen. Nicht-finanzielle Felder aktualisieren, Fälle routen, Termine planen — mit sofortigem Rollback.
- Stufe 2 — Begrenzte finanzielle Aktionen ausführen. Erstattungen bis zu einer Schwelle ausstellen, Bestellungen innerhalb definierter Grenzen anpassen — mit Genehmigung oberhalb des Limits.
- Stufe 3 — Tragweitenstarke Aktionen mit Pflichtgenehmigung ausführen. Vertragsänderungen, Zahlungsfreigaben, Stammdatenänderungen — ein Agent bereitet vor, ein Mensch unterschreibt.
Jede Stufe wird architektonisch durchgesetzt — in der API-Autorisierungsschicht, nicht in den Anweisungen des Agenten — sodass die Ausweitung eines Agentenradius eine bewusste Governance-Entscheidung ist, niemals ein emergentes Verhalten. Die Schwellen gehören in eine vom Fachbereich geprüfte Konfiguration, nicht vergraben in einem Prompt.
Wie KI-Agenten in SI-fähigen ERP- und CRM-Systemen operieren werden
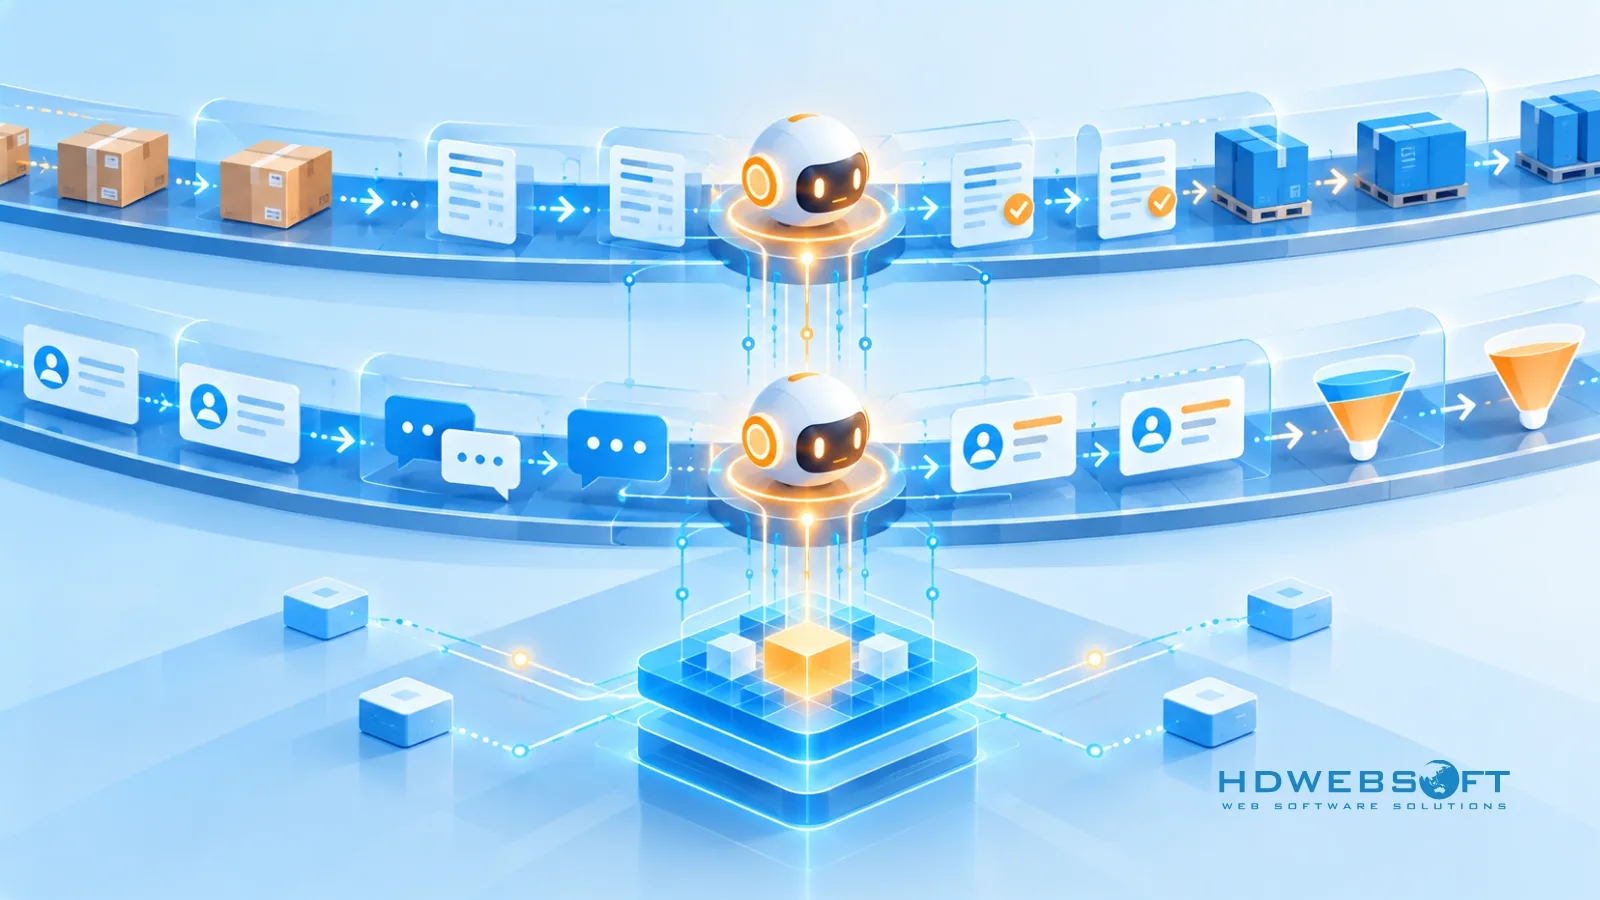
Abstrakte Prinzipien wirken stärker in konkreten Workflows. Auf einer gut gestalteten SI-fähigen Grundlage ist das Betriebsmuster konsistent: Ein Agent liest ein Ereignis, schlussfolgert über sauberen Daten, handelt über die API, hinterlässt eine maschinenlesbare Spur und eskaliert, sobald die Aktion seine Stufe überschreitet. Was sich unterscheidet, ist die Domäne.
Auf der ERP-Seite sind die wertvollsten frühen Workloads jene, die in systemübergreifendem Abgleich ertrinken:
- Order-to-Cash-Überwachung — ein Agent beobachtet Bestellereignisse, erkennt Abweichungen zwischen geliefert, berechnet und bezahlt und eröffnet Abgleichfälle mit bereits angehängten Nachweisen.
- Bestandsrebalancing — Nachfragesignale und Bestandsereignisse lösen vorgeschlagene Umlagerungsaufträge aus; unterhalb der Risikoschwelle werden sie automatisch ausgeführt, darüber landen sie in der Genehmigungswarteschlange.
- Lieferantenabgleich — Agenten gleichen kontinuierlich Rechnungen, Wareneingänge und Bestellkonditionen ab und markieren die Ausnahmen, die Menschen zum Monatsende suchen.
Auf der CRM-Seite verschiebt sich das Muster vom Abgleich zur Progression — kundenorientierte Arbeit voranbringen, ohne dass ein Mensch es bemerken muss:
- Lead-Qualifizierung und -Routing — Engagement- und firmografische Ereignisse lösen Scoring, Anreicherung und Zuweisung in Sekunden statt Tagen aus.
- Fall-Triage — eingehende Fälle werden klassifiziert, dedupliziert und mit vormontiertem Kontext geroutet; der Mensch erhält einen Fall, keine Warteschlange.
- Angebotserstellung — Agenten entwerfen Angebote aus Preisregeln und Deal-Kontext zur Freigabe durch den Vertrieb und komprimieren eine halbe Arbeitstag-Aufgabe zu einer Prüfung.
Das ist die Richtung, in die sich große Anbieter bereits bewegen: Plattformen wie SAP Business AI betten heute Agenten für Serviceabwicklung, Rechnungsabgleich und Lieferkettenüberwachung in ihre Suites ein. Anbieter-Agenten operieren jedoch innerhalb des Datenmodells des Anbieters und in dessen Grenzen. Wenn Ihre Workflows, Datensemantik oder Autonomieregeln von den Standardwerten der Plattform abweichen — was meist der Fall ist — wird die Lücke zum Argument für individuelle CRM-Entwicklung, bei der agentenverfügbare Felder, Aktionen und Genehmigungsstufen um Ihre Prozesse herum entworfen werden, statt nachträglich an die Annahmen eines Anbieters angepasst zu werden.
Modernisieren, erweitern oder neu aufbauen? Den eigenen Weg wählen
Wenige Unternehmen können — oder sollten — ihr ERP und CRM im Namen der Agentenfähigkeit komplett ersetzen. Die realistische Entscheidung ist ein Spektrum, und der richtige Punkt darauf hängt von Ihrem Datenmodell, Ihrer Integrationslandschaft und davon ab, wie viel Ihrer Prozesslogik wirklich differenzierend ist.
| Weg | Was er bedeutet | Am besten wenn | Vorsicht vor |
|---|---|---|---|
| Nachrüsten | Das Legacy-System mit APIs, Event-Emittern und einer Logging-Schicht umhüllen | Datenmodell ist solide; Budget und Risikobereitschaft gering | Flache Wrapper legen Felder frei, keine Fähigkeiten — die Logik bleibt gefangen |
| Erweitern | Den Kern behalten; SI-fähige Module für agentennahe Domänen daneben bauen | Kern ist stabil, aber bestimmte Domänen brauchen jetzt Agentenbetrieb | Zwei Architekturstile zu pflegen; Grenzen erfordern Disziplin |
| Neuaufbau | Den Kern durch ein maßgeschneidertes System ersetzen, das von Tag eins an agentenbedienbar ist | Ihr Datenmodell ist ein Wettbewerbsvorteil; Anbietergrenzen blockieren benötigte Autonomie | Höchste Kosten und Migrationsrisiko; nur durch dauerhafte Differenzierung gerechtfertigt |
Ehrliche Bewertung zählt mehr als Begeisterung. Individualentwicklung ist nicht automatisch die beste Antwort — sie ist es unter bestimmten Bedingungen: wenn Ihre Prozesssemantik von dem abweicht, was Suites gut abbilden, wenn Sie direkte Kontrolle über das Datenmodell brauchen, über dem Agenten schlussfolgern werden, oder wenn Anbieter-Roadmaps Fähigkeiten sperren, die Ihre Strategie erfordert. Die Vergleichskriterien, die dies tatsächlich entscheiden, sind die Total Cost of Ownership über 5–10 Jahre, die Integrationstiefe, die Ihre Agenten-Anwendungsfälle verlangen, das Migrationsrisiko für laufende Abläufe und die Obergrenze, die eine Anbieterplattform über Autonomiestufen legt.
Für Organisationen auf dem Neuaufbau-Pfad bietet individuelle ERP-Entwicklung einen entscheidenden Vorteil für die SI-Fähigkeit: Datenmodell, API-Fläche, Ereignisrückgrat und Audit-Schema werden als kohärentes Ganzes entworfen — nicht nachträglich mit der Architektur eines Anbieters verhandelt. Aber dieselbe Ehrlichkeit gilt umgekehrt: Wenn eine Suite bereits 90 % Ihres Bedarfs abdeckt, ist ihre Erweiterung die klügere Engineering-Entscheidung.
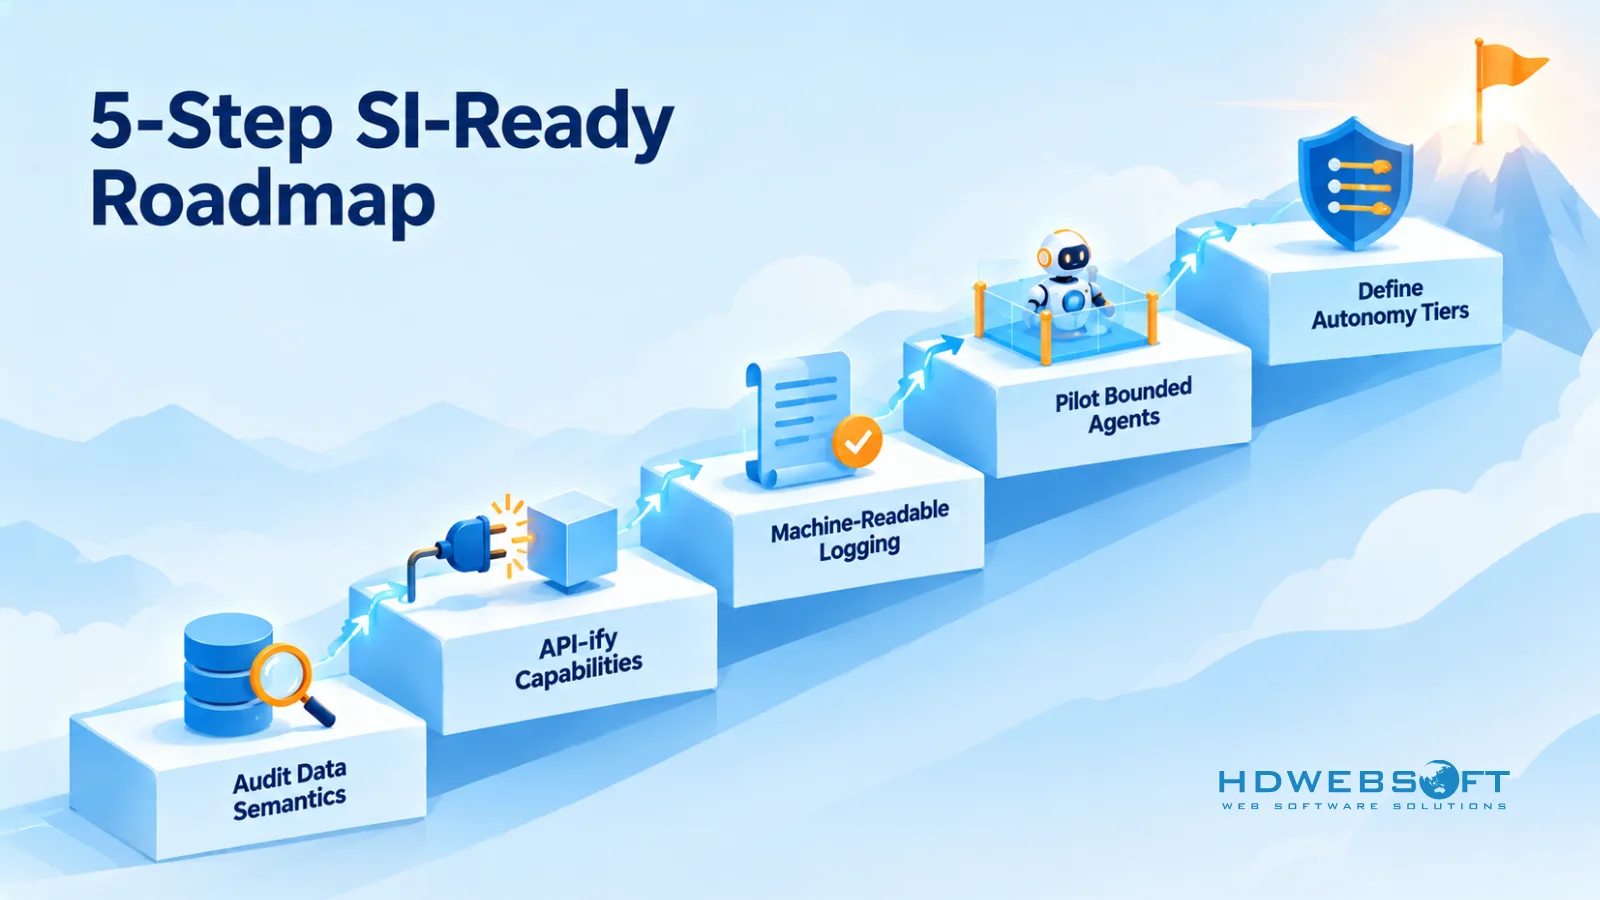
Wie Sie Ihre Geschäftssysteme auf autonome KI vorbereiten: Eine 5-Schritte-Roadmap
Die Lücke zwischen KI-Adoption und KI-Fähigkeit ist bereits messbar. McKinseys State of AI 2025 stellt fest, dass die meisten Organisationen KI inzwischen in mindestens einer Geschäftsfunktion einsetzen, die Mehrheit jedoch im Pilotstadium stecken bleibt statt zu skalieren — und die Blocker sind überwältigend Daten-, Workflow- und Governance-Fundamente statt Modellfähigkeit. Die folgenden fünf Schritte greifen genau diese Fundamente an, und jeder liefert Wert unabhängig davon, wann — oder ob — Superintelligenz ankommt.
- Prüfen Sie Ihre Datensemantik. Inventarisieren Sie Ihre Kernentitäten — Kunde, Bestellung, Produkt, Fall — und beantworten Sie für jede: Gibt es eine einzige Definition? Sind Feldbedeutungen dokumentiert? Stimmen parallele Module überein? Das Ergebnis ist eine Lückenliste, und sie erklärt meist, warum frühere KI-Piloten ins Stocken gerieten.
- API-fizieren Sie kritische Fähigkeiten. Wählen Sie die zehn Operationen, die ein Agent zuerst bräuchte — die aus Ihren frühen Anwendungsfällen — und stellen Sie sie als kontrollierte, dokumentierte Endpunkte bereit. Sie müssen nicht alles umhüllen; Sie brauchen die wertvollste Fläche aufrufbar.
- Führen Sie maschinenlesbares Logging ein. Instrumentieren Sie die oben beschriebene Akteur-Aktion-Begründung-Daten-Kette in den Domänen, die Sie zuerst API-fiziert haben. Wenn Sie nicht rekonstruieren können, warum eine Aktion geschah, war sie nicht sicher zu automatisieren.
- Pilotieren Sie begrenzte Agenten-Anwendungsfälle. Wählen Sie Workflows mit hohem Volumen, geringem Risiko und voller Reversibilität — Fall-Triage, Abgleichmarkierung, Entwurfsgenerierung. Nur Stufe-0- und Stufe-1-Autonomie; messen Sie gegen menschliche Baselines, bevor Sie ausweiten.
- Definieren Sie Autonomiestufen und Governance. Formalisieren Sie Berechtigungsstufen, Genehmigungsschwellen und Eskalationswege, bevor Agenten dagegen drücken. Governance, die unter Vorfallsdruck geschrieben wird, ist immer schlechter als Governance, die im Voraus geschrieben wurde.
Die Reihenfolge zählt weniger als die Ordnungslogik: Semantik vor APIs, APIs vor Agenten, Governance vor Autonomie. Teams, die das umdrehen — Agenten auf undokumentierte Daten ohne Audit-Kette ausrollen — lernen dieselben Lektionen als Produktionsvorfälle statt als Design-Reviews.
Fazit: SI-Fähigkeit ist eine Entscheidung, keine Frist
Niemand kann Ihnen sagen, wann — oder ob — Superintelligenz ankommt. Was sich wissen lässt, ist enger und nützlicher: Die Systeme, auf denen Ihr Geschäft läuft, wurden für menschliche Operatoren entworfen, und jeden Monat wird mehr Arbeit darin an Software delegiert, die eigenständig handelt. SI-fähiges ERP und CRM ist schlicht die Entscheidung, jetzt für diesen Operator zu entwerfen — saubere Daten, die Agenten interpretieren können, APIs, die sie aufrufen können, Audit-Trails, die sie hinterlassen müssen, und Grenzen, die sie nicht überschreiten dürfen.
Jeder Schritt zu dieser Architektur zahlt sich sofort aus: bessere Integrationen, sauberere Migrationen, sicherere Automatisierung, KI-Funktionen, die auf Ihren Daten statt auf Demo-Daten laufen. Die Organisationen, die autonome Agenten reibungslos aufnehmen werden, sind nicht die, die auf Gewissheit warteten — es sind die, die ihre Systeme lesbar machten, solange es noch günstig war.
HDWEBSOFT entwirft und baut maßgeschneiderte Geschäftssysteme und Integrationen mit von Anfang an eingebauter Agentenfähigkeit — über unsere KI-Entwicklungsdienstleistungen helfen wir Unternehmen, ihre aktuelle ERP- und CRM-Landschaft zu bewerten und die hier beschriebenen Fundamente zu bauen. Wenn Sie Modernisieren gegen Neuaufbau abwägen, ist genau dieses Gespräch unser Ausgangspunkt.
FAQ
Was ist ein SI-fähiges ERP-System?
Ein SI-fähiges ERP-System ist eine Enterprise-Resource-Planning-Plattform, die so konzipiert ist, dass autonome KI-Agenten sicher in ihr arbeiten können: saubere und semantisch dokumentierte Daten, jede Funktion über APIs aufrufbar, maschinenlesbare Audit-Trails für jede Änderung und begrenzte Autonomie mit menschlichen Kontrollpunkten. Es ist ein zukunftsorientierter Architekturansatz, kein zertifizierter Standard.
Können bestehende ERP- und CRM-Plattformen SI-fähig werden?
Teilweise. Bestehende Plattformen können sich der SI-Fähigkeit annähern, indem sie Datenmodelle bereinigen, Funktionen über APIs und Events bereitstellen und maschinenlesbares Logging hinzufügen — doch Plattformen, die um UI-gesteuerte Workflows und proprietäre Logik herum gebaut sind, haben strukturelle Grenzen. Wie weit eine Nachrüstung reicht, hängt davon ab, wie viel Kontrolle Sie über das Datenmodell und die Integrationsschicht haben.
Was ist der Unterschied zwischen API-first- und SI-fähiger Architektur?
API-first bedeutet, dass jede Systemfunktion über eine klar definierte Schnittstelle bereitgestellt wird. SI-fähig baut auf API-first auf und stellt drei zusätzliche Anforderungen: semantisch modellierte Daten, die Agenten interpretieren können, maschinenlesbare Audit-Trails für jede Aktion und Kontrollen für begrenzte Autonomie, die festlegen, was Agenten ohne menschliche Genehmigung tun dürfen.
Sollten wir unser ERP und CRM für KI-Agenten modernisieren oder neu aufbauen?
Das hängt von Ihren Rahmenbedingungen ab. Nachrüstung ist günstiger und risikoärmer, wenn Ihr Datenmodell solide ist; eine Erweiterung um neue SI-fähige Module funktioniert, wenn der Kern stabil bleiben muss; ein maßgeschneiderter Neuaufbau ergibt Sinn, wenn Ihr Datenmodell ein Wettbewerbsvorteil ist oder Anbietergrenzen die benötigte Autonomie blockieren. Vergleichen Sie TCO, Integrationsanforderungen, Migrationsrisiko und Roadmap-Grenzen des Anbieters, bevor Sie entscheiden.
Welche Anforderungen an Audit-Trails stellen autonome KI-Agenten?
Agenten-Audit-Trails müssen maschinenlesbar sein und für jede Zustandsänderung erfassen: welcher Agent oder Mensch gehandelt hat, welche Aktion ausgeführt wurde und warum, welche Daten gelesen und geändert wurden, welche Richtlinie die Aktion autorisiert hat und wie sie rückgängig gemacht werden kann. Das ist dieselbe Beweiskette, die Wirtschaftsprüfer bereits von Finanzsystemen erwarten — erweitert auf nicht-menschliche Akteure.