Los copilotos de IA actuales asisten a las personas que trabajan dentro de los sistemas ERP y CRM. La próxima generación de IA no asistirá — operará. A medida que las empresas comienzan a prepararse para la superinteligencia artificial y los agentes cada vez más autónomos que la preceden, los sistemas de registro que ejecutan finanzas, ventas, compras y relaciones con clientes se convierten en el cuello de botella crítico. Un agente de IA que razona a la perfección sigue siendo inútil si no puede leer sus datos, invocar sus flujos de trabajo o dejar un rastro en el que un auditor pueda confiar.
El ERP y CRM preparado para la SI es la respuesta arquitectónica a ese problema: sistemas empresariales diseñados para que los agentes de IA funcionen como usuarios operativos de primera clase — leyendo datos semánticamente limpios, actuando a través de APIs gobernadas y dejando evidencia legible por máquinas de todo lo que hacen. No es una categoría de producto, una certificación ni una casilla de proveedor. Es un conjunto de decisiones de diseño que usted toma ahora, mientras los requisitos aún son baratos de cumplir.
Esta guía explica qué significa realmente “preparado para la SI” para ERP y CRM, por qué las arquitecturas legacy bloquean a los agentes, los principios de diseño que hacen operables los sistemas para agentes, y cómo elegir entre modernizar, extender o reconstruir.
Puntos clave
- Preparado para la SI significa que un ERP o CRM trata a los agentes de IA como usuarios operativos de primera clase — con datos legibles por máquinas, capacidades invocables y acciones trazables — en lugar de acoplar IA sobre interfaces solo para humanos.
- Los sistemas legacy fallan con los agentes no porque falte IA, sino porque los datos están indocumentados, la lógica de negocio está enterrada en las UI y las acciones no dejan rastro legible por máquinas.
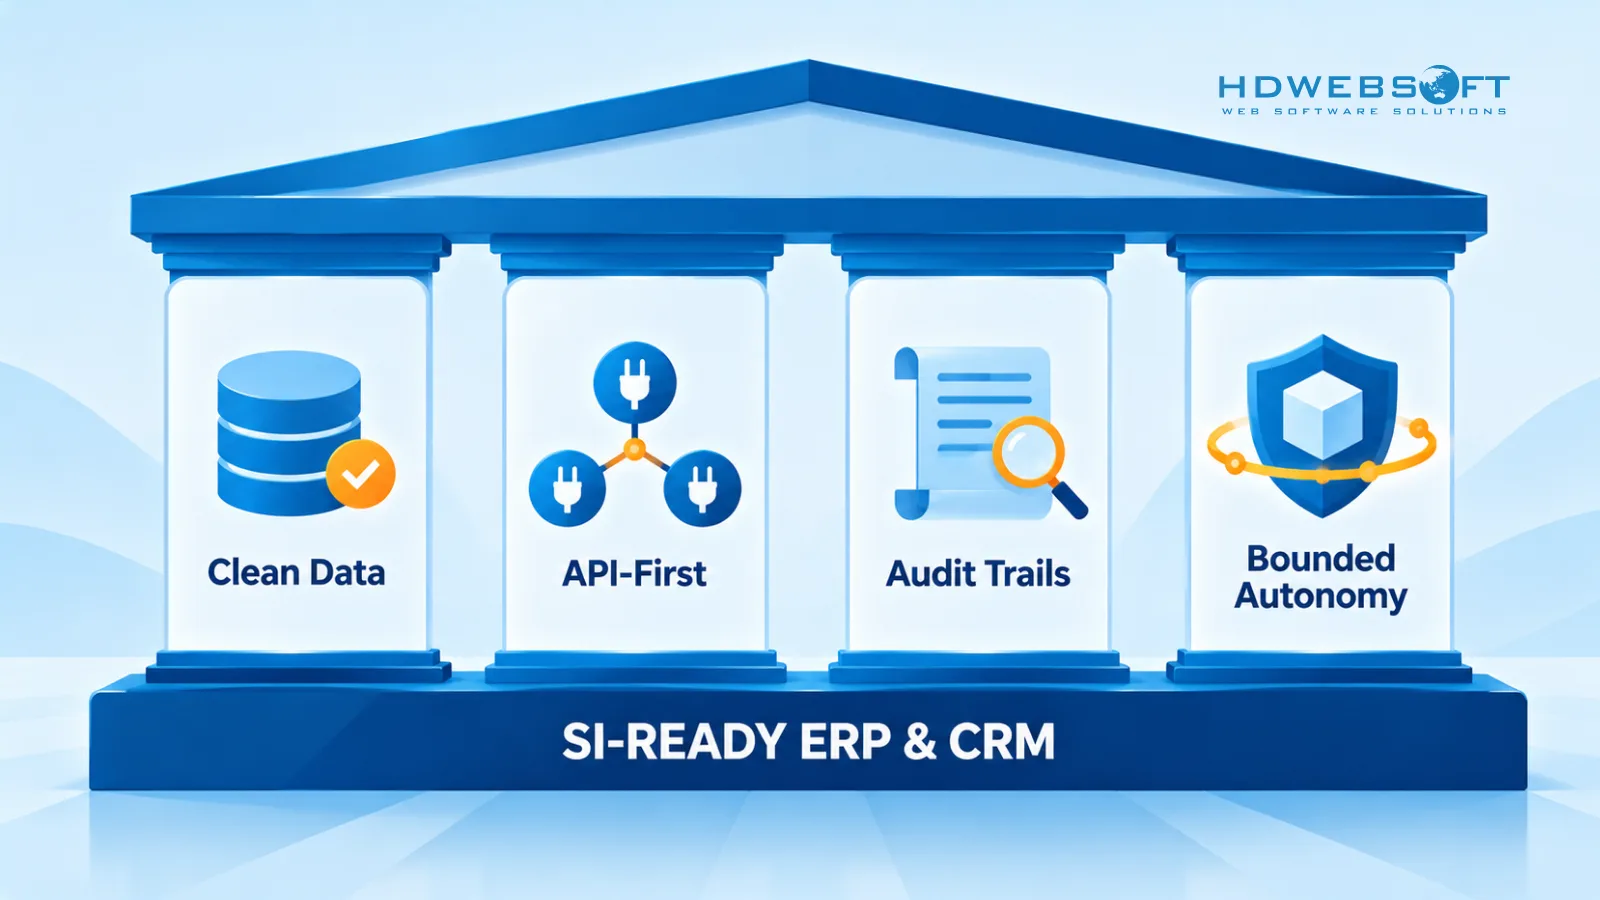
- Los cuatro pilares de diseño son datos semánticos limpios, integración API-first y orientada a eventos, pistas de auditoría legibles por máquinas y autonomía limitada con supervisión humana.
- Modernizar frente a reconstruir es una decisión de TCO y control, no una preferencia tecnológica — el desarrollo a medida es más sólido cuando su modelo de datos es un activo competitivo, no una respuesta universal.
- La preparación es arquitectónica, no futurista: cada paso hacia la preparación para la SI también mejora las integraciones de IA de hoy.
¿Qué significa “preparado para la SI” en sistemas ERP y CRM?
Un sistema preparado para la SI es un sistema de registro empresarial que trata a los agentes de IA como usuarios operativos legítimos — no como plugins que leen una pantalla destinada a otra persona. Concretamente, significa que el sistema satisface tres condiciones a la vez: los agentes pueden entender lo que significan los datos, actuar sobre el negocio mediante capacidades invocables y rendir cuentas de cada cambio que realizan.
Conviene separar dos ideas que a menudo se confunden. Preparado para IA describe lo que la mayoría de los proveedores venden hoy: un sistema que soporta copilotos, funciones predictivas o asistentes integrados — herramientas que asesoran a humanos que siguen siendo los verdaderos operadores. Preparado para la SI describe una condición más allá: el sistema sigue siendo operable, auditable y seguro a medida que los agentes asumen trabajo autónomo de múltiples pasos — y lo sigue siendo conforme la capacidad de los agentes crece hacia niveles que hoy no podemos especificar por completo.
Una salvedad honesta: “preparado para la SI” es un enfoque arquitectónico orientado al futuro, no un estándar técnico establecido ni una certificación. Ningún organismo del sector lo define y ningún proveedor puede venderle un ERP certificado como preparado para la SI — la propia superinteligencia artificial no existe. Lo que el término captura de forma útil es una dirección de diseño: construir sistemas que no habrá que desarmar cuando los agentes pidan hacer trabajo real.
Cinco rasgos definen esa dirección en la práctica:
- Datos modelados semánticamente — entidades, campos y relaciones llevan significado legible por máquinas, no solo formatos de almacenamiento.
- Capacidades invocables — cada operación de negocio se expone mediante APIs, no encerrada dentro de pantallas.
- Integración orientada a eventos — el sistema emite lo que ocurre, cuando ocurre, en lugar de agrupar la verdad en sincronizaciones nocturnas.
- Pistas de auditoría legibles por máquinas — cada cambio de estado registra quién actuó, por qué y sobre qué datos.
- Autonomía limitada — niveles de permiso y controles de aprobación definen qué puede hacer un agente sin un humano.
ERP y CRM se sitúan en la capa de aplicación de un stack más amplio. Si está mapeando cómo estos sistemas encajan junto a gateways de modelos, capas de orquestación y plataformas de datos empresariales, nuestro plano de arquitectura de superinteligencia empresarial cubre el panorama completo; este artículo se centra en los dos sistemas sobre los que su negocio realmente opera.
Por qué las arquitecturas ERP y CRM legacy bloquean la IA avanzada
Los sistemas ERP y CRM legacy se diseñaron en torno a una única suposición: un humano se sitúa entre los datos y cada decisión. Las interfaces presentan registros para que las personas los lean; los formularios recogen lo que las personas escriben; los flujos de trabajo codifican los pasos que las personas siguen. Esa suposición sirvió bien durante dos décadas — y es precisamente lo que se rompe cuando un agente intenta hacer el trabajo en su lugar.
Cuatro cuellos de botella estructurales aparecen en casi todo entorno legacy:
- Datos en silos e indocumentados. El mismo cliente existe como cinco registros ligeramente distintos entre módulos. Campos como
CUST_STAT_CDcargan conocimiento tribal que ninguna documentación captura. Los humanos compensan con experiencia; los agentes no pueden. - Lógica de negocio enterrada en las UI. La regla “los pedidos de más de 50.000 dólares necesitan aprobación financiera” vive en un script de formulario o un procedimiento almacenado — no en un servicio que un agente pueda invocar. La única forma de ejecutar la lógica es simular un usuario haciendo clic por las pantallas.
- Integración punto a punto. Décadas de conectores a medida hacen que los datos lleguen tarde, lleguen distintos o no lleguen. Un agente que necesita inventario actual, pedidos abiertos y estado del cliente a la vez recibe tres instantáneas inconsistentes.
- Sin responsabilidad legible por máquinas. Los logs de auditoría, donde existen, registran que un registro cambió — no quién autorizó el cambio, qué razonamiento lo precedió ni qué datos lo informaron. Responden “qué ocurrió” para humanos; no pueden responder “por qué ocurrió” para nadie.
| Patrón legacy | Modo de fallo del agente |
|---|---|
| Campos indocumentados con semántica tribal | El agente malinterpreta los datos y actúa sobre una premisa errónea — con confianza |
| Reglas de negocio encerradas en lógica de formularios | El agente evade los controles o debe fingir una sesión humana para activarlas |
| Sincronización nocturna por lotes entre módulos | El agente decide sobre instantáneas obsoletas e inconsistentes |
| Logs de cambios sin contexto de razonamiento | Las auditorías fallan: nadie puede reconstruir por qué el agente hizo lo que hizo |
| Permisos de UI como único control de acceso | El agente hereda privilegios humanos amplios — o queda bloqueado por completo |
El patrón bajo todo esto: el conocimiento y las capacidades del sistema solo son accesibles a través de interfaces con forma humana. Los agentes no fallan aquí por falta de inteligencia. Fallan porque nada de lo que necesitan es accesible por máquinas.
Principios de diseño centrales de la arquitectura ERP y CRM preparada para la SI
Cuatro principios de diseño convierten un sistema de registro en un sistema que los agentes pueden operar de verdad. Ninguno requiere esperar a una IA más inteligente — cada uno rinde frutos también en las integraciones de hoy.
Datos limpios y modelados semánticamente
Los agentes consumen significado, no bytes. Una capa de datos preparada para la SI da a cada entidad central — cliente, pedido, factura, contrato, caso — una única definición canónica compartida entre módulos, con campos que llevan semántica explícita: qué significa el valor, qué unidades usa, qué estados son legales y cómo se relaciona con otras entidades.
En la práctica esto significa mantener un glosario de negocio gobernado que vive con los datos, no en un wiki que nadie lee: descripciones a nivel de campo, valores de estado enumerados con su significado de negocio, relaciones documentadas y linaje que muestra de dónde procede cada valor. Cuando un agente encuentra status = PENDING_CREDIT, los propios metadatos del sistema deberían decirle qué significa crédito pendiente y qué acciones son válidas en ese estado — si no, el agente adivina, y adivinar a escala empresarial se convierte en incidentes.
Este es también el principio menos glamuroso y más trascendental. Cada capa posterior — APIs, pistas de auditoría, controles de autonomía — asume que los datos subyacentes son interpretables. La limpieza de datos es poco glamurosa precisamente porque es fundacional.
Integración API-first y orientada a eventos
Si los datos son lo que los agentes leen, las APIs son lo que tocan. Los sistemas preparados para la SI exponen cada capacidad de negocio significativa — crear pedido, liberar retención, calificar lead, aprobar devolución — como un endpoint gobernado con entradas, salidas y permisos explícitos. Una prueba útil: cualquier operación que un empleado capacitado pueda realizar debería poder hacerse a través de la superficie de API, sin simular una interfaz de usuario.
Igual de importante es cómo se propagan los cambios. La sincronización por lotes da a los agentes instantáneas obsoletas; una espina dorsal orientada a eventos — pedido creado, pago recibido, caso escalado, cada uno publicado al ocurrir — da a los agentes la misma consciencia en tiempo real que un humano obtiene mirando una pantalla. Los agentes se suscriben a flujos de eventos en lugar de sondear tablas, lo que es más rápido y dramáticamente más barato en infraestructura.
Los estándares emergentes están reduciendo el coste de integración aquí. El Model Context Protocol (MCP), por ejemplo, define una forma uniforme para que los agentes descubran e invoquen herramientas y fuentes de datos externas. Conviene ser preciso sobre lo que MCP hace y no hace: estandariza la conversación entre un agente y un sistema — descubrimiento de herramientas, descripción de capacidades, formato de invocación. No reemplaza sus APIs, su modelo de autorización ni sus validaciones de negocio. Esas siguen siendo suyas para diseñar. MCP hace que una superficie de API bien diseñada sea consumible por agentes; no puede rescatar un sistema cuyas capacidades no son invocables en primer lugar.
Pistas de auditoría legibles por máquinas
Cuando un agente cambia un registro, “alguien actualizó este campo” ya no es una entrada de log suficiente. Las pistas de auditoría preparadas para la SI capturan la cadena de evidencia completa de cada cambio de estado, en una forma que las máquinas — y los auditores — pueden interrogar:
- Actor — qué agente, cuenta de servicio o humano actuó, y bajo la autoridad de quién
- Acción — la operación realizada, con sus entradas y el cambio de estado resultante
- Justificación — el evento desencadenante, la política o ruta de razonamiento que lo justificó, y cualquier aprobación humana obtenida
- Datos tocados — qué registros se leyeron para informar la decisión, no solo cuáles se escribieron
- Reversibilidad — cómo puede deshacerse la acción, y si ya se ha deshecho
No es una invención nueva — los sistemas financieros y sanitarios llevan décadas exigiendo cadenas de evidencia equivalentes. Lo que cambia es el actor: el rastro debe estar estructurado para que los sistemas de supervisión, no solo los auditores humanos, puedan evaluar el comportamiento del agente de forma continua. Estas mecánicas de auditoría conectan directamente con el stack de responsabilidad más amplio — aplicación de políticas, niveles de supervisión y respuesta a incidentes — que cubrimos en gobernanza de la superinteligencia.
Autonomía limitada y supervisión humana
El último principio traza la línea entre lo que los agentes pueden hacer solos y lo que aún requiere una persona. La autonomía limitada significa que los permisos se expresan como niveles de consecuencia, no como un “acceso de agente: sí/no” binario:
- Nivel 0 — Leer y recomendar. Los agentes analizan, redactan y proponen; los humanos ejecutan. Apropiado para la mayoría de los despliegues actuales.
- Nivel 1 — Ejecutar acciones reversibles de bajo impacto. Actualizar campos no financieros, enrutar casos, programar — con reversión instantánea.
- Nivel 2 — Ejecutar acciones financieras acotadas. Emitir reembolsos hasta un umbral, ajustar pedidos dentro de rangos definidos — con aprobación por encima del límite.
- Nivel 3 — Ejecutar acciones de alta consecuencia con aprobación obligatoria. Cambios de contratos, liberación de pagos, modificaciones de datos maestros — el agente prepara, un humano firma.
Cada nivel se aplica arquitectónicamente — en la capa de autorización de la API, no en las instrucciones del agente — de modo que ampliar el alcance de un agente es una decisión de gobernanza deliberada, nunca un comportamiento emergente. Los umbrales pertenecen a la configuración revisada por el negocio, no enterrados en un prompt.
Cómo operarán los agentes de IA dentro de ERP y CRM preparados para la SI
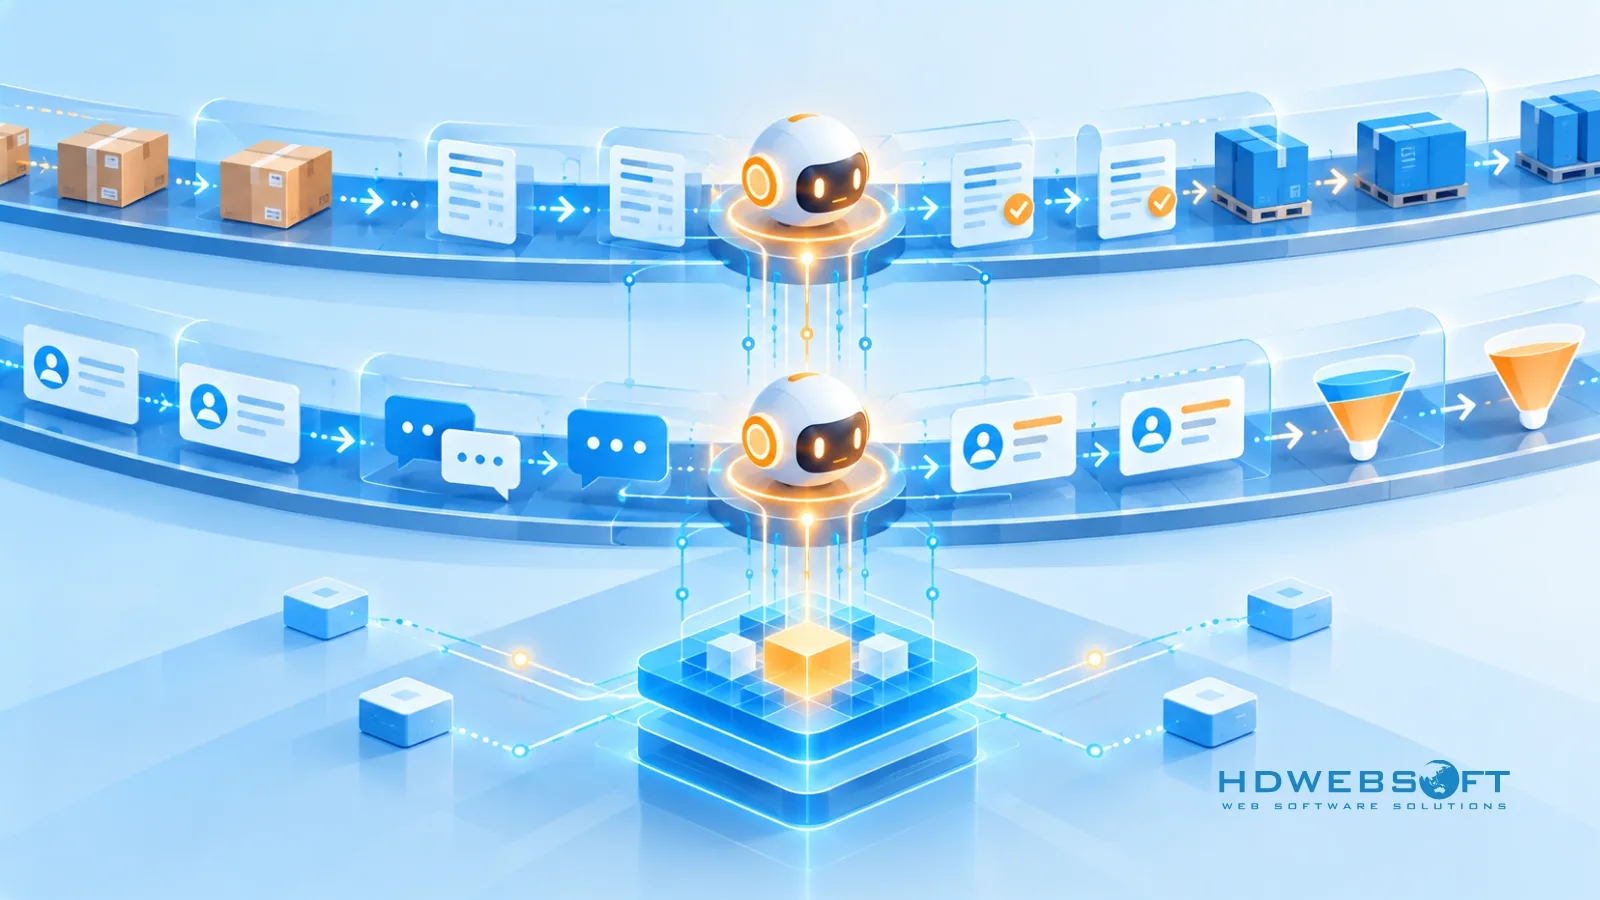
Los principios abstractos calan más en flujos de trabajo concretos. Sobre una base preparada para la SI bien diseñada, el patrón operativo es consistente: un agente lee un evento, razona sobre datos limpios, actúa a través de la API, deja un rastro legible por máquinas y escala siempre que la acción supera su nivel. Lo que difiere es el dominio.
En el lado ERP, las cargas de trabajo de mayor valor temprano son las ahogadas en conciliación entre sistemas:
- Monitorización order-to-cash — un agente vigila los eventos de pedidos, detecta discrepancias entre enviado, facturado y pagado, y abre casos de conciliación con la evidencia ya adjunta.
- Reequilibrio de inventario — las señales de demanda y los eventos de stock activan órdenes de transferencia propuestas; por debajo del umbral de riesgo se ejecutan automáticamente, por encima se ponen en cola para aprobación.
- Conciliación de proveedores — los agentes cruzan continuamente facturas, recepciones y condiciones de pedidos de compra, marcando las excepciones que los humanos persiguen a fin de mes.
En el lado CRM, el patrón pasa de conciliación a progresión — hacer avanzar el trabajo de cara al cliente sin esperar a que un humano lo note:
- Calificación y enrutamiento de leads — los eventos de engagement y firmográficos activan scoring, enriquecimiento y asignación en segundos en lugar de días.
- Triaje de casos — los casos entrantes se clasifican, deduplican y enrutan con el contexto prearmado; el humano recibe un caso, no una cola.
- Generación de presupuestos — los agentes redactan presupuestos a partir de reglas de precios y contexto del deal para aprobación del comercial, comprimiendo una tarea de medio día en una revisión.
Esta es la dirección que los grandes proveedores ya están tomando: plataformas como SAP Business AI ya integran agentes para resolución de servicio, conciliación de facturas y monitorización de la cadena de suministro dentro de sus suites. Sin embargo, los agentes del proveedor operan dentro del modelo de datos del proveedor y en sus límites. Cuando sus flujos de trabajo, semántica de datos o reglas de autonomía difieren de los valores por defecto de la plataforma — como suele ocurrir — la brecha se convierte en un argumento para el desarrollo de CRM a medida, donde los campos, acciones y niveles de aprobación permitidos al agente se diseñan en torno a sus procesos en lugar de adaptarse a las suposiciones de un proveedor.
¿Modernizar, extender o reconstruir? Elegir su camino
Pocas empresas pueden — o deben — reemplazar su ERP y CRM por completo en nombre de la preparación para agentes. La decisión realista es un espectro, y el punto correcto en él depende de su modelo de datos, su patrimonio de integración y cuánto de su lógica de proceso es realmente diferenciadora.
| Camino | Qué significa | Mejor cuando | Cuidado con |
|---|---|---|---|
| Modernizar | Envolver el sistema legacy con APIs, emisores de eventos y una capa de logging | El modelo de datos es sólido; presupuesto y apetito de riesgo bajos | Los envoltorios superficiales exponen campos, no capacidades — la lógica sigue atrapada |
| Extender | Mantener el núcleo; construir módulos preparados para la SI para dominios orientados a agentes junto a él | El núcleo es estable pero dominios específicos necesitan operación por agentes ya | Dos estilos arquitectónicos que mantener; los límites requieren disciplina |
| Reconstruir | Reemplazar el núcleo con un sistema a medida diseñado operable por agentes desde el día uno | Su modelo de datos es un activo competitivo; los límites del proveedor bloquean la autonomía necesaria | Mayor coste y riesgo de migración; solo justificado por diferenciación duradera |
La evaluación honesta importa más que el entusiasmo. El desarrollo a medida no es automáticamente la mejor respuesta — es la mejor respuesta bajo condiciones específicas: cuando la semántica de sus procesos diverge de lo que las suites modelan bien, cuando necesita control directo sobre el modelo de datos sobre el que razonarán los agentes, o cuando las hojas de ruta del proveedor limitan capacidades que su estrategia requiere. Los criterios de comparación que realmente deciden son el coste total de propiedad a 5–10 años, la profundidad de integración que exigen sus casos de uso de agentes, el riesgo de migración sobre operaciones en marcha y el techo que la plataforma del proveedor pone a los niveles de autonomía.
Para organizaciones en el camino de reconstrucción, el desarrollo de ERP a medida ofrece una ventaja decisiva para la preparación para la SI: el modelo de datos, la superficie de API, la espina dorsal de eventos y el esquema de auditoría se diseñan como un todo coherente — no se negocian con la arquitectura de un proveedor después. Pero la misma honestidad aplica a la inversa: si una suite ya cubre el 90% de lo que necesita, extenderla es la decisión de ingeniería más inteligente.
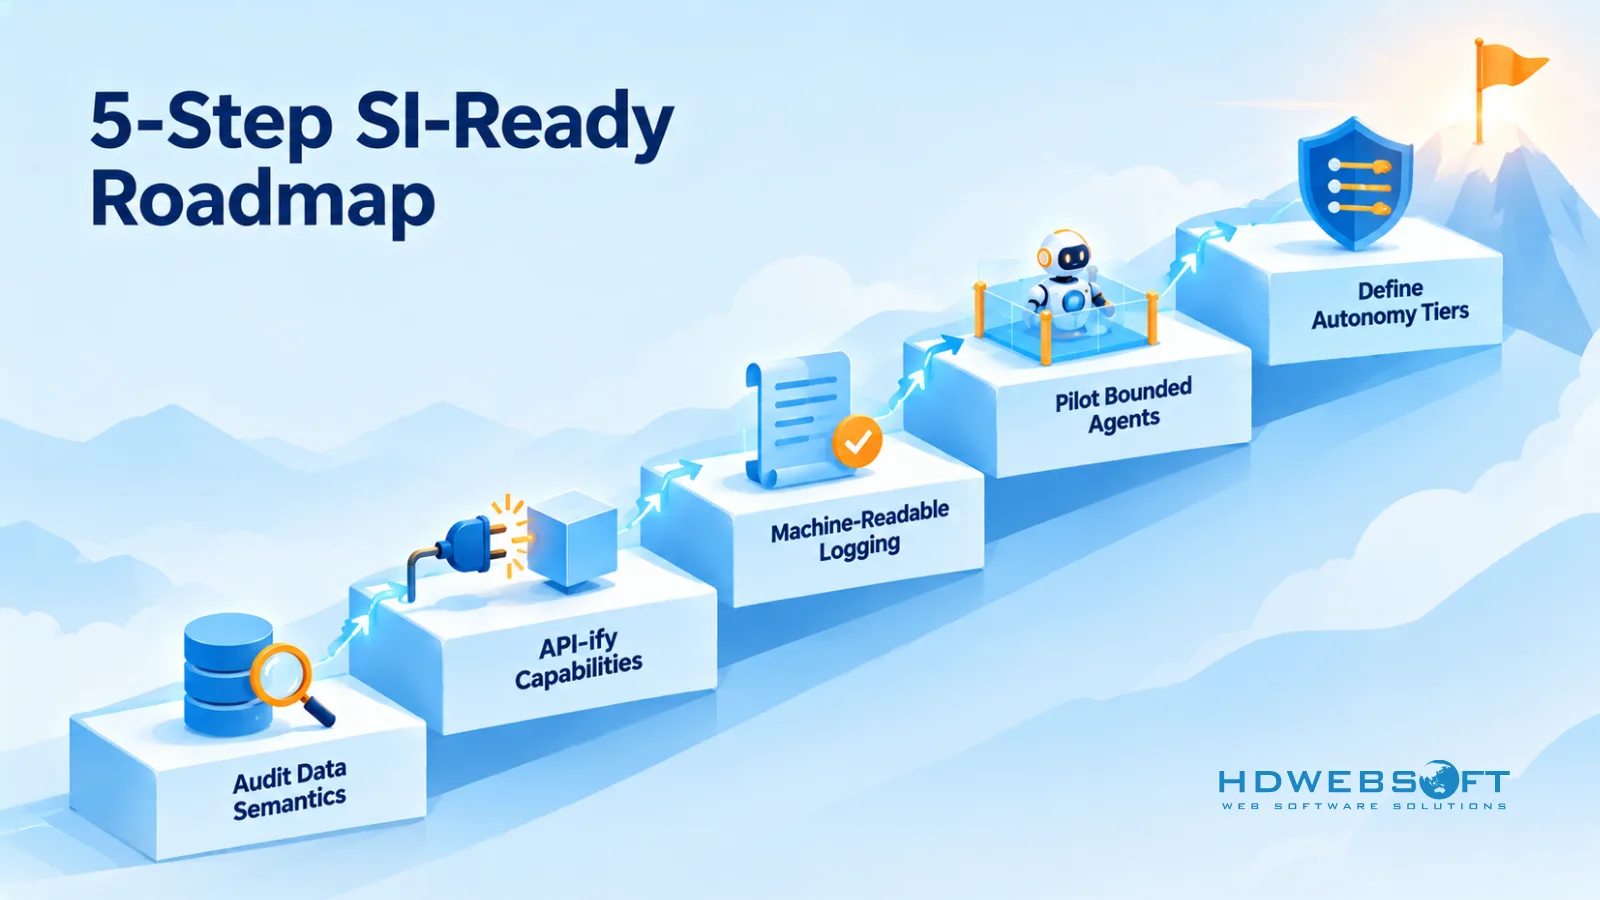
Cómo preparar sus sistemas empresariales para la IA autónoma: una hoja de ruta de 5 pasos
La brecha entre adopción de IA y preparación para la IA ya es medible. El State of AI in 2025 de McKinsey halla que la mayoría de las organizaciones ya usan IA en al menos una función de negocio, pero la mayoría siguen atascadas en pilotos en lugar de escalar — y los bloqueadores son abrumadoramente fundamentos de datos, flujos de trabajo y gobernanza, no capacidad del modelo. Los cinco pasos siguientes atacan exactamente esos fundamentos, y cada uno aporta valor independientemente de cuándo — o si — llega la superinteligencia.
- Audite su semántica de datos. Inventarie sus entidades centrales — cliente, pedido, producto, caso — y responda para cada una: ¿hay una única definición? ¿Están documentados los significados de los campos? ¿Coinciden los módulos paralelos? El resultado es una lista de brechas, y suele explicar por qué los pilotos de IA anteriores se estancaron.
- API-fique las capacidades críticas. Elija las diez operaciones que un agente necesitaría primero — las de sus casos de uso tempranos — y expóngalas como endpoints gobernados y documentados. No necesita envolverlo todo; necesita que la superficie de mayor valor sea invocable.
- Despliegue logging legible por máquinas. Instrumente la cadena actor-acción-justificación-datos descrita arriba en los dominios que API-ficó primero. Si no puede reconstruir por qué ocurrió una acción, no era seguro automatizarla.
- Pilote casos de uso de agentes acotados. Elija flujos de trabajo de alto volumen, bajo riesgo y totalmente reversibles — triaje de casos, marcado de conciliaciones, generación de borradores. Solo autonomía de nivel 0 y 1; mida contra líneas base humanas antes de expandir.
- Defina niveles de autonomía y gobernanza. Formalice los niveles de permiso, umbrales de aprobación y rutas de escalado antes de que los agentes presionen contra ellos. La gobernanza escrita bajo presión de incidentes siempre es peor que la escrita con antelación.
La secuencia importa menos que la lógica de ordenación: semántica antes que APIs, APIs antes que agentes, gobernanza antes que autonomía. Los equipos que lo invierten — desplegando agentes sobre datos indocumentados sin cadena de auditoría — aprenden las mismas lecciones como incidentes de producción en lugar de revisiones de diseño.
Conclusión: la preparación para la SI es una decisión, no un plazo
Nadie puede decirle cuándo — o si — llegará la superinteligencia. Lo que es conocible es más estrecho y más útil: los sistemas sobre los que opera su negocio se diseñaron para operadores humanos, y cada mes, más trabajo dentro de ellos se delega a software que actúa por su cuenta. El ERP y CRM preparado para la SI es simplemente la decisión de diseñar para ese operador ahora — datos limpios que los agentes puedan interpretar, APIs que puedan invocar, pistas de auditoría que deban dejar y límites que no puedan cruzar.
Cada paso hacia esa arquitectura rinde de inmediato: mejores integraciones, migraciones más limpias, automatización más segura, funciones de IA que funcionan sobre sus datos en lugar de datos de demo. Las organizaciones que absorberán agentes autónomos sin fricción no son las que esperaron certeza — son las que hicieron sus sistemas legibles mientras aún era barato hacerlo.
HDWEBSOFT diseña y construye sistemas empresariales e integraciones a medida con la preparación para agentes incorporada desde el inicio — a través de nuestros servicios de desarrollo de IA, ayudamos a las empresas a evaluar su panorama ERP y CRM actual y construir los fundamentos descritos aquí. Si está sopesando modernizar frente a reconstruir, esa conversación es exactamente donde empezamos.
FAQ
¿Qué es un sistema ERP preparado para la SI?
Un sistema ERP preparado para la SI es una plataforma de planificación de recursos empresariales diseñada para que agentes de IA autónomos puedan operar dentro de ella con seguridad: datos limpios y documentados semánticamente, todas las capacidades invocables mediante APIs, pistas de auditoría legibles por máquinas para cada cambio y autonomía limitada con controles de supervisión humana. Es un enfoque arquitectónico orientado al futuro, no un estándar certificado.
¿Pueden las plataformas ERP y CRM existentes volverse preparadas para la SI?
Parcialmente. Las plataformas existentes pueden avanzar hacia la preparación para la SI limpiando los modelos de datos, exponiendo capacidades mediante APIs y eventos, y añadiendo registro legible por máquinas — pero las plataformas construidas en torno a flujos de trabajo guiados por UI y lógica propietaria tienen límites estructurales. Hasta dónde llega la modernización depende del control que tenga sobre el modelo de datos y la capa de integración.
¿Cuál es la diferencia entre arquitectura API-first y preparada para la SI?
API-first significa que cada capacidad del sistema se expone mediante una interfaz bien definida. Preparado para la SI se construye sobre API-first con tres requisitos adicionales: datos modelados semánticamente que los agentes puedan interpretar, pistas de auditoría legibles por máquinas para cada acción y controles de autonomía limitada que definen qué pueden hacer los agentes sin aprobación humana.
¿Debemos modernizar o reconstruir nuestro ERP y CRM para agentes de IA?
Depende de sus restricciones. La modernización es más barata y de menor riesgo cuando el modelo de datos es sólido; extender con nuevos módulos preparados para la SI funciona cuando el núcleo debe permanecer estable; una reconstrucción a medida tiene sentido cuando su modelo de datos es un activo competitivo o los límites del proveedor bloquean la autonomía que necesita. Compare el TCO, los requisitos de integración, el riesgo de migración y las limitaciones de la hoja de ruta del proveedor antes de decidir.
¿Qué requisitos de pista de auditoría necesitan los agentes de IA autónomos?
Las pistas de auditoría de agentes deben ser legibles por máquinas y capturar, para cada cambio de estado: qué agente o humano actuó, qué acción se realizó y por qué, qué datos se leyeron y modificaron, qué política lo autorizó y cómo puede revertirse la acción. Es la misma cadena de evidencia que los auditores ya exigen a los sistemas financieros — extendida a actores no humanos.