Les copilotes IA d’aujourd’hui assistent les personnes qui travaillent dans les systèmes ERP et CRM. La prochaine génération d’IA n’assistera pas — elle opérera. Alors que les entreprises commencent à se préparer à la superintelligence artificielle et aux agents de plus en plus autonomes qui la précèdent, les systèmes d’enregistrement qui font tourner la finance, les ventes, les achats et les relations clients deviennent le goulot d’étranglement critique. Un agent IA capable de raisonner parfaitement reste inutile s’il ne peut pas lire vos données, appeler vos workflows ou laisser une trace en laquelle un auditeur peut avoir confiance.
L’ERP et le CRM prêts pour la SI sont la réponse architecturale à ce problème : des systèmes d’entreprise conçus pour que les agents IA fonctionnent comme des utilisateurs opérationnels de premier ordre — lisant des données sémantiquement propres, agissant via des API gouvernées et laissant des preuves lisibles par machine de tout ce qu’ils font. Ce n’est ni une catégorie de produit, ni une certification, ni une case à cocher chez un éditeur. C’est un ensemble de décisions de conception que vous prenez maintenant, tant que les exigences restent bon marché à satisfaire.
Ce guide explique ce que « prêt pour la SI » signifie réellement pour l’ERP et le CRM, pourquoi les architectures legacy bloquent les agents, les principes de conception qui rendent les systèmes opérables par des agents, et comment choisir entre moderniser, étendre ou reconstruire.
Points clés
- Prêt pour la SI signifie qu’un ERP ou un CRM traite les agents IA comme des utilisateurs opérationnels de premier ordre — avec des données lisibles par machine, des capacités appelables et des actions traçables — plutôt que de boulonner l’IA sur des interfaces réservées aux humains.
- Les systèmes legacy font échouer les agents non pas parce que l’IA manque, mais parce que les données ne sont pas documentées, que la logique métier est enterrée dans les UI et que les actions ne laissent aucune trace lisible par machine.
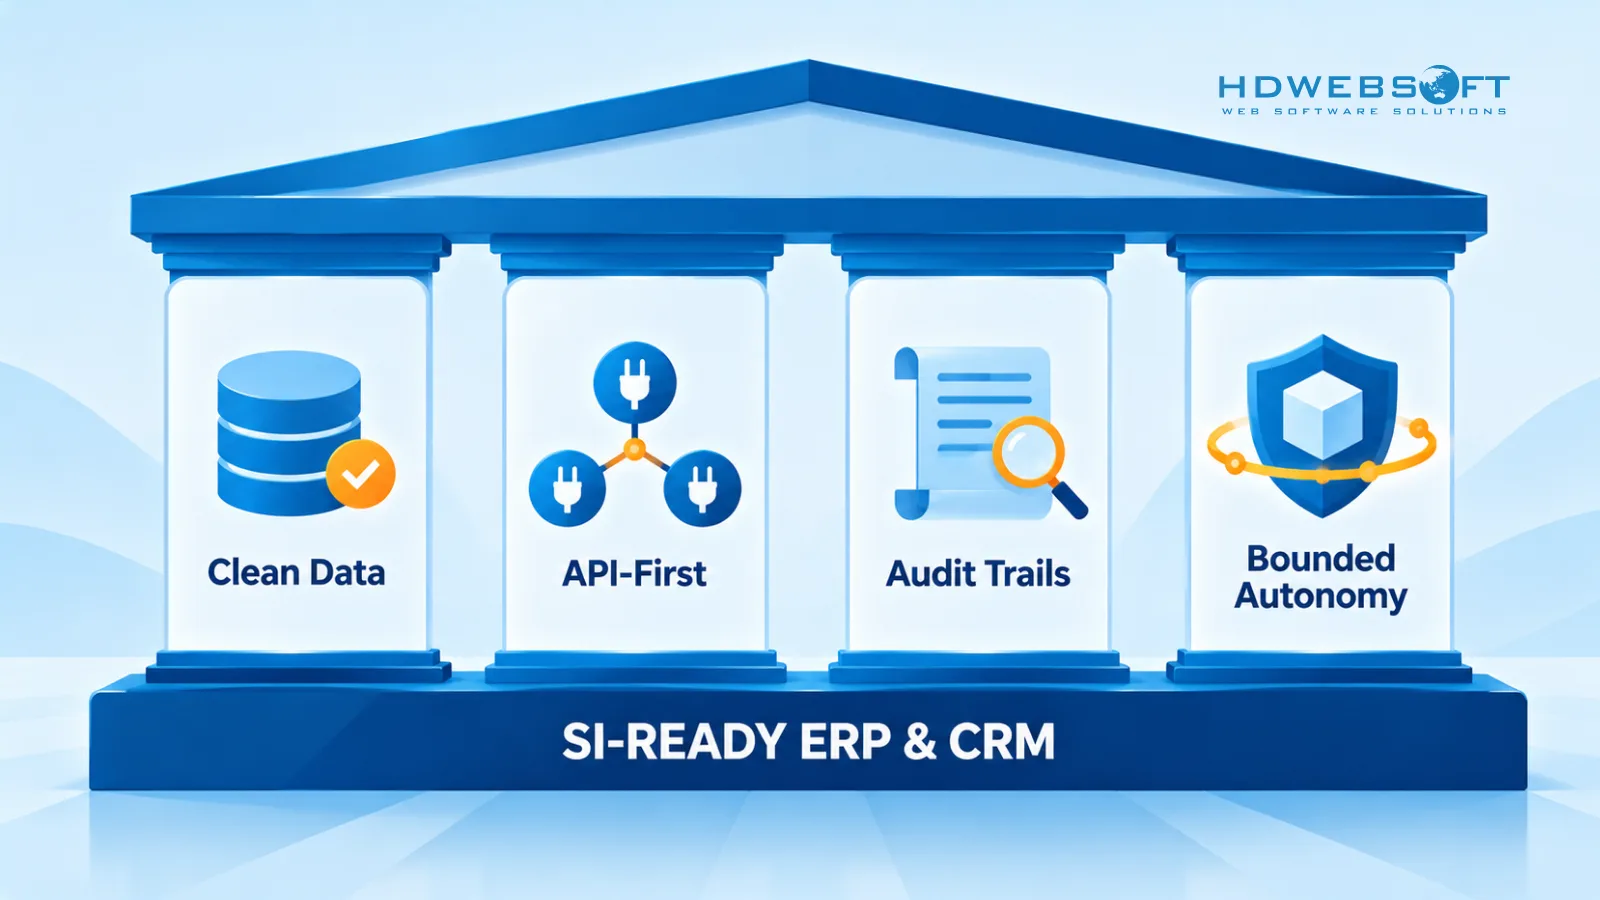
- Les quatre piliers de conception sont des données sémantiques propres, une intégration API-first et événementielle, des pistes d’audit lisibles par machine et une autonomie encadrée avec supervision humaine.
- Moderniser ou reconstruire est une décision de TCO et de contrôle, pas une préférence technologique — le développement sur mesure est plus pertinent lorsque votre modèle de données est un atout concurrentiel, pas une réponse universelle.
- La préparation est architecturale, pas futuriste : chaque pas vers la préparation à la SI améliore aussi les intégrations IA d’aujourd’hui.
Que signifie « prêt pour la SI » pour les systèmes ERP et CRM ?
Un système prêt pour la SI est un système d’enregistrement d’entreprise qui traite les agents IA comme des utilisateurs opérationnels légitimes — pas comme des plugins lisant un écran destiné à quelqu’un d’autre. Concrètement, cela signifie que le système satisfait trois conditions à la fois : les agents peuvent comprendre ce que signifient les données, agir sur l’activité via des capacités appelables, et rendre compte de chaque changement qu’ils effectuent.
Il est utile de séparer deux idées souvent confondues. Prêt pour l’IA décrit ce que la plupart des éditeurs vendent aujourd’hui : un système qui prend en charge copilotes, fonctions prédictives ou assistants intégrés — des outils qui conseillent des humains qui restent les vrais opérateurs. Prêt pour la SI décrit une condition plus avancée : le système reste opérable, auditable et sûr lorsque les agents assument un travail autonome en plusieurs étapes — et le reste à mesure que les capacités des agents progressent vers des niveaux que nous ne pouvons pas encore spécifier complètement.
Une réserve honnête s’impose : « prêt pour la SI » est une approche architecturale tournée vers l’avenir, pas un standard technique établi ni une certification. Aucun organisme sectoriel ne le définit et aucun éditeur ne peut vous vendre un ERP certifié prêt pour la SI — la superintelligence artificielle elle-même n’existe pas. Ce que le terme capture utilement, c’est une direction de conception : construire des systèmes qui n’auront pas besoin d’être démantelés quand les agents demanderont à faire du vrai travail.
Cinq traits définissent cette direction dans la pratique :
- Données modélisées sémantiquement — entités, champs et relations portent une signification lisible par machine, pas seulement des formats de stockage.
- Capacités appelables — chaque opération métier est exposée via des API, pas enfermée dans des écrans.
- Intégration événementielle — le système émet ce qui se passe, au moment où cela se passe, au lieu de regrouper la vérité dans des synchronisations nocturnes.
- Pistes d’audit lisibles par machine — chaque changement d’état enregistre qui a agi, pourquoi et sur quelles données.
- Autonomie encadrée — des niveaux de permission et des contrôles d’approbation définissent ce qu’un agent peut faire sans humain.
L’ERP et le CRM se situent à la couche applicative d’un stack plus large. Si vous cartographiez comment ces systèmes s’articulent avec les passerelles de modèles, les couches d’orchestration et les plateformes de données d’entreprise, notre plan d’architecture de superintelligence d’entreprise couvre la vue d’ensemble ; cet article reste concentré sur les deux systèmes sur lesquels votre entreprise tourne réellement.
Pourquoi les architectures ERP et CRM legacy bloquent l’IA avancée
Les systèmes ERP et CRM legacy ont été conçus autour d’une seule hypothèse : un humain se tient entre les données et chaque décision. Les interfaces présentent des enregistrements à lire ; les formulaires collectent ce que les gens saisissent ; les workflows encodent les étapes que les gens suivent. Cette hypothèse a bien servi pendant deux décennies — et c’est précisément ce qui se brise quand un agent tente de faire le travail à sa place.
Quatre goulots d’étranglement structurels apparaissent dans presque tous les environnements legacy :
- Données en silos et non documentées. Le même client existe sous cinq enregistrements légèrement différents entre modules. Des champs comme
CUST_STAT_CDportent un savoir tribal qu’aucune documentation ne capture. Les humains compensent par l’expérience ; les agents ne le peuvent pas. - Logique métier enterrée dans les UI. La règle « les commandes de plus de 50 000 dollars nécessitent une validation financière » vit dans un script de formulaire ou une procédure stockée — pas dans un service qu’un agent peut invoquer. La seule façon d’exécuter la logique est de simuler un utilisateur cliquant à travers les écrans.
- Intégration point à point. Des décennies de connecteurs sur mesure font que les données arrivent en retard, différemment ou pas du tout. Un agent qui a besoin simultanément du stock actuel, des commandes ouvertes et du statut client obtient trois instantanés incohérents.
- Aucune responsabilité lisible par machine. Les journaux d’audit, là où ils existent, enregistrent qu’un enregistrement a changé — pas qui a autorisé le changement, quel raisonnement l’a précédé ni quelles données l’ont informé. Ils répondent « que s’est-il passé » pour les humains ; ils ne peuvent répondre « pourquoi est-ce arrivé » pour personne.
| Modèle legacy | Mode d’échec de l’agent |
|---|---|
| Champs non documentés à la sémantique tribale | L’agent interprète mal les données et agit sur une prémisse erronée — avec assurance |
| Règles métier enfermées dans la logique de formulaires | L’agent contourne les contrôles ou doit simuler une session humaine pour les déclencher |
| Synchronisation nocturne par lots entre modules | L’agent décide sur des instantanés obsolètes et incohérents |
| Journaux de changements sans contexte de raisonnement | Les audits échouent : personne ne peut reconstruire pourquoi l’agent a fait ce qu’il a fait |
| Permissions UI comme seul contrôle d’accès | L’agent hérite de larges privilèges humains — ou est totalement bloqué |
Le schéma sous-jacent à tout cela : la connaissance et les capacités du système ne sont accessibles que par des interfaces à forme humaine. Les agents n’échouent pas ici par manque d’intelligence. Ils échouent parce que rien de ce dont ils ont besoin n’est accessible par machine.
Principes de conception fondamentaux d’une architecture ERP et CRM prête pour la SI
Quatre principes de conception transforment un système d’enregistrement en un système que les agents peuvent réellement opérer. Aucun n’exige d’attendre une IA plus intelligente — chacun rapporte dès les intégrations actuelles.
Données propres et modélisées sémantiquement
Les agents consomment du sens, pas des octets. Une couche de données prête pour la SI donne à chaque entité centrale — client, commande, facture, contrat, dossier — une définition canonique unique partagée entre modules, avec des champs portant une sémantique explicite : ce que la valeur signifie, quelles unités elle utilise, quels états sont valides et comment elle se rattache aux autres entités.
En pratique, cela signifie maintenir un glossaire métier gouverné qui vit avec les données, pas dans un wiki que personne ne lit : descriptions au niveau des champs, valeurs de statut énumérées avec leur signification métier, relations documentées et lignage montrant l’origine de chaque valeur. Quand un agent rencontre status = PENDING_CREDIT, les métadonnées du système lui-même devraient lui dire ce que signifie un crédit en attente et quelles actions sont valides dans cet état — sinon l’agent devine, et deviner à l’échelle d’une entreprise produit des incidents.
C’est aussi le principe le moins séduisant et le plus décisif. Chaque couche suivante — API, pistes d’audit, contrôles d’autonomie — suppose que les données sous-jacentes sont interprétables. Le nettoyage des données est ingrat précisément parce qu’il est fondamental.
Intégration API-first et événementielle
Si les données sont ce que les agents lisent, les API sont ce qu’ils touchent. Les systèmes prêts pour la SI exposent chaque capacité métier significative — créer une commande, lever un blocage, qualifier un lead, approuver un retour — comme un point de terminaison gouverné avec entrées, sorties et permissions explicites. Un test utile : toute opération qu’un employé formé peut réaliser devrait être réalisable via la surface d’API, sans simuler une interface utilisateur.
Tout aussi important est la façon dont les changements se propagent. La synchronisation par lots donne aux agents des instantanés obsolètes ; une dorsale événementielle — commande créée, paiement reçu, dossier escaladé, chacun publié à l’instant où il se produit — donne aux agents la même conscience temps réel qu’un humain regardant un écran. Les agents s’abonnent à des flux d’événements plutôt que d’interroger des tables, ce qui est à la fois plus rapide et nettement moins coûteux en infrastructure.
Les standards émergents réduisent le coût d’intégration ici. Le Model Context Protocol (MCP), par exemple, définit une manière uniforme pour les agents de découvrir et d’invoquer des outils et sources de données externes. Il vaut la peine d’être précis sur ce que MCP fait et ne fait pas : il standardise la conversation entre un agent et un système — découverte d’outils, description de capacités, format d’invocation. Il ne remplace ni vos API, ni votre modèle d’autorisation, ni vos validations métier. Celles-ci restent à concevoir de votre côté. MCP rend une surface d’API bien conçue consommable par des agents ; il ne peut pas sauver un système dont les capacités ne sont pas appelables à la base.
Pistes d’audit lisibles par machine
Quand un agent modifie un enregistrement, « quelqu’un a mis à jour ce champ » n’est plus une entrée de journal suffisante. Les pistes d’audit prêtes pour la SI capturent la chaîne de preuves complète pour chaque changement d’état, sous une forme que les machines — et les auditeurs — peuvent interroger :
- Acteur — quel agent, compte de service ou humain a agi, et sous l’autorité de qui
- Action — l’opération effectuée, avec ses entrées et le changement d’état résultant
- Justification — l’événement déclencheur, la politique ou le chemin de raisonnement qui l’a justifiée, et toute approbation humaine obtenue
- Données touchées — quels enregistrements ont été lus pour éclairer la décision, pas seulement ceux qui ont été écrits
- Réversibilité — comment l’action peut être annulée, et si elle l’a déjà été
Ce n’est pas une invention nouvelle — les systèmes financiers et de santé exigent des chaînes de preuves équivalentes depuis des décennies. Ce qui change, c’est l’acteur : la trace doit être structurée pour que des systèmes de supervision, pas seulement des auditeurs humains, puissent évaluer le comportement des agents en continu. Ces mécaniques d’audit se connectent directement au stack de responsabilité plus large — application des politiques, niveaux de supervision et réponse aux incidents — que nous couvrons dans gouvernance de la superintelligence.
Autonomie encadrée et supervision humaine
Le dernier principe trace la frontière entre ce que les agents peuvent faire seuls et ce qui requiert encore une personne. L’autonomie encadrée signifie que les permissions s’expriment en niveaux de conséquence, pas en « accès agent : oui/non » binaire :
- Niveau 0 — Lire et recommander. Les agents analysent, rédigent et proposent ; les humains exécutent. Approprié pour la plupart des déploiements actuels.
- Niveau 1 — Exécuter des actions réversibles à faible impact. Mettre à jour des champs non financiers, router des dossiers, planifier — avec annulation instantanée.
- Niveau 2 — Exécuter des actions financières bornées. Émettre des remboursements jusqu’à un seuil, ajuster des commandes dans des fourchettes définies — avec approbation au-dessus de la limite.
- Niveau 3 — Exécuter des actions à haute conséquence avec approbation obligatoire. Modifications de contrats, libérations de paiements, modifications de données de référence — un agent prépare, un humain signe.
Chaque niveau est appliqué architecturalement — dans la couche d’autorisation des API, pas dans les instructions de l’agent — de sorte qu’élargir le périmètre d’un agent est une décision de gouvernance délibérée, jamais un comportement émergent. Les seuils appartiennent à une configuration revue par le métier, pas enfouis dans un prompt.
Comment les agents IA opéreront dans les ERP et CRM prêts pour la SI
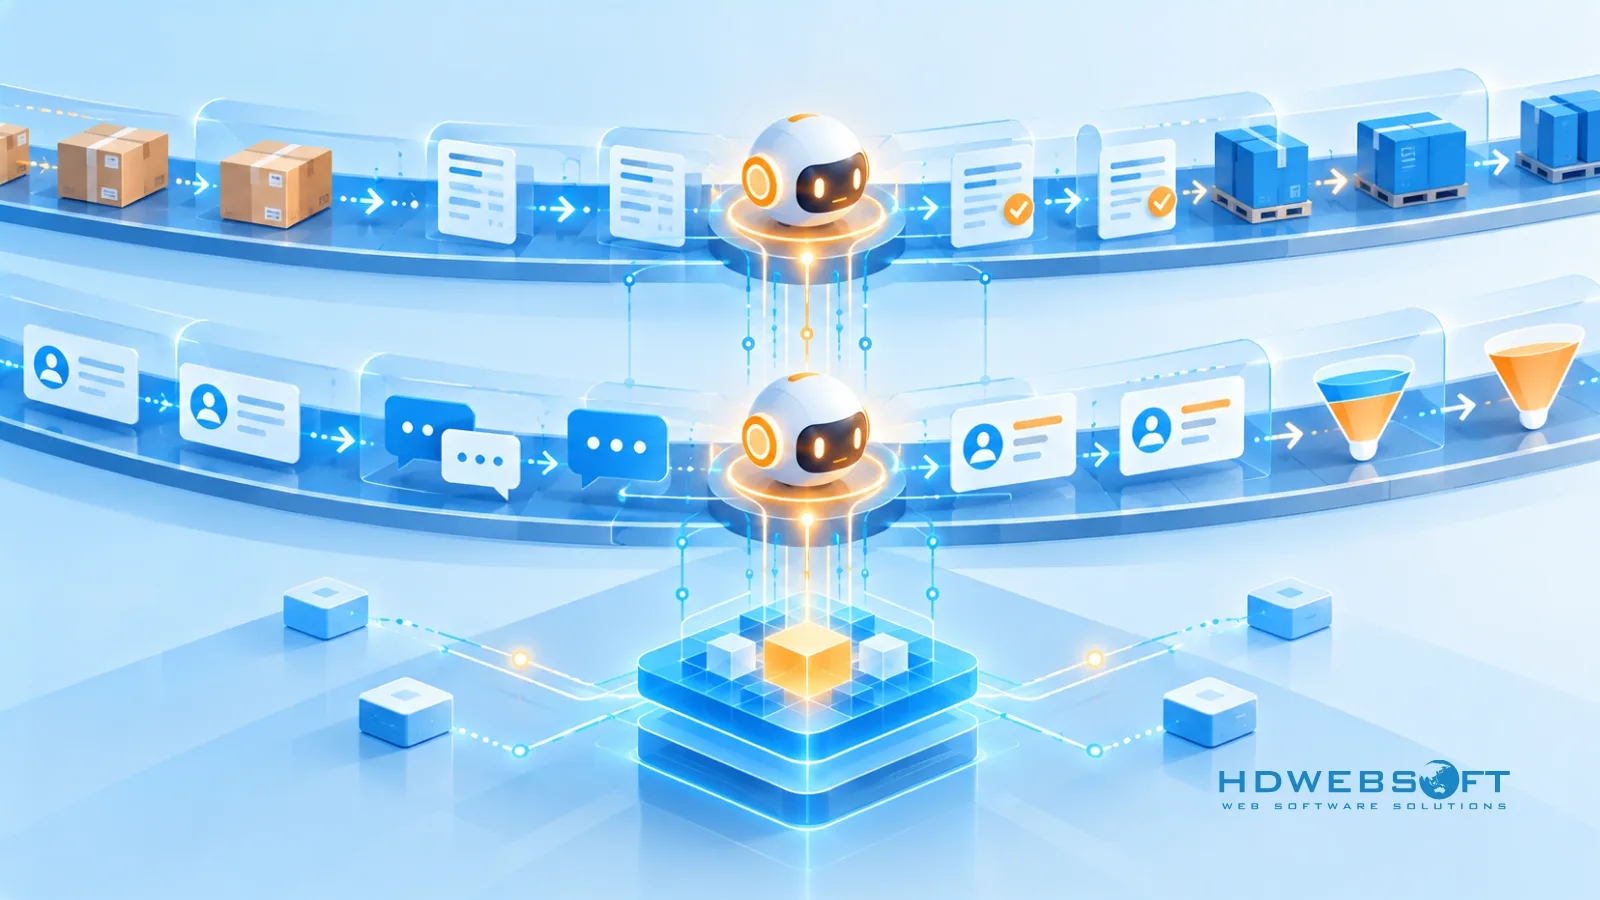
Les principes abstraits font plus d’effet dans des workflows concrets. Sur une fondation prête pour la SI bien conçue, le schéma opérationnel est constant : un agent lit un événement, raisonne sur des données propres, agit via l’API, laisse une trace lisible par machine et escalade dès que l’action dépasse son niveau. Ce qui change, c’est le domaine.
Côté ERP, les premières charges de travail à forte valeur sont celles qui se noient dans la réconciliation inter-systèmes :
- Surveillance order-to-cash — un agent observe les événements de commandes, détecte les écarts entre expédié, facturé et payé, et ouvre des dossiers de réconciliation avec les preuves déjà jointes.
- Rééquilibrage des stocks — les signaux de demande et les événements de stock déclenchent des ordres de transfert proposés ; sous le seuil de risque ils s’exécutent automatiquement, au-dessus ils attendent une approbation.
- Réconciliation fournisseurs — les agents rapprochent en continu factures, réceptions et conditions de commandes, signalant les exceptions que les humains traquent en fin de mois.
Côté CRM, le schéma passe de la réconciliation à la progression — faire avancer le travail face au client sans attendre qu’un humain le remarque :
- Qualification et routage des leads — les événements d’engagement et firmographiques déclenchent scoring, enrichissement et attribution en quelques secondes au lieu de jours.
- Triage des dossiers — les dossiers entrants sont classés, dédupliqués et routés avec le contexte préassemblé ; l’humain reçoit un dossier, pas une file d’attente.
- Génération de devis — les agents rédigent des devis à partir des règles de prix et du contexte de l’affaire pour validation du commercial, ramenant une tâche d’une demi-journée à une simple relecture.
C’est la direction que prennent déjà les grands éditeurs : des plateformes comme SAP Business AI intègrent désormais des agents pour la résolution de service, le rapprochement de factures et la surveillance de la chaîne d’approvisionnement dans leurs suites. Les agents des éditeurs opèrent cependant dans le modèle de données de l’éditeur et dans ses limites. Quand vos workflows, votre sémantique de données ou vos règles d’autonomie diffèrent des paramètres par défaut de la plateforme — ce qui est généralement le cas — l’écart devient un argument pour le développement de CRM sur mesure, où les champs, actions et niveaux d’approbation permis à l’agent sont conçus autour de vos processus plutôt qu’adaptés aux hypothèses d’un éditeur.
Moderniser, étendre ou reconstruire ? Choisir votre voie
Peu d’entreprises peuvent — ou devraient — remplacer purement et simplement leur ERP et leur CRM au nom de la préparation aux agents. La décision réaliste est un spectre, et le bon point sur ce spectre dépend de votre modèle de données, de votre parc d’intégration et de la part de votre logique de processus réellement différenciante.
| Voie | Ce que cela signifie | Pertinent quand | Attention à |
|---|---|---|---|
| Moderniser | Envelopper le système legacy d’API, d’émetteurs d’événements et d’une couche de journalisation | Le modèle de données est sain ; budget et appétit du risque faibles | Les enveloppes superficielles exposent des champs, pas des capacités — la logique reste piégée |
| Étendre | Garder le cœur ; construire des modules prêts pour la SI pour les domaines orientés agents à côté | Le cœur est stable mais certains domaines ont besoin d’agents maintenant | Deux styles architecturaux à maintenir ; les frontières exigent de la discipline |
| Reconstruire | Remplacer le cœur par un système sur mesure conçu opérable par des agents dès le premier jour | Votre modèle de données est un atout concurrentiel ; les limites de l’éditeur bloquent l’autonomie requise | Coût et risque de migration les plus élevés ; justifié seulement par une différenciation durable |
L’évaluation honnête compte plus que l’enthousiasme. Le développement sur mesure n’est pas automatiquement la meilleure réponse — il l’est dans des conditions précises : lorsque la sémantique de vos processus diverge de ce que les suites modélisent bien, lorsque vous avez besoin d’un contrôle direct sur le modèle de données sur lequel les agents raisonneront, ou lorsque les feuilles de route des éditeurs verrouillent des capacités que votre stratégie exige. Les critères de comparaison qui décident vraiment sont le coût total de possession sur 5 à 10 ans, la profondeur d’intégration que vos cas d’usage d’agents exigent, le risque de migration sur des opérations en cours, et le plafond que la plateforme de l’éditeur impose aux niveaux d’autonomie.
Pour les organisations sur la voie de la reconstruction, le développement d’ERP sur mesure offre un avantage décisif pour la préparation à la SI : le modèle de données, la surface d’API, la dorsale événementielle et le schéma d’audit sont conçus comme un tout cohérent — pas négociés après coup avec l’architecture d’un éditeur. Mais la même honnêteté s’applique en sens inverse : si une suite couvre déjà 90 % de vos besoins, l’étendre est la décision d’ingénierie la plus judicieuse.
Comment préparer vos systèmes d’entreprise à l’IA autonome : une feuille de route en 5 étapes
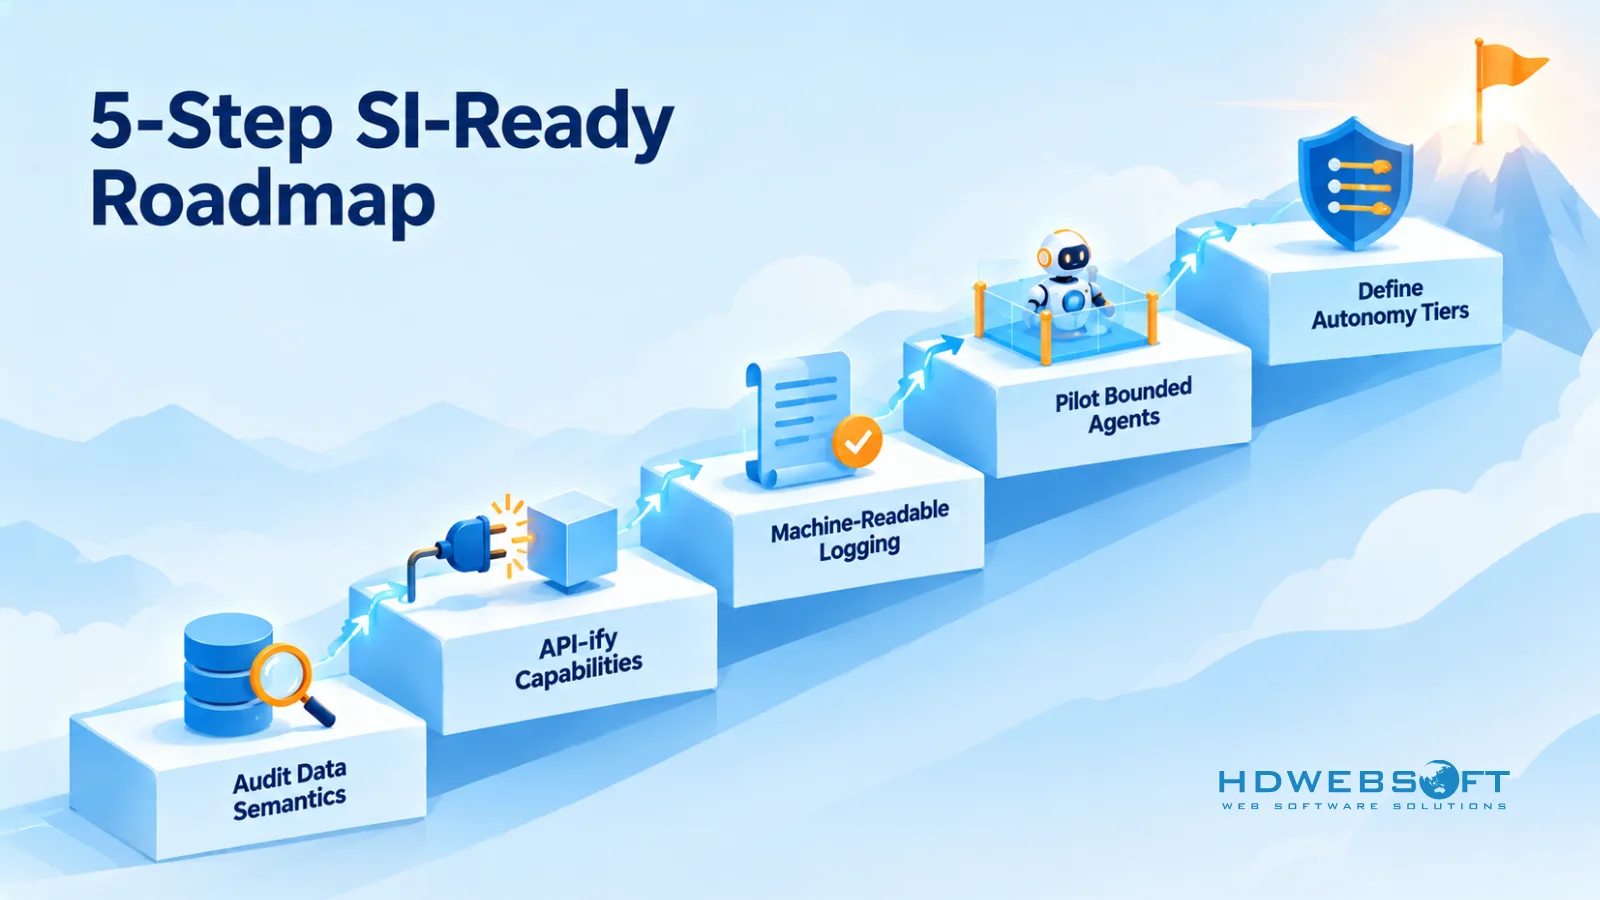
L’écart entre adoption de l’IA et préparation à l’IA est déjà mesurable. Le State of AI 2025 de McKinsey constate que la plupart des organisations utilisent désormais l’IA dans au moins une fonction métier, mais que la majorité reste bloquée au stade du pilote au lieu de passer à l’échelle — et que les blocages sont massivement des fondations de données, de workflows et de gouvernance plutôt que la capacité des modèles. Les cinq étapes ci-dessous attaquent exactement ces fondations, et chacune apporte de la valeur indépendamment du moment — ou de l’éventualité — où la superintelligence arrive.
- Auditez votre sémantique de données. Inventoriez vos entités centrales — client, commande, produit, dossier — et répondez pour chacune : existe-t-il une définition unique ? Les significations des champs sont-elles documentées ? Les modules parallèles sont-ils d’accord ? Le résultat est une liste d’écarts, et elle explique généralement pourquoi les pilotes IA précédents ont calé.
- API-fiez les capacités critiques. Choisissez les dix opérations dont un agent aurait besoin en premier — celles de vos cas d’usage initiaux — et exposez-les comme des points de terminaison gouvernés et documentés. Pas besoin de tout envelopper ; il faut que la surface de plus forte valeur soit appelable.
- Déployez une journalisation lisible par machine. Instrumentez la chaîne acteur-action-justification-données décrite plus haut sur les domaines que vous avez API-fiés en premier. Si vous ne pouvez pas reconstruire pourquoi une action s’est produite, elle n’était pas sûre à automatiser.
- Pilotez des cas d’usage d’agents bornés. Choisissez des workflows à fort volume, faible risque et totalement réversibles — triage de dossiers, signalement de réconciliations, génération de brouillons. Autonomie de niveau 0 et 1 uniquement ; mesurez par rapport aux référentiels humains avant d’étendre.
- Définissez les niveaux d’autonomie et la gouvernance. Formalisez les niveaux de permission, seuils d’approbation et chemins d’escalade avant que les agents ne les testent. Une gouvernance écrite sous la pression d’un incident est toujours moins bonne qu’une gouvernance écrite à l’avance.
La séquence compte moins que la logique d’ordonnancement : sémantique avant API, API avant agents, gouvernance avant autonomie. Les équipes qui l’inversent — déployant des agents sur des données non documentées sans chaîne d’audit — apprennent les mêmes leçons sous forme d’incidents de production plutôt que de revues de conception.
Conclusion : la préparation à la SI est une décision, pas une échéance
Personne ne peut vous dire quand — ou si — la superintelligence arrivera. Ce qui est connaissable est plus étroit et plus utile : les systèmes sur lesquels votre entreprise tourne ont été conçus pour des opérateurs humains, et chaque mois, davantage de travail en leur sein est délégué à des logiciels qui agissent par eux-mêmes. L’ERP et le CRM prêts pour la SI sont simplement la décision de concevoir pour cet opérateur dès maintenant — des données propres que les agents peuvent interpréter, des API qu’ils peuvent appeler, des pistes d’audit qu’ils doivent laisser, et des limites qu’ils ne peuvent pas franchir.
Chaque pas vers cette architecture rapporte immédiatement : meilleures intégrations, migrations plus propres, automatisation plus sûre, fonctions IA qui fonctionnent sur vos données plutôt que sur des données de démonstration. Les organisations qui absorberont les agents autonomes en douceur ne sont pas celles qui auront attendu la certitude — ce sont celles qui auront rendu leurs systèmes lisibles tant que c’était encore bon marché.
HDWEBSOFT conçoit et construit des systèmes d’entreprise et des intégrations sur mesure avec la préparation aux agents intégrée dès le départ — via nos services de développement IA, nous aidons les entreprises à évaluer leur paysage ERP et CRM actuel et à construire les fondations décrites ici. Si vous pesez modernisation contre reconstruction, cette conversation est exactement notre point de départ.
FAQ
Qu’est-ce qu’un système ERP prêt pour la SI ?
Un système ERP prêt pour la SI est une plateforme de planification des ressources d’entreprise conçue pour que des agents IA autonomes puissent y opérer en toute sécurité : données propres et documentées sémantiquement, chaque capacité appelable via des API, pistes d’audit lisibles par machine pour chaque modification, et autonomie encadrée avec des contrôles de supervision humaine. Il s’agit d’une approche architecturale tournée vers l’avenir, pas d’un standard certifié.
Les plateformes ERP et CRM existantes peuvent-elles devenir prêtes pour la SI ?
Partiellement. Les plateformes existantes peuvent progresser vers la préparation à la SI en nettoyant leurs modèles de données, en exposant leurs capacités via des API et des événements, et en ajoutant une journalisation lisible par machine — mais les plateformes construites autour de workflows pilotés par l’UI et de logique propriétaire ont des limites structurelles. La portée de la modernisation dépend du contrôle que vous avez sur le modèle de données et la couche d’intégration.
Quelle est la différence entre une architecture API-first et une architecture prête pour la SI ?
API-first signifie que chaque capacité du système est exposée via une interface bien définie. Prêt pour la SI s’appuie sur API-first avec trois exigences supplémentaires : des données modélisées sémantiquement que les agents peuvent interpréter, des pistes d’audit lisibles par machine pour chaque action, et des contrôles d’autonomie encadrée définissant ce que les agents peuvent faire sans approbation humaine.
Faut-il moderniser ou reconstruire notre ERP et CRM pour les agents IA ?
Cela dépend de vos contraintes. La modernisation est moins chère et moins risquée lorsque votre modèle de données est sain ; l’extension avec de nouveaux modules prêts pour la SI convient lorsque le cœur doit rester stable ; une reconstruction sur mesure se justifie lorsque votre modèle de données est un atout concurrentiel ou que les limites de l’éditeur bloquent l’autonomie dont vous avez besoin. Comparez le TCO, les exigences d’intégration, le risque de migration et les limites de la feuille de route de l’éditeur avant de décider.
De quelles exigences de piste d’audit les agents IA autonomes ont-ils besoin ?
Les pistes d’audit des agents doivent être lisibles par machine et capturer, pour chaque changement d’état : quel agent ou humain a agi, quelle action a été effectuée et pourquoi, quelles données ont été lues et modifiées, quelle politique l’a autorisée, et comment l’action peut être annulée. C’est la même chaîne de preuves que les auditeurs attendent déjà des systèmes financiers — étendue à des acteurs non humains.