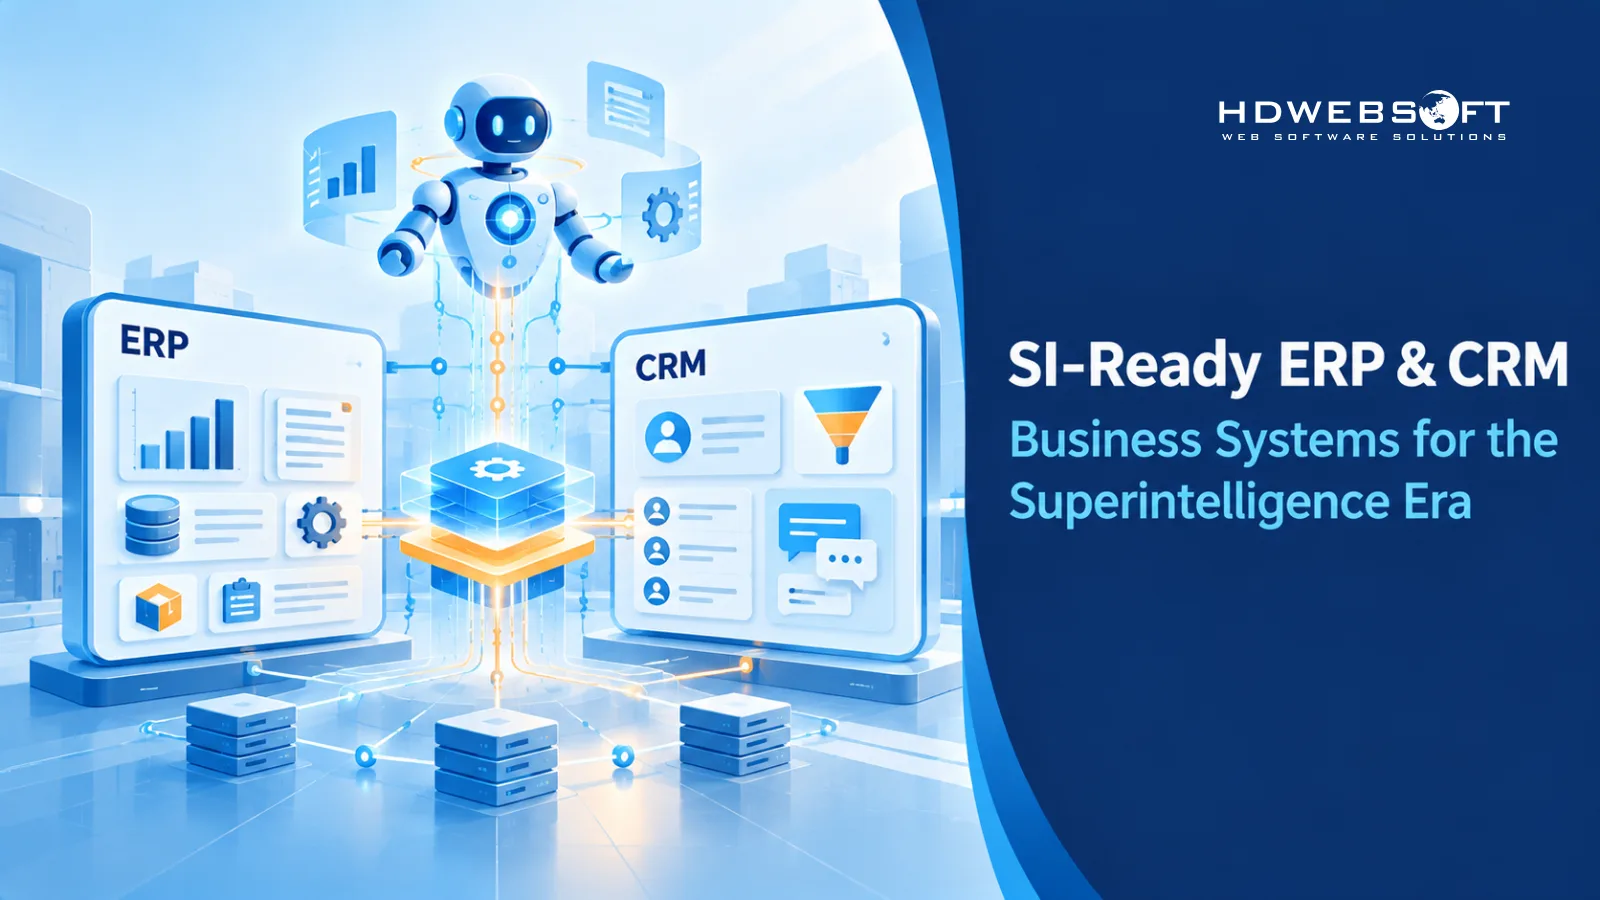
I copilot AI di oggi assistono le persone che lavorano dentro i sistemi ERP e CRM. La prossima generazione di AI non assisterà — opererà. Mentre le aziende iniziano a prepararsi alla superintelligenza artificiale e agli agenti sempre più autonomi che la precedono, i sistemi di registrazione che gestiscono finanza, vendite, approvvigionamento e relazioni con i clienti diventano il collo di bottiglia critico. Un agente AI in grado di ragionare perfettamente resta inutile se non può leggere i tuoi dati, richiamare i tuoi workflow o lasciare una traccia di cui un revisore possa fidarsi.
ERP e CRM pronti per la SI è la risposta architetturale a quel problema: sistemi aziendali progettati affinché gli agenti AI funzionino come utenti operativi di prima classe — leggendo dati semanticamente puliti, agendo tramite API governate e lasciando evidenze leggibili dalle macchine di tutto ciò che fanno. Non è una categoria di prodotto, una certificazione o una casella da spuntare dal vendor. È un insieme di decisioni di progettazione che prendi ora, mentre i requisiti sono ancora economici da soddisfare.
Questa guida spiega cosa significa davvero “pronto per la SI” per ERP e CRM, perché le architetture legacy bloccano gli agenti, i principi di progettazione che rendono i sistemi operabili dagli agenti e come scegliere tra modernizzare, estendere o ricostruire.
Punti chiave
- Pronto per la SI significa che un ERP o CRM tratta gli agenti AI come utenti operativi di prima classe — con dati leggibili dalle macchine, capacità richiamabili e azioni tracciabili — anziché imbullonare l’AI su interfacce pensate solo per gli umani.
- I sistemi legacy falliscono con gli agenti non perché manca l’AI, ma perché i dati non sono documentati, la logica di business è sepolta nelle UI e le azioni non lasciano tracce leggibili dalle macchine.
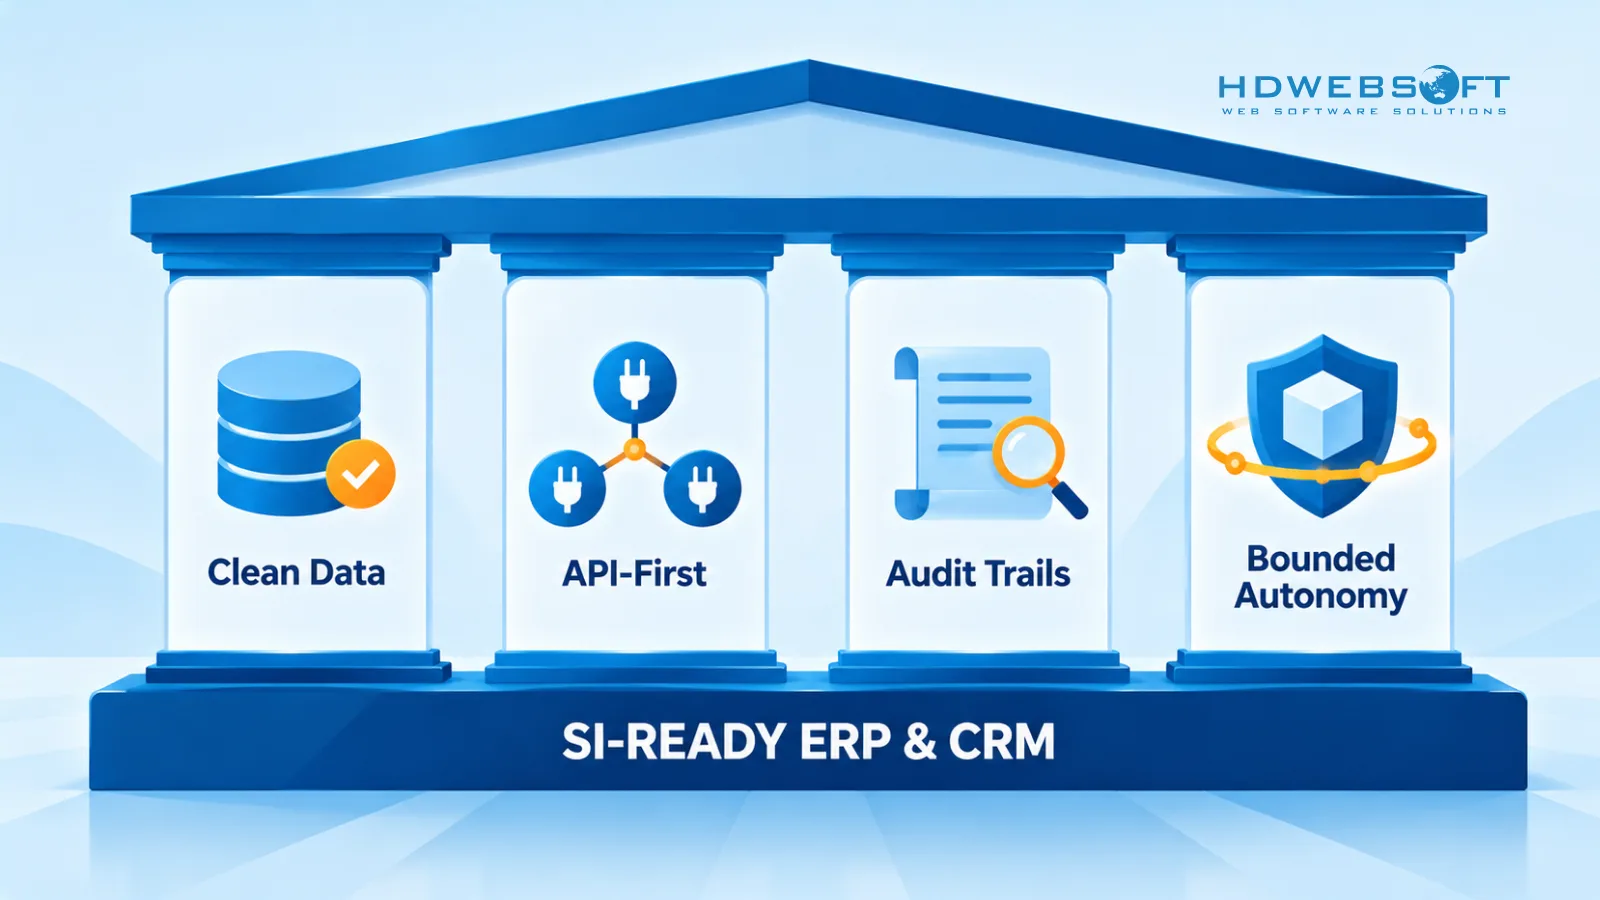
- I quattro pilastri di progettazione sono dati semantici puliti, integrazione API-first e guidata dagli eventi, audit trail leggibili dalle macchine e autonomia limitata con supervisione umana.
- Modernizzare o ricostruire è una decisione di TCO e controllo, non una preferenza tecnologica — lo sviluppo personalizzato è più forte quando il tuo modello dati è un asset competitivo, non una risposta universale.
- La prontezza è architetturale, non futuristica: ogni passo verso la prontezza per la SI migliora anche le integrazioni AI di oggi.
Cosa significa “pronto per la SI” per i sistemi ERP e CRM?
Un sistema pronto per la SI è un sistema aziendale di registrazione che tratta gli agenti AI come utenti operativi legittimi — non come plugin che leggono uno schermo pensato per qualcun altro. Concretamente, significa che il sistema soddisfa tre condizioni contemporaneamente: gli agenti possono capire cosa significano i dati, agire sul business tramite capacità richiamabili e rispondere di ogni modifica che apportano.
Aiuta separare due idee spesso confuse. Pronto per l’AI descrive ciò che la maggior parte dei vendor vende oggi: un sistema che supporta copilot, funzioni predittive o assistenti integrati — strumenti che consigliano gli umani, che restano i veri operatori. Pronto per la SI descrive una condizione ulteriore: il sistema resta operabile, verificabile e sicuro mentre gli agenti assumono lavoro autonomo in più fasi — e resta tale man mano che le capacità degli agenti crescono verso livelli che oggi non possiamo specificare appieno.
Una precisazione onesta: “pronto per la SI” è un approccio architetturale orientato al futuro, non uno standard tecnico consolidato né una certificazione. Nessun ente di settore lo definisce e nessun vendor può venderti un ERP certificato pronto per la SI — la superintelligenza artificiale stessa non esiste. Ciò che il termine cattura utilmente è una direzione di progettazione: costruire sistemi che non dovranno essere smontati quando gli agenti chiederanno di fare lavoro reale.
Cinque tratti definiscono quella direzione nella pratica:
- Dati modellati semanticamente — entità, campi e relazioni portano un significato leggibile dalle macchine, non solo formati di archiviazione.
- Capacità richiamabili — ogni operazione di business è esposta tramite API, non chiusa dentro schermate.
- Integrazione guidata dagli eventi — il sistema emette ciò che accade quando accade, invece di impacchettare la verità in sincronizzazioni notturne.
- Audit trail leggibili dalle macchine — ogni cambio di stato registra chi ha agito, perché e su quali dati.
- Autonomia limitata — livelli di autorizzazione e controlli di approvazione definiscono cosa un agente può fare senza un umano.
ERP e CRM si collocano al livello applicativo di uno stack più ampio. Se stai mappando come questi sistemi si inseriscono accanto a gateway di modelli, livelli di orchestrazione e piattaforme dati aziendali, il nostro progetto di architettura di superintelligenza aziendale copre il quadro generale; questo articolo resta concentrato sui due sistemi su cui la tua azienda effettivamente gira.
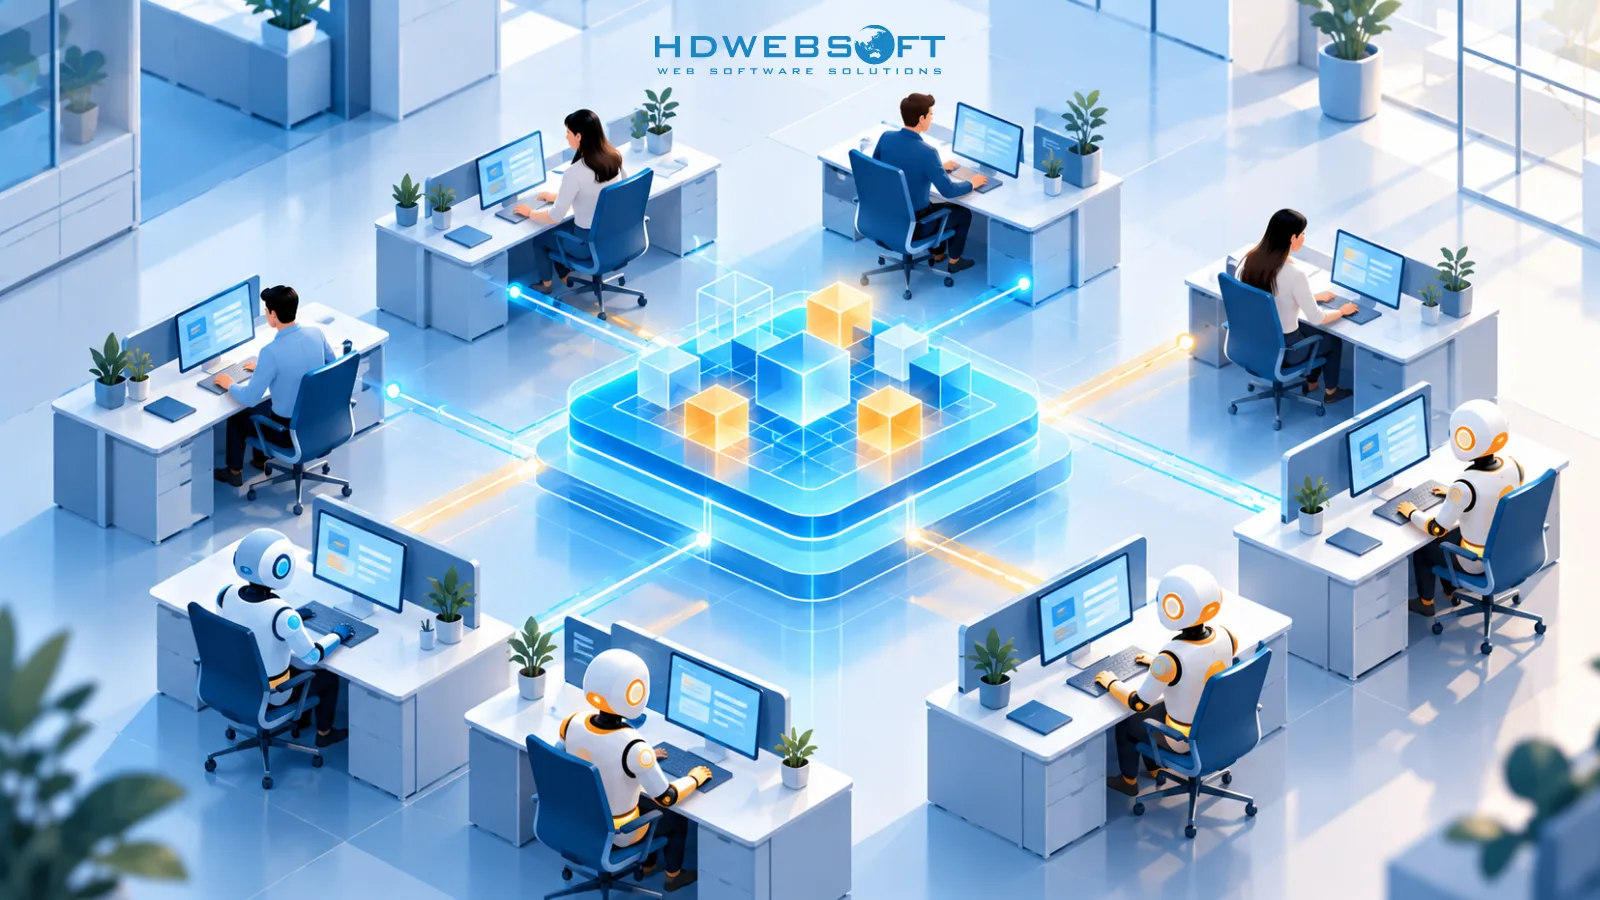
Perché le architetture ERP e CRM legacy bloccano l’AI avanzata
I sistemi ERP e CRM legacy sono stati progettati attorno a un’unica assunzione: un umano si trova tra i dati e ogni decisione. Le interfacce presentano record da leggere alle persone; i moduli raccolgono ciò che le persone digitano; i workflow codificano i passaggi che le persone seguono. Quell’assunzione ha funzionato bene per due decenni — ed è esattamente ciò che si rompe quando un agente prova a fare il lavoro al suo posto.
Quattro colli di bottiglia strutturali compaiono in quasi ogni ambiente legacy:
- Dati in silos e non documentati. Lo stesso cliente esiste come cinque record leggermente diversi tra i moduli. Campi come
CUST_STAT_CDportano conoscenza tribale che nessuna documentazione cattura. Gli umani compensano con l’esperienza; gli agenti non possono. - Logica di business sepolta nelle UI. La regola “gli ordini sopra i 50.000 dollari richiedono approvazione finanziaria” vive in uno script di un modulo o in una stored procedure — non in un servizio che un agente può richiamare. L’unico modo per eseguire la logica è simulare un utente che clicca tra le schermate.
- Integrazione punto-punto. Decenni di connettori su misura fanno sì che i dati arrivino in ritardo, diversi o non arrivino affatto. Un agente che ha bisogno contemporaneamente di inventario attuale, ordini aperti e stato cliente riceve tre istantanee incoerenti.
- Nessuna responsabilità leggibile dalle macchine. I log di audit, dove esistono, registrano che un record è cambiato — non chi ha autorizzato il cambiamento, quale ragionamento lo ha preceduto o quali dati lo hanno informato. Rispondono a “cosa è successo” per gli umani; non possono rispondere a “perché è successo” per nessuno.
| Schema legacy | Modalità di fallimento dell’agente |
|---|---|
| Campi non documentati con semantica tribale | L’agente interpreta male i dati e agisce su una premessa sbagliata — con sicurezza |
| Regole di business chiuse nella logica dei moduli | L’agente aggira i controlli o deve simulare una sessione umana per attivarle |
| Sincronizzazione batch notturna tra moduli | L’agente decide su istantanee obsolete e incoerenti |
| Log delle modifiche senza contesto di ragionamento | Gli audit falliscono: nessuno può ricostruire perché l’agente ha fatto ciò che ha fatto |
| Permessi UI come unico controllo di accesso | L’agente eredita ampi privilegi umani — o viene bloccato del tutto |
Lo schema sottostante a tutto questo: la conoscenza e le capacità del sistema sono accessibili solo attraverso interfacce a forma umana. Gli agenti non falliscono qui per mancanza di intelligenza. Falliscono perché niente di ciò di cui hanno bisogno è accessibile alle macchine.
Principi di progettazione fondamentali dell’architettura ERP e CRM pronta per la SI
Quattro principi di progettazione trasformano un sistema di registrazione in un sistema che gli agenti possono davvero operare. Nessuno richiede di aspettare un’AI più intelligente — ciascuno ripaga anche nelle integrazioni di oggi.
Dati puliti e modellati semanticamente
Gli agenti consumano significato, non byte. Un livello dati pronto per la SI dà a ogni entità centrale — cliente, ordine, fattura, contratto, caso — un’unica definizione canonica condivisa tra i moduli, con campi che portano semantica esplicita: cosa significa il valore, quali unità usa, quali stati sono validi e come si relaziona con le altre entità.
In pratica questo significa mantenere un glossario di business governato che vive con i dati, non in un wiki che nessuno legge: descrizioni a livello di campo, valori di stato enumerati con il loro significato di business, relazioni documentate e lineage che mostra da dove ha avuto origine ogni valore. Quando un agente incontra status = PENDING_CREDIT, i metadati del sistema stesso dovrebbero dirgli cosa significa credito in sospeso e quali azioni sono valide in quello stato — altrimenti l’agente indovina, e indovinare su scala aziendale diventa un incidente.
Questo è anche il principio meno appariscente e più consequenziale. Ogni livello successivo — API, audit trail, controlli di autonomia — presume che i dati sottostanti siano interpretabili. La pulizia dei dati è poco appariscente proprio perché è fondamentale.
Integrazione API-first e guidata dagli eventi
Se i dati sono ciò che gli agenti leggono, le API sono ciò che toccano. I sistemi pronti per la SI espongono ogni capacità di business significativa — creare ordine, rilasciare blocco, qualificare lead, approvare reso — come endpoint governato con input, output e permessi espliciti. Un test utile: qualsiasi operazione che un dipendente formato può eseguire dovrebbe essere eseguibile tramite la superficie API, senza simulare un’interfaccia utente.
Altrettanto importante è come si propagano i cambiamenti. La sincronizzazione batch dà agli agenti istantanee obsolete; una spina dorsale guidata dagli eventi — ordine creato, pagamento ricevuto, caso escalato, ciascuno pubblicato nel momento in cui accade — dà agli agenti la stessa consapevolezza in tempo reale che un umano ottiene guardando uno schermo. Gli agenti si iscrivono a flussi di eventi anziché interrogare tabelle, il che è sia più veloce sia drammaticamente più economico sull’infrastruttura.
Gli standard emergenti stanno riducendo qui il costo di integrazione. Il Model Context Protocol (MCP), per esempio, definisce un modo uniforme per gli agenti di scoprire e richiamare strumenti e fonti dati esterni. Vale la pena essere precisi su cosa MCP fa e non fa: standardizza la conversazione tra un agente e un sistema — scoperta degli strumenti, descrizione delle capacità, formato di invocazione. Non sostituisce le tue API, il tuo modello di autorizzazione o le tue validazioni di business. Quelle restano tue da progettare. MCP rende una superficie API ben progettata consumabile dagli agenti; non può salvare un sistema le cui capacità non sono richiamabili in primo luogo.
Audit trail leggibili dalle macchine
Quando un agente modifica un record, “qualcuno ha aggiornato questo campo” non è più una voce di log sufficiente. Gli audit trail pronti per la SI catturano la catena di evidenze completa per ogni cambio di stato, in una forma che le macchine — e i revisori — possono interrogare:
- Attore — quale agente, account di servizio o umano ha agito, e sotto la cui autorità
- Azione — l’operazione eseguita, con i suoi input e il cambio di stato risultante
- Motivazione — l’evento scatenante, la policy o il percorso di ragionamento che l’ha giustificata, e qualsiasi approvazione umana ottenuta
- Dati toccati — quali record sono stati letti per informare la decisione, non solo quali sono stati scritti
- Reversibilità — come l’azione può essere annullata, e se lo è già stata
Non è un’invenzione nuova — i sistemi finanziari e sanitari richiedono catene di evidenze equivalenti da decenni. Ciò che cambia è l’attore: la traccia deve essere strutturata affinché sistemi di supervisione, non solo revisori umani, possano valutare il comportamento degli agenti in modo continuo. Queste meccaniche di audit si collegano direttamente allo stack di responsabilità più ampio — applicazione delle policy, livelli di supervisione e risposta agli incidenti — che trattiamo in governance della superintelligenza.
Autonomia limitata e supervisione umana
L’ultimo principio traccia la linea tra ciò che gli agenti possono fare da soli e ciò che richiede ancora una persona. L’autonomia limitata significa che i permessi sono espressi come livelli di conseguenza, non come un “accesso agente: sì/no” binario:
- Livello 0 — Leggere e raccomandare. Gli agenti analizzano, redigono e propongono; gli umani eseguono. Appropriato per la maggior parte delle implementazioni odierne.
- Livello 1 — Eseguire azioni reversibili a basso impatto. Aggiornare campi non finanziari, instradare casi, pianificare — con rollback istantaneo.
- Livello 2 — Eseguire azioni finanziarie delimitate. Emettere rimborsi fino a una soglia, adeguare ordini entro intervalli definiti — con approvazione sopra il limite.
- Livello 3 — Eseguire azioni ad alta conseguenza con approvazione obbligatoria. Modifiche di contratti, rilasci di pagamenti, modifiche di dati master — un agente prepara, un umano firma.
Ogni livello è applicato architetturalmente — nel livello di autorizzazione delle API, non nelle istruzioni dell’agente — così che ampliare il perimetro di un agente è una decisione di governance deliberata, mai un comportamento emergente. Le soglie appartengono a una configurazione revisionata dal business, non seppellite in un prompt.
Come opereranno gli agenti AI dentro ERP e CRM pronti per la SI
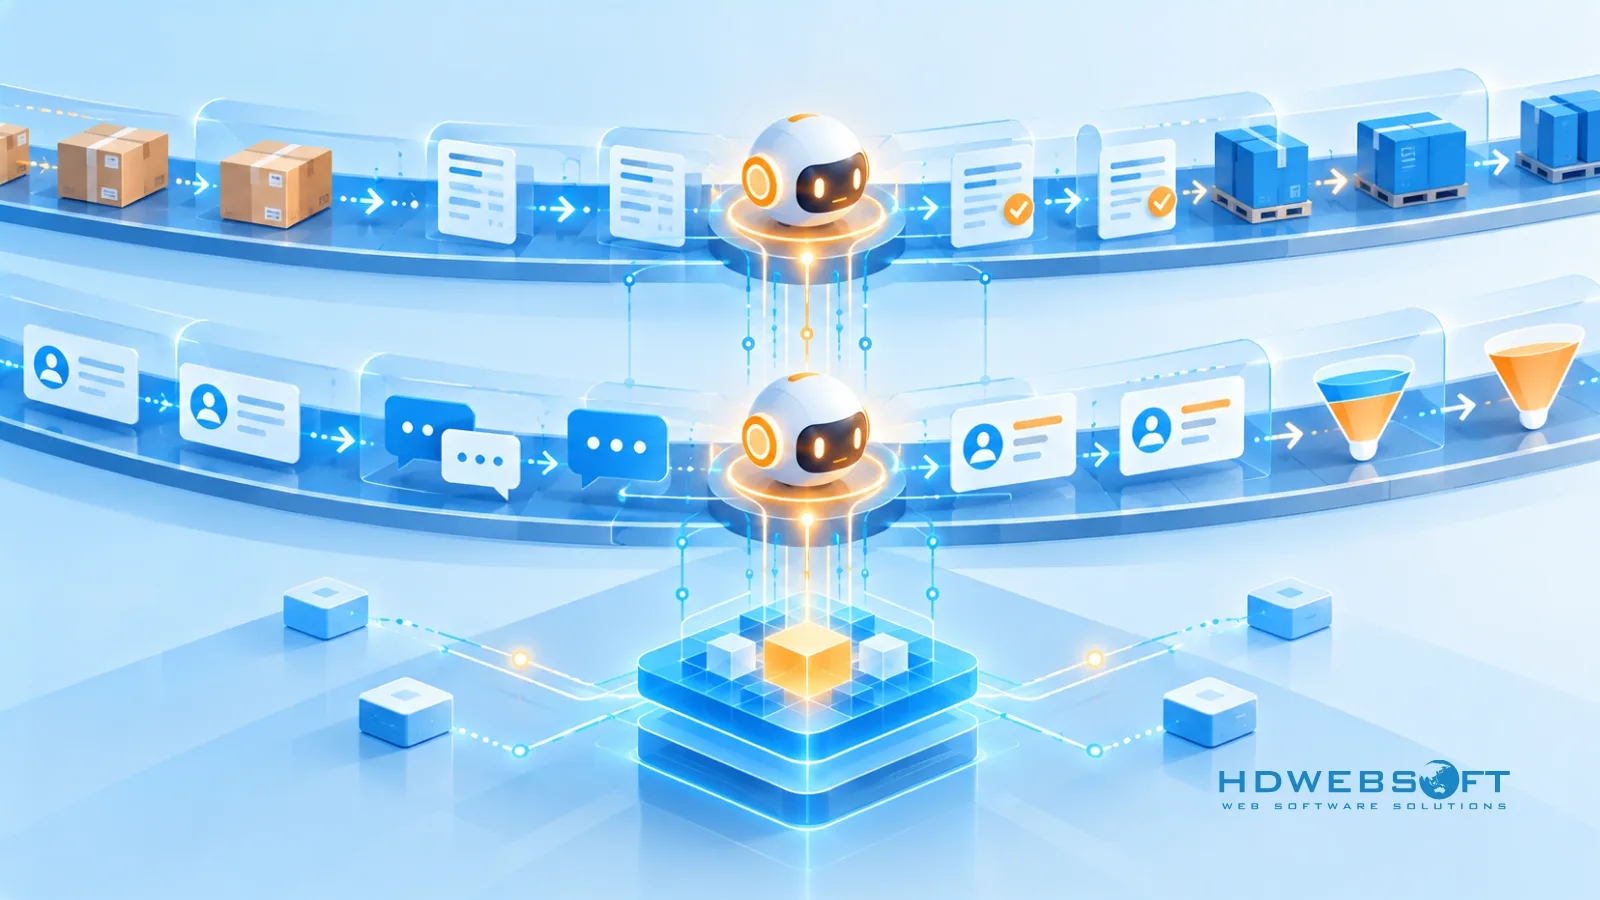
I principi astratti colpiscono di più nei workflow concreti. Su una base pronta per la SI ben progettata, lo schema operativo è coerente: un agente legge un evento, ragiona su dati puliti, agisce tramite l’API, lascia una traccia leggibile dalle macchine ed esegue un’escalation ogni volta che l’azione supera il suo livello. Ciò che cambia è il dominio.
Sul lato ERP, i primi carichi di lavoro di maggior valore sono quelli che annegano nella riconciliazione tra sistemi:
- Monitoraggio order-to-cash — un agente osserva gli eventi degli ordini, rileva disallineamenti tra spedito, fatturato e pagato, e apre casi di riconciliazione con le evidenze già allegate.
- Ribilanciamento dell’inventario — segnali di domanda ed eventi di scorta attivano ordini di trasferimento proposti; sotto la soglia di rischio si eseguono automaticamente, sopra si mettono in coda per approvazione.
- Riconciliazione fornitori — gli agenti abbinano continuamente fatture, ricevute e condizioni degli ordini d’acquisto, segnalando le eccezioni che gli umani cercano a fine mese.
Sul lato CRM, lo schema passa dalla riconciliazione alla progressione — portare avanti il lavoro rivolto al cliente senza aspettare che un umano lo noti:
- Qualificazione e instradamento dei lead — eventi di engagement e firmografici attivano scoring, arricchimento e assegnazione in secondi anziché giorni.
- Triage dei casi — i casi in arrivo vengono classificati, deduplicati e instradati con il contesto già assemblato; l’umano riceve un caso, non una coda.
- Generazione di preventivi — gli agenti redigono preventivi da regole di prezzo e contesto dell’affare per l’approvazione del commerciale, comprimendo un’attività di mezza giornata in una revisione.
Questa è la direzione che i grandi vendor stanno già prendendo: piattaforme come SAP Business AI integrano oggi agenti per la risoluzione dei servizi, l’abbinamento delle fatture e il monitoraggio della supply chain dentro le loro suite. Gli agenti dei vendor operano però dentro il modello dati del vendor e nei suoi confini. Quando i tuoi workflow, la semantica dei dati o le regole di autonomia differiscono dai default della piattaforma — come di solito accade — il divario diventa un argomento per lo sviluppo CRM personalizzato, dove campi, azioni e livelli di approvazione consentiti all’agente sono progettati attorno ai tuoi processi anziché adattati alle assunzioni di un vendor.
Modernizzare, estendere o ricostruire? Scegliere il proprio percorso
Poche aziende possono — o dovrebbero — sostituire il proprio ERP e CRM in blocco in nome della prontezza per gli agenti. La decisione realistica è uno spettro, e il punto giusto su di esso dipende dal tuo modello dati, dal patrimonio di integrazione e da quanta della tua logica di processo è davvero differenziante.
| Percorso | Cosa significa | Ideale quando | Attenzione a |
|---|---|---|---|
| Ammodernare | Avvolgere il sistema legacy con API, emettitori di eventi e un livello di logging | Il modello dati è solido; budget e propensione al rischio bassi | Gli involucri superficiali espongono campi, non capacità — la logica resta intrappolata |
| Estendere | Mantenere il core; costruire moduli pronti per la SI per i domini orientati agli agenti accanto ad esso | Il core è stabile ma domini specifici hanno bisogno degli agenti ora | Due stili architetturali da mantenere; i confini richiedono disciplina |
| Ricostruire | Sostituire il core con un sistema personalizzato progettato operabile dagli agenti dal primo giorno | Il tuo modello dati è un asset competitivo; i limiti del vendor bloccano l’autonomia necessaria | Costo e rischio di migrazione più alti; giustificato solo da una differenziazione duratura |
La valutazione onesta conta più dell’entusiasmo. Lo sviluppo personalizzato non è automaticamente la risposta migliore — lo è in condizioni specifiche: quando la semantica dei tuoi processi diverge da ciò che le suite modellano bene, quando hai bisogno di controllo diretto sul modello dati su cui gli agenti ragioneranno, o quando le roadmap dei vendor bloccano capacità che la tua strategia richiede. I criteri di confronto che davvero decidono sono il costo totale di proprietà su 5–10 anni, la profondità di integrazione che i tuoi casi d’uso degli agenti richiedono, il rischio di migrazione sulle operazioni in corso e il tetto che la piattaforma del vendor pone sui livelli di autonomia.
Per le organizzazioni sul percorso della ricostruzione, lo sviluppo ERP personalizzato offre un vantaggio decisivo per la prontezza alla SI: modello dati, superficie API, dorsale di eventi e schema di audit sono progettati come un tutt’uno coerente — non negoziati con l’architettura di un vendor a posteriori. Ma la stessa onestà vale al contrario: se una suite copre già il 90% di ciò di cui hai bisogno, estenderla è la decisione ingegneristica più intelligente.
Come preparare i tuoi sistemi aziendali all’AI autonoma: una roadmap in 5 passi
Il divario tra adozione dell’AI e prontezza per l’AI è già misurabile. Lo State of AI 2025 di McKinsey rileva che la maggior parte delle organizzazioni ora usa l’AI in almeno una funzione aziendale, ma la maggioranza resta bloccata nella fase pilota anziché scalare — e i blocchi sono in schiacciante maggioranza fondamenta di dati, workflow e governance, non capacità dei modelli. I cinque passi seguenti attaccano esattamente quelle fondamenta, e ciascuno offre valore indipendentemente da quando — o se — la superintelligenza arriverà.
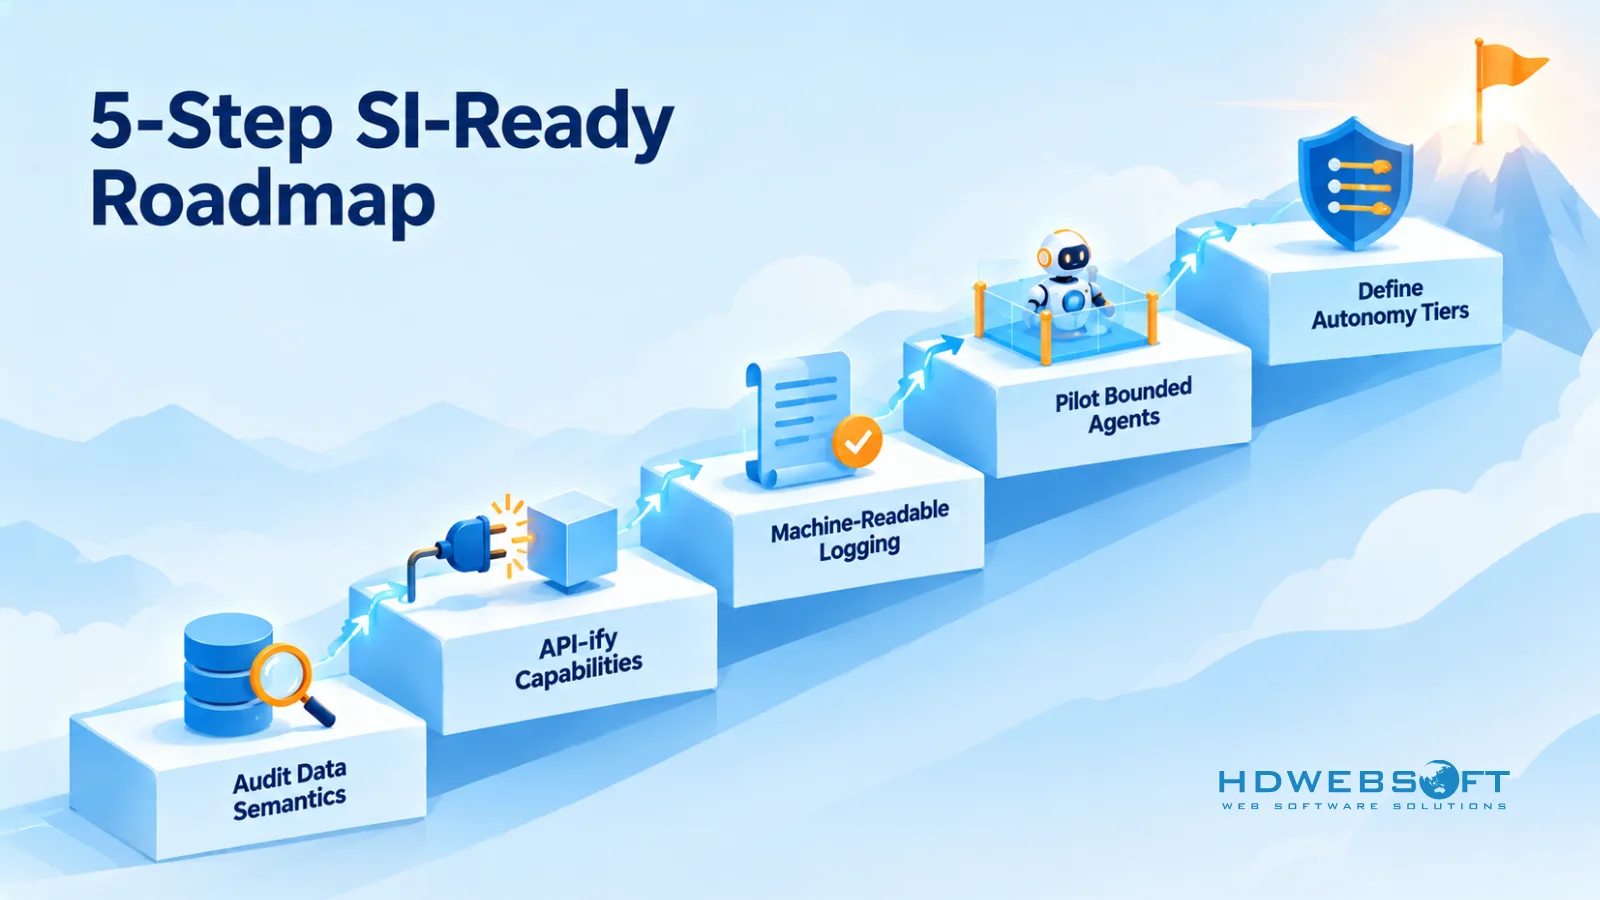
- Verifica la semantica dei tuoi dati. Inventaria le entità centrali — cliente, ordine, prodotto, caso — e rispondi per ciascuna: esiste una definizione unica? I significati dei campi sono documentati? I moduli paralleli concordano? Il risultato è una lista di gap, e di solito spiega perché i precedenti pilot AI si sono arenati.
- API-fica le capacità critiche. Scegli le dieci operazioni di cui un agente avrebbe bisogno per prime — quelle dei tuoi primi casi d’uso — ed esponile come endpoint governati e documentati. Non devi avvolgere tutto; ti serve richiamabile la superficie di maggior valore.
- Implementa logging leggibile dalle macchine. Strumenta la catena attore-azione-motivazione-dati descritta sopra sui domini che hai API-ficato per primi. Se non puoi ricostruire perché un’azione è avvenuta, non era sicuro automatizzarla.
- Avvia pilot di casi d’uso di agenti delimitati. Scegli workflow ad alto volume, basso rischio e completamente reversibili — triage dei casi, segnalazione di riconciliazioni, generazione di bozze. Solo autonomia di livello 0 e 1; misura rispetto alle baseline umane prima di espandere.
- Definisci livelli di autonomia e governance. Formalizza i livelli di autorizzazione, le soglie di approvazione e i percorsi di escalation prima che gli agenti vi si scontrino. La governance scritta sotto la pressione di un incidente è sempre peggiore di quella scritta in anticipo.
La sequenza conta meno della logica di ordinamento: semantica prima delle API, API prima degli agenti, governance prima dell’autonomia. I team che la invertono — distribuendo agenti su dati non documentati senza catena di audit — imparano le stesse lezioni come incidenti di produzione anziché come revisioni di progettazione.
Conclusione: la prontezza per la SI è una decisione, non una scadenza
Nessuno può dirti quando — o se — la superintelligenza arriverà. Ciò che è conoscibile è più ristretto e più utile: i sistemi su cui gira la tua azienda sono stati progettati per operatori umani, e ogni mese, più lavoro al loro interno viene delegato a software che agisce da solo. ERP e CRM pronti per la SI è semplicemente la decisione di progettare per quell’operatore ora — dati puliti che gli agenti possono interpretare, API che possono chiamare, audit trail che devono lasciare e confini che non possono oltrepassare.
Ogni passo verso quell’architettura ripaga immediatamente: integrazioni migliori, migrazioni più pulite, automazione più sicura, funzioni AI che lavorano sui tuoi dati anziché su dati demo. Le organizzazioni che assorbiranno gli agenti autonomi senza intoppi non sono quelle che hanno atteso la certezza — sono quelle che hanno reso i propri sistemi leggibili finché era ancora economico farlo.
HDWEBSOFT progetta e costruisce sistemi aziendali e integrazioni personalizzate con la prontezza per gli agenti incorporata fin dall’inizio — attraverso i nostri servizi di sviluppo AI, aiutiamo le aziende a valutare il proprio panorama ERP e CRM attuale e a costruire le fondamenta qui descritte. Se stai valutando modernizzare o ricostruire, quella conversazione è esattamente il nostro punto di partenza.
FAQ
Che cos’è un sistema ERP pronto per la SI?
Un sistema ERP pronto per la SI è una piattaforma di enterprise resource planning progettata affinché agenti AI autonomi possano operare al suo interno in sicurezza: dati puliti e documentati semanticamente, ogni capacità richiamabile tramite API, audit trail leggibili dalle macchine per ogni modifica e autonomia limitata con controlli di supervisione umana. È un approccio architetturale orientato al futuro, non uno standard certificato.
Le piattaforme ERP e CRM esistenti possono diventare pronte per la SI?
Parzialmente. Le piattaforme esistenti possono avvicinarsi alla prontezza per la SI ripulendo i modelli dati, esponendo capacità tramite API ed eventi e aggiungendo logging leggibile dalle macchine — ma le piattaforme costruite attorno a workflow guidati dall’UI e logica proprietaria hanno limiti strutturali. Fino a che punto arriva l’ammodernamento dipende da quanto controllo hai sul modello dati e sul livello di integrazione.
Qual è la differenza tra architettura API-first e pronta per la SI?
API-first significa che ogni capacità del sistema è esposta tramite un’interfaccia ben definita. Pronto per la SI si basa su API-first con tre requisiti aggiuntivi: dati modellati semanticamente che gli agenti possono interpretare, audit trail leggibili dalle macchine per ogni azione e controlli di autonomia limitata che definiscono cosa gli agenti possono fare senza approvazione umana.
Dobbiamo modernizzare o ricostruire il nostro ERP e CRM per gli agenti AI?
Dipende dai vincoli. L’ammodernamento è più economico e meno rischioso quando il modello dati è solido; l’estensione con nuovi moduli pronti per la SI funziona quando il core deve restare stabile; una ricostruzione personalizzata ha senso quando il modello dati è un asset competitivo o i limiti del vendor bloccano l’autonomia necessaria. Confronta TCO, requisiti di integrazione, rischio di migrazione e limiti della roadmap del vendor prima di decidere.
Di quali requisiti di audit trail hanno bisogno gli agenti AI autonomi?
Gli audit trail degli agenti devono essere leggibili dalle macchine e catturare, per ogni cambio di stato: quale agente o umano ha agito, quale azione è stata eseguita e perché, quali dati sono stati letti e modificati, quale policy l’ha autorizzata e come l’azione può essere annullata. È la stessa catena di evidenze che i revisori si aspettano già dai sistemi finanziari — estesa ad attori non umani.