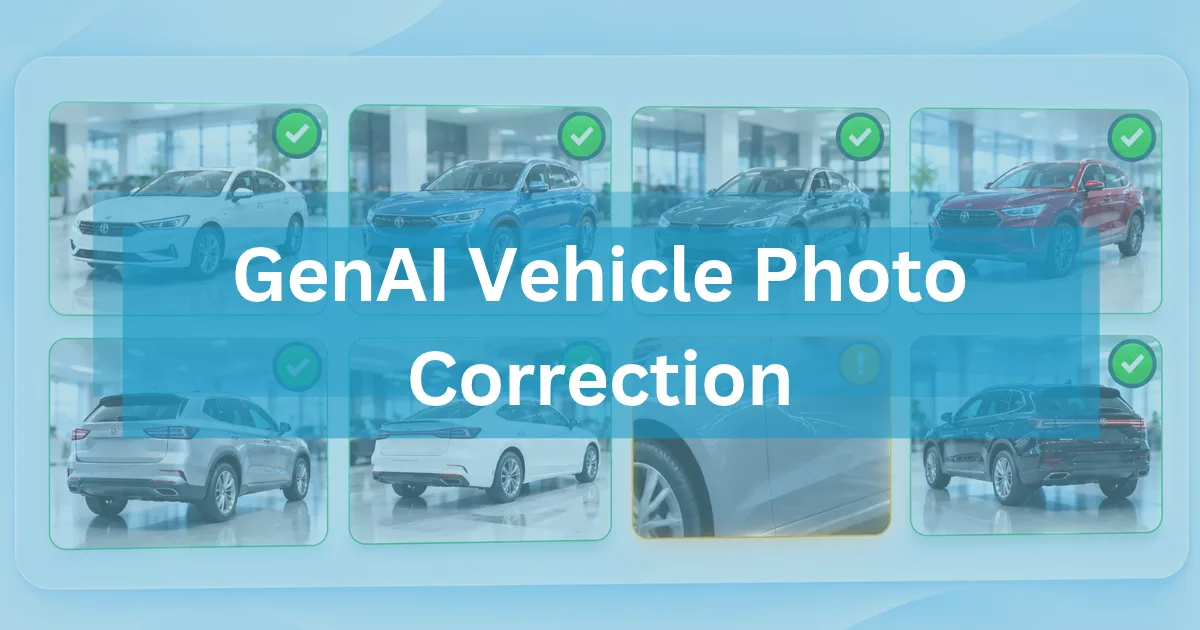
数百の自動車ディーラーを支える米国の車両撮影プラットフォームは、毎日70,000〜80,000枚の出品用写真を処理しています。この規模では、画質が購入者の関心と販売スピードを直結させます。HDWEBSOFTはGenAIベースの画像補正プラットフォームを開発し、旧来モデルを最新のディープラーニングに置き換え、客観的な品質スコアリングで高信頼度の写真を自動承認。手作業補正率を約34%から10%未満へ——70%削減——しながら、1日の全量を4時間のウィンドウ内、1枚あたり3秒未満で処理しています。
プロジェクトの背景
毎朝、オンライン出品用に数万枚の車両写真が短い時間枠に集中して到着します。既存のAIツールがあっても、照明不良・角度の歪み・色ズレにより約3枚に1枚は手作業での補正が必要で、1日23,000枚以上が編集者の手に回っていました。
クライアントは、旧モデルを最新ディープラーニングに刷新し、高信頼度の写真が人手レビューを完全にスキップできる品質スコアリングを導入し、手作業量を圧縮する新プラットフォームを発注しました——下流の出品ワークフローはディーラーの現行運用のまま維持する条件です。HDWEBSOFTの5名チームが、モデル開発・MLOps・クラウドインフラ・レビュー用Webアプリを担当しました。
ステークホルダー・インタビュー
「最も厳しい制約はバーストウィンドウそのものでした。4時間に80,000枚、1枚3秒未満。GPUのコールドスタートは2分超ですから、負荷に反応してからスケールする設計では常にキューを追いかけるだけになります。この現実を前提にパイプラインを設計する必要がありました」
— Dat Huynh、HDWEBSOFT プロジェクトマネージャー
チームは負荷を待ってスケールするのではなく、順序を逆転させました。日次バーストの15分前にGPU容量を3.6倍の余力でプレウォームし、キューが到着ピークを吸収している間に暖機済みインスタンスが処理を捌きます。ウィンドウ外はスケール・トゥ・ゼロで待機コストをほぼゼロに抑制。ローンチ前には4時間フルの負荷シミュレーションを実施し、見積もりではなく実量で設計を実証しました。
この設計により、プラットフォームは初日からバースト全体で3秒未満のSLAを維持し、ディーラーの出品スケジュールに影響するバックログを残しませんでした。以降の大規模AIワークロードにおけるキャパシティレビューの雛形にもなっています。
主要機能
- AI幾何補正 — 歪んだ角度や傾いた水平線を補正し、車両が中心になるようフレーミング。
- AIカラー補正 — 照明・ホワイトバランス・露出・コントラストを調整。画一的な補正ではなく各ディーラーのブランドトーンを学習。
- 品質スコアリング&自動承認 — 1枚ごとに0〜100で採点。高信頼度の結果は人手を介さず出品へ直行。
- 人手レビュー・ワークフロー — 信頼度バッジ付きグリッド表示で、レビュアーはワンクリックで一括承認。
- シームレス統合 — 既存の出品パイプラインにwebhookで接続。リトライと重複排除を備え、下流のワークフローは不変。
技術的課題
学習データの品質がクライアント提供のペア画像に完全依存
補正モデルの品質は、クライアントが提供した数千の補正前後ペア画像の品質を超えられません。複数の編集者が長期にわたり作業したデータであり、真のリスクは編集の不一致です——同じ照明問題を2人の編集者が異なる方法で直せば、モデルは意図ではなくノイズを学習します。内装写真はさらに困難で、狭いキャビン内では複雑な照明・混在する色温度・ダッシュボードや窓への強い反射が起き、汎用的な補正は機能しません。カバレッジの偏りも同程度に重要で、容易な屋外・日中写真に偏ったデータセットでは、編集者が最も苦労する領域でモデルが無力になります。
4時間ウィンドウに80,000枚
制約は処理量そのものより到着パターンでした。写真は一様に届かず、集中的な朝のバーストとして着信し、各画像は3秒未満で補正を完了する必要があります。GPUインスタンスのコールドスタートは最大150秒かかるため、リアクティブなオートスケーリングは常にキューを追い越せません——新しい容量が暖機する頃にはバックログが形成され雪だるま式に増えます。GPUを24時間暖機し続ける代替案は、クライアントのコストモデルを破壊します。さらにプロジェクト中盤でスコープがほぼ倍増し、これらすべてを解く時間も圧縮されました。
確率的なAI出力とディーラーごとのブランド期待
補正モデルは確率的です——同じ写真でも実行ごとにわずかに異なる結果を出力します。これにより出力レビューは毎回「どちらが正しく見えるか」という主観的な議論になり、人の承認なしにリリースすることへの信頼を損なっていました。ブランド要件がさらに複雑さを加えました。各ディーラーは、自社の編集者が長年かけて築いた独自のルックへの一致を求め、汎用的なハウススタイルを望みません。大手ディーラーには学習可能な補正前後の例が数千ありますが、小規模ディーラーにはなく、薄いデータで学習したプロファイルは信頼できません。
ソリューション
監査・カバレッジ重み付けされた学習データ
モデリング前にチームはデータセット全体を監査しました——すべての補正前後ペアの整合性を検証し、不一致の編集にフラグを立て、照明条件と撮影タイプのカバレッジを確認。データセットは個々の編集者の癖を暗記するのではなく、汎化可能な補正パターンを学習するよう分割しました。内装については学習データをそれらの困難なショットへ大きく重み付けし、低信頼度の補正はリリースせず自動的に人手レビューへ回す設計にしました。
実証済みの余力を持つプレウォーム容量
サーバーは日次バーストの15分前にベースライン容量の3.6倍で自動起動し、キューが形成される前にコールドスタート問題を吸収します。4時間フルの負荷シミュレーションで、実量ベースの設計をローンチ前に実証。中盤で増加したスコープを締切を動かさず吸収するため、チームは開発工程全体にAI支援開発ツールを導入し、30%の生産性向上を測定しました。
客観的スコアリングとディーラー別カラープロファイル
主観的なレビューを、写真ごとの客観的0〜100品質スコアに置き換え、厳格な出荷ルールを設定しました:スコアリング済み出力への人的合意が90%未満なら出荷しない。ブランドについては、各ディーラー自身の補正前後の例からディーラー別カラープロファイルを学習——画一的な補正ではなくその店のルックを学びます。履歴が不足するディーラーは地域プロファイルにフォールバックし、プロファイルは下流で人間の編集者が加える修正から継続的に精緻化されます。
ビジネス成果
- 手作業補正を70%削減 — 約3枚に1枚から10%未満へ、1枚あたりの処理は分から秒へ。
- インフラコスト月額約3,470ドル — フル生産量で、バースト外はスケール・トゥ・ゼロ。
- ディーラー間で均一な品質 — レビュアーごとの主観ではなく単一の採点基準。
- 自動ロールバック付きカナリアデプロイ — 本番規模でのモデル更新を安全に。
- 戦略的価値 — ディーラーの出品スピード向上、クライアント向けセグメント別レポート、引き渡し後の完全な運用自立。
技術スナップショット
- モデル: 幾何検出にYOLOv8-m、カラー補正にSVDLUT(PyTorch)、客観的品質スコアにMUSIQ NR-IQAとLPIPS——CUDA加速。
- サービング: バースト前にプレウォームされるオートスケーリングGPUプール背後のSageMaker非同期推論。
- パイプライン: AWS Lambda(Python 3.12)とECS/Fargate(Node.js)をSQS/SNSでオーケストレーション。DynamoDBで状態管理、RDS PostgreSQL 16でメタデータ、S3でアセット保管、API Gateway経由。
- セキュリティ: mTLS、HMAC-SHA256リクエスト署名、WAFv2、PrivateLink、KMS。
- デリバリー: TerraformによるIaC、GitHub Actions CI、Docker/ECRイメージ、CloudWatch+X-Rayによる可観測性、PagerDutyオンコール、レビューUIはReact+Cognito+CloudFront。
結論
このプラットフォームは、クライアントの編集業務を写真単位の手作業ボトルネックから、スコアリング駆動の自己補正パイプラインへ転換しました——レビュアーが触れるのはAIが最も自信を持てない写真だけです。厳しいレイテンシやボリューム制約下でコンピュータビジョンや生成AIワークロードをスケールさせるなら、当社のAI開発サービスがまさにこのデリバリーモデルを提供します。同様の構築をご検討ならチームまでご相談ください。
関連する取り組みを見る
関連するケーススタディ、サービス、業界、地域での開発実績をご覧ください。