Una plataforma estadounidense de fotografía de vehículos que da servicio a cientos de concesionarios procesa entre 70.000 y 80.000 fotos para anuncios cada día — un volumen en el que la calidad de imagen impulsa directamente el interés del comprador y la velocidad de venta. HDWEBSOFT entregó una plataforma de corrección de imágenes basada en GenAI que reemplazó los modelos antiguos por deep learning moderno, introdujo puntuación de calidad objetiva para aprobar automáticamente las fotos de alta confianza y redujo la tasa de edición manual de aproximadamente el 34% a menos del 10% — un 70% menos — mientras procesa todo el volumen diario en una ventana de 4 horas a menos de 3 segundos por foto.
Contexto del Proyecto
Cada mañana, decenas de miles de fotos de vehículos llegan en una ventana corta para su publicación online. A pesar de las herramientas de IA existentes, aproximadamente una de cada tres fotos aún requería corrección manual por mala iluminación, ángulos torcidos y color incorrecto — más de 23.000 fotos al día para los editores humanos.
El cliente encargó una nueva plataforma para reemplazar los modelos antiguos con deep learning moderno, añadir puntuación de calidad para que las fotos de alta confianza pudieran saltarse la revisión humana por completo y comprimir la carga manual — todo sin cambiar el flujo de publicación del que dependían sus concesionarios. Un equipo de cinco personas de HDWEBSOFT cubrió ingeniería de modelos, MLOps, infraestructura cloud y la aplicación web de revisión.
Entrevista con el Stakeholder
“La restricción más dura fue la propia ventana de ráfaga: 80.000 fotos en cuatro horas, cada una en menos de tres segundos. Las GPU tardan más de dos minutos en arrancar en frío, así que un autoscaling reactivo siempre iría persiguiendo la cola. Teníamos que diseñar el pipeline alrededor de esa realidad.”
— Dat Huynh, Project Manager en HDWEBSOFT
En lugar de esperar a que la carga disparara el escalado, el equipo invirtió la secuencia: la capacidad de GPU se precalienta 15 minutos antes de la ráfaga diaria con un margen de 3,6×, las colas absorben los picos de llegada mientras las instancias ya calientes las drenan, y el scale-to-zero mantiene el coste en reposo casi a cero fuera de la ventana. Una simulación de carga completa de cuatro horas antes del lanzamiento demostró el diseño con volumen real, no con estimaciones.
Ese trabajo de diseño es lo que permitió a la plataforma mantener su SLA de menos de 3 segundos durante toda la ráfaga matinal desde el primer día, sin acumular retrasos que afectaran a los calendarios de publicación de los concesionarios — y se convirtió en la plantilla de las revisiones de capacidad del equipo en cargas de trabajo de IA de gran volumen posteriores.
Funcionalidades Clave
- Corrección geométrica con IA — endereza ángulos torcidos y horizontes inclinados, y recorta cada encuadre alrededor del vehículo.
- Corrección de color con IA — corrige iluminación, balance de blancos, exposición y contraste; aprende el look de marca de cada concesionario en lugar de aplicar un estilo genérico.
- Puntuación de calidad y autoaprobación — puntúa cada foto de 0 a 100; los resultados de alta confianza van directo al anuncio sin intervención humana.
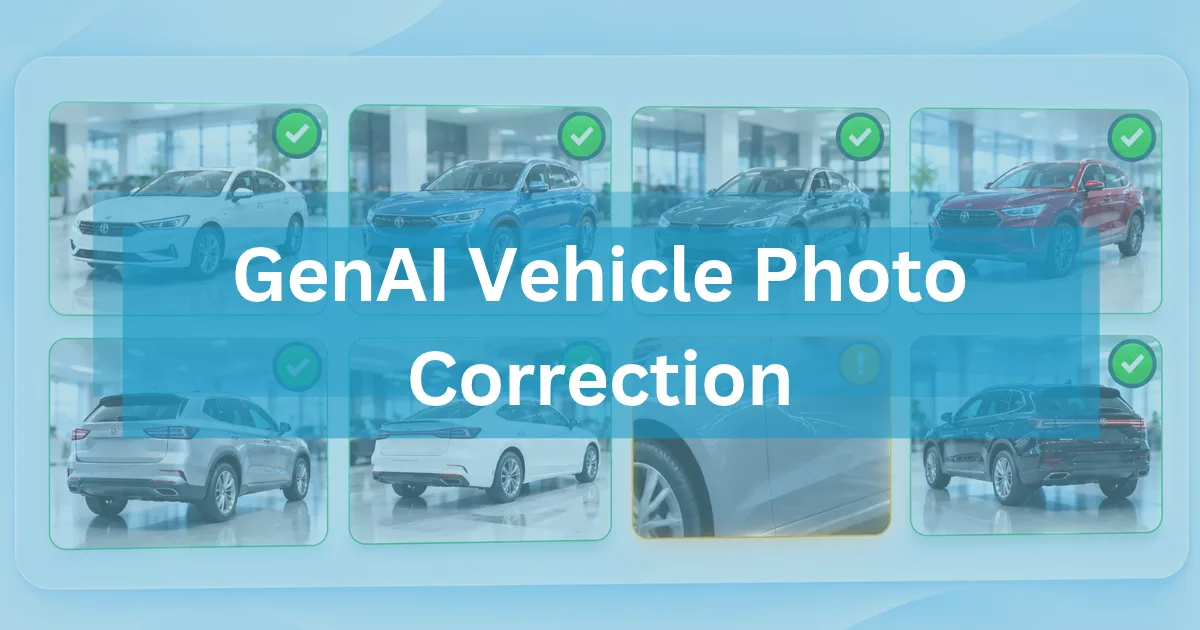
- Flujo de revisión humana — vista en cuadrícula con insignias de confianza que permite a los revisores aprobar lotes con un clic.
- Integración transparente — se conecta al pipeline de publicación existente del cliente mediante webhooks con reintentos y deduplicación, sin cambiar el flujo posterior.
Retos Técnicos
La calidad de los datos de entrenamiento dependía por completo de los pares aportados por el cliente
Los modelos de corrección solo podían ser tan buenos como los miles de pares de fotos antes-después que aportó el cliente, editados por distintas personas a lo largo del tiempo. El riesgo real era la inconsistencia: si dos editores corregían el mismo problema de iluminación de formas distintas, el modelo aprendería ruido en lugar de intención. Las fotos de interior agravaban el problema — las cabinas estrechas generan iluminación compleja, temperaturas de color mezcladas y fuertes reflejos en salpicaderos y ventanillas que las correcciones genéricas manejan mal. Las lagunas de cobertura importaban igual de mucho: un dataset sesgado hacia fotos fáciles de exterior a la luz del día dejaría al modelo ciego justo donde más sufren los editores.
80.000 fotos dentro de una ventana de 4 horas
El volumen por sí solo no era la restricción — lo era el patrón de llegada. Las fotos no llegan de forma uniforme; aterrizan en una ráfaga matinal concentrada y cada imagen debe completar la corrección en menos de 3 segundos. Las instancias GPU tardan hasta 150 segundos en arrancar en frío, de modo que cualquier estrategia de autoscaling reactivo queda permanentemente por detrás de la cola: cuando la nueva capacidad está caliente, el backlog ya se ha formado y se acumula. La alternativa — mantener las GPU calientes las 24 horas — habría roto el modelo de costes del cliente. A mitad del proyecto, además, el alcance casi se duplicó, comprimiendo el tiempo disponible para resolver todo esto.
Salida probabilística de la IA y expectativas de marca por concesionario
Los modelos de corrección son probabilísticos — la misma foto puede producir resultados ligeramente distintos entre ejecuciones. Eso convertía cada revisión de salidas en una discusión subjetiva sobre qué versión “se veía bien” y erosionaba la confianza de los stakeholders para publicar cualquier cosa sin aprobación humana. La marca lo complicaba aún más: cada concesionario espera que las fotos coincidan con su look establecido — una firma visual que sus editores construyeron durante años — no un estilo genérico. Los concesionarios grandes tienen miles de ejemplos antes/después de los que aprender; los pequeños no, y un perfil entrenado con datos escasos no sería fiable.
Soluciones
Datos de entrenamiento auditados y ponderados por cobertura
Antes de modelar, el equipo auditó todo el dataset — verificando que cada par antes/después estaba correctamente alineado, marcando ediciones inconsistentes y comprobando la cobertura por condiciones de iluminación y tipo de toma. El dataset se dividió para que el modelo aprendiera patrones de corrección generalizables en lugar de memorizar los hábitos de cada editor. Para los interiores, los datos de entrenamiento se ponderaron fuertemente hacia esas tomas difíciles, y el pipeline se diseñó para que las correcciones de baja confianza se enviaran automáticamente a revisión humana en lugar de publicarse.
Capacidad precalentada con margen demostrado
Los servidores despiertan automáticamente 15 minutos antes de la ráfaga diaria al 3,6× de la capacidad base, absorbiendo el problema del arranque en frío antes de que pueda formar cola. Una simulación de carga completa de 4 horas demostró el diseño antes del lanzamiento — con volumen realista, no cálculos teóricos. Para absorber el crecimiento del alcance a mitad de proyecto sin mover los plazos, el equipo adoptó herramientas de desarrollo asistidas por IA en todo el ciclo de entrega, lo que arrojó una ganancia de productividad del 30%.
Puntuación objetiva y perfiles de color por concesionario
La revisión subjetiva se sustituyó por una puntuación objetiva de 0–100 por foto, con una regla de publicación estricta: por debajo del 90% de acuerdo humano sobre las salidas puntuadas, la corrección no se publica. Para la marca, los perfiles de color por concesionario se entrenan con los propios ejemplos antes/después de cada concesionario — aprendiendo su look en lugar de imponer uno. Los concesionarios sin historial suficiente recurren a un perfil regional como fallback, y los perfiles se refinan continuamente con las correcciones que hacen los editores humanos aguas abajo.
Resultados de Negocio
- 70% menos de edición manual — de aproximadamente una de cada tres fotos a menos del 10% que necesita revisión, de minutos a segundos por foto.
- Coste de infraestructura de ~3.470 USD/mes a volumen de producción completo, con scale-to-zero fuera de la ventana.
- Calidad uniforme entre concesionarios — un único estándar de puntuación en lugar de subjetividad por revisor.
- Despliegues canary con rollback automático que mantienen las actualizaciones del modelo seguras a escala de producción.
- Ganancias estratégicas — publicación más rápida para los concesionarios, reporting segmentado para el cliente e independencia operativa total de su equipo tras el traspaso.
Snapshot Técnico
- Modelos: YOLOv8-m para detección geométrica; SVDLUT (PyTorch) para corrección de color; MUSIQ NR-IQA y LPIPS para puntuación de calidad objetiva — acelerados por CUDA.
- Serving: inferencia asíncrona de SageMaker detrás de un pool de GPU con autoscaling precalentado antes de la ráfaga.
- Pipeline: AWS Lambda (Python 3.12) y ECS/Fargate (Node.js) orquestados sobre SQS/SNS, con estado en DynamoDB, metadatos en RDS PostgreSQL 16 y assets en S3 detrás de API Gateway.
- Seguridad: mTLS, firma de peticiones HMAC-SHA256, WAFv2, PrivateLink y KMS.
- Entrega: infraestructura como código con Terraform, CI con GitHub Actions, imágenes Docker/ECR, observabilidad CloudWatch + X-Ray, on-call con PagerDuty e interfaz de revisión React + Cognito + CloudFront.
Conclusión
La plataforma transformó la operación de edición del cliente de un cuello de botella manual foto a foto a un pipeline autocorregido y puntuado — los revisores humanos ahora solo tocan las fotos en las que la IA tiene menos confianza. Si su equipo está escalando una carga de trabajo de computer vision o IA generativa bajo restricciones duras de latencia o volumen, nuestros servicios de desarrollo de IA cubren exactamente este modelo de entrega. Contacte con nuestro equipo para delimitar un proyecto similar.
Explore contenido relacionado
Vea más casos de estudio, servicios, industrias y experiencia regional relacionada.