Una piattaforma statunitense di fotografia veicoli che serve centinaia di concessionarie processa ogni giorno 70.000–80.000 foto per gli annunci — un volume in cui la qualità dell’immagine influenza direttamente l’interesse degli acquirenti e la velocità di vendita. HDWEBSOFT ha consegnato una piattaforma di correzione immagini basata su GenAI che ha sostituito i vecchi modelli con deep learning moderno, introdotto un punteggio di qualità oggettivo per approvare automaticamente le foto ad alta confidenza, e portato il tasso di ritocco manuale da circa il 34% a meno del 10% — una riduzione del 70% — processando l’intero volume giornaliero in una finestra di 4 ore a meno di 3 secondi per foto.
Contesto del Progetto
Ogni mattina decine di migliaia di foto di veicoli arrivano in una finestra ristretta per la pubblicazione online. Nonostante gli strumenti IA già esistenti, circa una foto su tre richiedeva ancora correzione manuale per cattiva illuminazione, angoli storti e colori imprecisi — oltre 23.000 foto al giorno per gli editor umani.
Il cliente ha commissionato una nuova piattaforma per sostituire i vecchi modelli con deep learning moderno, aggiungere un punteggio di qualità che permettesse alle foto ad alta confidenza di saltare del tutto la revisione umana, e comprimere il carico manuale — senza cambiare il workflow di pubblicazione da cui dipendevano le concessionarie. Un team HDWEBSOFT di cinque persone ha coperto ingegneria dei modelli, MLOps, infrastruttura cloud e l’applicazione web di revisione.
Intervista allo Stakeholder
“Il vincolo più duro era la finestra di picco stessa — 80.000 foto in quattro ore, ciascuna in meno di tre secondi. Le GPU impiegano oltre due minuti per l’avvio a freddo, quindi un autoscaling reattivo inseguirebbe sempre la coda. Dovevamo progettare la pipeline attorno a quella realtà.”
— Dat Huynh, Project Manager presso HDWEBSOFT
Invece di aspettare che il carico attivasse lo scaling, il team ha invertito la sequenza: la capacità GPU viene preriscaldata 15 minuti prima del picco giornaliero con un margine di 3,6×, le code assorbono le ondate di arrivo mentre le istanze già calde le smaltiscono, e lo scale-to-zero mantiene il costo a riposo quasi nullo fuori dalla finestra. Una simulazione di carico completa di quattro ore prima del lancio ha dimostrato il design con volume reale — non con stime.
È quel lavoro di progettazione che ha permesso alla piattaforma di mantenere l’SLA sotto i 3 secondi per l’intero picco mattutino fin dal primo giorno, senza backlog che ostacolasse i programmi di pubblicazione delle concessionarie — ed è diventato il modello per le revisioni di capacità del team sui successivi carichi di lavoro IA ad alto volume.
Funzionalità Chiave
- Correzione geometrica IA — raddrizza angoli storti e orizzonti inclinati, e ritaglia l’inquadratura attorno al veicolo.
- Correzione colore IA — corregge illuminazione, bilanciamento del bianco, esposizione e contrasto; impara il look di marca di ogni concessionaria invece di applicare uno stile generico.
- Punteggio di qualità e auto-approvazione — assegna a ogni foto un punteggio da 0 a 100; i risultati ad alta confidenza vanno direttamente all’annuncio senza intervento umano.
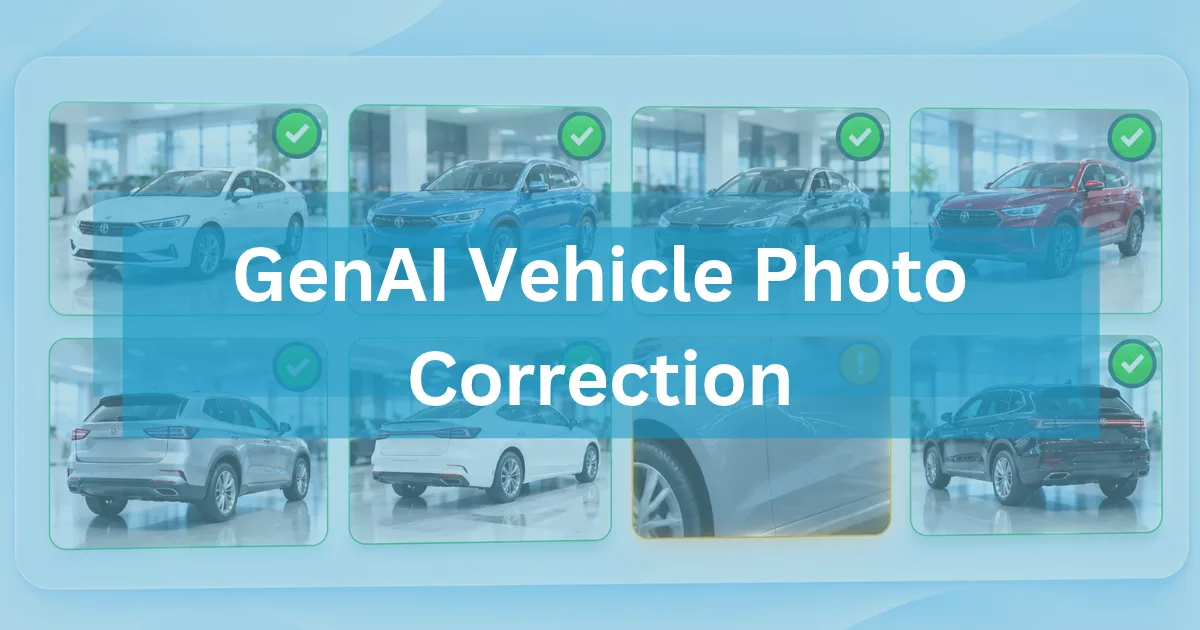
- Workflow di revisione umana — vista a griglia con badge di confidenza che permette ai revisori di approvare lotti con un clic.
- Integrazione trasparente — si collega alla pipeline di pubblicazione esistente del cliente tramite webhook con retry e deduplicazione, senza cambiare il workflow a valle.
Sfide Tecniche
La qualità dei dati di addestramento dipendeva interamente dalle coppie fornite dal cliente
I modelli di correzione potevano essere solo buoni quanto le migliaia di coppie prima-dopo fornite dal cliente — prodotte da diversi editor nel tempo. Il vero rischio era l’incoerenza: se due editor correggevano lo stesso problema di illuminazione in modo diverso, il modello avrebbe imparato rumore invece che intenzione. Le foto degli interni aggravavano il problema — gli abitacoli stretti creano illuminazione complessa, temperature di colore miste e forti riflessi su cruscotto e vetri che le correzioni generiche gestiscono male. Le lacune di copertura contavano altrettanto: un dataset sbilanciato verso facili esterni diurni avrebbe reso il modello cieco proprio dove gli editor faticano di più.
80.000 foto in una finestra di 4 ore
Il volume da solo non era il vincolo — lo era il pattern di arrivo. Le foto non arrivano in modo uniforme; atterrano in un picco mattutino concentrato, e ogni immagine deve completare la correzione in meno di 3 secondi. Le istanze GPU impiegano fino a 150 secondi per l’avvio a freddo, quindi qualsiasi strategia di autoscaling reattivo resta permanentemente indietro rispetto alla coda: quando la nuova capacità è calda, il backlog si è già formato e si accumula. L’alternativa — tenere le GPU calde 24 ore su 24 — avrebbe infranto il modello di costo del cliente. A metà progetto, inoltre, l’ambito è quasi raddoppiato, comprimendo il tempo disponibile per risolvere tutto questo.
Output IA probabilistico e aspettative di brand per concessionaria
I modelli di correzione sono probabilistici — la stessa foto può produrre risultati leggermente diversi a ogni esecuzione. Questo trasformava ogni revisione degli output in un dibattito soggettivo su quale versione “sembrasse giusta”, erodendo la fiducia degli stakeholder nel pubblicare qualsiasi cosa senza approvazione umana. Il branding aggiungeva complessità: ogni concessionaria si aspetta foto coerenti con il proprio look consolidato — una firma che i suoi editor hanno costruito in anni — non uno stile generico. Le grandi concessionarie hanno migliaia di esempi prima-dopo da cui imparare; quelle piccole no, e un profilo addestrato su dati scarsi non sarebbe affidabile.
Soluzioni
Dati di addestramento auditati e ponderati per copertura
Prima di qualsiasi modellazione, il team ha auditato l’intero dataset — verificando che ogni coppia prima-dopo fosse correttamente allineata, segnalando le correzioni incoerenti e controllando la copertura per condizioni di luce e tipo di inquadratura. Il dataset è stato diviso in modo che il modello apprendesse pattern di correzione generalizzabili invece di memorizzare le abitudini di singoli editor. Per gli interni, i dati di addestramento sono stati fortemente ponderati verso quelle inquadrature difficili, e la pipeline è stata progettata affinché i risultati a bassa confidenza vadano automaticamente ai revisori umani invece di essere pubblicati.
Capacità preriscaldata con margine dimostrato
I server si attivano automaticamente 15 minuti prima del picco giornaliero a 3,6× la capacità base, assorbendo il problema dell’avvio a freddo prima che possa formare una coda. Una simulazione di carico completa di 4 ore ha dimostrato il design prima del lancio — con volume realistico, non con calcoli approssimativi. Per assorbire la crescita dell’ambito a metà progetto senza spostare le scadenze, il team ha adottato strumenti di sviluppo assistiti dall’IA su tutta la consegna, misurando un guadagno di produttività del 30%.
Punteggio oggettivo e profili colore per concessionaria
La revisione soggettiva è stata sostituita da un punteggio di qualità oggettivo da 0 a 100 per foto, con una regola di pubblicazione rigida: sotto il 90% di accordo umano sugli output valutati, la correzione non esce. Per il branding, i profili colore per concessionaria sono addestrati sui propri esempi prima-dopo di ciascuna concessionaria — imparando il suo look invece di imporne uno. Le concessionarie senza storico sufficiente ricadono su un profilo regionale come fallback, e i profili si affinano continuamente dalle correzioni che gli editor umani apportano a valle.
Risultati di Business
- 70% di ritocco manuale in meno — da circa una foto su tre a meno del 10% che richiede revisione, da minuti a secondi per foto.
- ~3.470 USD/mese di costo infrastrutturale a volume di produzione pieno, con scale-to-zero fuori dalla finestra di picco.
- Qualità uniforme tra concessionarie — un unico standard di valutazione invece della soggettività per revisore.
- Deployment canary con auto-rollback che mantengono sicuri gli aggiornamenti del modello su scala di produzione.
- Guadagni strategici — pubblicazione più rapida per le concessionarie, reporting segmentato per il cliente e piena indipendenza operativa del suo team dopo l’handover.
Snapshot Tecnico
- Modelli: YOLOv8-m per il rilevamento geometrico; SVDLUT (PyTorch) per la correzione colore; MUSIQ NR-IQA e LPIPS per il punteggio di qualità oggettivo — accelerati CUDA.
- Serving: inferenza asincrona SageMaker dietro un pool GPU autoscaling preriscaldato prima del picco.
- Pipeline: AWS Lambda (Python 3.12) ed ECS/Fargate (Node.js) orchestrati su SQS/SNS, stato su DynamoDB, metadati su RDS PostgreSQL 16 e asset su S3 dietro API Gateway.
- Sicurezza: mTLS, firma delle richieste HMAC-SHA256, WAFv2, PrivateLink e KMS.
- Delivery: infrastructure-as-code Terraform, CI GitHub Actions, immagini Docker/ECR, osservabilità CloudWatch + X-Ray, on-call PagerDuty, interfaccia di revisione React + Cognito + CloudFront.
Conclusione
La piattaforma ha trasformato l’operazione di ritocco del cliente da un collo di bottiglia manuale foto per foto a una pipeline autocorretta e valutata — i revisori umani ora toccano solo le foto di cui l’IA è meno sicura. Se il vostro team sta scalando un carico di lavoro di computer vision o IA generativa sotto vincoli rigidi di latenza o volume, i nostri servizi di sviluppo IA coprono esattamente questo modello di consegna. Contattate il nostro team per delineare un progetto simile.
Esplora altri contenuti correlati
Vedi altro case studies, servizi, settori e esperienza operativa regionale correlata