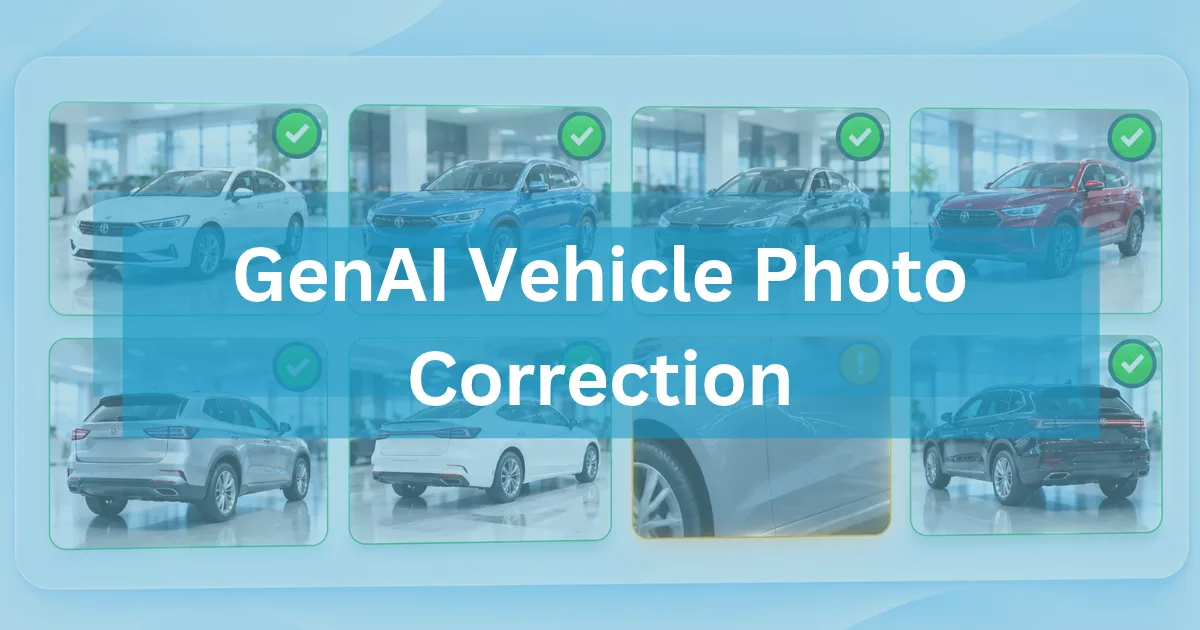
แพลตฟอร์มถ่ายภาพรถยนต์ของสหรัฐที่ให้บริการตัวแทนจำหน่ายหลายร้อยแห่ง ประมวลผลภาพลงประกาศ 70,000–80,000 ภาพทุกวัน — ปริมาณที่คุณภาพภาพส่งผลโดยตรงต่อความสนใจของผู้ซื้อและความเร็วในการขาย HDWEBSOFT ส่งมอบแพลตฟอร์มแก้ไขภาพด้วย GenAI ที่แทนโมเดลเก่าด้วย deep learning สมัยใหม่ เพิ่มการให้คะแนนคุณภาพเชิงวัตถุเพื่ออนุมัติภาพความมั่นใจสูงอัตโนมัติ และลดอัตรางานแก้มือจากราว 34% เหลือต่ำกว่า 10% — ลดลง 70% — ขณะประมวลผลปริมาณเต็มวันภายในกรอบ 4 ชั่วโมงที่ต่ำกว่า 3 วินาทีต่อภาพ
บริบทโครงการ
ทุกเช้า ภาพรถหลายหมื่นภาพไหลเข้ามาในกรอบเวลาแคบเพื่อลงประกาศออนไลน์ แม้มีเครื่องมือ AI เดิมอยู่แล้ว ภาพราว 1 ใน 3 ยังต้องแก้มือเพราะแสงไม่ดี มุมเอียง และสีเพี้ยน — ทิ้งภาพกว่า 23,000 ภาพต่อวันให้คนแก้
ลูกค้าสั่งแพลตฟอร์มใหม่เพื่อแทนโมเดลเก่าด้วย deep learning สมัยใหม่ เพิ่มการให้คะแนนคุณภาพเพื่อให้ภาพความมั่นใจสูงข้ามการรีวิวคนได้ทั้งหมด และบีบงานคนลง — โดยไม่เปลี่ยน workflow ลงประกาศข้างล่างที่ตัวแทนจำหน่ายพึ่งพาอยู่ ทีม HDWEBSOFT 5 คนรับผิดชอบวิศวกรรมโมเดล, MLOps, โครงสร้างพื้นฐานคลาวด์ และเว็บแอปสำหรับรีวิว
สัมภาษณ์ผู้มีส่วนได้ส่วนเสีย
“ข้อจำกัดที่หนักที่สุดคือกรอบเวลา burst เอง — 80,000 ภาพใน 4 ชั่วโมง ภาพละต่ำกว่า 3 วินาที GPU cold-start กินเวลากว่า 2 นาที ดังนั้น autoscaling แบบตอบสนองจะไล่ตามคิวอยู่เสมอ เราต้องออกแบบ pipeline โดยยึดความจริงนั้นเป็นหลัก”
— Dat Huynh, Project Manager แห่ง HDWEBSOFT
แทนที่จะรอโหลดมากระตุ้นการ scale ทีมกลับลำดับใหม่: ความจุ GPU ถูก pre-warm ล่วงหน้า 15 นาทีก่อน burst รายวันด้วยส่วนเผื่อ 3.6 เท่า คิวดูดซับยอดเข้ามาในขณะที่ instance ที่อุ่นแล้วระบายออก และ scale-to-zero ทำให้ต้นทุนตอนว่างนอกกรอบเวลาเกือบเป็นศูนย์ การจำลองโหลดเต็ม 4 ชั่วโมงก่อน go-live พิสูจน์ดีไซน์ด้วยปริมาณจริง — ไม่ใช่แค่การประมาณ
งานออกแบบนั้นเองที่ทำให้แพลตฟอร์มรักษา SLA ต่ำกว่า 3 วินาทีตลอด burst ตอนเช้าได้ตั้งแต่วันแรก ไม่เหลือ backlog ไปกระทบตารางลงประกาศของตัวแทนจำหน่าย — และกลายเป็นแม่แบบสำหรับการทบทวนความจุของทีมใน workload AI ขนาดใหญ่ภายหลัง
ฟีเจอร์หลัก
- AI แก้เรขาคณิต — ปรับมุมเอียงและเส้นขอบฟ้าเท ครอบเฟรมรอบตัวรถ
- AI แก้สี — แก้แสง, white balance, การเปิดรับแสง และ contrast; เรียนรู้ลุคแบรนด์ของตัวแทนแต่ละรายแทนที่จะใช้เกรดเดียว
- ให้คะแนนคุณภาพ & อนุมัติอัตโนมัติ — ให้คะแนนทุกภาพ 0–100; ผลลัพธ์ความมั่นใจสูงไปลงประกาศตรงโดยไม่ต้องคนแตะ
- workflow รีวิวคน — มุมมองตารางพร้อมป้ายความมั่นใจให้ผู้รีวิวอนุมัติเป็นชุดในคลิกเดียว
- ผสานอย่างไร้รอยต่อ — เชื่อม pipeline ลงประกาศเดิมของลูกค้าผ่าน webhook พร้อม retry และตัดข้อมูลซ้ำ workflow ข้างล่างไม่เปลี่ยน
ความท้าทายทางเทคนิค
คุณภาพข้อมูลฝึกพึ่งพาคู่ภาพที่ลูกค้าส่งทั้งหมด
โมเดลแก้ไขจะดีได้แค่คู่ภาพก่อน-หลังหลายพันคู่ที่ลูกค้าให้มา — ซึ่งผู้แก้หลายคนทำตลอดเวลา ความเสี่ยงจริงคือความไม่สม่ำเสมอ: ถ้าคนแก้สองคนแก้ปัญหาแสงเดียวกันคนละแบบ โมเดลจะเรียน noise แทนจะเรียนเจตนา ภาพภายในรถยิ่งยาก — ห้องโดยสารแคบสร้างแสงซับซ้อน อุณหภูมิสีผสม และแสงสะท้อนแรงบนแดชบอร์ดกับกระจกที่การแก้ทั่วไปรับมือไม่ได้ ช่องว่างความครอบคลุมสำคัญไม่แพ้กัน: dataset ที่เอียงไปทางภาพนอกรถกลางวันง่าย ๆ จะทำให้โมเดลตาบอดตรงจุดที่คนแก้ลำบากที่สุดพอดี
80,000 ภาพในกรอบ 4 ชั่วโมง
ข้อจำกัดไม่ใช่แค่ปริมาณ — แต่คือรูปแบบการเข้ามา ภาพไม่ได้ไหลสม่ำเสมอ มันมาเป็น burst ตอนเช้า และทุกภาพต้องเสร็จการแก้ภายใน 3 วินาที GPU instance ใช้เวลาถึง 150 วินาทีในการ cold-start ทำให้ autoscaling แบบตอบสนองตามคิวไม่ทันเสมอ: พอความจุใหม่อุ่น backlog ก็ก่อตัวและทบตัวแล้ว ทางเลือกคืออุ่น GPU ตลอด 24 ชม. ซึ่งจะพังโมเดลต้นทุนของลูกค้า กลางโครงการ ขอบเขตยังโตเกือบเท่าตัว บีบเวลาที่จะแก้ทุกอย่างนี้ลงอีก
Output AI ที่เป็นเชิงน่าจะเป็นกับความคาดหวังแบรนด์รายตัวแทน
โมเดลแก้ไขเป็นเชิงน่าจะเป็น — ภาพเดียวกันอาจให้ผลต่างกันเล็กน้อยในแต่ละรอบ ทำให้การรีวิวผลแต่ละครั้งกลายเป็นข้อถกเถียงเชิงอัตวิสัยว่าเวอร์ชันไหน “ดูถูก” และกัดกร่อนความเชื่อมั่นของ stakeholder ในการปล่อยอะไรโดยไม่มีคนอนุมัติ แบรนด์ยิ่งซับซ้อน: ตัวแทนแต่ละรายคาดหวังภาพที่เข้ากับลุคที่ตั้งไว้ — ลายเซ็นที่คนแก้ของพวกเขาสร้างมาหลายปี — ไม่ใช่สไตล์กลาง ตัวแทนใหญ่มีตัวอย่างก่อน-หลังหลายพันให้เรียน; ตัวแทนเล็กไม่มี และโปรไฟล์ที่ฝึกบนข้อมูลบางจะไม่น่าเชื่อถือ
โซลูชัน
ข้อมูลฝึกที่ผ่านการ audit และถ่วงน้ำหนักตามความครอบคลุม
ก่อน modeling ทีม audit dataset ทั้งชุด — ตรวจทุกคู่ก่อน-หลังจับคู่ถูก ติดธงงานแก้ไม่สม่ำเสมอ และเช็กความครอบคลุมตามสภาพแสงและประเภทภาพ dataset ถูกแบ่งเพื่อให้โมเดลเรียนแพทเทิร์นการแก้ที่ทั่วไปได้แทนที่จะจำนิสัยคนแก้แต่ละคน สำหรับภาพภายใน ข้อมูลฝึกถูกถ่วงน้ำหนักไปทางภาพยากเหล่านั้นอย่างหนัก และ pipeline ถูกออกแบบให้ผลความมั่นใจต่ำวิ่งไปหาผู้รีวิวอัตโนมัติแทนที่จะปล่อย
ความจุ pre-warm พร้อมส่วนเผื่อที่พิสูจน์แล้ว
เซิร์ฟเวอร์ตื่นอัตโนมัติ 15 นาทีก่อน burst รายวันที่ความจุพื้นฐาน 3.6 เท่า ดูดซับปัญหา cold-start ก่อนมันจะก่อคิว การจำลองโหลดเต็ม 4 ชั่วโมงพิสูจน์ดีไซน์ก่อน go-live ด้วยปริมาณสมจริง เพื่อรับขอบเขตที่โตขึ้นกลางโครงการโดยไม่เลื่อนกำหนดส่ง ทีมนำเครื่องมือพัฒนาที่มี AI ช่วยมาใช้ทั้งสายงาน วัดได้ผลผลิตภาพเพิ่ม 30%
การให้คะแนนเชิงวัตถุและโปรไฟล์สีรายตัวแทน
การรีวิวเชิงอัตวิสัยถูกแทนด้วยคะแนนคุณภาพเชิงวัตถุ 0–100 ต่อภาพ พร้อมกฎปล่อยงานแข็ง: ถ้าความเห็นพ้องของคนบนผลที่ให้คะแนนต่ำกว่า 90% งานแก้นั้นไม่ออก เรื่องแบรนด์ โปรไฟล์สีรายตัวแทนถูกฝึกจากตัวอย่างก่อน-หลังของตัวแทนนั้นเอง — เรียนลุคของพวกเขาแทนที่จะบังคับแบบเดียว ตัวแทนที่ประวัติไม่พอใช้โปรไฟล์ภูมิภาคเป็น fallback และโปรไฟล์ค่อย ๆ ละเอียดขึ้นเรื่อย ๆ จากการแก้ที่คนแก้ทำข้างล่าง
ผลลัพธ์ทางธุรกิจ
- ลดงานแก้มือ 70% — จากราว 1 ใน 3 ภาพเหลือต่ำกว่า 10% ที่ต้องรีวิว เวลาจากนาทีเหลือวินาทีต่อภาพ
- ต้นทุนโครงสร้างพื้นฐาน ~3,470 ดอลลาร์/เดือน ที่ปริมาณ production เต็ม พร้อม scale-to-zero นอกกรอบเวลา
- คุณภาพเสมอกันข้ามตัวแทน — มาตรฐานให้คะแนนเดียวแทนอัตวิสัยรายผู้รีวิว
- Canary deploy พร้อม auto-rollback รักษาความปลอดภัยการอัปเดตโมเดลในระดับ production
- ผลประโยชน์เชิงกลยุทธ์ — ลงประกาศเร็วขึ้นสำหรับตัวแทน รายงานแยกเซกเมนต์สำหรับลูกค้า และความเป็นอิสระในการดำเนินงานเต็มรูปแบบหลังส่งมอบ
ภาพรวมเทคนิค
- โมเดล: YOLOv8-m ตรวจเรขาคณิต; SVDLUT (PyTorch) แก้สี; MUSIQ NR-IQA และ LPIPS ให้คะแนนคุณภาพเชิงวัตถุ — เร่งด้วย CUDA
- Serving: SageMaker Async inference หลังพูล GPU autoscaling ที่ pre-warm ก่อน burst
- Pipeline: AWS Lambda (Python 3.12) และ ECS/Fargate (Node.js) ประสานผ่าน SQS/SNS, DynamoDB เก็บ state, RDS PostgreSQL 16 เก็บ metadata, S3 เก็บ asset หลัง API Gateway
- ความปลอดภัย: mTLS, เซ็น request ด้วย HMAC-SHA256, WAFv2, PrivateLink, KMS
- การส่งมอบ: Terraform IaC, GitHub Actions CI, image Docker/ECR, สังเกตการณ์ CloudWatch + X-Ray, on-call ด้วย PagerDuty, ส่วนรีวิว React + Cognito + CloudFront
สรุป
แพลตฟอร์มเปลี่ยนงานแก้ภาพของลูกค้าจากคอขวดทีละภาพด้วยมือ เป็น pipeline แก้ตัวเองที่มีการให้คะแนน — ผู้รีวิวเหลือแตะเฉพาะภาพที่ AI มั่นใจน้อยสุด ถ้าทีมของคุณกำลัง scale workload computer vision หรือ generative AI ภายใต้ข้อจำกัดความหน่วงหรือปริมาณแข็ง บริการพัฒนา AI ของเราครอบคลุมโมเดลการส่งมอบนี้พอดี ติดต่อทีมของเรา เพื่อวางขอบเขตงานที่คล้ายกัน
สำรวจเนื้อหาที่เกี่ยวข้องเพิ่มเติม
ดูเพิ่มเติม case studies, บริการ, อุตสาหกรรม และประสบการณ์การดำเนินงานตามภูมิภาคที่เกี่ยวข้อง