Die Superintelligenz-Architektur für Unternehmen ist ein vorgeschlagener Architekturansatz für Enterprise-KI-Systeme: eine anbieterneutrale Art, Daten, Modelle, Agenten, Anwendungen und Governance so zu organisieren, dass das System immer leistungsfähigere KI aufnehmen kann, ohne bei jeder Frontier-Verschiebung neu gebaut zu werden. Es ist kein etablierter Industriestandard — sondern ein Referenzmodell für Unternehmen, die architektonische Bereitschaft statt Anbieterabhängigkeit wollen.
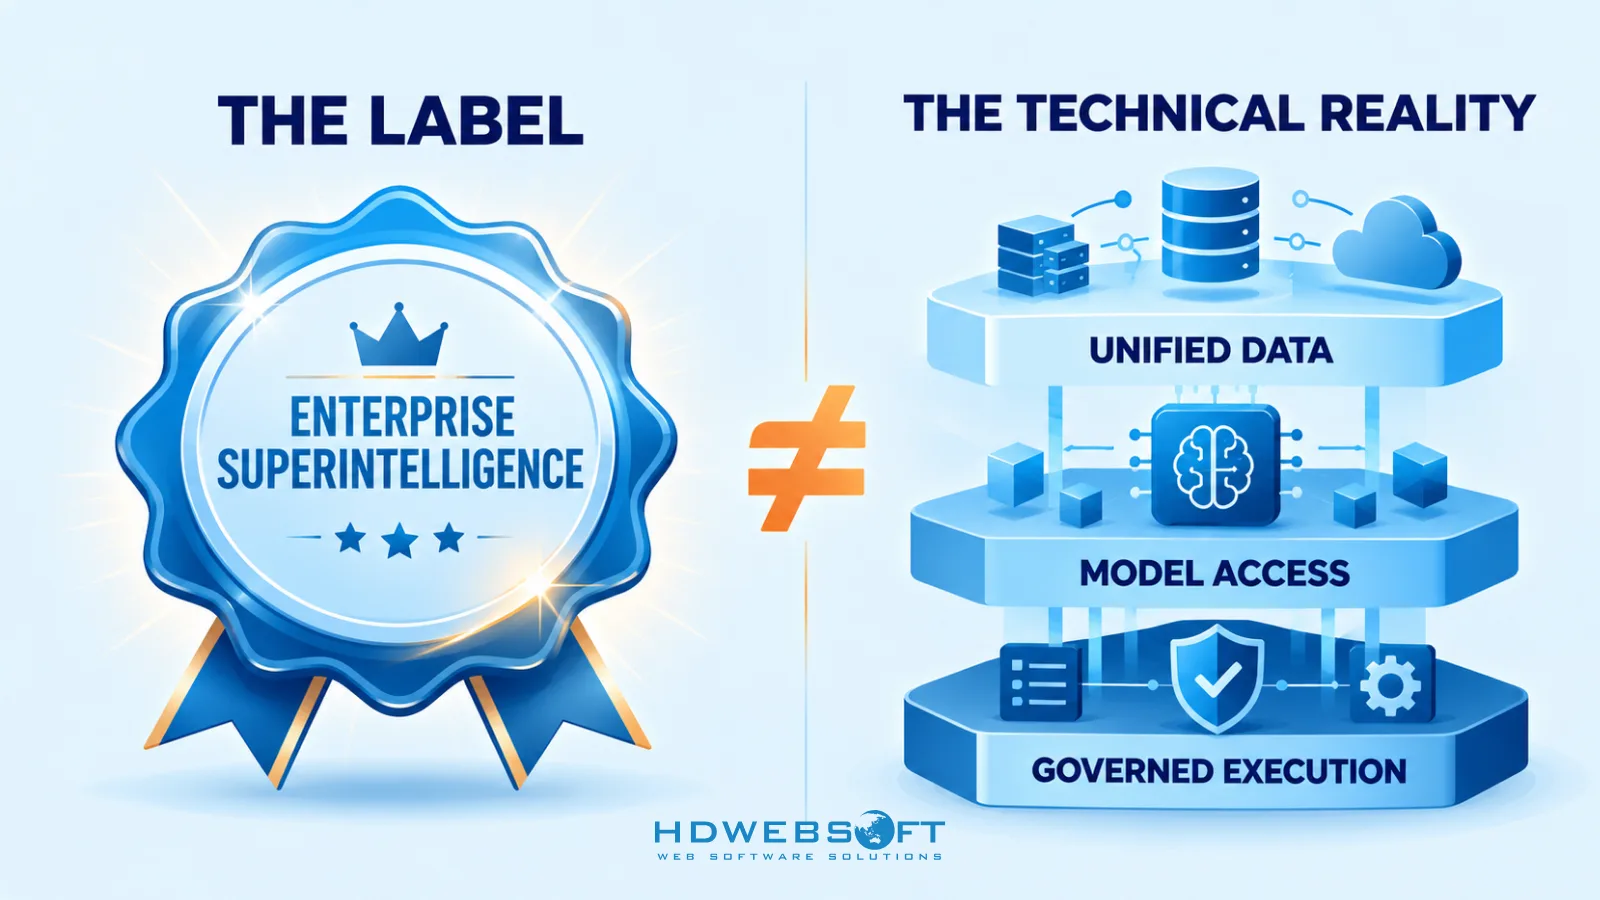
Der Begriff erfordert sorgfältigen Umgang. „Enterprise Superintelligence”, wie Plattformen ihn heute verwenden, beschreibt fortschrittliche, integrierte Enterprise-KI — nicht echte künstliche Superintelligenz, die hypothetisch und unverifiziert bleibt. Dieser Artikel liefert drei Dinge: einen nüchternen Blick auf die Plattformen, die das Label übernehmen, eine sechsschichtige Referenzarchitektur, die Sie adaptieren können, und eine phasenweise Roadmap zur Umsetzung mit der KI, die Sie bereits haben.
Die wichtigsten Punkte
- Die Superintelligenz-Architektur für Unternehmen ist ein vorgeschlagenes Referenzmodell — kein zertifizierter Standard und kein Beweis dafür, dass ASI existiert.
- Enterprise-SI-Plattformen wie Matrix und ML6s Unum sind frühe Marktbeispiele; beurteilen Sie sie nach ihrer Architektur, nicht nach ihren Labels.
- Eine superintelligenzfähige Architektur hat sechs Schichten — Daten, Modellabstraktion, Agentenorchestrierung, Anwendung, Infrastruktur — plus Governance als übergreifende Kontrollen über alle hinweg.
- Modellunabhängigkeit, Komposierbarkeit und Evaluierungsbaselines sind die Designprinzipien, die die Architektur bei Modellfortschritt dauerhaft machen.
- Eine vierstufige Roadmap — Bewertung, Fundament, Orchestrierungspilot, Produktionshärtung — führt schrittweise dorthin.
Was bedeutet Enterprise Superintelligence heute?
In der aktuellen Verwendung ist „Enterprise Superintelligence” ein Begriff der Produktpositionierung. Plattformen übernehmen ihn, um KI-Systeme zu beschreiben, die über das Beantworten von Fragen hinausgehen — Systeme, die sich mit Unternehmensdaten verbinden, darüber schlussfolgern, Arbeit planen und Aktionen innerhalb geregelter Grenzen ausführen. Er signalisiert Ambition: eine KI-Schicht, die das gesamte Geschäft versteht, nicht nur einen einzelnen Workflow.
Zwei Klarstellungen halten den Begriff ehrlich. Erstens liefert keine Enterprise-SI-Plattform echte Superintelligenz — die Fähigkeitsschwelle dafür hat, wie unser Pillar-Artikel erklärt, kein System erreicht. Zweitens ist das Label keine technische Spezifikation. Zwei Plattformen können beide „Superintelligenz” behaupten und dabei völlig unterschiedliche Architekturen, Datenhandhabung und Lock-in-Profile haben. Was für Ihre Planung zählt, ist die Architektur unter der Behauptung.
Der Aufstieg der Enterprise-Superintelligence-Plattformen
Eine kleine, aber wachsende Zahl von Anbietern positioniert Produkte jetzt direkt um Enterprise Superintelligence. Zwei veranschaulichen das Muster — und beide Beschreibungen unten spiegeln Anbieterpositionierung wider, keine unabhängig verifizierte Fähigkeit.
-
Matrix vermarktet die Enterprise Superintelligence Platform von Matrix als einheitliche Intelligenzschicht für Führungsteams. Den Materialien zufolge kombiniert die Plattform drei Fähigkeiten: ein „Brain”, das Geschäftsfragen beantwortet, indem es Daten innerhalb der eigenen Infrastruktur des Kunden abfragt, ein „Copilot”, das mit externen LLMs plant und Inhalte erzeugt — mit expliziten Kontrollen darüber, was geteilt wird — und „Agents”, die genehmigte Arbeit über verbundene Systeme ausführen. Die unterscheidende Architekturbehauptung ist, dass Rohdaten die Kundenumgebung nie verlassen — ein souveränitätsorientiertes Design für die C-Suite in regulierten Kontexten.
-
ML6, ein europäisches KI-Engineering-Unternehmen, positioniert die Unum-Plattform von ML6 als „Unum Enterprise Superintelligence”: KI-Infrastruktur, die IT-Roadmap-Prioritäten in agentengesteuerte Arbeit verwandelt. Die beschriebene Schleife — sense, think, act, learn — hebt operative Signale proaktiv hervor, routet Arbeit durch geregelte Workflow-Templates („Blueprints”), orchestriert Agenten zur Ausführung und akkumuliert Gedächtnis, sodass jeder Workflow den nächsten verbessert. Die Positionierung zielt auf das „KI-native Unternehmen”, mit genannten Anwendungsfällen in agentischem Programmmanagement und autonomer Wartung.
| Plattform | Positionierung | Fähigkeiten (Anbieterangaben) | Architektonische Implikationen |
|---|---|---|---|
| Matrix | Enterprise Superintelligence Platform — „frag, wisse, handle”-Schleife für die Unternehmensführung | Datenabfrage in eigener Infrastruktur; LLM-Planung mit kontrollierter Datenweitergabe; Agentenausführung über integrierte Systeme | Datensouveränität als First-Class-Grenze; einheitliche Query-Plan-Execute-Schleife über Bestandssysteme |
| ML6 Unum | Enterprise Superintelligence als agentische Betriebsinfrastruktur | Proaktive Signalgebung; geregelte Workflow-Blueprints; Agentenorchestrierung; kumulatives Workflow-Gedächtnis | Orchestrierung und Governance als Kernprodukt; Workflows als wiederverwendbare, auditierbare Assets |
Lesen Sie diese Plattformen als Marktsignale, nicht als Baupläne. Das Muster, das sie teilen — eine einheitliche Datenebene, eine Orchestrierungsschicht, die ausführt, und Governance, die beide umhüllt — ist genau das, was eine anbieterneutrale Referenzarchitektur kodifiziert. Der Unterschied ist, wem sie gehört: ihre Plattform oder Ihre Architektur.
Warum Unternehmen eine zukunftsfähige KI-Architektur brauchen
Vier Druckfaktoren machen architektonische Flexibilität dringlich. Erstens Modellentwicklungsgeschwindigkeit: Fähigkeitssprünge kommen jetzt jährlich oder schneller, und das heutige Bestmodell wird routinemäßig verdrängt. Zweitens Vendor Lock-in: an die API eines Anbieters fest verdrahtete Geschäftslogik macht jedes Modell-Upgrade zu einem Umbau. Drittens Integrationsrealität: Enterprise-KI schafft nur Wert, wenn sie ERP, CRM und Datenplattformen berührt — und jede dieser Integrationen ist die Stelle, an der Architekturen brechen. Viertens dauerhafte Flexibilität: das einzige Asset, das jede Modellgeneration überdauert, ist eine Architektur, die zum Austausch von Komponenten gebaut ist. Die sechs folgenden Schichten beschreiben sie.
Enterprise-Superintelligenz-Referenzarchitektur: Sechs Kernschichten
Diese Referenzarchitektur ist anbieterneutral. Jede konforme Enterprise-KI-Plattform — gekauft oder gebaut — bildet sich auf sie ab, was sie sowohl als Bewertungsinstrument als auch als Bauanleitung nützlich macht. Sechs Schichten stapeln sich von Infrastruktur bis Experience, und Governance ist bewusst keine siebte Schicht: sie ist ein Satz von Kontrollen, die in jeder Schicht existieren müssen.
| Schicht | Kernverantwortung | Schlüsselkomponenten |
|---|---|---|
| Enterprise Data & Knowledge | Vertrauenswürdige, geregelte Daten und Retrieval für KI | Lakehouse/Warehouse, Pipelines, Vector Stores, semantische Schicht, Katalog & Lineage |
| Model Abstraction & Routing | Modellunabhängiger Zugriff; richtiges Modell je Aufgabe | Modell-Gateway, Provider-Adapter, Routing-Policy, Modell-Registry |
| Agent Orchestration & Tool Execution | Mehrstufige Arbeit, Tools und Unternehmenssysteme koordinieren | Orchestrator, Tool-Registry, Execution Sandbox, HITL-Checkpoints |
| Application & Experience | Intelligenz an Nutzer und Geschäftsanwendungen liefern | Copilots, eingebettete KI-Features, interne APIs, Aktionswarteschlangen |
| Infrastructure & Operations | Stack zuverlässig, kostengünstig, skalierbar betreiben | Compute-Strategie, Deployment-Muster, Observability, FinOps |
| Governance, Security & Observability | Übergreifende Kontrollen in jeder Schicht | Identitäts- & Policy-Grenzen, Audit-Trails, Evals, Monitoring |
Enterprise Data & Knowledge Layer
Diese Schicht liefert das vertrauenswürdige Datensubstrat, von dem alles darüber abhängt. Verantwortlichkeiten: Ingest- und Integrationspipelines aus Unternehmensquellen (ERP, CRM, Data Warehouse, Dokumente), Qualitätskontrollen, eine semantische Schicht, die Geschäftsbegriffen stabile Definitionen gibt, und Retrieval-Schnittstellen — Vector Stores, Indizes und Query-APIs — die sowohl Analytics als auch RAG-artiges Grounding bedienen. Typische Komponenten sind Lakehouse oder Warehouse, Transformationspipelines, ein Katalog mit Lineage und Retrieval-Services. Die kritische Eigenschaft: Daten hier sind geregelt — jedes Asset hat einen Owner, eine Qualitätserwartung und dokumentierte Herkunft.
Schwache Datenqualität ist der häufigste Grund, warum Enterprise-KI unterperformt — unser Leitfaden zur KI-Datenbereitschaft behandelt die Bewertung im Detail. Outputs dieser Schicht sind Retrieval-Verträge und geregelte Datenprodukte, die die Schichten darüber konsumieren.
Model Abstraction & Routing Layer
Diese Schicht entkoppelt Ihr System von jedem einzelnen Modell. Verantwortlichkeiten: eine providerneutrale Schnittstelle für Konsumenten bereitstellen, jede Anfrage nach Fähigkeit, Kosten, Latenz oder Policy zum richtigen Modell routen, Fallbacks verwalten und Provider-Unterschiede normalisieren — Tool-Calling-Formate, Streaming, strukturierte Outputs. Kernkomponenten sind ein Modell-Gateway, Adapter pro Provider, Routing-Policy und ein Modell-Registry mit versionierten Aliases (reasoning-primary, fast-default), sodass Anwendungen nie einen Provider-Namen sehen. Eine LLM-Gateway-Architektur ist das Standard-Implementierungsmuster: ein einziger Kontrollpunkt für Modellauswahl, Observability, Kosten und Policy — der ein Modell-Upgrade in eine Konfigurationsänderung verwandelt. Diese Schicht ist die wichtigste Absicherung des Unternehmens gegen die wandernde Frontier: Wenn ein stärkeres Modell erscheint, evaluieren Sie es, aktualisieren einen Alias und promoten — kein Umbau.
Agent Orchestration & Tool Execution Layer
Über dem Modellzugriff sitzt die Schicht, die arbeitet. Verantwortlichkeiten: Ziele in mehrstufige Pläne zerlegen, Agenten und Workflows koordinieren, Tools und Unternehmenssysteme über geregelte Adapter aufrufen, Human-in-the-Loop-Checkpoints bei folgenreichen Aktionen erzwingen und die Ausführung für Audit und Lernen aufzeichnen. Komponenten umfassen einen Orchestrator (Workflow-Graphen oder Agentenframeworks), eine Tool-Registry, die erlaubte Aktionen definiert, Execution-Sandboxes mit begrenzten Rechten und Konnektoren zu ERP/CRM/Ticketing-Systemen. Integration ist der Punkt, an dem diese Schicht gewinnt oder scheitert — Agenten, die nur lesen können, sind Assistenten; Agenten, die handeln können, brauchen Verträge, Berechtigungen und Rollback-Pfade gegen reale Systeme. Unser Leitfaden zu KI-Agenten-Integration und Interoperabilität beschreibt diese Integrationsmuster im Detail. Die oben genannten Enterprise-SI-Plattformen sind im Kern Produkte, die um diese Schicht herum gebaut sind.
Application & Experience Layer
Diese Schicht liefert Intelligenz an Menschen und nachgelagerte Software. Sie umfasst konversationelle Copilots, eingebettete KI-Features in Geschäftsanwendungen, interne APIs, auf denen andere Teams bauen, und Interaktionsmuster wie proaktive Signal-Feeds und Genehmigungswarteschlangen — die „Action required”-Oberflächen, die Plattformen wie Unum ins Zentrum stellen. Das architektonische Anliegen ist Trennung: Experience-Komponenten konsumieren die Schichten darunter über stabile Schnittstellen, sodass eine neue UI-Oberfläche ein neuer Client ist, nicht eine neue Pipeline. Hier lebt auch der Großteil der Anpassung — die Schichten darunter sind Infrastruktur; diese trägt Ihre Workflows, Ihr Vokabular, das Vertrauen Ihrer Nutzer.
Infrastructure & Operations Layer
Die Fundamentschicht betreibt alles: Compute-Strategie (Cloud, On-Premises oder Hybrid), GPU-Ökonomie, Deployment-Muster, Umgebungsmanagement und die operative Telemetrie, die den Stack zuverlässig hält. Die architektonischen Entscheidungen hier sind Souveränität und Platzierung — Matrix’ Positionierung „Rohdaten verlassen Ihre Infrastruktur nie” ist ein extremer Ausdruck eines realen Trade-offs, den jedes Unternehmen trifft: welche Schichten wo laufen und wer was anfassen darf. Self-Hosting maximiert Kontrolle und Datenresidenz; Managed Services minimieren Betrieb. Die meisten Unternehmen landen bei Hybrid — Datenebene in der eigenen Umgebung, Kontrollebene dort, wo sie effizient ist. Kostenengineering gehört ebenfalls hierher: Modell-Routing-Entscheidungen von oben sind nur nützlich, wenn diese Schicht die realen Kosten jedes Pfades offenlegt.
Governance, Security & Observability Layer
Governance ist keine siebte Schicht — sie ist eine übergreifende Kontrollebene, die in jeder Schicht durchgesetzt wird. Auf der Datenschicht: Zugriffspolicies, Lineage und Residenz. Auf der Modellschicht: Listen zugelassener Provider, PII-Redaktion, Routing-Policies. Auf der Orchestrierungsschicht: Aktionsberechtigungen, menschliche Checkpoints, Sandboxing. Auf der Anwendungsschicht: rollenbasierte Oberflächen und Audit-Logs. Über allem: Evaluierungs-Pipelines, die beweisen, dass ein Modellwechsel vor der Promotion sicher ist, Verhaltensmonitoring in Produktion und Audit-Trails, die rekonstruieren, was das System tat und warum. Frameworks wie das NIST AI Risk Management Framework liefern die risikobasierte Struktur, auf die sich diese Kontrollen abbilden — govern, map, measure, manage — und geben Compliance-Teams ein anerkanntes Vokabular. Das zu merkende Muster: nachträglich angeflanschte Governance scheitert; Governance als Kontrollebene innerhalb jeder Schicht skaliert.
Wie eine Anfrage durch die Schichten fließt
Ein konkretes Beispiel verbindet alles. Ein CFO fragt: „Warum ist die Bruttomarge in Q3 gefallen, und entwirf den Korrekturplan.” Die Application-Schicht empfängt die Anfrage und authentifiziert die Benutzerrolle. Die Orchestration-Schicht plant die Arbeit: Margendaten abrufen, Treiber zerlegen, dann einen Plan entwerfen. Die Model-Abstraction-Schicht routet analytische Schritte an ein fähiges Reasoning-Modell und Entwurfsschritte an ein günstigeres — unter einer Policy, die Nicht-EU-Provider für diese Datenklasse verbietet.
Die Data & Knowledge-Schicht liefert geregelte Datenprodukte über Retrieval-Verträge, mit intakter Lineage. Die Orchestration-Schicht führt Tool-Aufrufe gegen das Finanzsystem in einer Sandbox aus und stellt den Entwurfsplan dann zur CFO-Genehmigung in eine Warteschlange — ein menschlicher Checkpoint vor allem Nachgelagerten. Infrastructure misst Kosten und Latenz bei jedem Schritt. Governance umhüllt alles: jeder Datenzugriff geloggt, jede Aktion berechtigt, jeder Output nachverfolgbar. So sieht „eine Intelligenzschleife” aus, wenn Sie die Architektur besitzen statt sie zu mieten.
Designprinzipien für superintelligenzfähige Systeme
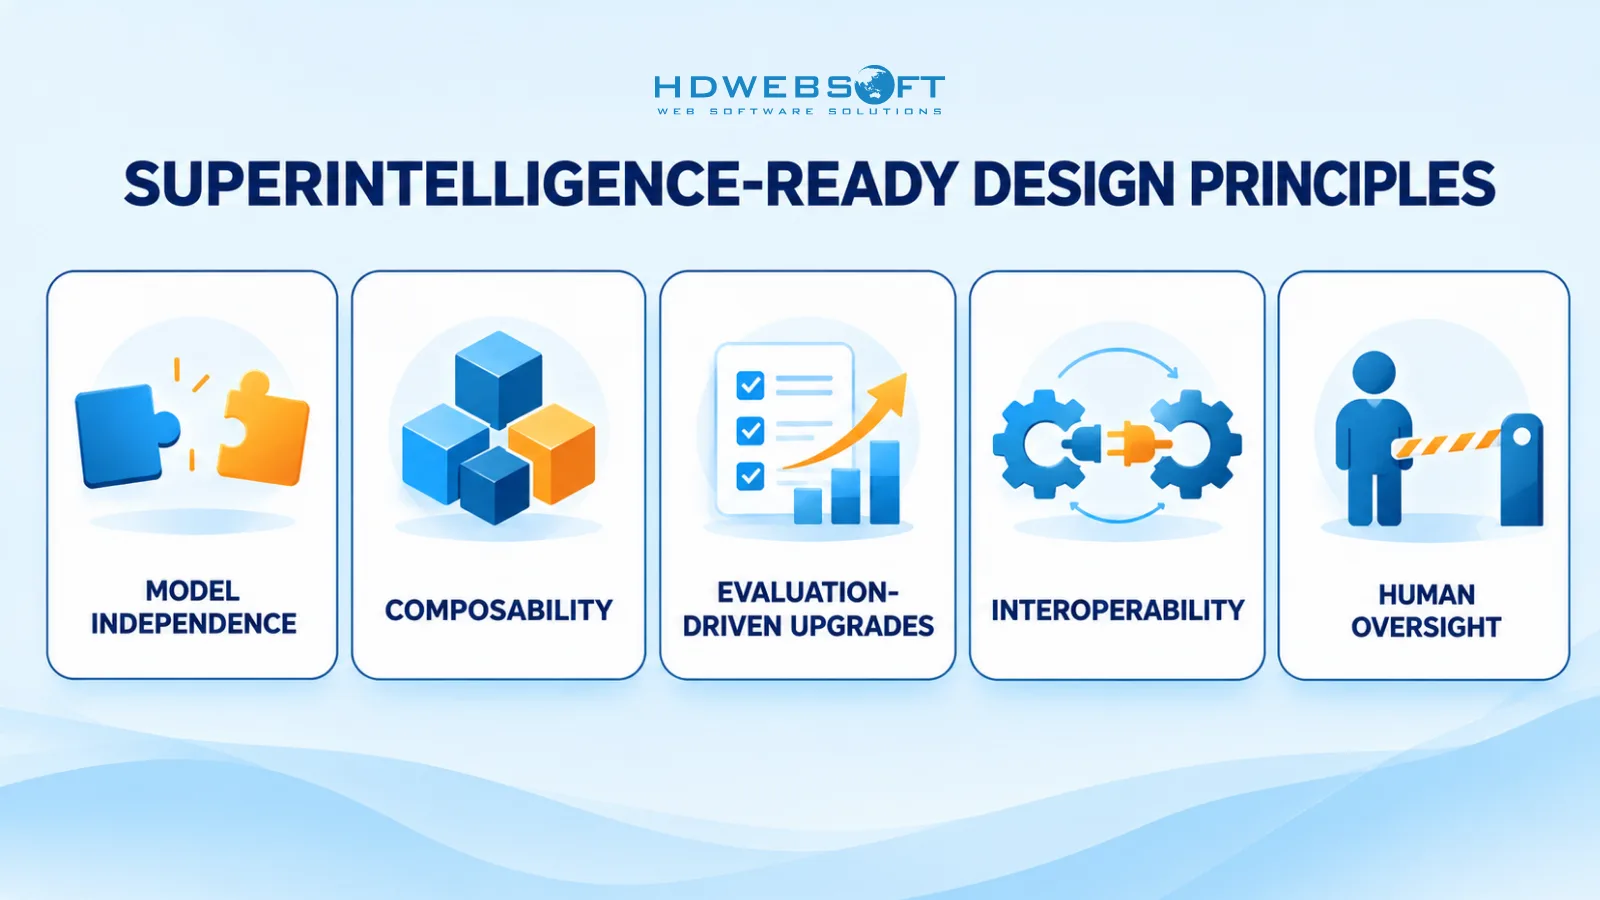
Fünf Prinzipien halten eine Superintelligenz-Architektur für Unternehmen dauerhaft, während sich KI-Fähigkeit aufbaut:
- Modellunabhängigkeit. Kein Provider-Name, keine Prompt-Eigenheit, kein Ausgabeformat in der Geschäftslogik. Modelle sind austauschbare Güter hinter Aliases.
- Komposierbarkeit. Jede Schicht stellt stabile Verträge bereit, sodass jede Komponente — Vector Store, Orchestrator, Gateway — ohne kaskadierende Änderungen austauschbar ist.
- Evaluierungsgetriebene Upgrades. Die Promotion eines neuen Modells oder Agentenverhaltens erfordert das Bestehen einer Eval-Suite auf Ihren realen Workloads, nicht Anbieter-Benchmarks.
- Interoperabilität. Offene APIs und Standardprotokolle zwischen den Schichten; keine proprietäre Kopplung, die Flexibilität in Lock-in verwandelt.
- Menschliche Aufsicht by Design. Genehmigungstore und Eskalationspfade sind architektonische Features mit definierten Schwellen — keine UI-Einstellungen zum späteren Deaktivieren.
Implementierungs-Roadmap: Von KI-Agenten zur zukunftsfähigen Architektur
Die Implementierung einer Superintelligenz-Architektur für Unternehmen ist eine Fähigkeitsprogression, kein Kalenderplan. Jede Phase liefert eigenständigen Wert und hat ein konkretes Abschlusskriterium.
| Phase | Ergebnis | Abgeschlossen wenn |
|---|---|---|
| 1. Architektur- & Datenbewertung | Gap-Analyse: aktuelle KI-Berührungspunkte, Datenreife, Integrationskarte, Zielzustands-Architektur | Dokumentierte Gaps mit priorisierter, freigegebener Zielarchitektur |
| 2. Fundament & Modellabstraktion | Modell-Gateway live mit providerneutralen Aliases; geregelter Datenzugriff für Prioritätsdomänen | Zwei oder mehr Modelle über eine Schnittstelle routbar; geregeltes Retrieval bedient echte Anfragen |
| 3. Agentenorchestrierungs-Pilot | Ein produktionsreifer Agenten-Workflow auf den neuen Schichten — begrenzter Umfang, echte Nutzer | Pilot verarbeitet Live-Traffic mit menschlichen Checkpoints und funktionierender Eval-Baseline |
| 4. Produktionshärtung & Skalierung | Vollständiger Sechs-Schichten-Stack in Produktion; Governance-Kontrollen operativ; Runbooks und Kostenguardrails | Sicherheits- und Audit-Kontrollen bestehen Review; Skalierungsschwellen und Deprecation-Verfahren definiert |
Beginnen Sie dort, wo Ihre derzeitige KI bereits Produktion berührt — ein bestehender Copilot oder Agent ist der natürliche Phase-3-Pilot. Der häufigste Fehlermodus ist Sequenzierung: Teams versuchen Phase 3, bevor Phase 2 existiert, und der „Orchestrierungspilot” kollabiert unter ungemessenem Modellzugriff und ungeregeltem Daten.
Häufige Architekturfehler, die man vermeiden sollte
- Vendor-Label-Abhängigkeit. Eine Plattform kaufen, weil „Superintelligenz” draufsteht, statt ihre Architektur an den sechs Schichten zu messen. Labels sind Marketing; Schichten sind Engineering.
- Fest verdrahtete Modellkopplung. Modellnamen, Prompt-Annahmen oder provider-spezifische Formate in der Geschäftslogik — das Lock-in, das jedes Upgrade zu einem Umbau macht.
- Schwache Governance. Kontrollen nach dem Deployment nachrüsten. Governance, die nicht im Datenfluss jeder Schicht liegt, wird unter Lieferdruck umgangen.
- Fehlende Evaluierungsbaselines. Keine Evals heißt kein objektiver Weg, ein stärkeres Modell zu promoten — Sie frieren entweder auf alter Fähigkeit ein oder promoten auf Glauben.
Fazit
Kein Anbieter kann Ihnen Superintelligenz verkaufen — sie existiert nicht. Was existiert, ist eine sich schnell verbessernde Frontier und eine echte architektonische Wahl: ein System bauen, dessen Schichten diese Verbesserung absorbieren können, oder an das gekoppelt bleiben, was Sie zuerst integriert haben. Eine superintelligenzfähige Architektur — geregelte Daten, abstrahierte Modelle, orchestrierte Agenten, beobachtbare Infrastruktur — ist, wie Unternehmen bereit bleiben, ohne auf eine Timeline zu wetten. HDWEBSOFT entwirft und baut genau diese Klasse von Enterprise-KI-Systemen über unsere KI-Entwicklungsdienstleistungen, und wenn Sie diesen Bauplan auf Ihren eigenen Stack abbilden wollen, kontaktieren Sie HDWEBSOFT, um Ihre Architektur-Roadmap zu besprechen.
FAQ
Was ist eine Superintelligenz-Architektur für Unternehmen?
Eine Superintelligenz-Architektur für Unternehmen ist ein vorgeschlagenes, anbieterneutrales Referenzmodell für Enterprise-KI-Systeme. Sie organisiert Daten, Modellzugriff, Agentenorchestrierung, Anwendungen, Infrastruktur und übergreifende Governance in Schichten, die stärkere KI-Modelle aufnehmen können, ohne neu gebaut zu werden. Es ist ein Architekturansatz, kein zertifizierter Industriestandard.
Liefern Enterprise-SI-Plattformen wie Matrix und Unum echte Superintelligenz?
Nein. Künstliche Superintelligenz existiert heute nicht, und kein Anbieterprodukt ist verifiziert, sie zu liefern. Plattformen wie Matrix und ML6s Unum verwenden den Begriff als Positionierung für integrierte Enterprise-KI-Systeme, die Datenzugriff, Reasoning und Ausführung vereinen. Bewerten Sie sie anhand von Architektur und Governance, nicht am Label.
Was ist der Unterschied zwischen einer Modellabstraktionsschicht und einer Agentenorchestrierungsschicht?
Eine Modellabstraktionsschicht normalisiert den Zugriff auf mehrere KI-Modelle über eine einzige Schnittstelle und entscheidet, welches Modell jede Anfrage bearbeitet. Eine Agentenorchestrierungsschicht liegt darüber und koordiniert mehrstufige Arbeit: Planung, Tool-Aufrufe, Integration von Unternehmenssystemen und menschliche Freigabepunkte.
Wie funktioniert Governance in einer superintelligenzfähigen Architektur?
Governance wirkt als schichtübergreifende Kontrollen statt als separates Modul. Sie umfasst Identitäts- und Zugriffsgrenzen, Richtliniendurchsetzung am Modell-Gateway, Audit-Trails für Agentenaktionen, Evaluierungs-Pipelines für Modellwechsel und Überwachung des Systemverhaltens in der Produktion.
Wie sollten Unternehmen die Implementierung dieser Architektur phasen?
Eine praktische Reihenfolge ist: Architektur- und Datenbewertung, Fundament und Modellabstraktion, ein Pilot für Agentenorchestrierung, dann Produktionshärtung und Skalierung. Jede Phase hat ein konkretes Ergebnis und ein Abschlusskriterium, sodass die Architektur schrittweise reift — ohne riskanten Big-Bang-Umbau.