Le déploiement d’agents IA est l’étape où la plupart des pilotes prometteurs s’effondrent. Une démo qui répond à des questions dans un environnement contrôlé survit rarement au contact des utilisateurs réels, des données réelles et des budgets réels. Gartner prévoit que plus de 40 % des projets d’IA agentique seront annulés d’ici fin 2027, avec l’augmentation des coûts et l’insuffisance des contrôles de risque parmi les principales raisons. L’écart entre le pilote et l’IA agentique en production n’est pas uniquement un problème technologique — c’est un problème de discipline d’ingénierie que peu d’équipes anticipent avant de toucher la production.
Les pilotes réussissent parce qu’ils s’exécutent dans des environnements contrôlés avec peu d’utilisateurs, peu de cas limites et aucune pression de coût réelle. La production expose les agents à des pics de trafic, des entrées ambiguës, du contenu adversarial et des contraintes budgétaires que les pilotes ne simulent jamais. Sans garde-fous, observabilité et contrôles de coûts conçus pour la production dès le départ, les agents dérivent, ralentissent, brûlent des tokens et font fuiter des données. Cet article détaille les quatre goulots d’étranglement techniques qui brisent le déploiement d’agents IA en production — dérive de prompt, latence d’API, coût en tokens et failles de sécurité — et explique comment les garde-fous en couches, la mise en cache intelligente du contexte et l’observabilité structurée aident les équipes à déployer des agents IA en production de manière fiable.
Points clés à retenir
- Gartner prévoit que plus de 40 % des projets d’IA agentique seront annulés d’ici fin 2027, avec l’augmentation des coûts et l’insuffisance des contrôles de risque parmi les principales raisons.
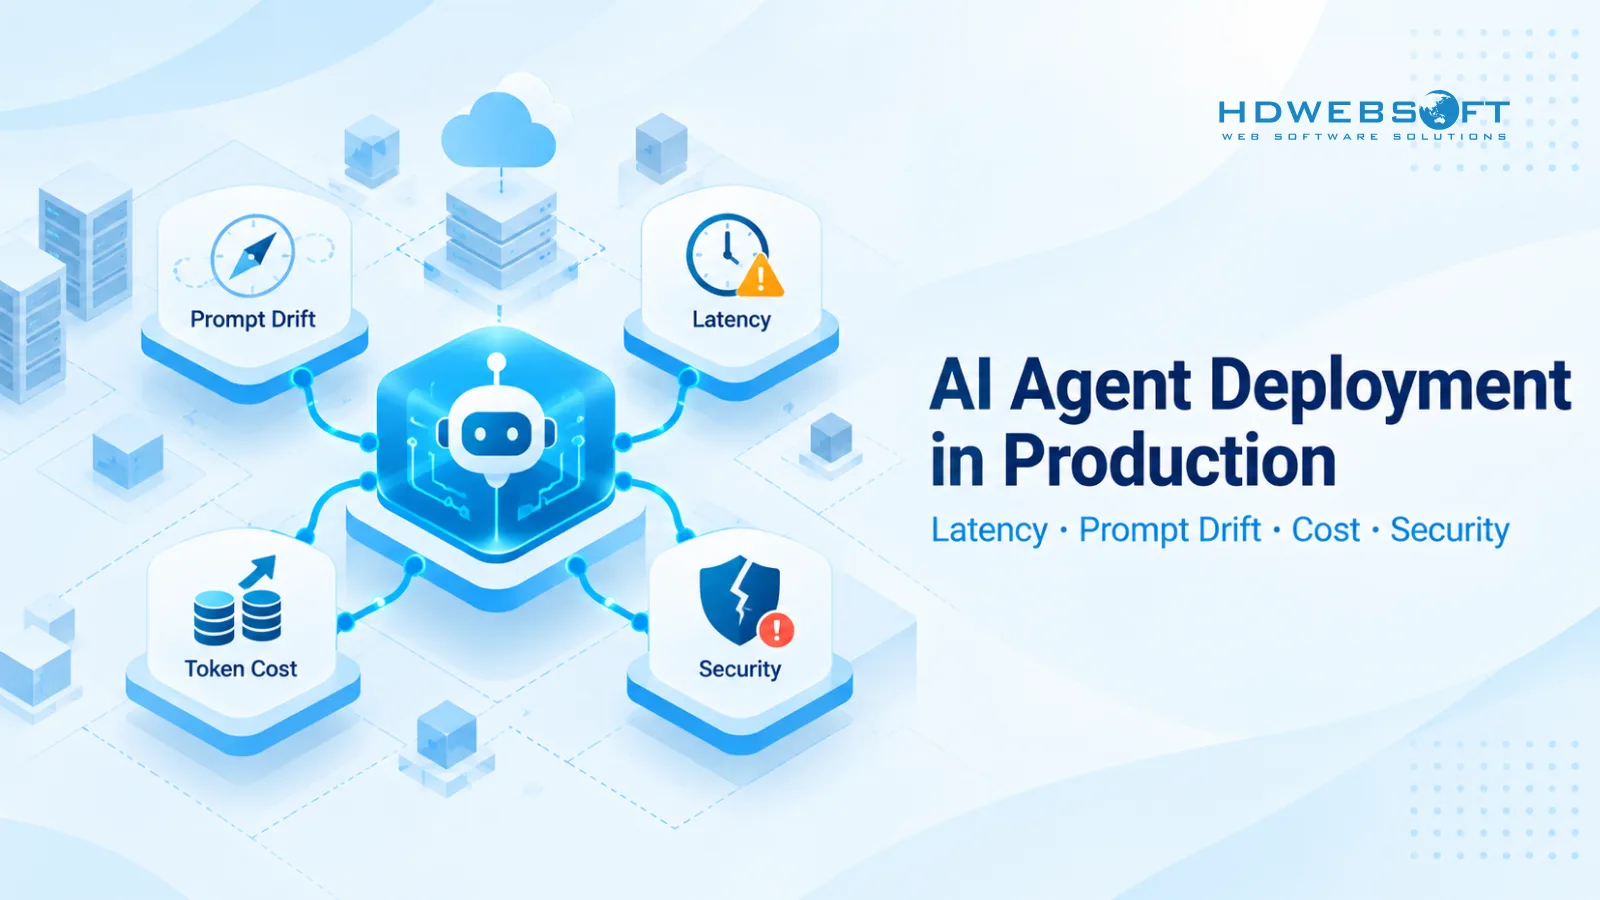
- Quatre goulots d’étranglement techniques brisent les déploiements en production : dérive de prompt, latence d’API, coût en tokens et failles de sécurité.
- Les garde-fous en couches — combinant règles déterministes, vérifications basées sur des modèles, contrôle d’accès et approbation humaine — forment l’épine dorsale de la fiabilité des agents IA.
- Les boucles multi-agents peuvent faire augmenter le coût en tokens rapidement ou de manière super-linéaire en raison du contexte répété, des retries et des embranchements ; les limites de boucles, le routage de modèles et la mise en cache du contexte sont des leviers essentiels.
- Une prévision des coûts en tokens avec des seuils budgétaires et une politique d’arrêt ou d’escalade est un prérequis au déploiement en production, pas une réflexion après coup.
- L’observabilité des agents IA nécessite une rédaction, une classification des données et une politique de rétention — ne journalisez jamais les prompts complets ou le contexte lorsque des PII ou des secrets sont présents.
Ce que signifie réellement le déploiement d’agents IA en production
Le déploiement d’agents IA en production ne consiste pas simplement à exécuter un modèle sur un serveur. Il s’agit d’opérer un système autonome qui raisonne, appelle des outils et prend des actions sous une charge réelle, avec des utilisateurs réels et des conséquences réelles. La production signifie que le système doit rester fiable, sûr et maîtrisé en coût lorsque le trafic augmente, que les entrées deviennent désordonnées et que les budgets se resserrent.
Pilote vs production : l’écart qui fait mourir les projets
L’écart entre le pilote et la production est l’endroit où la plupart des projets meurent. Les pilotes s’exécutent dans des environnements contrôlés avec peu d’utilisateurs, peu de cas limites et aucune pression de coût réelle. La production expose les agents à des pics de trafic, des entrées ambiguës, du contenu adversarial et des contraintes budgétaires que les pilotes ne simulent jamais.
| Dimension | Pilote | Production |
|---|---|---|
| Utilisateurs | Une poignée de testeurs | Des milliers ou plus, schémas imprévisibles |
| Cas limites | Sélectionnés, limités | Illimités, adversariaux |
| SLA | Au mieux | Contractuel ou lié aux attentes utilisateurs |
| Budget | Tolérant | Limites strictes, alertes de coût, escalade |
| Observabilité | Inspection manuelle | Tableaux de bord en temps réel, alertes, pistes d’audit |
| Rollback | Redémarrer la démo | Rollback contrôlé, valeurs par défaut sûres |
Les équipes qui traitent les pilotes comme des expériences plutôt que des prototypes de production réussissent rarement à passer à l’échelle. Les équipes les plus performantes conçoivent pour la production dès le départ, en intégrant les garde-fous, l’observabilité et les contrôles de coûts comme des exigences fondamentales plutôt que comme des réflexions après coup.
Les quatre goulots d’étranglement techniques qui brisent les déploiements en production
Lorsque les agents passent du pilote à la production, quatre goulots d’étranglement techniques expliquent la majorité des échecs de déploiement d’agents IA :
- Dérive de prompt — les agents perdent progressivement leur adhésion aux instructions originales à mesure que le contexte s’étend et que les sorties intermédiaires s’accumulent.
- Latence d’API — les appels séquentiels à travers l’inférence LLM, les appels d’outils et l’orchestration accumulent une latence qui brise les flux en temps réel.
- Coût en tokens — les boucles multi-agents, les retries et les embranchements font augmenter l’utilisation des tokens rapidement ou de manière super-linéaire.
- Failles de sécurité — injection de prompt indirecte, appels d’outils non sûrs et risques d’exfiltration de données que la sécurité applicative traditionnelle ne couvre pas pleinement.
Chaque goulot d’étranglement est prévisible, diagnostiquable et traitable — mais seulement si les équipes s’y préparent avant la production, pas après. Pour le déploiement d’agents IA en entreprise, ces quatre problèmes expliquent la majorité des échecs en production.
Goulot d’étranglement 1 : la dérive de prompt érode la fiabilité des agents
La dérive de prompt, également appelée dérive de contexte ou d’instructions, est la perte progressive de l’adhésion aux instructions à mesure qu’un agent traite des conversations plus longues ou des boucles multi-tours. L’agent commence aligné avec ses instructions originales, mais à mesure que l’interaction s’étend, ses sorties s’écartent de plus en plus du comportement attendu.
Ce qui cause la dérive de prompt dans les boucles d’agents multi-tours
Plusieurs mécanismes provoquent la dérive de prompt dans le déploiement d’agents IA en production :
- Croissance du contexte : à mesure qu’une conversation ou une boucle d’agent s’étend, la fenêtre de contexte se remplit de sorties intermédiaires, de résultats d’appels d’outils et de messages utilisateurs. Le prompt système original et les contraintes occupent une part décroissante de l’attention du modèle.
- Troncature : lorsque le contexte dépasse la fenêtre du modèle, le contenu plus ancien — souvent y compris des instructions critiques — est tronqué ou résumé, perdant en fidélité.
- Instructions conflictuelles : de nouvelles instructions provenant de sorties d’outils, de messages utilisateurs ou d’autres agents peuvent entrer en conflit avec le prompt système original, et le modèle peut suivre l’instruction la plus récente sans règle de priorité explicite.
- Mémoire obsolète : les informations stockées en mémoire ou dans des systèmes de retrieval peuvent devenir obsolètes, amenant l’agent à agir sur un contexte qui ne reflète plus la réalité.
- Sorties intermédiaires : les sorties des étapes précédentes dans une chaîne multi-agents influencent le raisonnement des étapes ultérieures. Si une sortie précoce est subtilement erronée, l’erreur se propage en aval.
Aucun de ces mécanismes ne nécessite que le modèle « préfère le contexte récent » — ils émergent des réalités pratiques de la gestion du contexte, de la troncature et du volume considérable de contenu intermédiaire que les agents en production génèrent.
Comment la dérive de prompt dégrade la qualité des sorties dans le temps
Les conséquences de la dérive se cumulent au fil des longues sessions et des chaînes multi-agents, sapant la fiabilité des agents IA. Les agents commencent à halluciner, à appeler les mauvais outils, à violer des contraintes ou à perdre de vue l’objectif initial. Dans les boucles multi-agents, la dérive est particulièrement dangereuse : l’agent A transmet le contexte à l’agent B, qui le transmet à l’agent C, et chaque passage introduit une nouvelle opportunité de perte d’instructions.
Dans les journaux de production, la dérive se manifeste par une dégradation subtile de la qualité, facile à manquer. Les sorties peuvent encore sembler plausibles en surface, mais elles ne satisfont plus les contraintes originales — un agent de support client commence à omettre des avertissements obligatoires, un agent d’analyse de données commence à omettre les intervalles de confiance, ou un agent de codage cesse de suivre le guide de style de l’équipe. Sans métriques de détection de dérive, ces régressions passent souvent inaperçues jusqu’à ce qu’un utilisateur se plaigne ou qu’un audit révèle l’écart.
Détecter et contenir la dérive de prompt
Contrôler la dérive nécessite à la fois la prévention et la détection. Les techniques de prévention incluent :
- Réinjection périodique : réinjecter le prompt système et les contraintes critiques à intervalles réguliers, plutôt que de compter sur la visibilité du prompt original tout au long d’une longue session.
- Gestion de la fenêtre de contexte : résumer ou élaguer le contenu intermédiaire pour maintenir les instructions originales proéminentes. Ne conserver que ce dont la prochaine étape a besoin.
- Points de contrôle déterministes : valider la sortie de l’agent à chaque tour par rapport aux contraintes originales, et non seulement à la fin de la session.
La détection nécessite plusieurs signaux, pas une seule métrique. Une détection efficace de la dérive combine :
- Taux de réussite des tâches : l’agent accomplit-il toujours sa tâche correctement ?
- Taux de violation des contraintes : à quelle fréquence l’agent enfreint-il des règles explicites ?
- Correction des appels d’outils : les bons outils sont-ils appelés avec les bons paramètres ?
- Évaluations de régression : exécuter périodiquement une suite d’évaluation fixe pour détecter les régressions de qualité par rapport à une référence connue.
- Distance sémantique : mesurer à quel point les sorties se sont écartées du comportement attendu, comme un signal parmi d’autres.
Aucune métrique unique ne détecte toute la dérive. Les équipes qui ne s’appuient que sur la distance sémantique ou uniquement sur le taux de réussite des tâches manqueront des régressions que les autres signaux détectent. Une approche multi-signaux est le seul moyen fiable de détecter la dérive dans le déploiement d’agents IA en production.
Goulot d’étranglement 2 : la latence d’API brise les flux d’agents en temps réel
La latence est le second goulot d’étranglement qui brise les déploiements en production. Les flux d’agents enchaînent plusieurs appels — inférence LLM, exécution d’outils, retrieval, orchestration — et la latence s’accumule à chaque étape séquentielle. Lorsque des embranchements ou des retries entrent en jeu, le temps de réponse total peut augmenter fortement, rendant le déploiement d’agents IA en production plus difficile à maintenir dans des temps de réponse acceptables.
Où se cache la latence dans les chaînes d’appels d’agents
La latence dans le déploiement d’agents IA provient de plusieurs sources :
- Inférence LLM : le temps de génération propre au modèle, qui évolue avec la longueur de sortie et la taille du modèle.
- Latence des appels d’outils : API externes, bases de données et services que l’agent appelle, chacun ajoutant un temps d’aller-retour.
- Surcoût du retrieval RAG : le retrieval, l’embedding et le classement ajoutent du temps avant même que le modèle ne commence à générer.
- Orchestration multi-agents : la coordination entre agents — routage, passages, agrégation des résultats — ajoute une surcharge par-dessus la latence des appels individuels.
- Sérialisation et désérialisation : la conversion entre formats pour chaque appel ajoute de petits délais cumulatifs.
Dans une boucle multi-agents, la latence s’accumule à travers les appels séquentiels. Si chaque étape prend quelques secondes et que la boucle comporte plusieurs étapes, le temps de réponse total peut atteindre des dizaines de secondes. Les embranchements — où un agent essaie plusieurs approches — et les retries — où un agent retente une étape échouée — peuvent pousser la latence totale encore plus haut. À titre d’exemple illustratif, un seul appel d’agent peut prendre de 3 à 8 secondes, et une chaîne multi-agents de plusieurs étapes peut atteindre 30 à 60 secondes. Ces chiffres sont des exemples, non universels — la latence réelle dépend du choix du modèle, des performances des outils et de la conception de l’orchestration.
Budgets de latence pour les agents IA en production
Un budget de latence est le temps de réponse maximal acceptable pour une tâche donnée, alloué à chaque étape de la chaîne d’agents. Sans budget, les équipes n’ont aucun moyen de décider quand la latence est acceptable ou quand l’architecture doit changer.
Exemples de budgets de latence — ceux-ci sont illustratifs, non des SLA universels :
- Interactions en temps réel (ex. : chat, support en direct) : moins de 5 secondes
- Tâches quasi temps réel (ex. : analyse de données, génération de rapports) : moins de 30 secondes
- Tâches en arrière-plan (ex. : traitement par lots, agents planifiés) : moins de 5 minutes
Une fois le budget défini, allouez-le à travers les étapes de la chaîne d’agents. Si le total estimé dépasse le budget, l’architecture doit changer — paralléliser les appels d’outils, raccourcir le raisonnement, router les tâches simples vers des modèles plus rapides, ou déplacer le travail vers un traitement en arrière-plan.
Réduire la latence sans sacrifier la profondeur de raisonnement
Plusieurs techniques réduisent la latence sans forcer l’agent à raisonner moins profondément :
- Réponses en streaming : diffuser la sortie vers l’utilisateur au fur et à mesure de sa génération, afin que l’utilisateur voie la progression au lieu d’attendre une réponse complète.
- Routage de modèles : router les tâches simples vers des modèles plus petits et plus rapides et réserver les grands modèles aux tâches nécessitant un raisonnement plus approfondi. Les décisions de routage doivent se fonder sur la complexité de la tâche, le risque et les exigences de qualité — non sur un ratio fixe.
- Appels d’outils en parallèle : exécuter les appels d’outils indépendants en parallèle plutôt que séquentiellement, réduisant le temps d’attente total.
- Mise en cache : mettre en cache les sorties LLM et les résultats d’outils pour des entrées similaires afin d’éviter les appels redondants.
- Exécution spéculative (optionnel, avancé) : pour les étapes aux schémas prévisibles, exécuter les étapes suivantes probables avant que l’étape actuelle ne soit terminée.
La génération augmentée par retrieval illustre bien le compromis de latence. Le RAG ajoute une surcharge de retrieval, mais un bon ancrage peut réduire le nombre de retries et de boucles de raisonnement dont un agent a besoin, ce qui peut abaisser la latence totale. L’effet net dépend de l’implémentation — le RAG ne réduit pas toujours la latence, mais un retrieval bien conçu le peut.
Goulot d’étranglement 3 : l’explosion du coût en tokens dans les boucles multi-agents
Le coût en tokens est le goulot d’étranglement qui surprend les équipes. Les pilotes s’exécutent avec peu d’utilisateurs et peu de cas limites, donc l’utilisation des tokens reste gérable. La production met l’utilisation à l’échelle, et les boucles multi-agents amplifient le coût de manières que les données de pilote n’ont jamais révélées. Sans prévision des coûts, le déploiement d’agents IA en production peut dépasser les budgets avant que quiconque ne s’en aperçoive.
Pourquoi les boucles multi-agents brûlent des tokens de manière imprévisible
Les boucles multi-agents font augmenter le coût en tokens rapidement ou de manière super-linéaire dans le déploiement d’agents IA en raison de plusieurs facteurs :
- Contexte répété : chaque tour d’une boucle renvoie le contexte — prompt système, historique de conversation, résultats d’outils — au modèle. À mesure que le contexte s’étend, chaque tour coûte plus de tokens que le précédent.
- Retries : lorsqu’un agent produit une sortie invalide, la boucle réessaie, renvoyant le contexte complet plus le retour d’erreur.
- Embranchements : lorsqu’un agent essaie plusieurs approches, chaque branche consomme des tokens, et seule la sortie d’une branche peut être utilisée.
- Échanges multi-agents : les agents communiquant entre eux consomment des tokens pour chaque message, ajoutant une surcharge que les systèmes à agent unique n’ont pas.
À titre d’exemple illustratif, une session pilote peut utiliser 5 000 tokens. À 1 000 sessions par jour en production, cela devient 5 millions de tokens par jour — et c’est avant de prendre en compte les retries, les embranchements et la croissance du contexte que le trafic de production introduit. Le coût peut augmenter rapidement ou de manière super-linéaire, non linéairement, lorsque ces facteurs se combinent.
Leviers de coût : mise en cache du contexte, routage de modèles, limites de boucles
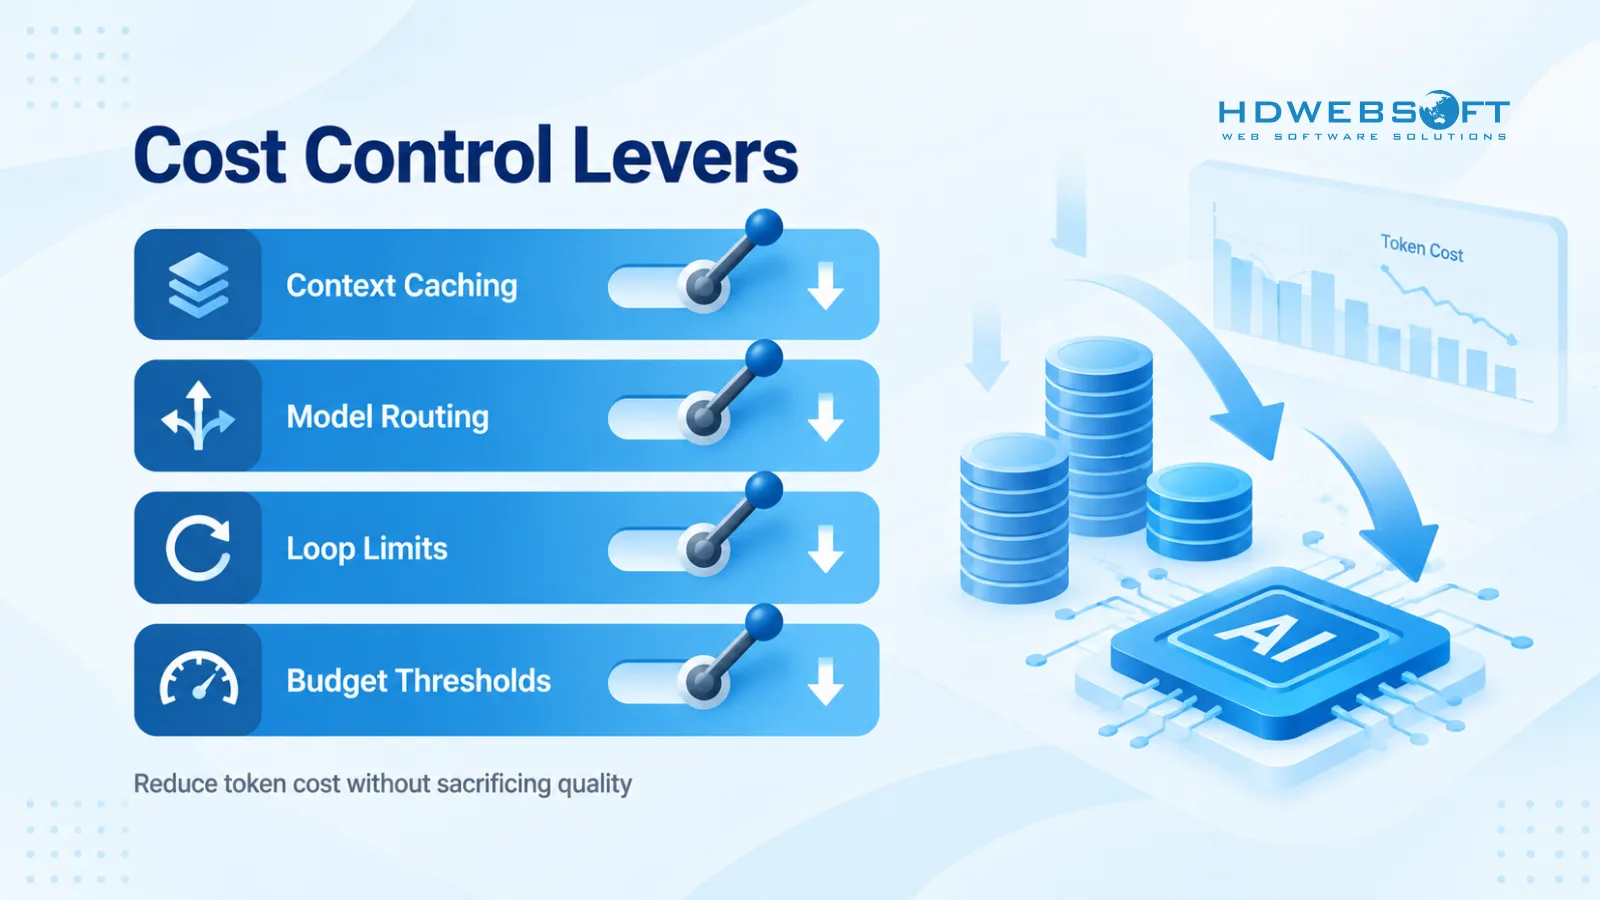
Plusieurs leviers contrôlent le coût en tokens en production :
- Mise en cache du contexte : mettre en cache les préfixes de prompts, les résultats d’outils et les sorties LLM pour des entrées similaires afin d’éviter de renvoyer ou de régénérer le même contenu.
- Routage de modèles : router les tâches vers le plus petit modèle répondant aux exigences de qualité. Les décisions de routage doivent se fonder sur la complexité de la tâche, le risque et les exigences de qualité — non sur un ratio fixe comme 80 % petit et 20 % grand.
- Limites de boucles : définir un nombre maximal de tours par session. Lorsque la limite est atteinte, terminer la boucle et escalader vers un humain ou un chemin de repli.
- Compression de prompt : résumer ou compresser le contexte au lieu de renvoyer l’historique complet à chaque tour.
- Traitement par lots : déplacer les tâches non temps réel vers un traitement par lots, où le coût peut être optimisé sans pression de latence.
Construire une prévision des coûts en tokens avant de déployer
Une prévision des coûts en tokens est un prérequis au déploiement d’agents IA en production, pas une réflexion après coup. Construisez la prévision avant le lancement :
- Estimer les tokens moyens par session : inclure le prompt système, le contexte, les résultats d’outils et la sortie. Prendre en compte les retries et les embranchements.
- Multiplier par les sessions attendues par jour : utiliser un volume de production réaliste, non un volume de pilote.
- Appliquer la tarification des modèles : calculer le coût quotidien et mensuel aux prix actuels des tokens.
- Ajouter une marge pour la variance : le trafic de production est imprévisible ; ajouter une marge pour les pics inattendus.
- Séparer les coûts fixes et variables : les coûts fixes incluent les prompts système et le contexte de base ; les coûts variables évoluent avec les tours, les appels d’outils et les retries.
Une fois la prévision en place, définissez des seuils budgétaires avec une politique d’arrêt ou d’escalade. Lorsque les dépenses franchissent un seuil, le système peut arrêter l’agent, escalader vers un humain, basculer vers un modèle moins cher ou alerter l’équipe — la politique dépend du cas d’usage. L’essentiel est d’avoir une politique avant le lancement, pas de découvrir le dépassement budgétaire après l’arrivée de la facture.
Goulot d’étranglement 4 : failles de sécurité et sorties d’agents non contrôlées
La sécurité est le quatrième goulot d’étranglement, et c’est celui pour lequel les équipes de sécurité applicative traditionnelle sont le moins préparées. Les agents ne se contentent pas de générer du texte — ils appellent des outils, accèdent à des données et prennent des actions, ce qui introduit des menaces que les contrôles AppSec classiques n’ont pas été conçus pour traiter. Déployer des agents IA en production sans garde-fous spécifiques aux agents expose les organisations aux injections, à l’exfiltration de données et aux appels d’outils non sûrs.
Injection de prompt indirecte et appels d’outils non sûrs
L’injection de prompt indirecte est le principal risque de sécurité pour les agents en production et une cause majeure d’échec de déploiement d’agents IA. Contrairement à l’injection directe, où un attaquant manipule le prompt directement, l’injection indirecte cache des instructions malveillantes dans des données que l’agent récupère ou traite — contenu généré par les utilisateurs, documents récupérés, sorties d’outils ou pages web externes.
Lorsqu’un agent lit ce contenu, il peut suivre les instructions injectées comme si elles étaient légitimes. Un agent lisant un e-mail client contenant des instructions cachées pourrait faire fuiter des données, appeler un outil sensible ou modifier un enregistrement qu’il ne devrait pas toucher. Parce que l’injection provient des données, non du prompt lui-même, la seule validation des entrées ne la détecte pas.
Le risque est amplifié lorsque les agents ont des capacités d’appel d’outils. Un agent capable d’envoyer des e-mails, de modifier des bases de données ou d’initier des paiements présente bien plus de risque qu’un agent qui ne génère que du texte. Chaque appel d’outil est une action potentielle aux conséquences réelles, et des appels d’outils non contrôlés peuvent causer des dégâts avant que quiconque ne s’en aperçoive.
Risques d’exfiltration de données dans les flux d’agents
Les agents ont souvent accès à plusieurs sources de données — bases de données, API, espaces de stockage de fichiers — et cet accès crée un risque d’exfiltration. Un agent capable de lire des données sensibles et d’envoyer des e-mails ou d’appeler des API externes peut exfiltrer ces données via ses sorties ou ses appels d’outils.
Les systèmes multi-agents amplifient le risque. L’agent A peut avoir un accès étendu aux données car ses tâches l’exigent, tandis que l’agent B a un périmètre plus restreint. Si l’agent B peut demander des données à l’agent A, et que les sorties de l’agent B circulent vers un canal externe, les données peuvent transiter d’un agent à fort accès vers une destination externe sans qu’aucun des deux agents ne viole explicitement son propre périmètre.
Les mesures d’atténuation incluent :
- Principe du moindre privilège : donner à chaque agent l’accès minimal aux données requis par ses tâches, aussi étroitement limité que possible.
- Filtrage des sorties : valider les sorties de l’agent avant qu’elles n’atteignent les canaux externes, en bloquant le contenu contenant des données sensibles.
- Journalisation d’audit : journaliser chaque appel d’outil, ses paramètres et son résultat, afin que les tentatives d’exfiltration soient traçables.
Pourquoi la sécurité applicative traditionnelle est nécessaire mais non suffisante
La sécurité applicative traditionnelle reste nécessaire mais n’est pas suffisante pour les risques spécifiques aux agents. Les WAF, la validation des entrées, l’authentification et l’autorisation comptent toujours — ils sont les fondations. Mais ils ne couvrent pas les menaces que les agents introduisent :
- L’injection de prompt n’est pas une injection de code traditionnelle. Elle exploite le comportement de suivi d’instructions du modèle, pas une vulnérabilité de code, donc les règles WAF et l’assainissement des entrées ne la détectent pas.
- Les agents décident quels outils appeler dynamiquement. Il n’y a pas de route fixe à filtrer — le raisonnement propre de l’agent détermine l’action, et les contrôles de sécurité traditionnels ne peuvent pas prévoir ou filtrer chaque chemin d’appel d’outil possible.
- Les sorties d’agents peuvent contenir des données sensibles fuitées via les journaux, les e-mails ou les appels d’API externes, même lorsque le magasin de données sous-jacent est correctement sécurisé.
Des garde-fous spécifiques aux agents sont requis par-dessus l’AppSec traditionnelle : validation des sorties, listes autorisées d’appels d’outils, approbation humaine pour les actions sensibles et pistes d’audit complètes. Pour une analyse approfondie des modèles de menaces et des mesures d’atténuation propres aux LLM, consultez la sécurité LLM pour l’IA agentique.
Comment déployer des agents IA en production de manière fiable
Traiter les quatre goulots d’étranglement nécessite une approche structurée combinant garde-fous, mise en cache et observabilité. Chaque composant traite un ou plusieurs goulots d’étranglement, et ensemble ils forment les fondations de production que les pilotes n’ont pas. Pour les équipes qui apprennent à déployer des agents IA en production, les composants suivants sont essentiels.
Garde-fous en couches : l’épine dorsale de la fiabilité des agents
Les garde-fous en couches combinent plusieurs types de contrôles, chacun traitant différents modes de défaillance :
- Contrôles déterministes : validation de schéma pour les sorties, listes autorisées d’appels d’outils, limites de boucles et vérifications de permissions. Ce sont des règles qui ne dépendent pas du modèle — elles appliquent des contraintes quel que soit ce que l’agent génère, formant la première couche de fiabilité des agents IA.
- Vérifications basées sur des modèles ou des classificateurs : filtres de contenu, détecteurs d’hallucinations et classificateurs de sorties qui détectent les problèmes que les règles déterministes ne peuvent pas. Ils utilisent des modèles ou classificateurs plus petits pour évaluer les sorties de l’agent avant qu’elles n’atteignent les utilisateurs ou les outils.
- Contrôle d’accès : principe du moindre privilège pour chaque agent, permissions d’outils limitées et restrictions d’accès aux données liées au rôle de l’agent.
- Approbation humaine : pour les actions sensibles — paiements, modifications de données, communications externes — exiger une approbation humaine explicite avant que l’agent n’exécute l’action.
Aucune couche unique n’est suffisante. Les règles déterministes détectent les violations de schéma et les appels d’outils non autorisés mais manquent les problèmes de contenu subtils. Les vérifications basées sur des modèles détectent les problèmes de contenu mais peuvent elles-mêmes être vulnérables aux entrées adversariales. L’approbation humaine intercepte les actions à haut risque mais ne passe pas à l’échelle pour chaque décision. La force des garde-fous en couches est que chaque couche couvre les lacunes que les autres laissent, rendant le déploiement d’agents IA en production bien plus fiable qu’aucun contrôle unique.
Mise en cache intelligente du contexte pour réduire latence et coût ensemble
La mise en cache du contexte traite la latence et le coût simultanément en réduisant le travail redondant :
- Mettre en cache les prompts système et le contexte stable : éviter de renvoyer le même préfixe de prompt à chaque tour.
- Mettre en cache les résultats d’outils : si plusieurs tours nécessitent la même sortie d’outil, la mettre en cache au lieu de rappeler l’outil.
- Cache sémantique pour les sorties LLM : pour des entrées similaires, retourner une sortie mise en cache au lieu de régénérer.
La mise en cache introduit ses propres risques que les équipes de production doivent gérer :
- Invalidation du cache : lorsque les données sous-jacentes changent, les résultats mis en cache doivent être invalidés ou rafraîchis. Un cache périmé conduit à des réponses erronées.
- Isolation par tenant : ne jamais servir les résultats mis en cache d’un tenant à un autre. Les clés de cache doivent inclure le contexte du tenant.
- Fraîcheur des données : définir des TTL qui correspondent à la fréquence de mise à jour des données. Un cache trop périmé est pire qu’absence de cache.
- Sorties sensibles ou à haut risque : ne pas mettre en cache les sorties contenant des PII, des décisions financières, des conseils médicaux ou d’autres contenus sensibles, à moins que la couche de cache n’ait des contrôles de sécurité équivalents. En cas de doute, ne pas mettre en cache.
Observabilité et évaluation comme exigences de production
L’observabilité des agents IA diffère de l’observabilité applicative traditionnelle. Les agents prennent des décisions dynamiques, appellent des outils externes et produisent des sorties difficiles à valider par de simples contrôles réussite/échec. Le déploiement d’agents IA en production nécessite une observabilité couvrant :
- Décisions d’outils : quels outils ont été appelés, avec quels paramètres, et quels résultats sont revenus.
- Décisions de routage : quel modèle ou branche a été sélectionné et pourquoi.
- État intermédiaire : la sortie de chaque étape de la chaîne d’agents, non la chaîne de pensée cachée du modèle.
- Métadonnées de modèle et d’outils : version du modèle, version de l’outil et paramètres utilisés, afin que les régressions puissent être tracées à des versions spécifiques.
- Résultats des garde-fous : si chaque couche a réussi ou échoué, et la raison du rejet lorsqu’un garde-fou bloque une action.
- Traces de latence et de coût : décomposition du temps et du coût en tokens par étape, afin que les goulots d’étranglement soient visibles.
- Résultat final : le résultat final du travail de l’agent, avec un statut de succès ou d’échec.
La rédaction, la classification des données et la politique de rétention sont obligatoires. Ne jamais journaliser les prompts complets ou le contexte complet lorsque des PII ou des secrets peuvent être présents. Classifier les données avant la journalisation, rédiger les champs sensibles et appliquer des limites de rétention afin que les journaux ne deviennent pas un passif. Ne pas tenter de journaliser la chaîne de pensée cachée du modèle — elle n’est pas disponible de manière fiable, et la forcer peut dégrader la qualité des sorties.
L’évaluation va au-delà du test de la sortie finale. Testez chaque étape de la chaîne d’agents, afin que les régressions soient détectées à l’étape où elles naissent plutôt qu’uniquement à la fin. Définissez des alertes pour les métriques de dérive, les dépassements de budget de latence, les seuils de coût et les taux de rejet des garde-fous, afin que les problèmes apparaissent avant les utilisateurs.
Ancrer le retrieval pour réduire dérive et coût
La génération augmentée par retrieval, bien implémentée, peut réduire à la fois la dérive et le coût. Un ancrage précis donne à l’agent un contexte pertinent et à jour, ce qui réduit le nombre de tours de raisonnement nécessaires et la probabilité d’hallucination. Moins de tours signifie moins de tokens et une latence plus faible. L’ancrage renforce aussi les instructions originales en fournissant un contexte concret récupéré qui ancre le raisonnement de l’agent.
Le RAG n’est pas une solution gratuite — il ajoute une surcharge de retrieval et introduit ses propres modes de défaillance si la qualité du retrieval est médiocre. Mais un retrieval bien conçu peut réduire les retries et les boucles de raisonnement, produisant un bénéfice net pour la dérive, le coût et la latence. Pour une analyse approfondie de l’orchestration du retrieval, de l’évaluation et de l’ancrage, consultez l’orchestration du retrieval et l’ancrage dans le RAG agentique.
Comment HDWEBSOFT réduit les risques des lancements d’agents IA en production
HDWEBSOFT aide les équipes à passer des agents IA du pilote à la production via un cadre de lancement structuré pour des déploiements bien délimités. Le cadre n’est pas un forfait à portée et calendrier fixes — c’est une approche par phases qui s’adapte à la complexité du cas d’usage, à la maturité de la logique d’agent existante et à la maturité de production de l’organisation. Pour le déploiement d’agents IA en entreprise, cette approche structurée aide les équipes à éviter les quatre goulots d’étranglement dès le premier jour.
Ce que couvre le cadre de lancement
Le cadre couvre les composants que le déploiement d’agents IA en production exige mais que les pilotes omettent généralement :
- Conception d’architecture : une architecture prête pour la production qui intègre garde-fous, observabilité et contrôles de coûts dès le départ.
- Implémentation des garde-fous en couches : contrôles déterministes, vérifications basées sur des modèles, contrôle d’accès et portes d’approbation humaine adaptés au profil de risque du cas d’usage.
- Mise en place de la mise en cache du contexte : stratégie de mise en cache avec invalidation, isolation par tenant et traitement des sorties sensibles.
- Pile d’observabilité : journalisation, alertage et évaluation avec rédaction, classification des données et politique de rétention intégrées.
- Déploiement contrôlé : déploiement par phases qui commence par un périmètre restreint et s’étend en fonction des résultats prouvés.
Le cadre convient aux cas d’usage à périmètre clair et avec une logique d’agent existante ou simple. Ce n’est pas un sprint construit de zéro — c’est un chemin structuré vers la production pour des agents qui ont prouvé leur valeur en pilote et ont besoin de la rigueur d’ingénierie pour survivre à l’échelle.
Une approche par phases, non un calendrier fixe
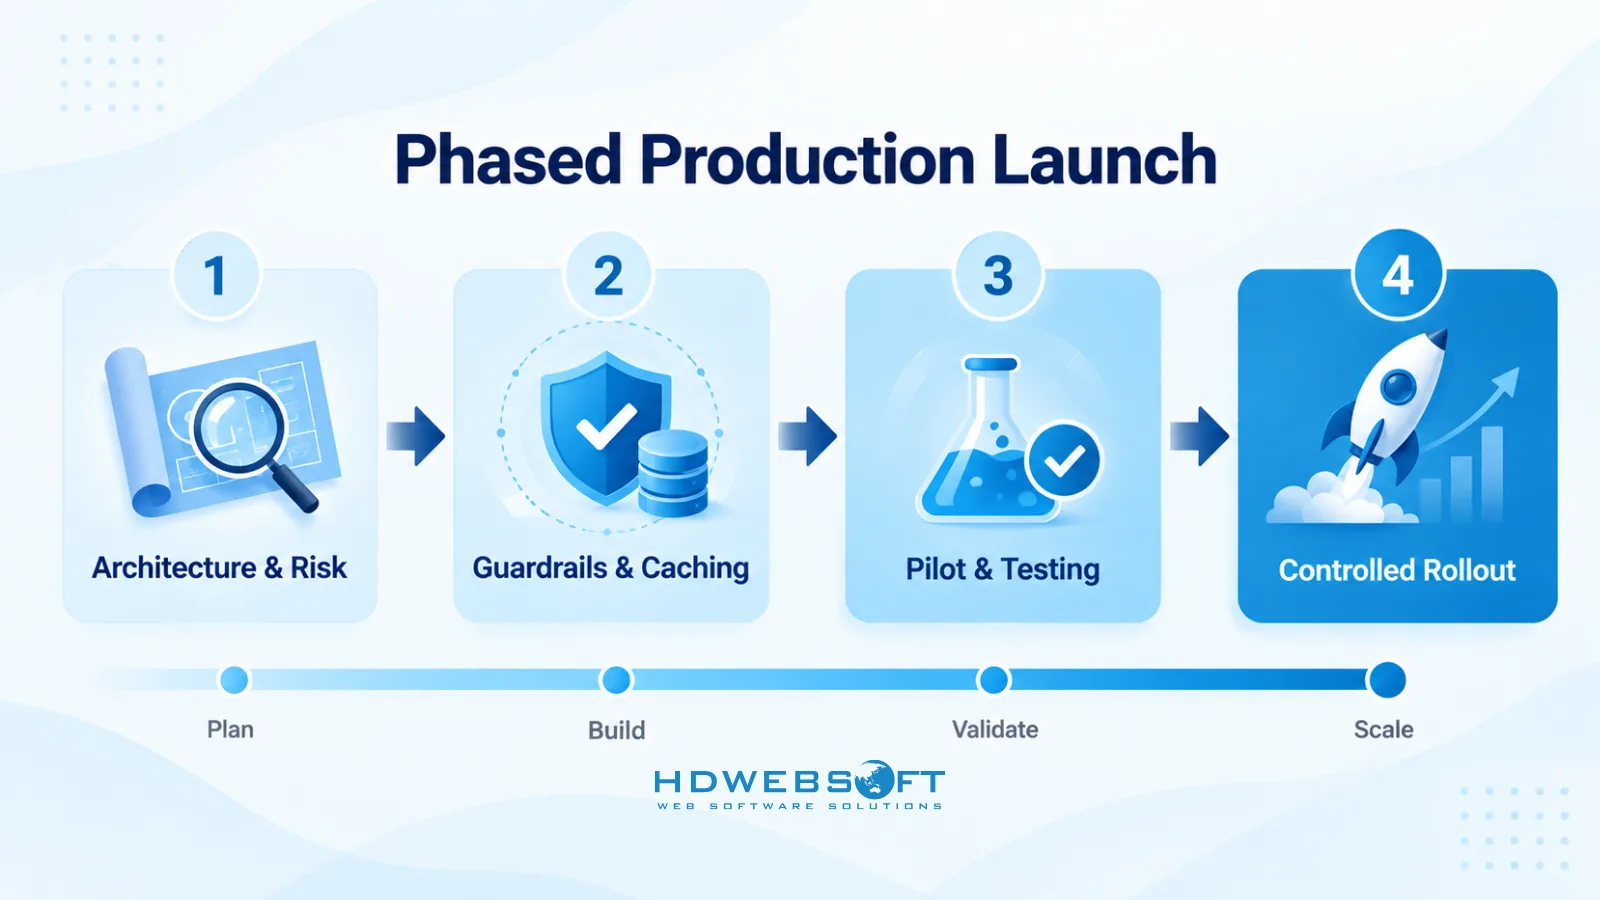
Le lancement suit une approche par phases plutôt qu’un calendrier fixe. Les phases sont :
- Session d’architecture et évaluation des risques : définir le cas d’usage, les métriques de succès, le profil de risque et les exigences de production. Identifier quels goulots d’étranglement — dérive, latence, coût, sécurité — sont les plus pertinents pour le déploiement.
- Implémentation des garde-fous, de la mise en cache et de l’observabilité : construire les fondations de production avant que l’agent ne touche le trafic réel. Les garde-fous en couches, la mise en cache avec invalidation et l’observabilité avec rédaction sont mis en place durant cette phase.
- Déploiement pilote et tests : déployer l’agent dans un environnement contrôlé qui reproduit la production, avec tous les garde-fous et l’observabilité actifs. Tester contre une charge réaliste, des cas limites et des modes de défaillance.
- Déploiement contrôlé et surveillance : déployer progressivement, surveiller les métriques de dérive, la latence, le coût et les résultats des garde-fous, et étendre le périmètre en fonction des résultats prouvés.
La durée de chaque phase dépend de la complexité du cas d’usage, de la maturité de la logique d’agent existante et de la maturité de production de l’organisation. Le cadre apporte structure et discipline, non un calendrier rigide.
Pourquoi un lancement structuré réduit les risques du déploiement en production
Un lancement structuré réduit les risques du déploiement d’agents IA en production de plusieurs manières :
- Clarté du périmètre : un cas d’usage bien délimité empêche la dérive du périmètre, qui est la raison la plus courante pour laquelle les déploiements en production dépassent budget et calendrier.
- Concentration sur un cas d’usage à forte valeur : plutôt que de tenter de déployer tous les agents à la fois, le cadre se concentre sur un cas d’usage où le succès est le plus probable et la valeur la plus élevée.
- Garde-fous et observabilité dès le départ : les fondations de production sont construites avant le lancement, non greffées après le premier incident.
- Référence pour la mise à l’échelle : un déploiement contrôlé réussi fournit la référence — métriques, seuils de garde-fous, schémas de coût — sur laquelle les futures décisions de mise à l’échelle s’appuient.
Pour les équipes prêtes à passer du pilote à la production, la prochaine étape est une session d’architecture technique avec notre responsable IA pour cartographier le cas d’usage, identifier les goulots d’étranglement pertinents et définir les exigences de production. Planifiez une session d’architecture technique avec notre responsable IA pour démarrer la conversation.
Conclusion
Le déploiement d’agents IA en production est une discipline d’ingénierie, non une capacité de modèle. Les quatre goulots d’étranglement — dérive de prompt, latence d’API, coût en tokens et failles de sécurité — sont prévisibles, diagnostiquables et traitables, mais seulement lorsque les équipes s’y préparent avant la production plutôt qu’après le premier incident. Un déploiement d’agents IA réussi nécessite des garde-fous en couches, une mise en cache intelligente du contexte et une observabilité structurée dès le départ.
Les garde-fous en couches, la mise en cache intelligente du contexte avec invalidation et isolation par tenant appropriées, et une observabilité structurée avec rédaction et politique de rétention forment les fondations de production que les pilotes n’ont pas. Une prévision des coûts en tokens avec des seuils budgétaires et une politique d’arrêt ou d’escalade est un prérequis, non une réflexion après coup. Et un cadre de lancement structuré — par phases, non rigidement calendrieré — donne aux équipes la discipline pour déployer un cas d’usage avec excellence avant de passer au suivant.
HDWEBSOFT aide les équipes à naviguer cette transition avec un cadre de lancement par phases qui construit les fondations de production avant que l’agent ne touche le trafic réel. Pour les organisations prêtes à avancer, la prochaine étape est une session d’architecture technique pour définir le cas d’usage, identifier les goulots d’étranglement pertinents et planifier le déploiement.
FAQ
Qu’est-ce que le déploiement d’agents IA en production ?
Le déploiement d’agents IA en production est l’opération d’un système IA autonome qui raisonne, appelle des outils et prend des actions sous une charge réelle, avec des utilisateurs réels et des conséquences réelles. Il nécessite des garde-fous en couches, de l’observabilité, des contrôles de coûts et des procédures de rollback que les pilotes n’ont généralement pas. Un déploiement d’agents IA réussi traite la fiabilité, la sécurité et le contrôle des coûts comme des exigences d’ingénierie fondamentales.
Pourquoi les pilotes d’agents IA échouent-ils lors du passage en production ?
Les pilotes échouent en production à cause de quatre goulots d’étranglement techniques : dérive de prompt, latence d’API, coût en tokens et failles de sécurité. Les équipes sous-estiment ces problèmes car les pilotes s’exécutent dans des environnements contrôlés avec peu d’utilisateurs, peu de cas limites et aucune pression de coût réelle. Sans garde-fous, observabilité et prévisions de coûts conçus pour la production, le déploiement d’agents IA échoue lorsque les agents dérivent, ralentissent, brûlent des tokens et font fuiter des données.
Qu’est-ce que la dérive de prompt et comment la contrôler ?
La dérive de prompt, également appelée dérive de contexte ou d’instructions, est la perte progressive de l’adhésion aux instructions à mesure qu’un agent traite des sessions plus longues ou des boucles multi-tours. Elle est causée par la croissance du contexte, la troncature, les instructions conflictuelles, la mémoire obsolète et les sorties intermédiaires. Contrôlez-la en réinjectant les contraintes périodiquement, en gérant les fenêtres de contexte, en ajoutant des points de contrôle déterministes et en détectant la dérive avec plusieurs signaux — taux de réussite des tâches, taux de violation des contraintes, correction des appels d’outils, évaluations de régression et distance sémantique.
Combien coûte l’exécution d’agents IA en production ?
Le coût dépend des tokens moyens par session, des sessions par jour et de la tarification des modèles. Les boucles multi-agents peuvent faire augmenter le coût rapidement ou de manière super-linéaire en raison du contexte répété, des retries et des embranchements. Construisez une prévision des coûts en tokens avant le lancement et définissez des seuils budgétaires avec une politique d’arrêt ou d’escalade afin que les dépassements soient détectés avant l’arrivée de la facture.
Que sont les garde-fous en couches pour les agents IA ?
Les garde-fous en couches combinent plusieurs types de contrôles : règles déterministes (validation de schéma, listes autorisées d’appels d’outils, limites de boucles, vérifications de permissions), vérifications basées sur des modèles ou des classificateurs (filtres de contenu, détecteurs d’hallucinations), contrôle d’accès (moindre privilège, permissions d’outils limitées) et approbation humaine pour les actions sensibles. Aucune couche unique n’est suffisante — chacune couvre les lacunes des autres, et ensemble elles forment l’épine dorsale de la fiabilité des agents IA en production.
Comment fonctionne le cadre de lancement d’agents IA de HDWEBSOFT ?
Le cadre de lancement de HDWEBSOFT est une approche par phases pour des déploiements bien délimités : session d’architecture et évaluation des risques, implémentation des garde-fous, de la mise en cache et de l’observabilité, déploiement pilote et tests, et déploiement contrôlé et surveillance. Le cadre s’adapte à la complexité du cas d’usage et à la maturité de l’organisation, plutôt que de suivre un calendrier fixe. Pour le déploiement d’agents IA en entreprise, cette approche structurée aide les équipes à éviter les quatre goulots d’étranglement dès le départ.