การติดตั้ง AI agent คือจุดที่โครงการนำร่องที่มีแววมากที่สุดพังทลาย เดโม่ที่ตอบคำถามได้ในสภาพแวดล้อมที่ควบคุมนั้น แทบจะไม่เคยอยู่รอดเมื่อต้องเผชิญกับผู้ใช้จริง ข้อมูลจริง และงบประมาณจริง Gartner คาดการณ์ว่าโครงการ agentic AI มากกว่า 40% จะถูกยกเลิกภายในสิ้นปี 2027 โดยต้นทุนที่เพิ่มสูงขึ้นและการควบคุมความเสี่ยงที่ไม่เพียงพอเป็นหนึ่งในสาเหตุหลัก ช่องว่างระหว่างการทำนำร่องกับagentic AI ใน production ไม่ใช่แค่ปัญหาด้านเทคโนโลยีเท่านั้น แต่เป็นปัญหาด้านระเบียบวิธีวิศวกรรมที่ทีมน้อยทีนักจะคาดการณ์ไว้ก่อนที่จะเข้าสู่ production ครับ
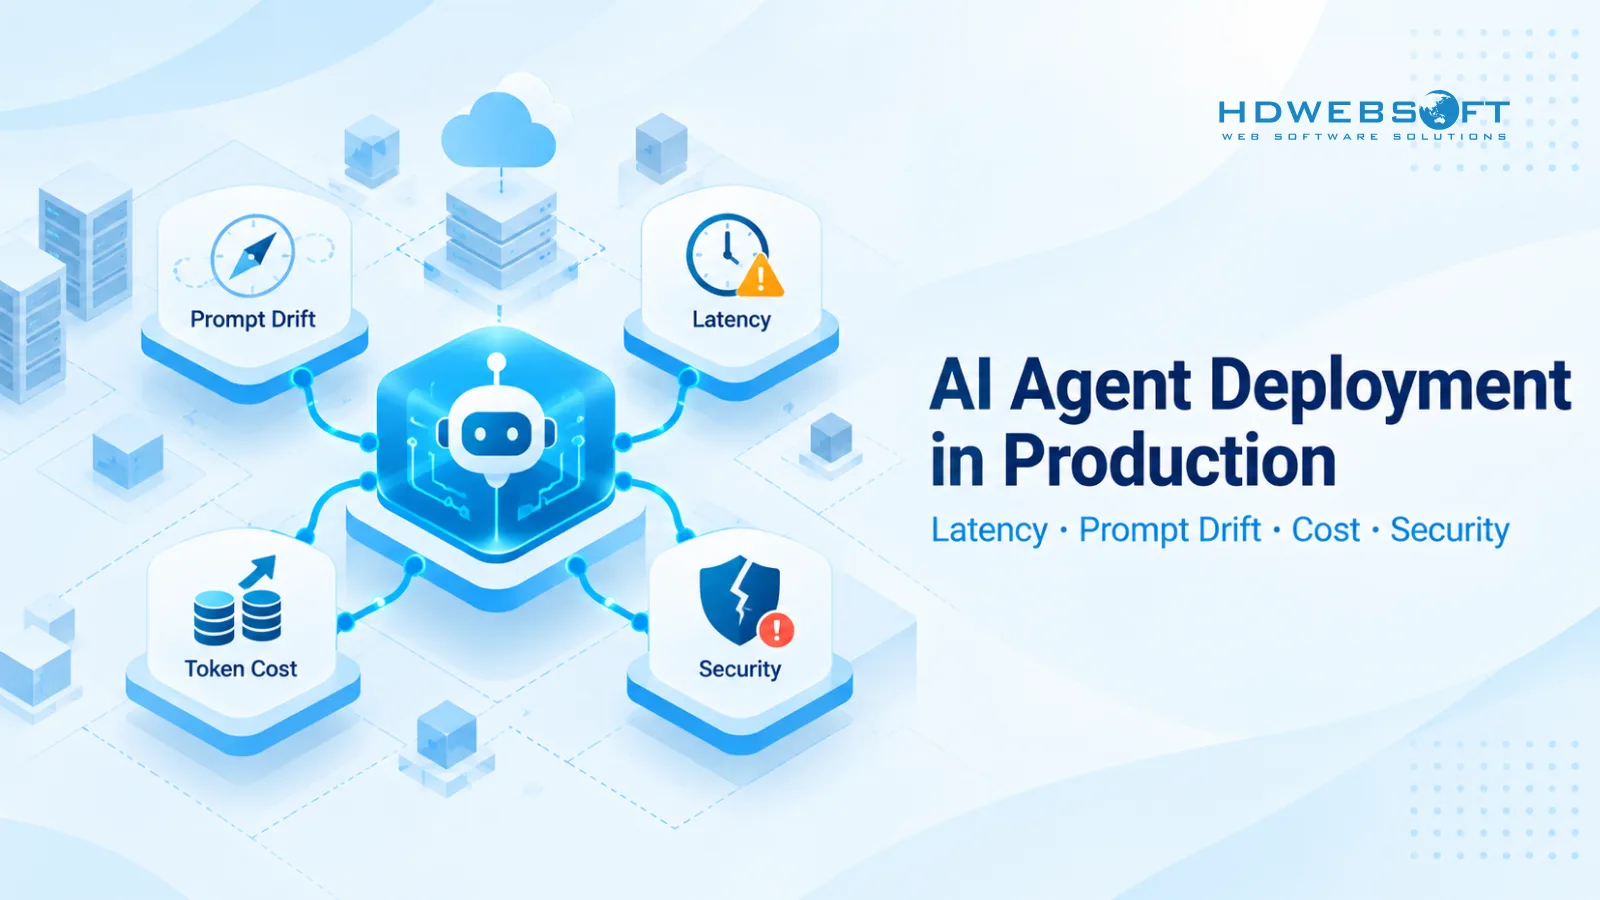
โครงการนำร่องประสบความสำเร็จเพราะทำงานในสภาพแวดล้อมที่ควบคุม มีผู้ใช้น้อย มี edge case น้อย และไม่มีแรงกดดันด้านต้นทุนจริง ส่วน production จะเปิดเผย agent ให้เผชิญกับการเพิ่มขึ้นของปริมาณการใช้งาน ข้อมูลนำเข้าที่คลุมเครือ เนื้อหาที่เป็นปฏิปักษ์ และข้อจำกัดด้านงบประมาณที่โครงการนำร่องไม่เคยจำลองขึ้น หากไม่มี guardrails, observability และการควบคุมต้นทุนที่ออกแบบมาสำหรับ production ตั้งแต่แรกเริ่ม agent จะเริ่มเบี่ยงเบน ชะลอตัวลง เผาผลาญ token และรั่วไหลข้อมูล บทความนี้จะวิเคราะห์คอขวดทางเทคนิคสี่ประการที่ทำให้การติดตั้ง AI agent ใน production ล้มเหลว ได้แก่ prompt drift, API latency, token cost และช่องโหว่ด้านความปลอดภัย และอธิบายวิธีที่ layered guardrails, smart context caching และ structured observability ช่วยให้ทีมติดตั้ง AI agent ใน production ได้อย่างน่าเชื่อถือครับ
ประเด็นสำคัญ
- Gartner คาดการณ์ว่าโครงการ agentic AI มากกว่า 40% จะถูกยกเลิกภายในสิ้นปี 2027 โดยต้นทุนที่เพิ่มสูงขึ้นและการควบคุมความเสี่ยงที่ไม่เพียงพอเป็นหนึ่งในสาเหตุหลัก
- คอขวดทางเทคนิคสี่ประการที่ทำให้การติดตั้งใน production ล้มเหลว: prompt drift, API latency, token cost และช่องโหว่ด้านความปลอดภัย
- Layered guardrails ที่ผสมผสานกฎเกณฑ์แบบ deterministic, การตรวจสอบด้วยโมเดล, การควบคุมการเข้าถึง และการอนุมัติโดยมนุษย์ เป็นแกนหลักของความน่าเชื่อถือของ AI agent
- Multi-agent loops สามารถขับดันต้นทุน token ให้เพิ่มขึ้นอย่างรวดเร็วหรือแบบ superlinear เนื่องจากบริบทที่ซ้ำกัน การ retry และการแตกสาขา การกำหนด loop limits, model routing และ context caching เป็นกลไกสำคัญที่จำเป็น
- การพยากรณ์ต้นทุน token พร้อม budget thresholds และนโยบายการหยุดหรือการเลื่อนขั้นเป็นข้อกำหนดเบื้องต้นสำหรับการติดตั้งใน production ไม่ใช่สิ่งที่ทำภายหลัง
- Observability สำหรับ AI agent ต้องมีการ redact การจัดประเภทข้อมูล และนโยบายการเก็บรักษาข้อมูล ห้าม log prompt หรือ context แบบเต็มเมื่อมี PII หรือข้อมูลลับอยู่
การติดตั้ง AI Agent ใน Production หมายถึงอะไรจริงๆ
การติดตั้ง AI agent ใน production ไม่ใช่แค่การรันโมเดลบนเซิร์ฟเวอร์ แต่เป็นการดูแลระบบอัตโนมัติที่ให้เหตุผล เรียกใช้เครื่องมือ และดำเนินการต่างๆ ภายใต้ภาระงานจริง ผู้ใช้จริง และผลกระทบจริง การอยู่ใน production หมายความว่าระบบต้องคงความน่าเชื่อถือ ความปลอดภัย และการควบคุมต้นทุนไว้ได้เมื่อปริมาณการใช้งานพุ่งสูงขึ้น ข้อมูลนำเข้ายุ่งยาก และงบประมาณตึงขึ้นครับ
นำร่องกับ Production: ช่องว่างที่ทำลายโครงการ
ช่องว่างระหว่างการนำร่องกับ production คือจุดที่โครงการส่วนใหญ่ตาย โครงการนำร่องทำงานในสภาพแวดล้อมที่ควบคุม มีผู้ใช้น้อย มี edge case น้อย และไม่มีแรงกดดันด้านต้นทุนจริง ส่วน production จะเปิดเผย agent ให้เผชิญกับการเพิ่มขึ้นของปริมาณการใช้งาน ข้อมูลนำเข้าที่คลุมเครือ เนื้อหาที่เป็นปฏิปักษ์ และข้อจำกัดด้านงบประมาณที่โครงการนำร่องไม่เคยจำลองขึ้น
| มิติ | นำร่อง | Production |
|---|---|---|
| ผู้ใช้ | ผู้ทดสอบไม่กี่คน | หลายพันคนขึ้นไป รูปแบบการใช้งานที่คาดเดาไม่ได้ |
| Edge case | คัดสรรและจำกัด | ไม่จำกัด มีลักษณะปฏิปักษ์ |
| SLA | พยายามให้ดีที่สุด | ผูกกับสัญญาหรือความคาดหวังของผู้ใช้ |
| งบประมาณ | ยอมรับได้ | ข้อจำกัดแบบเข้มงวด การแจ้งเตือนต้นทุน การเลื่อนขั้น |
| Observability | ตรวจสอบด้วยมือ | แดชบอร์ดแบบเรียลไทม์ การแจ้งเตือน บันทึกการตรวจสอบ |
| Rollback | รีสตาร์ทเดโม่ | Rollback ที่ควบคุมได้ ค่าเริ่มต้นที่ปลอดภัยเมื่อเกิดข้อผิดพลาด |
ทีมที่มองโครงการนำร่องเป็นการทดลองมากกว่าต้นแบบ production มักไม่ประสบความสำเร็จในการขยายขนาด ทีมที่ประสบความสำเร็จมากที่สุดจะออกแบบเพื่อ production ตั้งแต่แรกเริ่ม โดยสร้าง guardrails, observability และการควบคุมต้นทุนเป็นข้อกำหนดหลักมากกว่าทำเป็นข้อคิดภายหลังครับ
คอขวดทางเทคนิคสี่ประการที่ทำให้การติดตั้งใน Production ล้มเหลว
เมื่อ agent ย้ายจากการนำร่องไปสู่ production คอขวดทางเทคนิคสี่ประการเป็นสาเหตุหลักของความล้มเหลวในการติดตั้ง AI agent:
- Prompt drift — agent ค่อยๆ สูญเสียการยึดมั่นในคำสั่งเดิมเมื่อบริบทเติบโตและผลลัพธ์ระหว่างขั้นตอนสะสมขึ้น
- API latency — การเรียกตามลำดับผ่าน LLM inference, tool calls และ orchestration สะสม latency ที่ทำลายเวิร์กโฟลว์แบบเรียลไทม์
- Token cost — multi-agent loops, การ retry และการแตกสาขาขับดันการใช้ token ให้เพิ่มขึ้นอย่างรวดเร็วหรือแบบ superlinear
- Security gaps — indirect prompt injection, unsafe tool calls และความเสี่ยงด้านการรั่วไหลของข้อมูลที่ AppSec แบบดั้งเดิมไม่ได้ครอบคลุมอย่างเต็มที่
คอขวดแต่ละประการสามารถคาดการณ์ วินิจฉัย และแก้ไขได้ แต่ต่อเมื่อทีมออกแบบรองรับไว้ก่อนเข้า production ไม่ใช่หลังจากนั้น สำหรับการติดตั้ง AI agent สำหรับองค์กร ปัญหาทั้งสี่นี้เป็นสาเหตุของความล้มเหลวใน production ส่วนใหญ่ครับ
คอขวดที่ 1: Prompt Drift ทำลายความน่าเชื่อถือของ Agent
Prompt drift หรือที่เรียกว่า context หรือ instruction drift คือการสูญเสียการยึดมั่นในคำสั่งอย่างค่อยเป็นค่อยไปเมื่อ agent ประมวลผลบทสนทนาที่ยาวขึ้นหรือ multi-turn loops ตอนเริ่มต้น agent จะสอดคล้องกับคำสั่งเดิม แต่เมื่อการโต้ตอบยาวขึ้น ผลลัพธ์จะเบี่ยงเบนไปจากพฤติกรรมที่ตั้งใจไว้มากขึ้นเรื่อยๆ
สาเหตุของ Prompt Drift ใน Multi-Turn Agent Loops
กลไกหลายประการก่อให้เกิด prompt drift ในการติดตั้ง AI agent ใน production:
- การเติบโตของบริบท: เมื่อบทสนทนาหรือ agent loop ยาวขึ้น หน้าต่างบริบทจะเต็มไปด้วยผลลัพธ์ระหว่างขั้นตอน ผลลัพธ์ของ tool calls และข้อความของผู้ใช้ ทำให้ system prompt และข้อจำกัดเดิมครอบครองสัดส่วนความสนใจของโมเดลน้อยลง
- การตัดทอน: เมื่อบริบทเกินหน้าต่างของโมเดล เนื้อหาเก่าซึ่งมักมีคำสั่งสำคัญ จะถูกตัดทอนหรือสรุป ทำให้สูญเสียความถูกต้อง
- คำสั่งที่ขัดแย้งกัน: คำสั่งใหม่จากผลลัพธ์ของเครื่องมือ ข้อความของผู้ใช้ หรือ agent อื่น อาจขัดแย้งกับ system prompt เดิม และโมเดลอาจทำตามคำสั่งล่าสุดโดยไม่มีกฎลำดับความสำคัญที่ชัดเจน
- หน่วยความจำเดิม: ข้อมูลที่เก็บในหน่วยความจำหรือระบบ retrieval อาจล้าสมัย ทำให้ agent ดำเนินการตามบริบทที่ไม่สะท้อนความเป็นจริงอีกต่อไป
- ผลลัพธ์ระหว่างขั้นตอน: ผลลัพธ์จากขั้นตอนก่อนหน้าใน multi-agent chain มีอิทธิพลต่อการให้เหตุผลในขั้นตอนถัดไป หากผลลัพธ์ตอนต้นผิดเพียงเล็กน้อย ข้อผิดพลาดจะสะสมในขั้นตอนปลายน้ำ
กลไกเหล่านี้ไม่จำเป็นต้องอาศัยให้โมเดล “นิยมบริบทล่าสุด” แต่เกิดขึ้นจากความเป็นจริงในการจัดการบริบท การตัดทอน และปริมาณของเนื้อหาระหว่างขั้นตอนที่ production agent สร้างขึ้นมากมาย
Prompt Drift ทำให้คุณภาพผลลัพธ์เสื่อมลงอย่างไรตามกาลเวลา
ผลกระทบของ drift สะสมขึ้นในเซสชันที่ยาวนานและ multi-agent chains ทำให้ความน่าเชื่อถือของ AI agent ลดลง Agent เริ่มหลอนลอย เรียกเครื่องมือผิด ละเมิดข้อจำกัด หรือสูญเสียการติดตามเป้าหมายเดิม ใน multi-agent loops นั้น drift อันตรายเป็นพิเศษ: agent A ส่งบริบทให้ agent B ซึ่งส่งต่อให้ agent C และการส่งต่อแต่ละครั้งเป็นโอกาสที่จะเกิดการสูญเสียคำสั่ง
ใน production logs นั้น drift ปรากฏเป็นการเสื่อมคุณภาพที่ละเอียดอ่อนจนมองข้ามได้ง่าย ผลลัพธ์อาจยังดูสมเหตุสมผลบนพื้นผิว แต่ไม่ตอบสนองข้อจำกัดเดิมอีกต่อไป — agent สนับสนุนลูกค้าเริ่มข้าม disclaimer ที่จำเป็น, agent วิเคราะห์ข้อมูลเริ่มละเว้นช่วงความเชื่อมั่น หรือ coding agent เลิกทำตาม style guide ของทีม หากไม่มีเมตริกการตรวจจับ drift การถดถอยเหล่านี้มักไม่ถูกสังเกตจนกว่าผู้ใช้จะร้องเรียนหรือการตรวจสอบจะพบช่องว่าง
การตรวจจับและควบคุม Prompt Drift
การควบคุม drift ต้องอาศัยทั้งการป้องกันและการตรวจจับ เทคนิคการป้องกันได้แก่:
- การฉีดซ้ำเป็นช่วงๆ: ฉีด system prompt และข้อจำกัดสำคัญซ้ำในช่วงเวลาปกติ แทนที่จะพึ่งพา prompt เดิมให้ปรากฏตลอดเซสชันที่ยาวนาน
- การจัดการหน้าต่างบริบท: สรุปหรือตัดทอนเนื้อหาระหว่างขั้นตอนเพื่อให้คำสั่งเดิมโดดเด่น เก็บเฉพาะสิ่งที่ขั้นตอนถัดไปต้องการ
- Deterministic checkpoints: ตรวจสอบผลลัพธ์ของ agent ในแต่ะรอบเทียบกับข้อจำกัดเดิม ไม่ใช่ตรวจเฉพาะตอนท้ายเซสชัน
การตรวจจับต้องอาศัยสัญญาณหลายตัว ไม่ใช่เมตริกเดียว การตรวจจับ drift ที่มีประสิทธิภาพผสมผสาน:
- อัตราความสำเร็จของงาน: agent ยังทำงานให้สำเร็จอย่างถูกต้องหรือไม่?
- อัตราการละเมิดข้อจำกัด: agent ทำผิดกฎที่ระบุไว้บ่อยแค่ไหน?
- ความถูกต้องของ tool-call: เครื่องมือที่ถูกต้องถูกเรียกด้วยพารามิเตอร์ที่ถูกต้องหรือไม่?
- Regression evals: รันชุดประเมินคงที่เป็นช่วงๆ เพื่อจับการถดถอยของคุณภาพเทียบกับเกณฑ์ฐานที่ทราบ
- ระยะทางเชิงความหมาย: วัดว่าผลลัพธ์เบี่ยงเบนจากพฤติกรรมที่ตั้งใจไว้มากแค่ไหน เป็นหนึ่งในสัญญาณหลายตัว
ไม่มีเมตริกใดตัวเดียวจับ drift ได้ทั้งหมด ทีมที่พึ่งเฉพาะระยะทางเชิงความหมายหรือเฉพาะอัตราความสำเร็จของงานจะพลาดการถดถอยที่สัญญาณอื่นจับได้ การใช้วิธีหลายสัญญาณเป็นวิธีเดียวที่น่าเชื่อถือในการตรวจจับ drift ในการติดตั้ง AI agent ใน production ครับ
คอขวดที่ 2: API Latency ทำลายเวิร์กโฟลว์ Agent แบบเรียลไทม์
Latency เป็นคอขวดที่สองที่ทำให้การติดตั้งใน production ล้มเหลว เวิร์กโฟลว์ของ agent เชื่อมการเรียกหลายครั้งเข้าด้วยกัน — LLM inference, การเรียกใช้เครื่องมือ, retrieval, orchestration — และ latency สะสมในแต่ละขั้นตอนตามลำดับ เมื่อมีการแตกสาขาหรือการ retry เข้ามาเกี่ยวข้อง เวลาตอบสนองรวมอาจเพิ่มขึ้นอย่างมาก ทำให้การติดตั้ง AI agent ใน production ยิ่งยากที่จะรักษาให้อยู่ในเวลาตอบสนองที่ยอมรับได้
Latency ซ่อนอยู่ที่ไหนใน Agent Call Chains
Latency ในการติดตั้ง AI agent มาจากหลายแหล่ง:
- LLM inference: เวลาในการสร้างผลลัพธ์ของโมเดลเอง ซึ่งขยายตามความยาวของผลลัพธ์และขนาดของโมเดล
- Latency ของ tool call: API ภายนอก ฐานข้อมูล และบริการที่ agent เรียก แต่ละรายการเพิ่มเวลาไปกลับ
- Overhead ของ RAG retrieval: retrieval, embedding และ ranking เพิ่มเวลาก่อนที่โมเดลจะเริ่มสร้างผลลัพธ์
- Multi-agent orchestration: การประสานงานระหว่าง agent — routing, handoffs, การรวมผลลัพธ์ — เพิ่ม overhead ทับบน latency ของการเรียกแต่ละครั้ง
- Serialization และ deserialization: การแปลงรูปแบบสำหรับการเรียกแต่ละครั้งเพิ่มความล่าช้าเล็กน้อยแต่สะสมขึ้น
ใน multi-agent loop นั้น latency สะสมข้ามการเรียกตามลำดับ หากแต่ละขั้นตอนใช้เวลาไม่กี่วินาทีและ loop รันหลายขั้นตอน เวลาตอบสนองรวมอาจถึงหลายสิบวินาที การแตกสาขา — ที่ agent ลองหลายวิธี — และการ retry — ที่ agent พยายามซ้ำขั้นตอนที่ล้มเหลว — สามารถดัน latency รวมให้สูงขึ้นอีก ตัวอย่างประกอบ การเรียก agent เดี่ยวอาจใช้เวลา 3 ถึง 8 วินาที และ multi-agent chain หลายขั้นตอนอาจถึง 30 ถึง 60 วินาที ตัวเลขเหล่านี้เป็นเพียงตัวอย่าง ไม่ใช่ค่าสากล — latency จริงขึ้นอยู่กับโมเดลที่เลือก ประสิทธิภาพของเครื่องมือ และการออกแบบ orchestration
Latency Budgets สำหรับ Production AI Agents
Latency budget คือเวลาตอบสนองสูงสุดที่ยอมรับได้สำหรับงานที่กำหนด กระจายข้ามแต่ละขั้นตอนใน agent chain หากไม่มี budget ทีมไม่มีวิธีตัดสินใจว่า latency ใดยอมรับได้หรือสถาปัตยกรรมต้องเปลี่ยน
ตัวอย่าง latency budgets — เป็นเพียงตัวอย่างประกอบ ไม่ใช่ SLA สากล:
- การโต้ตอบแบบเรียลไทม์ (เช่น แชท, สนับสนุนสด): ภายใน 5 วินาที
- งานใกล้เรียลไทม์ (เช่น การวิเคราะห์ข้อมูล, การสร้างรายงาน): ภายใน 30 วินาที
- งานเบื้องหลัง (เช่น การประมวลผลแบบ batch, agent ตามกำหนดเวลา): ภายใน 5 นาที
เมื่อกำหนด budget แล้ว ให้กระจายข้ามขั้นตอนใน agent chain หากผลรวมโดยประมาณเกิน budget สถาปัตยกรรมต้องเปลี่ยน — เรียกเครื่องมือแบบขนาน ลดความลึกของการให้เหตุผล ส่งงานง่ายๆ ไปยังโมเดลที่เร็วกว่า หรือย้ายงานไปเป็นการประมวลผลเบื้องหลัง
การลด Latency โดยไม่เสียความลึกของการให้เหตุผล
เทคนิคหลายอย่างช่วยลด latency โดยไม่บังคับให้ agent ให้เหตุผลน้อยลง:
- การสตรีมผลลัพธ์: สตรีมผลลัพธ์ให้ผู้ใช้ทันทีที่สร้างขึ้น เพื่อให้ผู้ใช้เห็นความคืบหน้าแทนที่จะรอผลลัพธ์ที่สมบูรณ์
- Model routing: ส่งงานง่ายไปยังโมเดลที่เล็กและเร็วกว่า และสำรองโมเดลใหญ่สำหรับงานที่ต้องการการให้เหตุผลที่ลึกกว่า การตัดสินใจ routing ควรอิงจากความซับซ้อนของงาน ความเสี่ยง และข้อกำหนดด้านคุณภาพ ไม่ใช่สัดส่วนคงที่
- Parallel tool calls: เรียกเครื่องมืออิสระแบบขนานแทนที่ตามลำดับ ลดเวลารอรวม
- Caching: แคชผลลัพธ์ของ LLM และผลลัพธ์ของเครื่องมือสำหรับข้อมูลนำเข้าที่คล้ายกันเพื่อหลีกเลี่ยงการเรียกซ้ำ
- Speculative execution (ทางเลือก ขั้นสูง): สำหรับขั้นตอนที่มีรูปแบบที่คาดเดาได้ ให้เริ่มขั้นตอนถัดไปที่น่าจะเป็นไปได้ก่อนที่ขั้นตอนปัจจุบันจะเสร็จสิ้น
Retrieval-augmented generation แสดงให้เห็นถึงการแลกเปลี่ยนด้าน latency ได้ดี RAG เพิ่ม overhead ของ retrieval แต่การ grounding ที่ดีสามารถลดจำนวน retry และ reasoning loops ที่ agent ต้องการ ซึ่งอาจลด latency รวมได้ ผลกระทบสุทธิขึ้นอยู่กับการใช้งานจริง — RAG ไม่ได้ลด latency เสมอไป แต่ retrieval ที่ออกแบบดีสามารถทำได้
คอขวดที่ 3: การระเบิดของ Token Cost ใน Multi-Agent Loops
Token cost เป็นคอขวดที่จับทีมได้โดยไม่คาดคิด โครงการนำร่องรันด้วยผู้ใช้น้อยและ edge case น้อย จึงทำให้การใช้ token อยู่ในระดับควบคุมได้ ส่วน production ขยายการใช้งาน และ multi-agent loops ขยายต้นทุนในรูปแบบที่ข้อมูลนำร่องไม่เคยเผยให้เห็น หากไม่มีการพยากรณ์ต้นทุน การติดตั้ง AI agent ใน production สามารถทะลุงบประมาณได้ก่อนที่ใครจะสังเกตเห็น
ทำไม Multi-Agent Loops เผาผลาญ Token อย่างคาดเดาไม่ได้
Multi-agent loops ขับดันต้นทุน token ให้เพิ่มขึ้นอย่างรวดเร็วหรือแบบ superlinear ในการติดตั้ง AI agent เนื่องจากปัจจัยหลายประการ:
- บริบทที่ซ้ำกัน: ในแต่ละรอบของ loop จะส่งบริบทซ้ำ — system prompt, ประวัติบทสนทนา, ผลลัพธ์ของเครื่องมือ — ไปยังโมเดล เมื่อบริบทเติบโต แต่ละรอบจะใช้ token มากกว่ารอบก่อน
- การ retry: เมื่อ agent สร้างผลลัพธ์ที่ไม่ถูกต้อง loop จะ retry โดยส่งบริบทเต็มอีกครั้งพร้อม feedback ข้อผิดพลาด
- การแตกสาขา: เมื่อ agent ลองหลายวิธี แต่ละสาขาใช้ token และอาจใช้ผลลัพธ์ของเพียงสาขาเดียว
- การแลกเปลี่ยนระหว่าง multi-agent: agent ที่สื่อสารกันจะใช้ token สำหรับทุกข้อความ เพิ่ม overhead ที่ระบบ single-agent ไม่มี
ตัวอย่างประกอบ เซสชันนำร่องอาจใช้ 5,000 token ที่ 1,000 เซสชันต่อวันใน production จะกลายเป็น 5 ล้าน token ต่อวัน — และนั่นยังไม่นับรวมการ retry การแตกสาขา และการเติบโตของบริบทที่การใช้งาน production นำเข้ามา ต้นทุนอาจเพิ่มขึ้นอย่างรวดเร็วหรือแบบ superlinear ไม่ใช่เชิงเส้น เมื่อปัจจัยเหล่านี้สะสมกัน
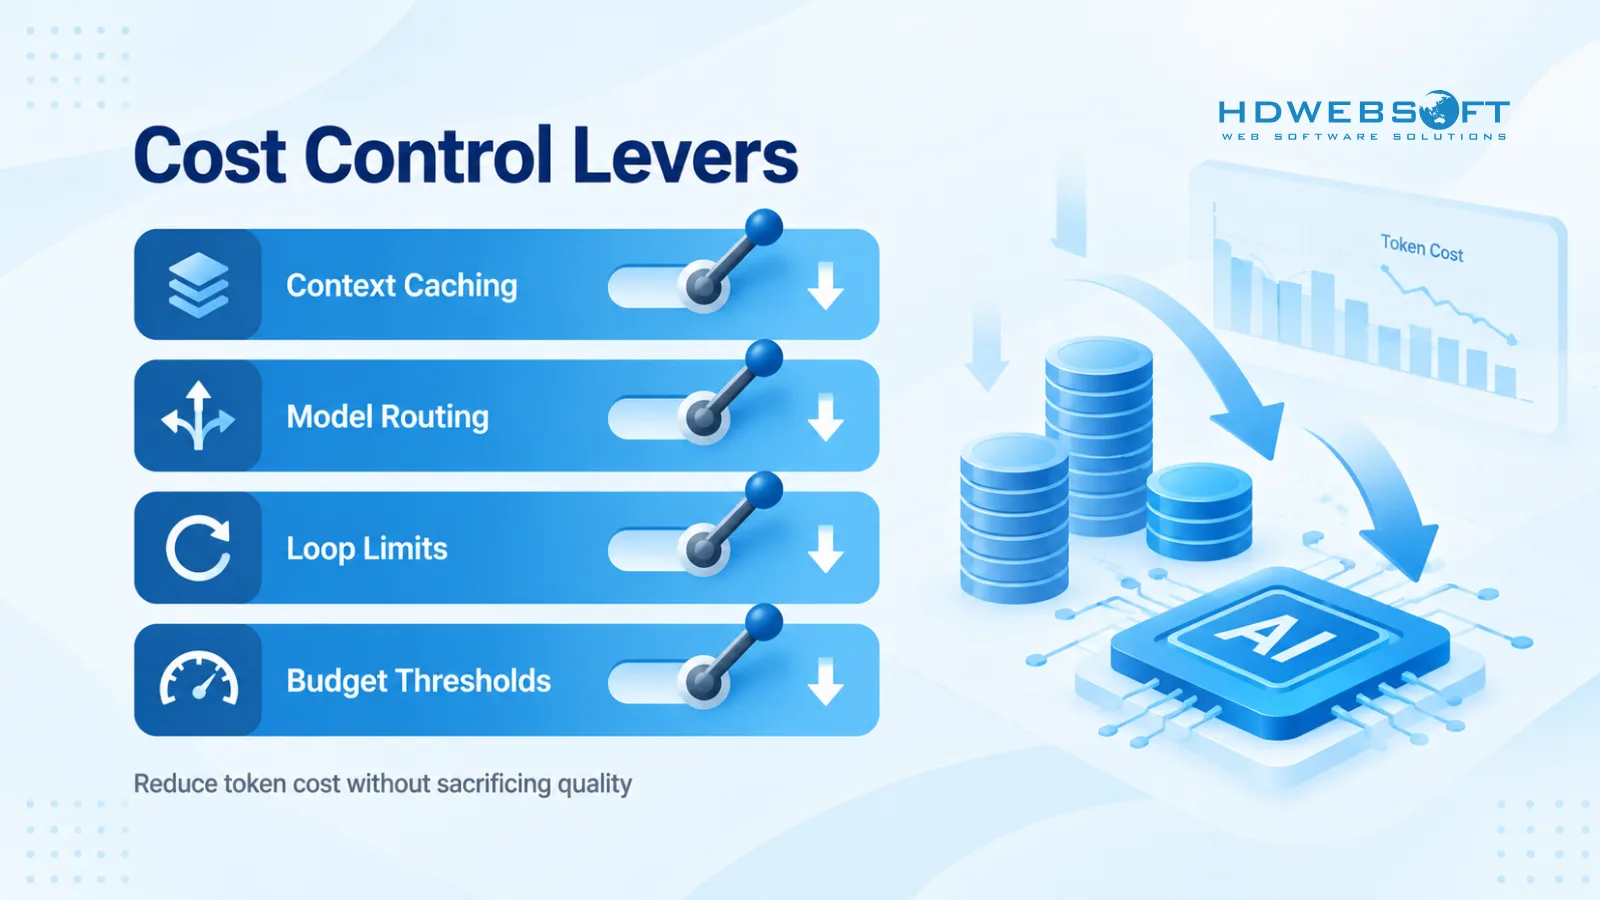
กลไกควบคุมต้นทุน: Context Caching, Model Routing, Loop Limits
กลไกหลายตัวช่วยควบคุมต้นทุน token ใน production:
- Context caching: แคช prompt prefix, ผลลัพธ์ของเครื่องมือ และผลลัพธ์ของ LLM สำหรับข้อมูลนำเข้าที่คล้ายกันเพื่อหลีกเลี่ยงการส่งซ้ำหรือสร้างซ้ำเนื้อหาเดิม
- Model routing: ส่งงานไปยังโมเดลที่เล็กที่สุดที่ตอบโจทย์คุณภาพ การตัดสินใจ routing ควรอิงจากความซับซ้อนของงาน ความเสี่ยง และข้อกำหนดด้านคุณภาพ ไม่ใช่สัดส่วนคงที่เช่น 80% เล็ก 20% ใหญ่
- Loop limits: กำหนดจำนวนรอบสูงสุดต่อเซสชัน เมื่อถึงขีดจำกัดให้ยุติ loop และเลื่อนขั้นไปยังมนุษย์หรือเส้นทางสำรอง
- Prompt compression: สรุปหรือบีบอัดบริบทแทนการส่งประวัติเต็มในแต่ละรอบ
- Batch processing: ย้ายงานที่ไม่ใช่เรียลไทม์ไปเป็นการประมวลผลแบบ batch ที่สามารถปรับต้นทุนได้โดยไม่มีแรงกดดันด้าน latency
การสร้างพยากรณ์ต้นทุน Token ก่อนติดตั้ง
พยากรณ์ต้นทุน token เป็นข้อกำหนดเบื้องต้นสำหรับการติดตั้ง AI agent ใน production ไม่ใช่สิ่งที่ทำภายหลัง สร้างพยากรณ์ก่อนเปิดตัว:
- ประเมิน token เฉลี่ยต่อเซสชัน: รวม system prompt, บริบท, ผลลัพธ์ของเครื่องมือ และผลลัพธ์ รวมถึงการ retry และการแตกสาขา
- คูณด้วยเซสชันที่คาดไว้ต่อวัน: ใช้ปริมาณ production จริง ไม่ใช่ปริมาณนำร่อง
- ปรับใช้ราคาโมเดล: คำนวณต้นทุนรายวันและรายเดือนที่ราคา token ปัจจุบัน
- เพิ่ม buffer สำหรับความแปรปรวน: การใช้งาน production คาดเดาไม่ได้ เพิ่ม buffer สำหรับการเพิ่มขึ้นที่ไม่คาดคิด
- แยกต้นทุนคงที่และต้นทุนผันแปร: ต้นทุนคงที่รวม system prompt และบริบทพื้นฐาน ต้นทุนผันแปรขยายตามจำนวนรอบ, tool calls และการ retry
เมื่อพยากรณ์พร้อมแล้ว ให้กำหนด budget thresholds พร้อมนโยบายการหยุดหรือการเลื่อนขั้น เมื่อการใช้จ่ายข้ามเกณฑ์ ระบบสามารถหยุด agent เลื่อนขั้นไปยังมนุษย์ สลับไปยังโมเดลที่ถูกกว่า หรือแจ้งเตือนทีม — นโยบายขึ้นอยู่กับกรณีการใช้งาน สำคัญคือต้องมีนโยบายก่อนเปิดตัว ไม่ใช่ค้นพบการทะลุงบประมาณหลังใบแจ้งหนี้มาถึง
คอขวดที่ 4: ช่องโหว่ด้านความปลอดภัยและผลลัพธ์ของ Agent ที่ไม่ถูกควบคุม
ความปลอดภัยเป็นคอขวดที่สี่ และเป็นสิ่งที่ทีม application security แบบดั้งเดิมเตรียมพร้อมน้อยที่สุด Agent ไม่ได้สร้างแค่ข้อความ — แต่ยังเรียกเครื่องมือ เข้าถึงข้อมูล และดำเนินการต่างๆ ซึ่งนำเข้ามาซึ่งภัยคุกคามที่การควบคุม AppSec แบบดั้งเดิมไม่ได้ออกแบบให้รองรับ การติดตั้ง AI agent ใน production โดยไม่มี guardrails เฉพาะของ agent จะทำให้องค์กรเปิดเผยต่อ injection attacks, การรั่วไหลของข้อมูล และ unsafe tool calls
Indirect Prompt Injection และ Unsafe Tool Calls
Indirect prompt injection เป็นความเสี่ยงด้านความปลอดภัยหลักของ production agent และเป็นสาเหตุชั้นนำของความล้มเหลวในการติดตั้ง AI agent ต่างจาก direct prompt injection ที่ผู้โจมตีจัดการ prompt โดยตรง การ injection ทางอ้อมจะซ่อนคำสั่งที่เป็นอันตรายไว้ในข้อมูลที่ agent ค้นคืนหรือประมวลผล — เนื้อหาที่ผู้ใช้สร้างขึ้น เอกสารที่ค้นคืน ผลลัพธ์ของเครื่องมือ หรือหน้าเว็บภายนอก
เมื่อ agent อ่านเนื้อหานี้ อาจทำตามคำสั่งที่ถูก inject ราวกับเป็นคำสั่งที่ถูกต้อง agent ที่อ่านอีเมลลูกค้าซึ่งมีคำสั่งซ่อนอยู่อาจรั่วไหลข้อมูล เรียกเครื่องมือที่ละเอียดอ่อน หรือแก้ไขระเบียนที่ไม่ควรกระทำ เนื่องจากการ injection มาผ่านข้อมูล ไม่ใช่ผ่าน prompt โดยตรง การตรวจสอบข้อมูลนำเข้าเพียงอย่างเดียวจึงไม่สามารถจับได้
ความเสี่ยงยิ่งรุนแรงขึ้นเมื่อ agent มีความสามารถในการเรียกเครื่องมือ agent ที่สามารถส่งอีเมล แก้ไขฐานข้อมูล หรือเริ่มการชำระเงินย่อมมีความเสี่ยงสูงกว่า agent ที่สร้างแค่ข้อความ ทุก tool call เป็นการกระทำที่มีผลกระทบจริง และ tool call ที่ไม่ถูกควบคุมสามารถก่อความเสียหายก่อนที่ใครจะสังเกตเห็น
ความเสี่ยงด้านการรั่วไหลของข้อมูลในเวิร์กโฟลว์ Agent
Agent มักเข้าถึงแหล่งข้อมูลหลายแหล่ง — ฐานข้อมูล, API, ที่เก็บไฟล์ — และการเข้าถึงนั้นสร้างความเสี่ยงด้านการรั่วไหล agent ที่สามารถอ่านข้อมูลละเอียดอ่อนและส่งอีเมลหรือเรียก API ภายนอกสามารถรั่วไหลข้อมูลนั้นผ่านผลลัพธ์หรือ tool calls ของตัวเอง
ระบบ multi-agent ขยายความเสี่ยงให้ใหญ่ขึ้น agent A อาจมีการเข้าถึงข้อมูลกว้างขวางเพราะงานของตนต้องการ ขณะที่ agent B มีขอบเขตแคบกว่า หาก agent B สามารถขอข้อมูลจาก agent A และผลลัพธ์ของ agent B ไหลไปยังช่องทางภายนอก ข้อมูลอาจเคลื่อนจาก agent ที่เข้าถึงสูงไปยังปลายทางภายนอกโดยที่ไม่มี agent ใดละเมิดขอบเขตของตนอย่างชัดเจน
มาตรการบรรเทาได้แก่:
- หลักการสิทธิ์น้อยที่สุด: ให้ agent แต่ละตัวเข้าถึงข้อมูลน้อยที่สุดเท่าที่งานต้องการ โดยจำกัดขอบเขตให้แคบที่สุดเท่าที่เป็นไปได้
- การกรองผลลัพธ์: ตรวจสอบผลลัพธ์ของ agent ก่อนถึงช่องทางภายนอก บล็อกเนื้อหาที่มีข้อมูลละเอียดอ่อน
- บันทึกการตรวจสอบ: บันทึกทุก tool call พารามิเตอร์ และผลลัพธ์ เพื่อให้ความพยายามรั่วไหลสามารถสืบย้อนได้
ทำไม AppSec แบบดั้งเดิมจึงจำเป็นแต่ไม่เพียงพอ
application security แบบดั้งเดิมยังคงจำเป็นแต่ไม่เพียงพอสำหรับความเสี่ยงเฉพาะของ agent WAF, การตรวจสอบข้อมูลนำเข้า, authentication และ authorization ยังคงสำคัญ — เป็นรากฐาน แต่ไม่ครอบคลุมภัยคุกคามที่ agent นำเข้ามา:
- Prompt injection ไม่ใช่ code injection แบบดั้งเดิม มันใช้พฤติกรรมการทำตามคำสั่งของโมเดล ไม่ใช่ช่องโหว่ของโค้ด ดังนั้นกฎ WAF และการทำความสะอาดข้อมูลนำเข้าจึงไม่จับได้
- Agent ตัดสินใจเรียกเครื่องมือใด แบบไดนามิก ไม่มีเส้นทางคงที่ให้กรอง — การให้เหตุผลของ agent เองเป็นตัวกำหนดการกระทำ และการควบคุมความปลอดภัยแบบดั้งเดิมไม่สามารถคาดการณ์หรือกรองเส้นทาง tool call ที่เป็นไปได้ทุกเส้นทาง
- ผลลัพธ์ของ agent อาจมีข้อมูลละเอียดอ่อน ที่รั่วไหลผ่าน logs, อีเมล หรือการเรียก API ภายนอก แม้ว่าที่เก็บข้อมูลพื้นฐานจะรักษาความปลอดภัยอย่างถูกต้อง
Guardrails เฉพาะของ agent จำเป็นต้องมีเพิ่มบน AppSec แบบดั้งเดิม: การตรวจสอบผลลัพธ์, tool call allowlists, การอนุมัติโดยมนุษย์สำหรับการกระทำที่ละเอียดอ่อน และบันทึกการตรวจสอบที่สมบูรณ์ สำหรับข้อมูลเชิงลึกเกี่ยวกับโมเดลภัยคุกคามและมาตรการบรรเทาเฉพาะ LLM โปรดดู LLM security สำหรับ agentic AI
วิธีติดตั้ง AI Agent ใน Production อย่างน่าเชื่อถือ
การจัดการคอขวดทั้งสี่ต้องอาศัยแนวทางที่มีโครงสร้าง ผสมผสาน guardrails, caching และ observability แต่ละองค์ประกอบจัดการคอขวดหนึ่งหรือมากกว่า และรวมกันเป็นรากฐานของ production ที่โครงการนำร่องขาด สำหรับทีมที่กำลังเรียนรู้วิธีติดตั้ง AI agent ใน production องค์ประกอบต่อไปนี้เป็นสิ่งจำเป็น
Layered Guardrails: แกนหลักของความน่าเชื่อถือของ Agent
Layered guardrails ผสมผสานการควบคุมหลายประเภท แต่ละประเภทจัดการรูปแบบความล้มเหลวที่แตกต่างกัน:
- การควบคุมแบบ deterministic: การตรวจสอบ schema สำหรับผลลัพธ์, tool call allowlists, loop limits และการตรวจสอบสิทธิ์ เป็นกฎที่ไม่ขึ้นกับโมเดล — บังคับข้อจำกัดไม่ว่า agent จะสร้างอะไรก็ตาม เป็นชั้นแรกของความน่าเชื่อถือของ AI agent
- การตรวจสอบด้วยโมเดลหรือ classifier: content filters, hallucination detectors และ output classifiers ที่จับปัญหาที่กฎ deterministic ไม่ได้ ใช้โมเดลหรือ classifier ที่เล็กกว่าประเมินผลลัพธ์ของ agent ก่อนถึงผู้ใช้หรือเครื่องมือ
- การควบคุมการเข้าถึง: หลักการสิทธิ์น้อยที่สุดสำหรับทุก agent, สิทธิ์เครื่องมือที่จำกัดขอบเขต และขีดจำกัดการเข้าถึงข้อมูลผูกกับบทบาทของ agent
- การอนุมัติโดยมนุษย์: สำหรับการกระทำที่ละเอียดอ่อน — การชำระเงิน, การแก้ไขข้อมูล, การสื่อสารภายนอก — ต้องได้รับการอนุมัติจากมนุษย์อย่างชัดเจนก่อน agent ดำเนินการ
ไม่มีชั้นใดชั้นเดียวที่เพียงพอ กฎ deterministic จับการละเมิด schema และ tool call ที่ไม่ได้รับอนุญาต แต่พลาดปัญหาเนื้อหาที่ละเอียดอ่อน การตรวจสอบด้วยโมเดลจับปัญหาเนื้อหา แต่ตัวมันเองก็อาจเปราะบางต่อข้อมูลนำเข้าที่เป็นปฏิปักษ์ การอนุมัติโดยมนุษย์จับการกระทำที่มีความเสี่ยงสูง แต่ไม่ขยายได้ถึงทุกการตัดสินใจ จุดแข็งของ layered guardrails คือแต่ละชั้นปิดช่องว่างที่อีกชั้นเปิดไว้ ทำให้การติดตั้ง AI agent ใน production น่าเชื่อถือกว่าการควบคุมเดี่ยวใดๆ อย่างมาก
Smart Context Caching เพื่อลด Latency และต้นทุนพร้อมกัน
Context caching จัดการ latency และต้นทุนพร้อมกันโดยลดงานซ้ำซ้อน:
- แคช system prompt และบริบทคงที่: หลีกเลี่ยงการส่ง prompt prefix เดิมในทุกรอบ
- แคชผลลัพธ์ของเครื่องมือ: หากหลายรอบต้องการผลลัพธ์เครื่องมือเดียวกัน ให้แคชไว้แทนการเรียกซ้ำ
- Semantic cache สำหรับผลลัพธ์ LLM: สำหรับข้อมูลนำเข้าที่คล้ายกัน ส่งคืนผลลัพธ์ที่แคชไว้แทนการสร้างใหม่
Caching นำเข้าซึ่งความเสี่ยงของตัวมันเองที่ทีม production ต้องจัดการ:
- การ invalidation แคช: เมื่อข้อมูลพื้นฐานเปลี่ยน ผลลัพธ์ที่แคชต้องถูก invalidation หรือรีเฟรช แคชที่ล้าสมัยนำไปสู่คำตอบที่ผิด
- การแยก tenant: ห้ามส่งผลลัพธ์ที่แคชของ tenant หนึ่งให้อีก tenant หนึ่ง คีย์แคชต้องรวมบริบทของ tenant
- ความสดของข้อมูล: กำหนด TTL ที่สอดคล้องกับความถี่ในการอัปเดตของข้อมูล แคชที่ล้าสมัยเกินไปแย่กว่าไม่มีแคช
- ผลลัพธ์ละเอียดอ่อนหรือมีความเสี่ยงสูง: ห้ามแคชผลลัพธ์ที่มี PII, การตัดสินใจทางการเงิน, คำแนะนำทางการแพทย์ หรือเนื้อหาละเอียดอ่อนอื่นๆ เว้นแต่ชั้น caching มีการควบคุมความปลอดภัยที่เทียบเท่า เมื่อไม่แน่ใจ ห้ามแคช
Observability และ Evaluation ในฐานะข้อกำหนดของ Production
Observability สำหรับ AI agent ต่างจาก application observability แบบดั้งเดิม agent ตัดสินใจแบบไดนามิก เรียกเครื่องมือภายนอก และสร้างผลลัพธ์ที่ยากต่อการตรวจสอบด้วยการตรวจสอบแบบผ่าน/ไม่ผ่านอย่างง่าย การติดตั้ง AI agent ใน production ต้องการ observability ที่ครอบคลุม:
- การตัดสินใจเรียกเครื่องมือ: เครื่องมือใดถูกเรียก ด้วยพารามิเตอร์ใด และผลลัพธ์อะไรกลับมา
- การตัดสินใจ routing: โมเดลหรือสาขาใดถูกเลือกและเพราะเหตุใด
- สถานะระหว่างขั้นตอน: ผลลัพธ์จากแต่ละขั้นตอนใน agent chain ไม่ใช่ chain-of-thought ที่ซ่อนอยู่ของโมเดล
- ข้อมูลเมตาของโมเดลและเครื่องมือ: เวอร์ชันของโมเดล, เวอร์ชันของเครื่องมือ และพารามิเตอร์ที่ใช้ เพื่อให้สามารถสืบย้อนการถดถอยไปยังเวอร์ชันเฉพาะ
- ผลลัพธ์ของ guardrail: แต่ละชั้นผ่านหรือไม่ผ่าน และเหตุผลในการปฏิเสธเมื่อ guardrail บล็อกการกระทำ
- การติดตาม latency และต้นทุน: รายละเอียดเวลาและต้นทุน token ต่อขั้นตอน เพื่อให้คอขวดมองเห็นได้
- ผลลัพธ์สุดท้าย: ผลสุดท้ายของงานของ agent พร้อมสถานะสำเร็จหรือล้มเหลว
การ redact, การจัดประเภทข้อมูล และนโยบายการเก็บรักษาเป็นข้อบังคับ ห้าม log prompt หรือ context แบบเต็มเมื่ออาจมี PII หรือข้อมูลลับ จัดประเภทข้อมูลก่อน log, redact ฟิลด์ละเอียดอ่อน และบังคับขีดจำกัดการเก็บรักษาเพื่อ logs ไม่กลายเป็นภาระ ห้ามพยายาม log chain-of-thought ที่ซ่อนอยู่ของโมเดล — มันไม่สามารถเข้าถึงได้อย่างน่าเชื่อถือ และการบังคับสามารถทำให้คุณภาพผลลัพธ์ลดลง
Evaluation ไม่ได้จำกัดเพียงการทดสอบผลลัพธ์สุดท้าย ทดสอบแต่ละขั้นตอนใน agent chain เพื่อให้การถดถอยถูกจับที่ขั้นตอนที่เกิดขึ้นมากกว่าเฉพาะตอนท้าย ตั้งค่าการแจ้งเตือนสำหรับเมตริก drift, การละเมิด latency budget, ขีดจำกัดต้นทุน และอัตราการปฏิเสธของ guardrail เพื่อให้ปัญหาปรากฏก่อนผู้ใช้จะพบ
Grounding Retrieval เพื่อลด Drift และต้นทุน
Retrieval-augmented generation เมื่อใช้งานอย่างดี สามารถลดทั้ง drift และต้นทุน การ grounding ที่แม่นยำให้ agent บริบทที่เกี่ยวข้องและเป็นปัจจุบัน ซึ่งลดจำนวน reasoning turns ที่ต้องการและโอกาสเกิด hallucination รอบที่น้อยลงหมายถึง token ที่น้อยลงและ latency ที่ต่ำลง การ grounding ยังเสริมคำสั่งเดิมโดยให้บริบทที่สร้างขึ้นจริงที่ยึดเหนี่ยวการให้เหตุผลของ agent
RAG ไม่ใช่สิ่งที่ได้ประโยชน์โดยไม่มีต้นทุน — มันเพิ่ม overhead ของ retrieval และนำเข้ารูปแบบความล้มเหลวของตัวเองหากคุณภาพ retrieval ต่ำ แต่ retrieval ที่ออกแบบดีสามารถลด retry และ reasoning loops สร้างประโยชน์สุทธิสำหรับ drift, ต้นทุน และ latency สำหรับข้อมูลเชิงลึกเกี่ยวกับ retrieval orchestration, evaluation และ grounding โปรดดู retrieval orchestration และ grounding ใน agentic RAG
HDWEBSOFT ช่วยลดความเสี่ยงในการเปิดตัว AI Agent ใน Production อย่างไร
HDWEBSOFT ช่วยทีมย้าย AI agent จากการนำร่องสู่ production ผ่านกรอบการเปิดตัวที่มีโครงสร้างสำหรับการติดตั้งที่มีขอบเขตชัดเจน กรอบการทำงานนี้ไม่ใช่แพ็กเกจขอบเขตและเส้นเวลาคงที่ — เป็นแนวทางแบบเป็นขั้นที่ปรับตามความซับซ้อนของกรณีการใช้งาน ความเป็นผู้ใหญ่ของตรรกะ agent ที่มีอยู่ และความพร้อม production ขององค์กร สำหรับการติดตั้ง AI agent สำหรับองค์กร แนวทางที่มีโครงสร้างนี้ช่วยทีมหลีกเลี่ยงคอขวดทั้งสี่ตั้งแต่วันแรก
กรอบการเปิดตัวครอบคลุมอะไรบ้าง
กรอบการทำงานครอบคลุมองค์ประกอบที่การติดตั้ง AI agent ใน production ต้องการแต่โครงการนำร่องมักข้ามไป:
- การออกแบบสถาปัตยกรรม: สถาปัตยกรรมที่พร้อมสำหรับ production ที่คำนึงถึง guardrails, observability และการควบคุมต้นทุนตั้งแต่แรกเริ่ม
- การใช้งาน layered guardrails: การควบคุมแบบ deterministic, การตรวจสอบด้วยโมเดล, การควบคุมการเข้าถึง และประตูอนุมัติโดยมนุษย์ที่ปรับให้เหมาะกับโปรไฟล์ความเสี่ยงของกรณีการใช้งาน
- การตั้งค่า context caching: กลยุทธ์ caching พร้อมการ invalidation, การแยก tenant และการจัดการผลลัพธ์ละเอียดอ่อน
- Observability stack: การ log, การแจ้งเตือน และการประเมิน พร้อมการ redact, การจัดประเภทข้อมูล และนโยบายการเก็บรักษาที่สร้างเข้าไป
- การเปิดตัวที่ควบคุม: การติดตั้งแบบเป็นขั้นที่เริ่มจากขอบเขตแคบและขยายตามผลลัพธ์ที่พิสูจน์แล้ว
กรอบการทำงานเหมาะกับกรณีการใช้งานที่มีขอบเขตชัดเจนและมีตรรกะ agent ที่มีอยู่หรือง่าย ไม่ใช่การสร้างจากศูนย์แบบรวดเร็ว — เป็นเส้นทางที่มีโครงสร้างสู่ production สำหรับ agent ที่พิสูจน์คุณค่าในการนำร่องแล้วและต้องการความเข้มข้นทางวิศวกรรมเพื่ออยู่รอดในขนาดใหญ่
แนวทางแบบเป็นขั้น ไม่ใช่เส้นเวลาคงที่
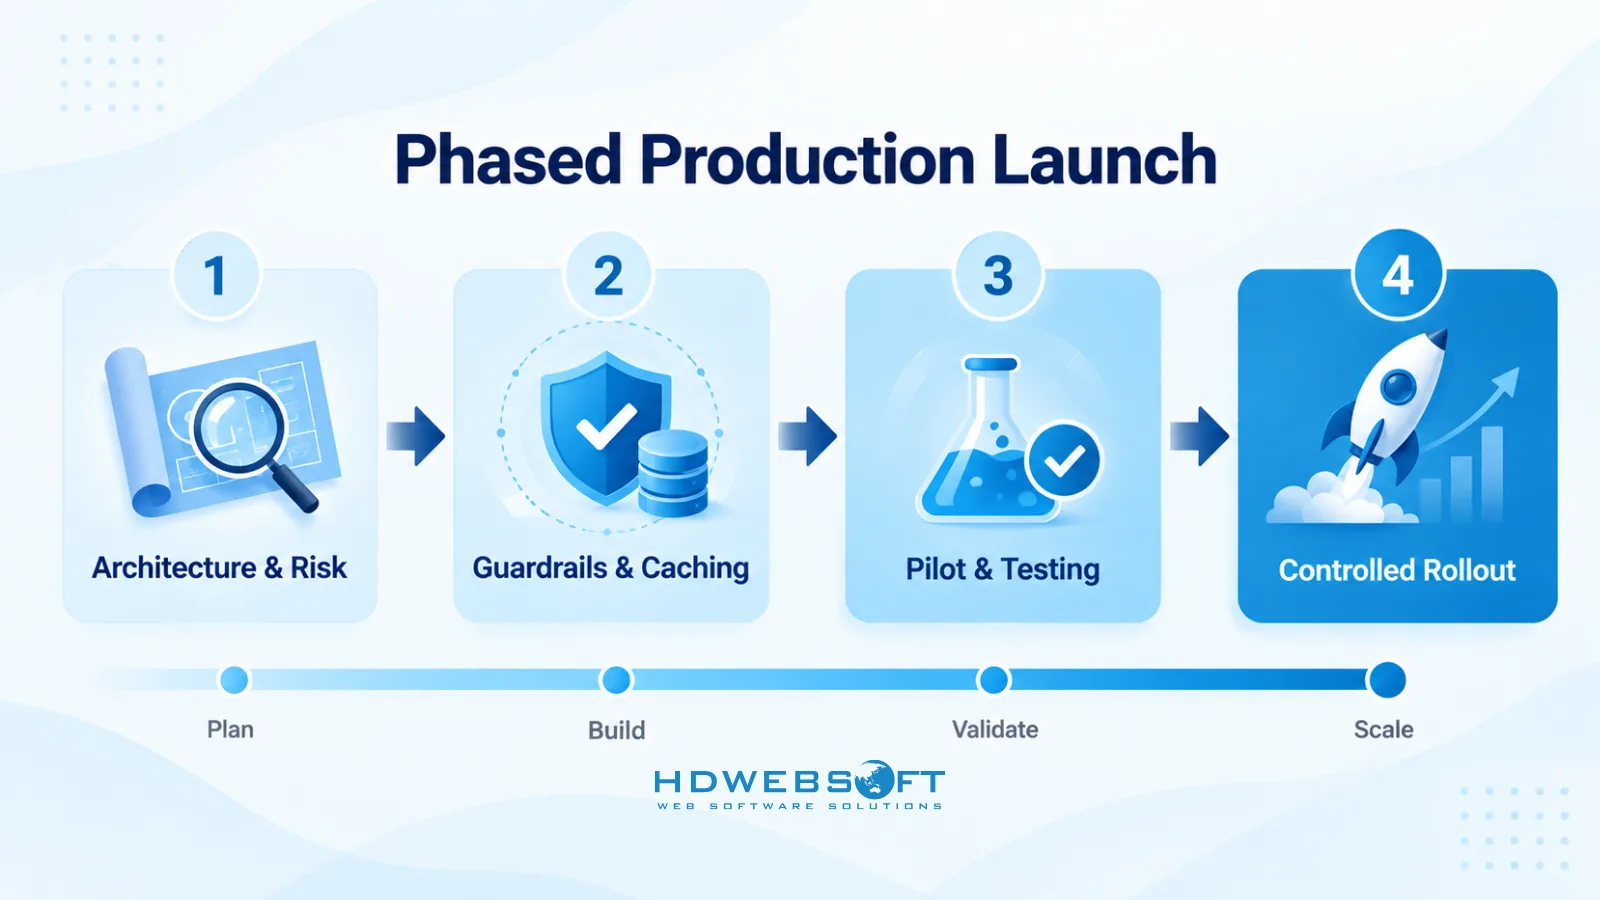
การเปิดตัวใช้แนวทางแบบเป็นขั้นมากกว่าเส้นเวลาคงที่ ขั้นตอนได้แก่:
- การประชุมสถาปัตยกรรมและการประเมินความเสี่ยง: กำหนดกรณีการใช้งาน, เมตริกความสำเร็จ, โปรไฟล์ความเสี่ยง และข้อกำหนด production ระบุว่าคอขวดใด — drift, latency, ต้นทุน, ความปลอดภัย — เกี่ยวข้องมากที่สุดกับการติดตั้ง
- การใช้งาน guardrails, caching และ observability: สร้างรากฐาน production ก่อน agent สัมผัสการใช้งานจริง layered guardrails, caching พร้อมการ invalidation และ observability พร้อมการ redact ถูกตั้งค่าในขั้นตอนนี้
- การติดตั้งนำร่องและการทดสอบ: ติดตั้ง agent ในสภาพแวดล้อมที่ควบคุมซึ่งสะท้อน production โดยมี guardrails และ observability ทำงานเต็มรูปแบบ ทดสอบกับภาระที่สมจริง, edge cases และรูปแบบความล้มเหลว
- การเปิดตัวที่ควบคุมและการติดตาม: เปิดตัวอย่างค่อยเป็นค่อยไป ติดตามเมตริก drift, latency, ต้นทุน และผลลัพธ์ guardrail และขยายขอบเขตตามผลลัพธ์ที่พิสูจน์แล้ว
ระยะเวลาของแต่ละขั้นตอนขึ้นอยู่กับความซับซ้อนของกรณีการใช้งาน ความเป็นผู้ใหญ่ของตรรกะ agent ที่มีอยู่ และความพร้อม production ขององค์กร กรอบการทำงานให้โครงสร้างและระเบียบวิธี ไม่ใช่ตารางเวลาที่แข็งทื่อ
ทำไมการเปิดตัวที่มีโครงสร้างจึงลดความเสี่ยงของการติดตั้งใน Production
การเปิดตัวที่มีโครงสร้างลดความเสี่ยงของการติดตั้ง AI agent ใน production ในหลายด้าน:
- ความชัดเจนของขอบเขต: กรณีการใช้งานที่มีขอบเขตชัดเจนป้องกัน scope creep ซึ่งเป็นสาเหตุที่พบบ่อยที่สุดที่ทำให้การติดตั้งใน production เกินงบประมาณและเส้นเวลา
- โฟกัสกรณีการใช้งานที่มีคุณค่าสูงหนึ่งกรณี: แทนที่จะพยายามติดตั้ง agent ทุกตัวพร้อมกัน กรอบการทำงานโฟกัสกรณีการใช้งานหนึ่งที่โอกาสสำเร็จสูงและคุณค่าสูงสุด
- Guardrails และ observability ตั้งแต่แรก: รากฐาน production ถูกสร้างก่อนเปิดตัว ไม่ใช่เสริมภายหลังอุบัติการณ์แรก
- พื้นฐานสำหรับการขยายขนาด: การเปิดตัวที่ควบคุมที่สำเร็จให้พื้นฐาน — เมตริก, ขีดจำกัด guardrail, รูปแบบต้นทุน — ที่การตัดสินใจขยายขนาดในอนาคตพึ่งพา
สำหรับทีมที่พร้อมย้ายจากการนำร่องสู่ production ขั้นต่อไปคือการประชุมสถาปัตยกรรมทางเทคนิคกับผู้นำ AI ของเราเพื่อจัดทำแผนกรณีการใช้งาน ระบุคอขวดที่เกี่ยวข้อง และกำหนดข้อกำหนด production จองประชุมสถาปัตยกรรมทางเทคนิคกับผู้นำ AI ของเรา เพื่อเริ่มการสนทนา
บทสรุป
การติดตั้ง AI agent ใน production เป็นระเบียบวิธีทางวิศวกรรม ไม่ใช่ความสามารถของโมเดล คอขวดทั้งสี่ — prompt drift, API latency, token cost และช่องโหว่ด้านความปลอดภัย — สามารถคาดการณ์ วินิจฉัย และแก้ไขได้ แต่ต่อเมื่อทีมออกแบบรองรับไว้ก่อน production มากกว่าหลังอุบัติการณ์แรก การติดตั้ง AI agent ที่สำเร็จต้องการ layered guardrails, smart context caching และ structured observability ตั้งแต่แรกเริ่ม
Layered guardrails, smart context caching พร้อมการ invalidation และการแยก tenant ที่เหมาะสม และ structured observability พร้อมการ redact และนโยบายการเก็บรักษา เป็นรากฐานของ production ที่โครงการนำร่องขาด พยากรณ์ต้นทุน token พร้อม budget thresholds และนโยบายการหยุดหรือการเลื่อนขั้นเป็นข้อกำหนดเบื้องต้น ไม่ใช่สิ่งที่ทำภายหลัง และกรอบการเปิดตัวที่มีโครงสร้าง — แบบเป็นขั้น ไม่ใช่เส้นเวลาที่แข็งทื่อ — ให้ระเบียบวิธีแก่ทีมในการติดตั้งกรณีการใช้งานหนึ่งให้ดีก่อนขยายไปยังกรณีถัดไป
HDWEBSOFT ช่วยทีมสำรวจการเปลี่ยนผ่านนี้ด้วยกรอบการเปิดตัวแบบเป็นขั้นที่สร้างรากฐาน production ก่อน agent สัมผัสการใช้งานจริง สำหรับองค์กรที่พร้อมก้าวต่อ ขั้นถัดไปคือการประชุมสถาปัตยกรรมทางเทคนิคเพื่อกำหนดกรณีการใช้งาน ระบุคอขวดที่เกี่ยวข้อง และวางแผนการติดตั้ง
คำถามที่พบบ่อย
การติดตั้ง AI agent ใน production คืออะไร?
การติดตั้ง AI agent ใน production คือการดูแลระบบ AI อัตโนมัติที่ให้เหตุผล เรียกใช้เครื่องมือ และดำเนินการต่างๆ ภายใต้ภาระงานจริง ผู้ใช้จริง และผลกระทบจริง ต้องการ layered guardrails, observability, การควบคุมต้นทุน และขั้นตอน rollback ที่โครงการนำร่องมักขาด การติดตั้ง AI agent ที่สำเร็จถือว่าความน่าเชื่อถือ ความปลอดภัย และการควบคุมต้นทุนเป็นข้อกำหนดทางวิศวกรรมหลัก
ทำไมโครงการนำร่อง AI agent จึงล้มเหลวเมื่อย้ายสู่ production?
โครงการนำร่องล้มเหลวใน production เนื่องจากคอขวดทางเทคนิคสี่ประการ: prompt drift, API latency, token cost และช่องโหว่ด้านความปลอดภัย ทีมประเมินความเสี่ยงเหล่านี้ต่ำเกินไปเพราะโครงการนำร่องรันในสภาพแวดล้อมที่ควบคุม มีผู้ใช้น้อย มี edge case น้อย และไม่มีแรงกดดันด้านต้นทุนจริง หากไม่มี guardrails, observability และพยากรณ์ต้นทุนที่ออกแบบสำหรับ production การติดตั้ง AI agent จะล้มเหลวเมื่อ agent เบี่ยงเบน ชะลอตัว เผาผลาญ token และรั่วไหลข้อมูล
Prompt drift คืออะไรและจะควบคุมอย่างไร?
Prompt drift หรือที่เรียกว่า context หรือ instruction drift คือการสูญเสียการยึดมั่นในคำสั่งอย่างค่อยเป็นค่อยไปเมื่อ agent ประมวลผลเซสชันที่ยาวขึ้นหรือ multi-turn loops เกิดจากการเติบโตของบริบท การตัดทอน คำสั่งที่ขัดแย้งกัน หน่วยความจำเดิม และผลลัพธ์ระหว่างขั้นตอน ควบคุมโดยฉีดข้อจำกัดซ้ำเป็นช่วงๆ จัดการหน้าต่างบริบท เพิ่ม deterministic checkpoints และตรวจจับ drift ด้วยสัญญาณหลายตัว — อัตราความสำเร็จของงาน อัตราการละเมิดข้อจำกัด ความถูกต้องของ tool-call, regression evals และระยะทางเชิงความหมาย
การรัน AI agent ใน production มีต้นทุนเท่าใด?
ต้นทุนขึ้นอยู่กับ token เฉลี่ยต่อเซสชัน เซสชันต่อวัน และราคาโมเดล multi-agent loops สามารถขับดันต้นทุนให้เพิ่มขึ้นอย่างรวดเร็วหรือแบบ superlinear เนื่องจากบริบทที่ซ้ำกัน การ retry และการแตกสาขา สร้างพยากรณ์ต้นทุน token ก่อนเปิดตัวและกำหนด budget thresholds พร้อมนโยบายการหยุดหรือการเลื่อนขั้น เพื่อให้การทะลุงบประมาณถูกจับก่อนใบแจ้งหนี้มาถึง
Layered guardrails สำหรับ AI agent คืออะไร?
Layered guardrails ผสมผสานการควบคุมหลายประเภท: กฎ deterministic (การตรวจสอบ schema, tool call allowlists, loop limits, การตรวจสอบสิทธิ์), การตรวจสอบด้วยโมเดลหรือ classifier (content filters, hallucination detectors), การควบคุมการเข้าถึง (สิทธิ์น้อยที่สุด, สิทธิ์เครื่องมือที่จำกัดขอบเขต) และการอนุมัติโดยมนุษย์สำหรับการกระทำที่ละเอียดอ่อน ไม่มีชั้นใดชั้นเดียวที่เพียงพอ — แต่ละชั้นปิดช่องว่างที่อีกชั้นเปิดไว้ และรวมกันเป็นแกนหลักของความน่าเชื่อถือของ AI agent ใน production
กรอบการเปิดตัว AI agent ของ HDWEBSOFT ทำงานอย่างไร?
กรอบการเปิดตัวของ HDWEBSOFT เป็นแนวทางแบบเป็นขั้นสำหรับการติดตั้งที่มีขอบเขตชัดเจน: การประชุมสถาปัตยกรรมและการประเมินความเสี่ยง, การใช้งาน guardrails และ caching และ observability, การติดตั้งนำร่องและการทดสอบ และการเปิดตัวที่ควบคุมและการติดตาม กรอบการทำงานปรับตามความซับซ้อนของกรณีการใช้งานและความพร้อมขององค์กร มากกว่าจะตามเส้นเวลาคงที่ สำหรับการติดตั้ง AI agent สำหรับองค์กร แนวทางที่มีโครงสร้างนี้ช่วยทีมหลีกเลี่ยงคอขวดทั้งสี่ตั้งแต่ต้น