La distribuzione di agenti IA è il punto in cui la maggior parte dei piloti promettenti si interrompe. Una demo che risponde a domande in un ambiente controllato raramente sopravvive al contatto con utenti reali, dati reali e budget reali. Gartner prevede che oltre il 40% dei progetti di IA agentica sarà cancellato entro la fine del 2027, con l’aumento dei costi e l’inadeguatezza dei controlli dei rischi tra le cause principali. Il divario tra pilota e IA agentica in produzione non è solo un problema tecnologico — è un problema di disciplina ingegneristica che pochi team anticipano prima di arrivare in produzione.
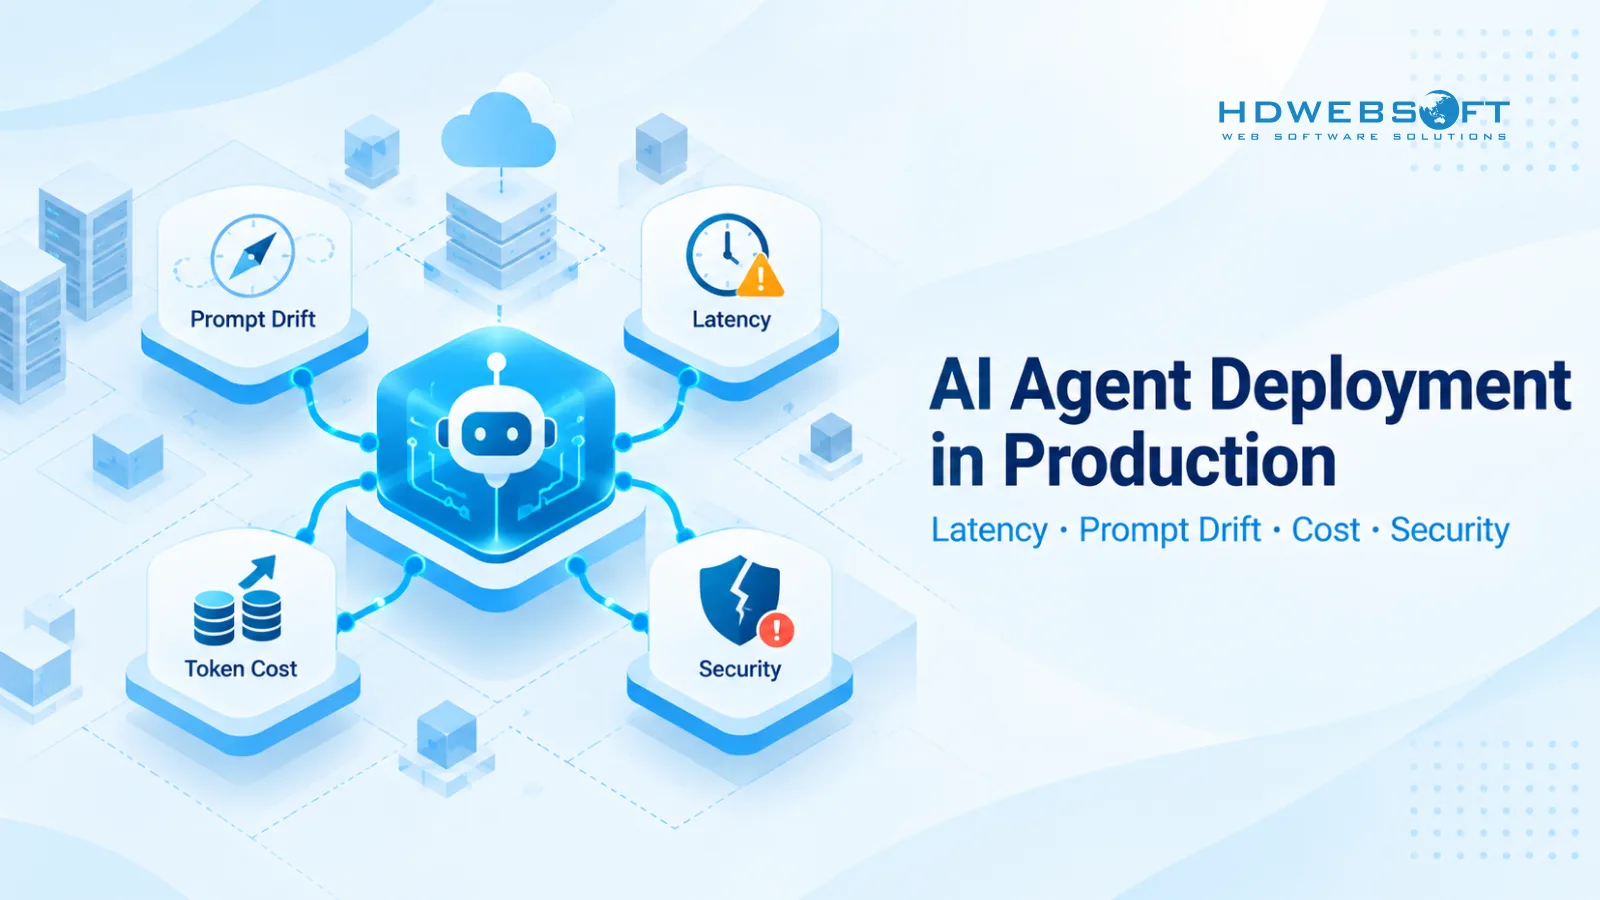
I piloti hanno successo perché girano in ambienti controllati con pochi utenti, pochi casi limite e nessuna reale pressione sui costi. La produzione espone gli agenti a picchi di traffico, input ambigui, contenuti avversari e vincoli di budget che i piloti non simulano mai. Senza guardrail, osservabilità e controlli dei costi progettati per la produzione fin dall’inizio, gli agenti subiscono deriva, rallentano, consumano token e perdono dati. Questo articolo analizza i quattro colli di bottiglia tecnici che compromettono la distribuzione di agenti IA in produzione — deriva dei prompt, latenza delle API, costi dei token e gap di sicurezza — e spiega come guardrail a strati, smart context caching e osservabilità strutturata aiutino i team a distribuire agenti IA in produzione in modo affidabile.
Punti chiave
- Gartner prevede che oltre il 40% dei progetti di IA agentica sarà cancellato entro la fine del 2027, con l’aumento dei costi e l’inadeguatezza dei controlli dei rischi tra le cause principali.
- Quattro colli di bottiglia tecnici compromettono le distribuzioni in produzione: deriva dei prompt, latenza delle API, costi dei token e gap di sicurezza.
- I guardrail a strati — che combinano regole deterministiche, controlli basati su modello, controllo degli accessi e approvazione umana — costituiscono la spina dorsale dell’affidabilità degli agenti IA.
- I cicli multi-agente possono far crescere i costi dei token rapidamente o in modo superlineare a causa di contesto ripetuto, tentativi e diramazioni; limiti dei cicli, routing dei modelli e context caching sono leve essenziali.
- Una previsione dei costi dei token con soglie di budget e una politica di stop o escalation è un prerequisito per la distribuzione in produzione, non un ripensamento.
- L’osservabilità per gli agenti IA richiede redazione, classificazione dei dati e politica di conservazione — non registrare mai prompt o contesto completi quando sono presenti PII o segreti.
Cosa significa davvero distribuire agenti IA in produzione
La distribuzione di agenti IA in produzione non è semplicemente eseguire un modello su un server. Significa gestire un sistema autonomo che ragiona, chiama strumenti e compie azioni sotto carico reale, con utenti reali e conseguenze reali. La produzione significa che il sistema deve rimanere affidabile, sicuro e sotto controllo dei costi quando il traffico subisce picchi, gli input diventano disordinati e i budget si restringono.
Pilota contro produzione: il divario che uccide i progetti
Il divario tra pilota e produzione è il punto in cui la maggior parte dei progetti muore. I piloti girano in ambienti controllati con pochi utenti, pochi casi limite e nessuna reale pressione sui costi. La produzione espone gli agenti a picchi di traffico, input ambigui, contenuti avversari e vincoli di budget che i piloti non simulano mai.
| Dimensione | Pilota | Produzione |
|---|---|---|
| Utenti | Una manciata di tester | Migliaia o più, pattern imprevedibili |
| Casi limite | Curati, limitati | Illimitati, avversari |
| SLA | Best-effort | Contrattuali o legati alle aspettative degli utenti |
| Budget | Tollerante | Limiti rigidi, avvisi sui costi, escalation |
| Osservabilità | Ispezione manuale | Dashboard in tempo reale, avvisi, audit trail |
| Rollback | Riavviare la demo | Rollback controllato, impostazioni fail-safe |
I team che trattano i piloti come esperimenti piuttosto che come prototipi di produzione raramente hanno successo nel ridimensionamento. I team più efficaci progettano per la produzione fin dall’inizio, costruendo guardrail, osservabilità e controlli dei costi come requisiti fondamentali anziché ripensamenti.
I quattro colli di bottiglia tecnici che compromettono le distribuzioni in produzione
Quando gli agenti passano dal pilota alla produzione, quattro colli di bottiglia tecnici sono responsabili della maggior parte degli insuccessi nella distribuzione di agenti IA:
- Deriva dei prompt — gli agenti perdono gradualmente aderenza alle istruzioni originali man mano che il contesto cresce e gli output intermedi si accumulano.
- Latenza delle API — le chiamate sequenziali tra inferenza LLM, chiamate agli strumenti e orchestrazione accumulano latenza che compromette i flussi di lavoro in tempo reale.
- Costi dei token — cicli multi-agente, tentativi e diramazioni fanno crescere rapidamente o in modo superlineare l’uso dei token.
- Gap di sicurezza — prompt injection indiretta, chiamate agli strumenti non sicure e rischi di esfiltrazione dei dati che la sicurezza applicativa tradizionale non copre pienamente.
Ciascun collo di bottiglia è prevedibile, diagnosticabile e affrontabile — ma solo se i team li progettano prima della produzione, non dopo. Per la distribuzione di agenti IA aziendali, questi quattro problemi sono responsabili della maggior parte degli insuccessi in produzione.
Collo di bottiglia 1: la deriva dei prompt erode l’affidabilità dell’agente
La deriva dei prompt, detta anche deriva di contesto o di istruzioni, è la perdita graduale di aderenza alle istruzioni man mano che un agente elabora conversazioni più lunghe o cicli multi-turno. L’agente inizia allineato alle proprie istruzioni originali, ma man mano che l’interazione cresce, i suoi output divergono sempre più dal comportamento previsto.
Cosa causa la deriva dei prompt nei cicli multi-turno degli agenti
Diversi meccanismi generano la deriva dei prompt nella distribuzione di agenti IA in produzione:
- Crescita del contesto: man mano che una conversazione o un ciclo di agente si estende, la finestra di contesto si riempie di output intermedi, risultati di chiamate agli strumenti e messaggi degli utenti. Il prompt di sistema originale e i vincoli occupano una quota decrescente dell’attenzione del modello.
- Troncamento: quando il contesto supera la finestra del modello, i contenuti più datati — spesso incluse istruzioni critiche — vengono troncati o riassunti, perdendo fedeltà.
- Istruzioni in conflitto: nuove istruzioni provenienti da output degli strumenti, messaggi degli utenti o altri agenti possono entrare in conflitto con il prompt di sistema originale e il modello può seguire l’istruzione più recente senza regole di precedenza esplicite.
- Memoria obsoleta: le informazioni memorizzate in memoria o nei sistemi di retrieval possono diventare datate, portando l’agente ad agire su un contesto che non riflette più la realtà.
- Output intermedi: gli output dei passaggi precedenti in una catena multi-agente influenzano il ragionamento nei passaggi successivi. Se un output iniziale è sottilmente errato, l’errore si propaga a valle.
Nessuno di questi meccanismi richiede che il modello “preferisca il contesto recente” — emergono dalle realtà pratiche della gestione del contesto, del troncamento e del puro volume di contenuti intermedi che gli agenti in produzione generano.
Come la deriva dei prompt degrada la qualità degli output nel tempo
Le conseguenze della deriva si propagano in sessioni lunghe e catene multi-agente, minando l’affidabilità degli agenti IA. Gli agenti iniziano a produrre allucinazioni, a chiamare gli strumenti sbagliati, a violare i vincoli o a perdere di vista l’obiettivo originale. Nei cicli multi-agente, la deriva è particolarmente pericolosa: l’agente A passa il contesto all’agente B, che lo passa all’agente C, e ogni passaggio introduce un’ulteriore occasione di perdita di istruzioni.
Nei log di produzione, la deriva si manifesta come un degrado sottile della qualità, facile da non notare. Gli output possono ancora sembrare plausibili in superficie, ma non soddisfano più i vincoli originali — un agente di supporto clienti inizia a omettere le dichiarazioni obbligatorie, un agente di analisi dati comincia a omettere gli intervalli di confidenza o un agente di coding smette di seguire la guida di stile del team. Senza metriche di rilevamento della deriva, queste regressioni spesso passano inosservate finché un utente non si lamenta o un audit non rileva la lacuna.
Rilevare e contenere la deriva dei prompt
Controllare la deriva richiede sia prevenzione sia rilevamento. Le tecniche di prevenzione includono:
- Re-iniezione periodica: re-iniettare il prompt di sistema e i vincoli critici a intervalli regolari, anziché affidarsi al fatto che il prompt originale rimanga visibile per tutta una sessione lunga.
- Gestione della finestra di contesto: riassumere o potare i contenuti intermedi per mantenere le istruzioni originali in evidenza. Conservare solo ciò che serve al passo successivo.
- Checkpoint deterministici: validare l’output dell’agente a ogni turno rispetto ai vincoli originali, non solo alla fine della sessione.
Il rilevamento richiede molteplici segnali, non una singola metrica. Un rilevamento efficace della deriva combina:
- Tasso di successo del task: l’agente completa ancora correttamente il proprio task?
- Tasso di violazione dei vincoli: con quale frequenza l’agente infrange regole esplicite?
- Correttezza delle chiamate agli strumenti: vengono chiamati gli strumenti giusti con i parametri giusti?
- Valutazioni di regressione: eseguire periodicamente una suite di valutazione fissa per cogliere regressioni di qualità rispetto a una baseline nota.
- Distanza semantica: misurare quanto gli output si sono allontanati dal comportamento previsto, come uno dei tanti segnali.
Nessuna singola metrica coglie tutta la deriva. I team che si affidano solo alla distanza semantica o solo al tasso di successo del task perderanno regressioni che gli altri segnali colgono. Un approccio multi-segnale è l’unico modo affidabile per rilevare la deriva nella distribuzione di agenti IA in produzione.
Collo di bottiglia 2: la latenza delle API compromette i flussi di lavoro in tempo reale degli agenti
La latenza è il secondo collo di bottiglia che compromette le distribuzioni in produzione. I flussi di lavoro degli agenti concatenano molteplici chiamate — inferenza LLM, esecuzione di strumenti, retrieval, orchestrazione — e la latenza si accumula a ogni passo sequenziale. Quando entrano in gioco diramazioni o tentativi, il tempo di risposta totale può crescere sensibilmente, rendendo più difficile mantenere la distribuzione di agenti IA in produzione entro tempi di risposta accettabili.
Dove si nasconde la latenza nelle catene di chiamate degli agenti
La latenza nella distribuzione di agenti IA proviene da diverse fonti:
- Inferenza LLM: il tempo di generazione del modello stesso, che scala con la lunghezza dell’output e le dimensioni del modello.
- Latenza delle chiamate agli strumenti: API esterne, database e servizi che l’agente chiama, ciascuno dei quali aggiunge tempo di round-trip.
- Overhead di retrieval RAG: il retrieval, l’embedding e il ranking aggiungono tempo prima ancora che il modello inizi a generare.
- Orchestrazione multi-agente: il coordinamento tra agenti — routing, passaggi, aggregazione dei risultati — aggiunge overhead oltre la latenza delle singole chiamate.
- Serializzazione e deserializzazione: la conversione tra formati per ogni chiamata aggiunge ritardi piccoli ma cumulativi.
In un ciclo multi-agente, la latenza si accumula lungo le chiamate sequenziali. Se ogni passo richiede alcuni secondi e il ciclo esegue diversi passi, il tempo di risposta totale può raggiungere decine di secondi. Le diramazioni — in cui un agente prova approcci multipli — e i tentativi — in cui un agente ritenta un passo fallito — possono spingere la latenza totale ancora più in alto. Come esempio illustrativo, una singola chiamata di agente potrebbe richiedere dai 3 agli 8 secondi e una catena multi-agente di diversi passi potrebbe arrivare dai 30 ai 60 secondi. Questi numeri sono esempi, non valori universali — la latenza effettiva dipende dalla scelta del modello, dalle prestazioni degli strumenti e dal design dell’orchestrazione.
Budget di latenza per agenti IA in produzione
Un budget di latenza è il tempo di risposta massimo accettabile per un dato task, ripartito tra i passi della catena di agenti. Senza un budget, i team non hanno modo di decidere quando la latenza è accettabile o quando l’architettura deve cambiare.
Esempi di budget di latenza — sono illustrativi, non SLA universali:
- Interazioni in tempo reale (es. chat, supporto live): sotto i 5 secondi
- Task quasi in tempo reale (es. analisi dati, generazione di report): sotto i 30 secondi
- Task in background (es. elaborazione batch, agenti pianificati): sotto i 5 minuti
Una volta fissato il budget, lo si ripartisce tra i passi della catena di agenti. Se il totale stimato supera il budget, l’architettura deve cambiare — parallelizzare le chiamate agli strumenti, accorciare il ragionamento, instradare i task più semplici verso modelli più veloci o spostare il lavoro in elaborazione in background.
Ridurre la latenza senza sacrificare la profondità di ragionamento
Diverse tecniche riducono la latenza senza forzare l’agente a ragionare meno in profondità:
- Risposte in streaming: trasmettere l’output all’utente man mano che viene generato, così l’utente vede l’avanzamento invece di attendere una risposta completa.
- Routing dei modelli: instradare i task semplici verso modelli più piccoli e veloci e riservare i modelli grandi ai task che richiedono un ragionamento più profondo. Le decisioni di routing dovrebbero basarsi sulla complessità del task, sul rischio e sui requisiti di qualità — non su un rapporto fisso.
- Chiamate agli strumenti in parallelo: eseguire le chiamate indipendenti agli strumenti in parallelo anziché in sequenza, riducendo il tempo totale di attesa.
- Caching: memorizzare nella cache gli output LLM e i risultati degli strumenti per input simili, per evitare chiamate ridondanti.
- Esecuzione speculativa (opzionale, avanzata): per i passi con pattern prevedibili, eseguire i passi probabilmente successivi prima che il passo corrente sia completato.
La generazione aumentata da retrieval illustra bene il compromesso sulla latenza. Il RAG aggiunge overhead di retrieval, ma un buon grounding può ridurre il numero di tentativi e di cicli di ragionamento necessari a un agente, il che può abbassare la latenza totale. L’effetto netto dipende dall’implementazione — il RAG non riduce sempre la latenza, ma un retrieval ben progettato può farlo.
Collo di bottiglia 3: esplosione dei costi dei token nei cicli multi-agente
Il costo dei token è il collo di bottiglia che coglie i team di sorpresa. I piloti girano con pochi utenti e pochi casi limite, quindi l’uso dei token rimane gestibile. La produzione scala l’uso e i cicli multi-agente amplificano i costi in modi che i dati del pilota non avevano mai rivelato. Senza una previsione dei costi, la distribuzione di agenti IA in produzione può esaurire i budget prima che chiunque se ne accorga.
Perché i cicli multi-agente consumano token in modo imprevedibile
I cicli multi-agente fanno crescere i costi dei token rapidamente o in modo superlineare nella distribuzione di agenti IA a causa di diversi fattori:
- Contesto ripetuto: ogni turno in un ciclo reinvia il contesto — prompt di sistema, cronologia della conversazione, risultati degli strumenti — al modello. Man mano che il contesto cresce, ogni turno costa più token del precedente.
- Tentativi: quando un agente produce un output non valido, il ciclo ritenta, inviando di nuovo il contesto completo più il feedback dell’errore.
- Diramazioni: quando un agente prova approcci multipli, ogni diramazione consuma token e può essere usato solo l’output di una diramazione.
- Scambi multi-agente: gli agenti che comunicano tra loro consumano token per ogni messaggio, aggiungendo overhead che i sistemi a singolo agente non hanno.
Come esempio illustrativo, una sessione pilota potrebbe usare 5.000 token. A 1.000 sessioni al giorno in produzione, diventano 5 milioni di token al giorno — e questo prima di contare tentativi, diramazioni e crescita del contesto che il traffico di produzione introduce. Il costo può crescere rapidamente o in modo superlineare, non linearmente, quando questi fattori si combinano.
Leve di costo: context caching, routing dei modelli, limiti dei cicli
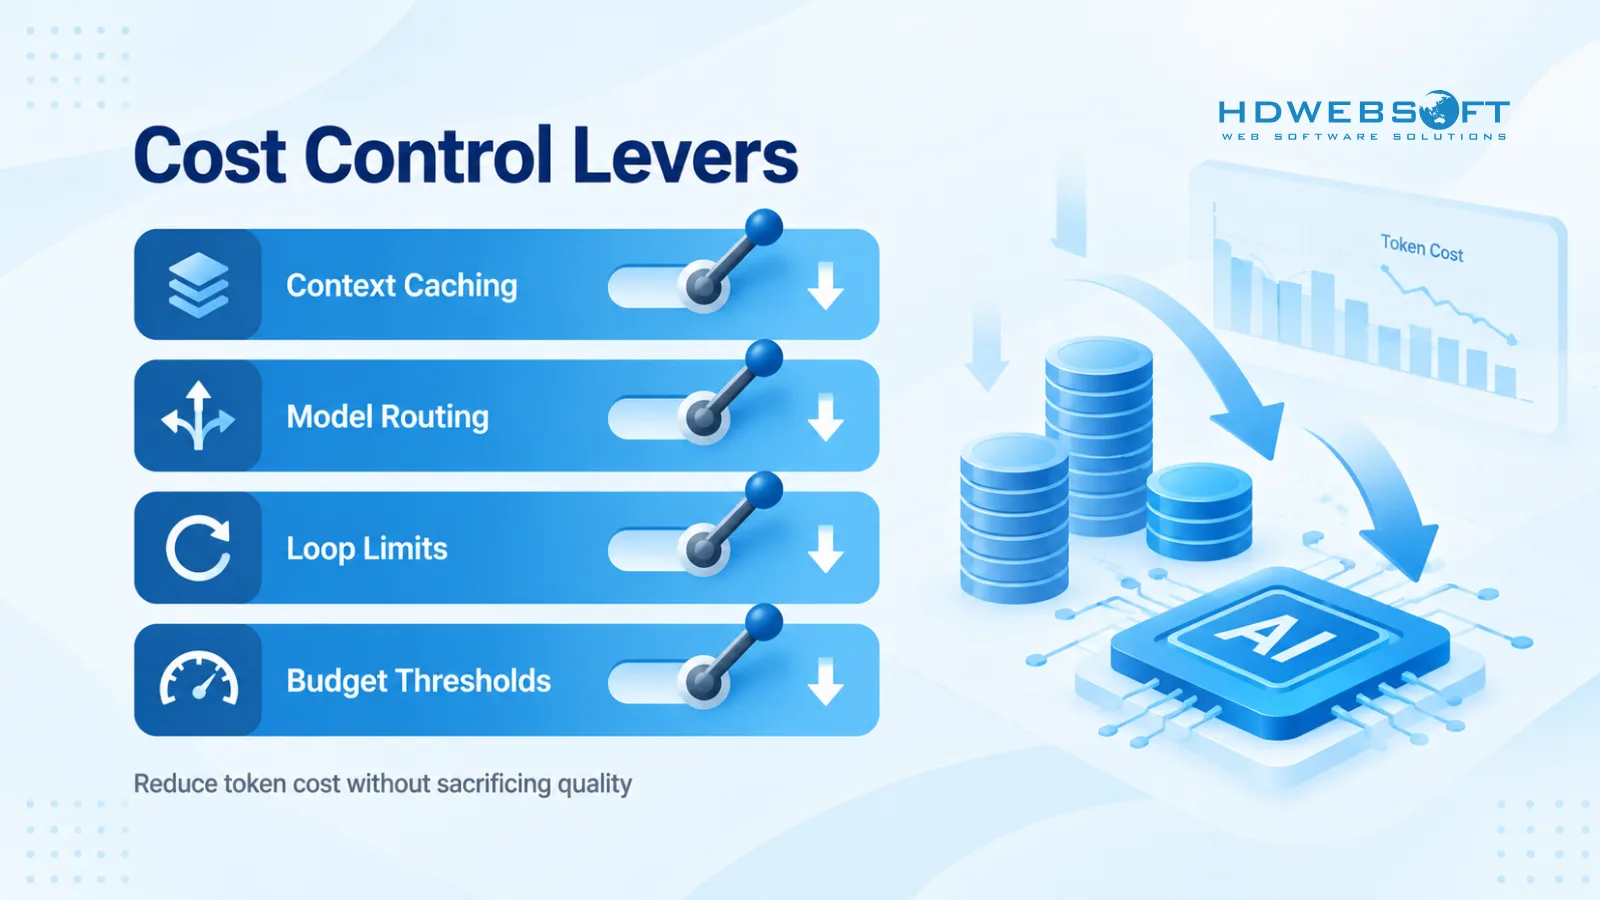
Diverse leve controllano il costo dei token in produzione:
- Context caching: memorizzare nella cache i prefissi dei prompt, i risultati degli strumenti e gli output LLM per input simili, per evitare di reinviare o rigenerare gli stessi contenuti.
- Routing dei modelli: instradare i task verso il modello più piccolo che soddisfi i requisiti di qualità. Le decisioni di routing dovrebbero basarsi sulla complessità del task, sul rischio e sui requisiti di qualità — non su un rapporto fisso come 80% piccolo e 20% grande.
- Limiti dei cicli: impostare un numero massimo di turni per sessione. Quando il limite è raggiunto, terminare il ciclo ed escalare a un umano o a un percorso di fallback.
- Compressione dei prompt: riassumere o comprimere il contesto invece di reinviare la cronologia completa a ogni turno.
- Elaborazione batch: spostare i task non in tempo reale nell’elaborazione batch, dove il costo può essere ottimizzato senza pressione di latenza.
Costruire una previsione dei costi dei token prima di distribuire
Una previsione dei costi dei token è un prerequisito per la distribuzione di agenti IA in produzione, non un ripensamento. Costruire la previsione prima del lancio:
- Stimare i token medi per sessione: includere prompt di sistema, contesto, risultati degli strumenti e output. Tenere conto di tentativi e diramazioni.
- Moltiplicare per le sessioni attese al giorno: usare un volume di produzione realistico, non il volume del pilota.
- Applicare i prezzi dei modelli: calcolare il costo giornaliero e mensile ai prezzi correnti dei token.
- Aggiungere un margine per la varianza: il traffico di produzione è imprevedibile; aggiungere un margine per picchi inattesi.
- Separare costi fissi e variabili: i costi fissi includono i prompt di sistema e il contesto di base; i costi variabili scalano con i turni, le chiamate agli strumenti e i tentativi.
Una volta predisposta la previsione, impostare soglie di budget con una politica di stop o escalation. Quando la spesa supera una soglia, il sistema può fermare l’agente, escalare a un umano, passare a un modello più economico o avvisare il team — la politica dipende dal caso d’uso. L’essenziale è avere una politica prima del lancio, non scoprire la violazione del budget dopo l’arrivo della fattura.
Collo di bottiglia 4: gap di sicurezza e output degli agenti non controllati
La sicurezza è il quarto collo di bottiglia ed è quello per cui i team di sicurezza applicativa tradizionale sono meno preparati. Gli agenti non si limitano a generare testo — chiamano strumenti, accedono a dati e compiono azioni, il che introduce minacce che i controlli AppSec tradizionali non erano progettati per affrontare. Distribuire agenti IA in produzione senza guardrail specifici per gli agenti espone le organizzazioni ad attacchi di injection, esfiltrazione di dati e chiamate agli strumenti non sicure.
Prompt injection indiretta e chiamate agli strumenti non sicure
La prompt injection indiretta è il rischio di sicurezza principale per gli agenti in produzione e una delle cause principali di insuccesso nella distribuzione di agenti IA. A differenza della prompt injection diretta, in cui un attaccante manipola il prompt direttamente, l’injection indiretta nasconde istruzioni malevole all’interno dei dati che l’agente recupera o elabora — contenuti generati dagli utenti, documenti recuperati, output degli strumenti o pagine web esterne.
Quando un agente legge questi contenuti, può seguire le istruzioni iniettate come se fossero legittime. Un agente che legge un’email di un cliente contenente istruzioni nascoste potrebbe perdere dati, chiamare uno strumento sensibile o modificare un record che non dovrebbe toccare. Poiché l’injection arriva attraverso i dati, non attraverso il prompt stesso, la sola validazione degli input non la coglie.
Il rischio si aggrava quando gli agenti hanno capacità di chiamata agli strumenti. Un agente che può inviare email, modificare database o avviare pagamenti comporta un rischio ben maggiore di un agente che genera solo testo. Ogni chiamata a uno strumento è un’azione potenziale con conseguenze reali e chiamate non controllate possono causare danni prima che chiunque se ne accorga.
Rischi di esfiltrazione dei dati nei flussi di lavoro degli agenti
Gli agenti spesso accedono a molteplici fonti di dati — database, API, file store — e questo accesso crea rischio di esfiltrazione. Un agente che può leggere dati sensibili e inviare email o chiamare API esterne può esfiltrare quei dati attraverso i propri output o le chiamate agli strumenti.
I sistemi multi-agente amplificano il rischio. L’agente A può avere un ampio accesso ai dati perché i suoi task lo richiedono, mentre l’agente B ha un ambito più ristretto. Se l’agente B può richiedere dati all’agente A e gli output dell’agente B fluiscono verso un canale esterno, i dati possono passare da un agente con accesso elevato a una destinazione esterna senza che nessuno dei due agenti violi esplicitamente il proprio ambito.
Le mitigazioni includono:
- Principio del minimo privilegio: dare a ciascun agente il minimo accesso ai dati richiesto dai suoi task, con ambito il più ristretto possibile.
- Filtraggio degli output: validare gli output dell’agente prima che raggiungano canali esterni, bloccando i contenuti che contengono dati sensibili.
- Log di audit: registrare ogni chiamata agli strumenti, i suoi parametri e il suo esito, in modo che i tentativi di esfiltrazione siano tracciabili.
Perché l’AppSec tradizionale è necessaria ma non sufficiente
La sicurezza applicativa tradizionale rimane necessaria ma non è sufficiente per i rischi specifici degli agenti. WAF, validazione degli input, autenticazione e autorizzazione contano ancora — sono la fondazione. Ma non coprono le minacce che gli agenti introducono:
- La prompt injection non è una tradizionale injection di codice. Sfrutta il comportamento di seguire le istruzioni del modello, non una vulnerabilità di codice, quindi le regole WAF e la sanificazione degli input non la cogliono.
- Gli agenti decidono quali strumenti chiamare in modo dinamico. Non c’è una rotta fissa da filtrare — il ragionamento stesso dell’agente determina l’azione e i controlli di sicurezza tradizionali non possono prevedere o filtrare ogni possibile percorso di chiamata agli strumenti.
- Gli output degli agenti possono contenere dati sensibili dispersi tramite log, email o chiamate ad API esterne, anche quando l’archivio dati sottostante è adeguatamente protetto.
I guardrail specifici per gli agenti sono necessari in aggiunta all’AppSec tradizionale: validazione degli output, allowlist per le chiamate agli strumenti, approvazione umana per le azioni sensibili e audit trail completi. Per un’analisi più approfondita dei modelli di minaccia e delle mitigazioni specifiche per gli LLM, si veda sicurezza LLM per IA agentica.
Come distribuire agenti IA in produzione in modo affidabile
Affrontare i quattro colli di bottiglia richiede un approccio strutturato che combini guardrail, caching e osservabilità. Ciascun componente affronta uno o più colli di bottiglia e insieme formano la fondazione di produzione che i piloti mancano. Per i team che stanno imparando come distribuire agenti IA in produzione, i componenti seguenti sono essenziali.
Guardrail a strati: la spina dorsale dell’affidabilità degli agenti
I guardrail a strati combinano molteplici tipi di controllo, ciascuno dei quali affronta diverse modalità di fallimento:
- Controlli deterministici: validazione dello schema per gli output, allowlist per le chiamate agli strumenti, limiti dei cicli e controlli dei permessi. Sono regole che non dipendono dal modello — applicano i vincoli a prescindere da ciò che l’agente genera, formando il primo strato di affidabilità degli agenti IA.
- Controlli basati su modello o classificatore: filtri dei contenuti, rilevatori di allucinazioni e classificatori di output che colgono problemi che le regole deterministiche non possono. Usano modelli o classificatori più piccoli per valutare gli output dell’agente prima che raggiungano gli utenti o gli strumenti.
- Controllo degli accessi: principio del minimo privilegio per ogni agente, permessi degli strumenti con ambito ristretto e limiti di accesso ai dati legati al ruolo dell’agente.
- Approvazione umana: per le azioni sensibili — pagamenti, modifiche ai dati, comunicazioni esterne — richiedere un’approvazione umana esplicita prima che l’agente esegua l’azione.
Nessun singolo strato è sufficiente. Le regole deterministiche colgono le violazioni di schema e le chiamate non autorizzate agli strumenti ma perdono i problemi sottili di contenuto. I controlli basati su modello colgono i problemi di contenuto ma possono essi stessi essere vulnerabili a input avversari. L’approvazione umana colge le azioni ad alto rischio ma non scala a ogni decisione. La forza dei guardrail a strati sta nel fatto che ciascuno strato copre le lacune lasciate dagli altri, rendendo la distribuzione di agenti IA in produzione ben più affidabile di qualsiasi singolo controllo.
Smart context caching per ridurre insieme latenza e costi
Il context caching affronta latenza e costi simultaneamente riducendo il lavoro ridondante:
- Memorizzare nella cache i prompt di sistema e il contesto stabile: evitare di reinviare lo stesso prefisso di prompt a ogni turno.
- Memorizzare nella cache i risultati degli strumenti: se più turni hanno bisogno dello stesso output di uno strumento, memorizzarlo nella cache invece di richiamare lo strumento.
- Cache semantica per gli output LLM: per input simili, restituire un output memorizzato nella cache invece di rigenerarlo.
Il caching introduce rischi propri che i team di produzione devono gestire:
- Invalidazione della cache: quando i dati sottostanti cambiano, i risultati memorizzati nella cache devono essere invalidati o aggiornati. Una cache obsoleta porta a risposte errate.
- Isolamento dei tenant: non servire mai i risultati memorizzati nella cache di un tenant a un altro. Le chiavi di cache devono includere il contesto del tenant.
- Aggiornamento dei dati: impostare TTL coerenti con la frequenza di aggiornamento dei dati. Una cache troppo obsoleta è peggio di nessuna cache.
- Output sensibili o ad alto rischio: non memorizzare nella cache output che contengono PII, decisioni finanziarie, consigli medici o altri contenuti sensibili, a meno che lo strato di caching non disponga di controlli di sicurezza equivalenti. In caso di dubbio, non memorizzare nella cache.
Osservabilità e valutazione come requisiti di produzione
L’osservabilità per gli agenti IA differisce da quella delle applicazioni tradizionali. Gli agenti prendono decisioni dinamiche, chiamano strumenti esterni e producono output difficili da validare con semplici controlli di superato/fallito. La distribuzione di agenti IA in produzione richiede un’osservabilità che copra:
- Decisioni sugli strumenti: quali strumenti sono stati chiamati, con quali parametri e quali risultati sono tornati.
- Decisioni di routing: quale modello o diramazione è stata selezionata e perché.
- Stato intermedio: l’output di ciascun passo nella catena di agenti, non il chain-of-thought nascosto del modello.
- Metadati di modelli e strumenti: versione del modello, versione dello strumento e parametri usati, in modo che le regressioni siano riconducibili a versioni specifiche.
- Risultati dei guardrail: se ciascuno strato ha superato o fallito e il motivo di rifiuto quando un guardrail blocca un’azione.
- Tracce di latenza e costi: ripartizione di tempo e costo dei token per passo, in modo che i colli di bottiglia siano visibili.
- Esito finale: il risultato finale del lavoro dell’agente, con stato di successo o fallimento.
Redazione, classificazione dei dati e politica di conservazione sono obbligatorie. Non registrare mai prompt o contesto completi quando potrebbero essere presenti PII o segreti. Classificare i dati prima di registrarli, redigere i campi sensibili e applicare limiti di conservazione in modo che i log non diventino una responsabilità. Non tentare di registrare il chain-of-thought nascosto del modello — non è disponibile in modo affidabile e forzarlo può degradare la qualità degli output.
La valutazione va oltre il test dell’output finale. Testare ciascun passo nella catena di agenti, in modo che le regressioni siano colte nel passo in cui hanno origine anziché solo alla fine. Impostare avvisi per le metriche di deriva, le violazioni del budget di latenza, le soglie di costo e i tassi di rifiuto dei guardrail, in modo che i problemi emergano prima degli utenti.
Grounding del retrieval per ridurre deriva e costi
La generazione aumentata da retrieval, quando implementata bene, può ridurre sia la deriva sia i costi. Un grounding accurato fornisce all’agente un contesto pertinente e aggiornato, il che riduce il numero di turni di ragionamento necessari e la probabilità di allucinazioni. Meno turni significano meno token e latenza più bassa. Il grounding inoltre rafforza le istruzioni originali fornendo un contesto concreto e recuperato che ancori il ragionamento dell’agente.
Il RAG non è una vittoria gratuita — aggiunge overhead di retrieval e introduce modalità di fallimento proprie se la qualità del retrieval è scarsa. Ma un retrieval ben progettato può ridurre tentativi e cicli di ragionamento, producendo un beneficio netto su deriva, costi e latenza. Per un’analisi più approfondita dell’orchestrazione del retrieval, della valutazione e del grounding, si veda orchestrazione del retrieval e grounding nel RAG agentico.
Come HDWEBSOFT riduce i rischi dei lanci di agenti IA in produzione
HDWEBSOFT aiuta i team a portare gli agenti IA dal pilota alla produzione attraverso un framework di lancio strutturato per distribuzioni ben delimitate. Il framework non è un pacchetto a scope e tempistiche fisse — è un approccio per fasi che si adatta alla complessità del caso d’uso, alla maturità della logica di agente esistente e alla prontezza produttiva dell’organizzazione. Per la distribuzione di agenti IA aziendali, questo approccio strutturato aiuta i team a evitare i quattro colli di bottiglia fin dal primo giorno.
Cosa copre il framework di lancio
Il framework copre i componenti che la distribuzione di agenti IA in produzione richiede ma che i piloti tipicamente saltano:
- Design dell’architettura: architettura pronta per la produzione che tiene conto di guardrail, osservabilità e controlli dei costi fin dall’inizio.
- Implementazione dei guardrail a strati: controlli deterministici, controlli basati su modello, controllo degli accessi e gate di approvazione umana tarati sul profilo di rischio del caso d’uso.
- Configurazione del context caching: strategia di caching con invalidazione, isolamento dei tenant e gestione degli output sensibili.
- Stack di osservabilità: logging, avvisi e valutazione con redazione, classificazione dei dati e politica di conservazione integrate.
- Rollout controllato: distribuzione per fasi che inizia con uno scope ristretto e si espande in base ai risultati comprovati.
Il framework si adatta a casi d’uso con scope chiaro e logica di agente esistente o semplice. Non è uno sprint da zero — è un percorso strutturato verso la produzione per agenti che hanno dimostrato il proprio valore nel pilota e hanno bisogno del rigore ingegneristico per sopravvivere a scala.
Un approccio per fasi, non una tempistica fissa
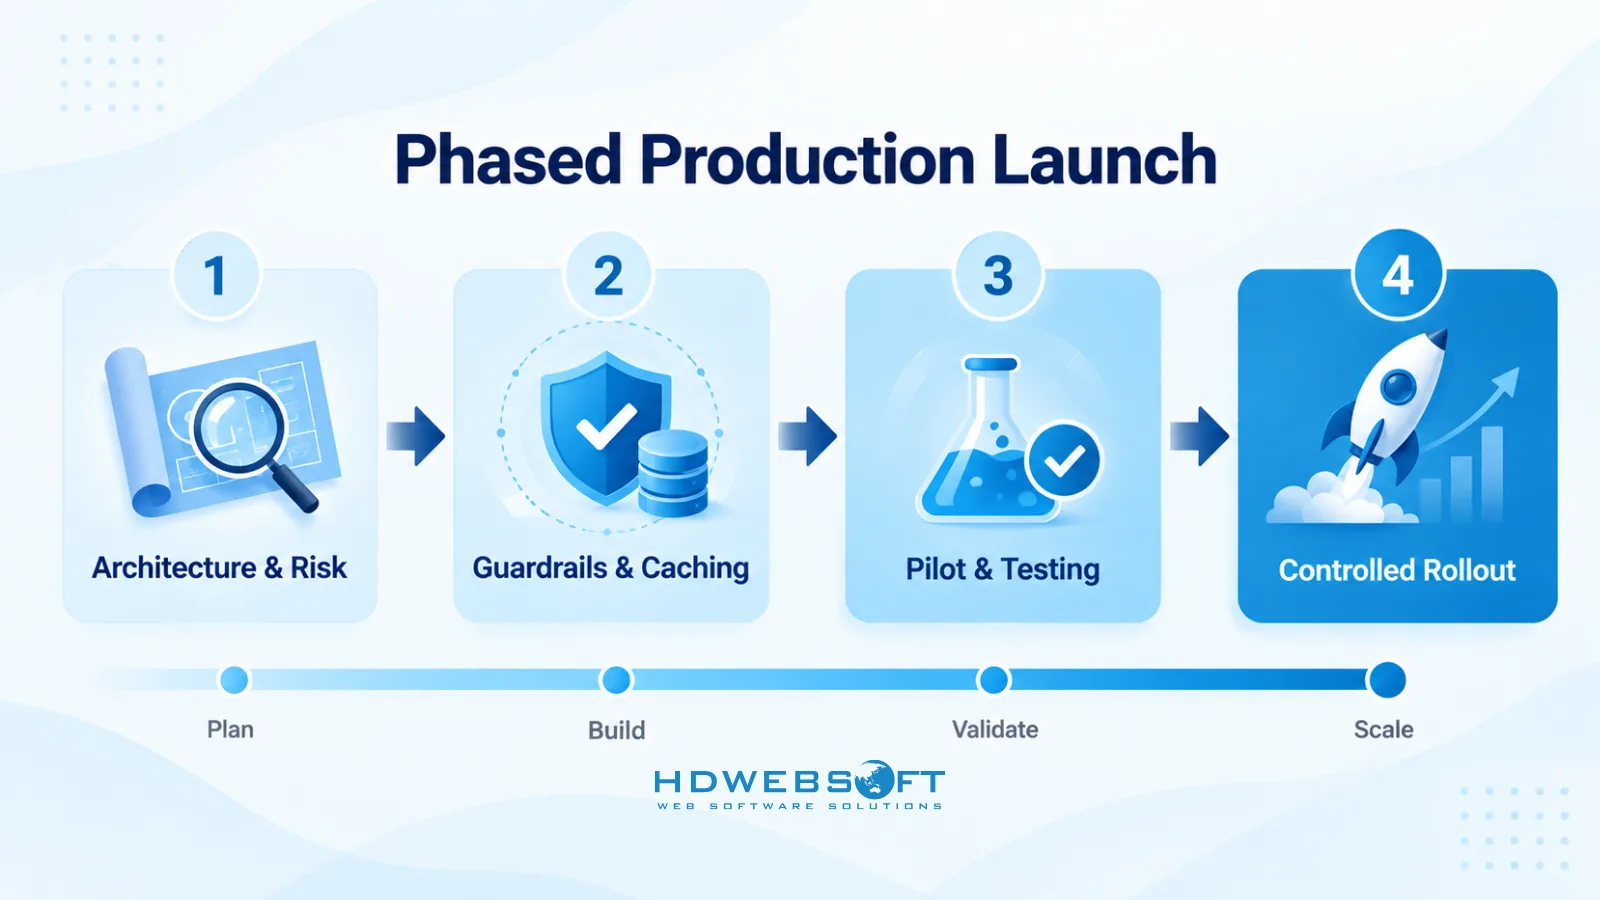
Il lancio segue un approccio per fasi anziché una tempistica fissa. Le fasi sono:
- Sessione di architettura e valutazione dei rischi: definire il caso d’uso, le metriche di successo, il profilo di rischio e i requisiti di produzione. Identificare quali colli di bottiglia — deriva, latenza, costi, sicurezza — sono più rilevanti per la distribuzione.
- Implementazione di guardrail, caching e osservabilità: costruire la fondazione di produzione prima che l’agente tocchi traffico reale. Guardrail a strati, caching con invalidazione e osservabilità con redazione vengono configurati in questa fase.
- Distribuzione pilota e test: distribuire l’agente in un ambiente controllato che rispecchia la produzione, con guardrail e osservabilità completi attivi. Testare con carico realistico, casi limite e modalità di fallimento.
- Rollout controllato e monitoraggio: rollout graduale, monitorare le metriche di deriva, la latenza, i costi e i risultati dei guardrail ed espandere lo scope in base ai risultati comprovati.
La durata di ciascuna fase dipende dalla complessità del caso d’uso, dalla maturità della logica di agente esistente e dalla prontezza produttiva dell’organizzazione. Il framework fornisce struttura e disciplina, non una pianificazione rigida.
Perché un lancio strutturato riduce i rischi della distribuzione in produzione
Un lancio strutturato riduce i rischi della distribuzione di agenti IA in produzione in diversi modi:
- Chiarezza di scope: un caso d’uso ben delimitato previene lo scope creep, che è il motivo più comune per cui le distribuzioni in produzione superano budget e tempistiche.
- Focus su un caso d’uso ad alto valore: anziché tentare di distribuire ogni agente in una volta, il framework si concentra su un caso d’uso in cui il successo è più probabile e il valore è massimo.
- Guardrail e osservabilità fin dall’inizio: le fondazioni di produzione sono costruite prima del lancio, non aggiunte dopo il primo incidente.
- Baseline per il ridimensionamento: un rollout controllato di successo fornisce la baseline — metriche, soglie dei guardrail, pattern di costi — su cui le future decisioni di scaling si appoggiano.
Per i team pronti a passare dal pilota alla produzione, il passo successivo è una sessione di architettura tecnica con il nostro responsabile IA per mappare il caso d’uso, identificare i colli di bottiglia rilevanti e definire i requisiti di produzione. Prenoti una sessione di architettura tecnica con il nostro responsabile IA per iniziare la conversazione.
Conclusione
La distribuzione di agenti IA in produzione è una disciplina ingegneristica, non una capacità del modello. I quattro colli di bottiglia — deriva dei prompt, latenza delle API, costi dei token e gap di sicurezza — sono prevedibili, diagnosticabili e affrontabili, ma solo quando i team li progettano prima della produzione anziché dopo il primo incidente. Una distribuzione di agenti IA di successo richiede guardrail a strati, smart context caching e osservabilità strutturata fin dall’inizio.
I guardrail a strati, lo smart context caching con adeguata invalidazione e isolamento dei tenant e un’osservabilità strutturata con redazione e politica di conservazione formano la fondazione di produzione che i piloti mancano. Una previsione dei costi dei token con soglie di budget e una politica di stop o escalation è un prerequisito, non un ripensamento. E un framework di lancio strutturato — per fasi, non con tempistiche rigide — dà ai team la disciplina per distribuire bene un caso d’uso prima di passare al successivo.
HDWEBSOFT aiuta i team a gestire questa transizione con un framework di lancio per fasi che costruisce le fondazioni di produzione prima che l’agente tocchi traffico reale. Per le organizzazioni pronte a procedere, il passo successivo è una sessione di architettura tecnica per definire il caso d’uso, identificare i colli di bottiglia rilevanti e pianificare la distribuzione.
FAQ
Cos’è la distribuzione di agenti IA in produzione?
La distribuzione di agenti IA in produzione è la gestione di un sistema IA autonomo che ragiona, chiama strumenti e compie azioni sotto carico reale, con utenti reali e conseguenze reali. Richiede guardrail a strati, osservabilità, controlli dei costi e procedure di rollback che i piloti tipicamente mancano. Una distribuzione di agenti IA di successo tratta affidabilità, sicurezza e controllo dei costi come requisiti ingegneristici fondamentali.
Perché i piloti di agenti IA falliscono nel passaggio alla produzione?
I piloti falliscono in produzione a causa di quattro colli di bottiglia tecnici: deriva dei prompt, latenza delle API, costi dei token e gap di sicurezza. I team li sottovalutano perché i piloti girano in ambienti controllati con pochi utenti, pochi casi limite e nessuna reale pressione sui costi. Senza guardrail, osservabilità e previsioni dei costi progettati per la produzione, la distribuzione di agenti IA fallisce quando gli agenti subiscono deriva, rallentano, consumano token e perdono dati.
Cos’è la deriva dei prompt e come si controlla?
La deriva dei prompt, detta anche deriva di contesto o di istruzioni, è la perdita graduale di aderenza alle istruzioni man mano che un agente elabora sessioni più lunghe o cicli multi-turno. È causata dalla crescita del contesto, dal troncamento, da istruzioni in conflitto, da memoria obsoleta e da output intermedi. La si controlla re-iniettando periodicamente i vincoli, gestendo le finestre di contesto, aggiungendo checkpoint deterministici e rilevando la deriva con molteplici segnali — tasso di successo del task, tasso di violazione dei vincoli, correttezza delle chiamate agli strumenti, valutazioni di regressione e distanza semantica.
Quanto costa gestire agenti IA in produzione?
Il costo dipende dai token medi per sessione, dalle sessioni al giorno e dai prezzi dei modelli. I cicli multi-agente possono far crescere i costi rapidamente o in modo superlineare a causa di contesto ripetuto, tentativi e diramazioni. Si costruisca una previsione dei costi dei token prima del lancio e si impostino soglie di budget con una politica di stop o escalation, in modo che le violazioni di spesa siano colte prima dell’arrivo della fattura.
Cosa sono i guardrail a strati per gli agenti IA?
I guardrail a strati combinano molteplici tipi di controllo: regole deterministiche (validazione dello schema, allowlist per le chiamate agli strumenti, limiti dei cicli, controlli dei permessi), controlli basati su modello o classificatore (filtri dei contenuti, rilevatori di allucinazioni), controllo degli accessi (minimo privilegio, permessi degli strumenti con ambito ristretto) e approvazione umana per le azioni sensibili. Nessun singolo strato è sufficiente — ciascuno copre le lacune lasciate dagli altri e insieme formano la spina dorsale dell’affidabilità degli agenti IA in produzione.
Come funziona il framework di lancio degli agenti IA di HDWEBSOFT?
Il framework di lancio di HDWEBSOFT è un approccio per fasi per distribuzioni ben delimitate: sessione di architettura e valutazione dei rischi, implementazione di guardrail, caching e osservabilità, distribuzione pilota e test, rollout controllato e monitoraggio. Il framework si adatta alla complessità del caso d’uso e alla prontezza dell’organizzazione, anziché seguire una tempistica fissa. Per la distribuzione di agenti IA aziendali, questo approccio strutturato aiuta i team a evitare i quattro colli di bottiglia fin dall’inizio.