Der KI-Agenten-Einsatz ist der Punkt, an dem die meisten vielversprechenden Pilotprojekte scheitern. Eine Demo, die in einer kontrollierten Umgebung Fragen beantwortet, übersteht selten den Kontakt mit echten Nutzern, echten Daten und echten Budgets. Gartner prognostiziert, dass mehr als 40 % der agentischen KI-Projekte bis Ende 2027 eingestellt werden, wobei eskalierende Kosten und unzureichende Risikokontrollen zu den Hauptgründen zählen. Die Lücke zwischen Pilot und agentischer KI in der Produktion ist nicht allein ein Technologieproblem — es ist ein Problem der Engineering-Disziplin, das wenige Teams vorhersehen, bevor sie die Produktion erreichen.
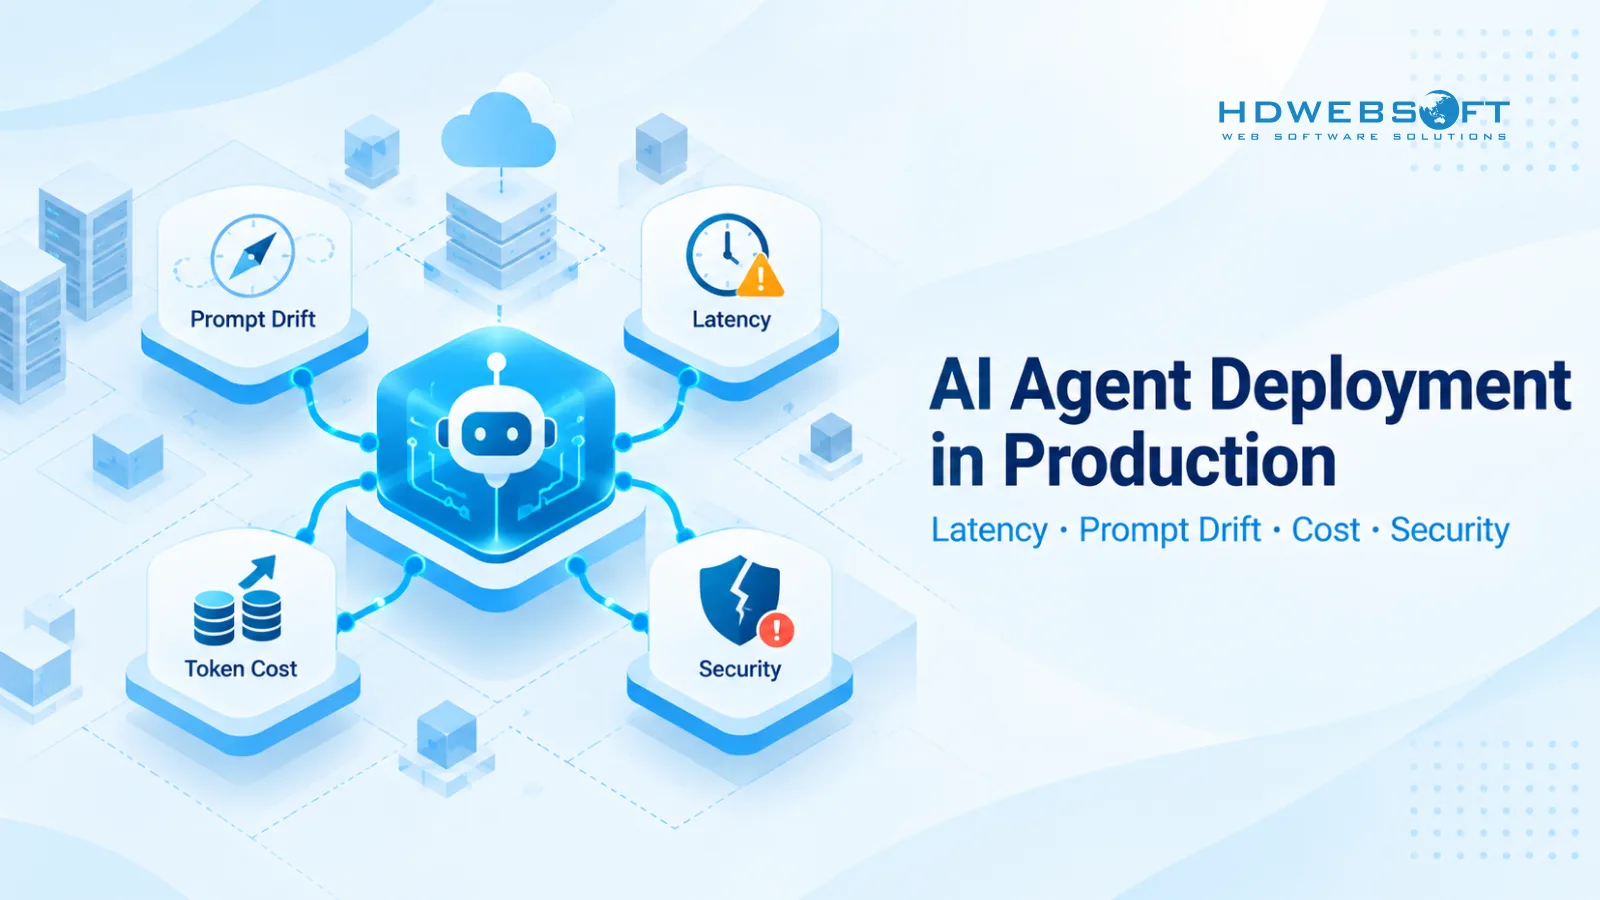
Piloten gelingen, weil sie in kontrollierten Umgebungen mit wenigen Nutzern, wenigen Randfällen und ohne echten Kostendruck laufen. Die Produktion setzt Agenten Verkehrsspitzen, mehrdeutigen Eingaben, adversarialem Inhalt und Budgetbeschränkungen aus, die Piloten nie simulieren. Ohne Guardrails, Observability und Kostenkontrollen, die von Anfang an für die Produktion konzipiert sind, driften Agenten ab, werden langsam, verbrennen Tokens und leaken Daten. Dieser Artikel analysiert die vier technischen Engpässe, die den KI-Agenten-Einsatz in der Produktion zum Scheitern bringen — Prompt Drift, API-Latenz, Token-Kosten und Sicherheitslücken — und erklärt, wie gestaffelte Guardrails, intelligentes Context Caching und strukturierte Observability Teams helfen, KI-Agenten zuverlässig in der Produktion einzusetzen.
Kernergebnisse
- Gartner prognostiziert, dass mehr als 40 % der agentischen KI-Projekte bis Ende 2027 eingestellt werden, wobei eskalierende Kosten und unzureichende Risikokontrollen zu den Hauptgründen zählen.
- Vier technische Engpässe bringen Produktionsbereitstellungen zum Scheitern: Prompt Drift, API-Latenz, Token-Kosten und Sicherheitslücken.
- Gestaffelte Guardrails — die deterministische Regeln, modellbasierte Prüfungen, Zugriffskontrolle und menschliche Freigaben kombinieren — bilden das Rückgrat der KI-Agenten-Zuverlässigkeit.
- Multi-Agenten-Schleifen können Token-Kosten schnell oder superlinear treiben aufgrund von wiederholtem Kontext, Retries und Verzweigung; Schleifenlimits, Modell-Routing und Context Caching sind wesentliche Hebel.
- Eine Token-Kostenprognose mit Budgetschwellen und einer Stopp- oder Eskalationsrichtlinie ist eine Voraussetzung für den Produktionseinsatz, kein Nachgedanke.
- Observability für KI-Agenten erfordert Redaction, Datenklassifizierung und Aufbewahrungsrichtlinie — protokollieren Sie niemals vollständige Prompts oder Kontext, wenn PII oder Secrets vorhanden sind.
Was KI-Agenten-Einsatz in der Produktion wirklich bedeutet
Der KI-Agenten-Einsatz in der Produktion bedeutet nicht einfach, ein Modell auf einem Server auszuführen. Es geht um den Betrieb eines autonomen Systems, das unter realer Last, mit echten Nutzern und echten Konsequenzen schlussfolgert, Tools aufruft und Aktionen ausführt. Produktion bedeutet, dass das System zuverlässig, sicher und kostenkontrolliert bleiben muss, wenn Verkehrsspitzen auftreten, Eingaben unordentlich werden und Budgets enger werden.
Pilot vs. Produktion: Die Lücke, die Projekte tötet
Die Lücke zwischen Pilot und Produktion ist der Punkt, an dem die meisten Projekte scheitern. Piloten laufen in kontrollierten Umgebungen mit wenigen Nutzern, wenigen Randfällen und ohne echten Kostendruck. Die Produktion setzt Agenten Verkehrsspitzen, mehrdeutigen Eingaben, adversarialem Inhalt und Budgetbeschränkungen aus, die Piloten nie simulieren.
| Dimension | Pilot | Produktion |
|---|---|---|
| Nutzer | Handvoll Tester | Tausende oder mehr, unvorhersehbare Muster |
| Randfälle | Kuratiert, begrenzt | Unbegrenzt, adversariell |
| SLA | Best-Effort | Vertraglich oder nutzererwartungsgesteuert |
| Budget | Tolerant | Harte Limits, Kostenwarnungen, Eskalation |
| Observability | Manuelle Prüfung | Echtzeit-Dashboards, Warnungen, Audit-Trails |
| Rollback | Demo neu starten | Kontrolliertes Rollback, ausfallsichere Standards |
Teams, die Piloten als Experimente statt als Produktionsprototypen behandeln, scheitern beim Skalieren selten erfolgreich. Die erfolgreichsten Teams konzipieren von Anfang an für die Produktion und bauen Guardrails, Observability und Kostenkontrollen als Kernanforderungen statt als Nachgedanken.
Die vier technischen Engpässe, die Produktionsbereitstellungen zum Scheitern bringen
Wenn Agenten vom Pilot in die Produktion wechseln, sind vier technische Engpässe für die meisten KI-Agenten-Einsatzfehler verantwortlich:
- Prompt Drift — Agenten verlieren allmählich die Einhaltung der ursprünglichen Anweisungen, während der Kontext wächst und sich Zwischenergebnisse ansammeln.
- API-Latenz — Sequenzielle Aufrufe über LLM-Inferenz, Tool-Aufrufe und Orchestrierung akkumulieren Latenz, die Echtzeit-Workflows bricht.
- Token-Kosten — Multi-Agenten-Schleifen, Retries und Verzweigung treiben die Token-Nutzung schnell oder superlinear in die Höhe.
- Sicherheitslücken — Indirekte Prompt-Injection, unsichere Tool-Aufrufe und Datenexfiltrationsrisiken, die traditionelle AppSec nicht vollständig abdeckt.
Jeder Engpass ist vorhersagbar, diagnostizierbar und behebbar — aber nur, wenn Teams vor der Produktion dafür konzipieren, nicht danach. Für den KI-Agenten-Einsatz im Unternehmen sind diese vier Probleme für die Mehrheit der Produktionsfehler verantwortlich.
Engpass 1: Prompt Drift untergräbt die Agenten-Zuverlässigkeit
Prompt Drift, auch Context- oder Instruction Drift genannt, ist der allmähliche Verlust der Anweisungseinhaltung, wenn ein Agent längere Konversationen oder Multi-Turn-Schleifen verarbeitet. Der Agent beginnt im Einklang mit seinen ursprünglichen Anweisungen, aber während die Interaktion wächst, weichen seine Ergebnisse zunehmend vom beabsichtigten Verhalten ab.
Was Prompt Drift in Multi-Turn-Agenten-Schleifen verursacht
Mehrere Mechanismen treiben Prompt Drift beim KI-Agenten-Einsatz in der Produktion:
- Kontextwachstum: Während sich eine Konversation oder Agenten-Schleife ausdehnt, füllt sich das Kontextfenster mit Zwischenergebnissen, Tool-Aufruf-Ergebnissen und Nutzernachrichten. Der ursprüngliche System-Prompt und die Einschränkungen belegen einen schrumpfenden Anteil der Aufmerksamkeit des Modells.
- Trunkierung: Wenn der Kontext das Fenster des Modells überschreitet, wird älterer Inhalt — oft einschließlich kritischer Anweisungen — trunkiert oder zusammengefasst, wodurch Präzision verloren geht.
- Widersprüchliche Anweisungen: Neue Anweisungen aus Tool-Ergebnissen, Nutzernachrichten oder anderen Agenten können mit dem ursprünglichen System-Prompt kollidieren, und das Modell folgt möglicherweise der jüngeren Anweisung ohne explizite Vorrangregeln.
- Veralteter Speicher: Informationen, die im Speicher oder in Retrieval-Systemen gespeichert sind, können veralten, was den Agenten dazu veranlasst, im Kontext zu handeln, der nicht mehr der Realität entspricht.
- Zwischenergebnisse: Ergebnisse aus früheren Schritten in einer Multi-Agenten-Kette beeinflussen das Schlussfolgern in späteren Schritten. Wenn ein frühes Ergebnis subtil falsch ist, verstärkt sich der Fehler stromabwärts.
Keiner dieser Mechanismen erfordert, dass das Modell „jüngeren Kontext bevorzugt” — sie entstehen aus den praktischen Realitäten des Kontextmanagements, der Trunkierung und des schieren Volumen an Zwischeninhalten, die Produktionsagenten erzeugen.
Wie Prompt Drift die Ergebnisqualität im Laufe der Zeit verschlechtert
Die Folgen von Drift verstärken sich über lange Sitzungen und Multi-Agenten-Ketten und untergraben die KI-Agenten-Zuverlässigkeit. Agenten beginnen zu halluzinieren, die falschen Tools aufzurufen, Einschränkungen zu verletzen oder das ursprüngliche Ziel aus den Augen zu verlieren. In Multi-Agenten-Schleifen ist Drift besonders gefährlich: Agent A gibt Kontext an Agent B weiter, der an Agent C weitergibt, und jeder Handoff bietet eine weitere Gelegenheit für Anweisungsverlust.
In Produktionsprotokollen zeigt sich Drift als subtile Qualitätsminderung, die leicht zu übersehen ist. Ergebnisse können an der Oberfläche noch plausibel aussehen, aber sie erfüllen nicht mehr die ursprünglichen Einschränkungen — ein Kundensupport-Agent beginnt, erforderliche Hinweise auszulassen, ein Datenanalyse-Agent lässt Konfidenzintervalle weg, oder ein Coding-Agent hört auf, den Styleguide des Teams zu befolgen. Ohne Drift-Erkennungsmetriken bleiben diese Regressionen oft unbemerkt, bis ein Nutzer sich beschwert oder ein Audit die Lücke aufdeckt.
Erkennung und Eindämmung von Prompt Drift
Die Kontrolle von Drift erfordert sowohl Prävention als auch Erkennung. Präventionstechniken umfassen:
- Periodische Re-Injection: Injizieren Sie den System-Prompt und kritische Einschränkungen in regelmäßigen Abständen erneut, anstatt sich darauf zu verlassen, dass der ursprüngliche Prompt während einer langen Sitzung sichtbar bleibt.
- Kontextfenster-Management: Fassen Sie zusammen oder beschneiden Sie Zwischeninhalte, um die ursprünglichen Anweisungen hervorzuheben. Behalten Sie nur, was der nächste Schritt benötigt.
- Deterministische Checkpoints: Validieren Sie die Agenten-Ausgabe in jedem Turn gegen die ursprünglichen Einschränkungen, nicht nur am Ende der Sitzung.
Die Erkennung erfordert mehrere Signale, nicht eine einzelne Metrik. Effektive Drift-Erkennung kombiniert:
- Aufgabenerfolgsquote: Schließt der Agent seine Aufgabe noch korrekt ab?
- Einschränkungs-Verletzungsrate: Wie oft bricht der Agent explizite Regeln?
- Tool-Aufruf-Korrektheit: Werden die richtigen Tools mit den richtigen Parametern aufgerufen?
- Regression-Evals: Führen Sie periodisch eine feste Evaluierungssuite aus, um Qualitätsregressionen gegen eine bekannte Baseline zu erfassen.
- Semantische Distanz: Messen Sie, wie weit Ergebnisse vom beabsichtigten Verhalten abgewichen sind, als eines von vielen Signalen.
Keine einzelne Metrik erfasst alle Drift. Teams, die sich nur auf semantische Distanz oder nur auf die Aufgabenerfolgsquote verlassen, werden Regressionen übersehen, die die anderen Signale erfassen. Ein Multi-Signal-Ansatz ist der einzige zuverlässige Weg, Drift beim KI-Agenten-Einsatz in der Produktion zu erkennen.
Engpass 2: API-Latenz bricht Echtzeit-Agenten-Workflows
Latenz ist der zweite Engpass, der Produktionsbereitstellungen zum Scheitern bringt. Agenten-Workflows verketten mehrere Aufrufe — LLM-Inferenz, Tool-Ausführung, Retrieval, Orchestrierung — und Latenz akkumuliert sich über jeden sequenziellen Schritt. Wenn Verzweigung oder Retries hinzukommen, kann die Gesamtantwortzeit stark ansteigen, was den KI-Agenten-Einsatz in der Produktion erschwert, innerhalb akzeptabler Antwortzeiten zu halten.
Wo sich Latenz in Agenten-Aufrufketten versteckt
Latenz beim KI-Agenten-Einsatz stammt aus mehreren Quellen:
- LLM-Inferenz: Die Generierungszeit des Modells selbst, die mit Ausgabelänge und Modellgröße skaliert.
- Tool-Aufruf-Latenz: Externe APIs, Datenbanken und Dienste, die der Agent aufruft, die jeweils Round-Trip-Zeit hinzufügen.
- RAG-Retrieval-Overhead: Retrieval, Embedding und Ranking fügen Zeit hinzu, bevor das Modell überhaupt mit der Generierung beginnt.
- Multi-Agenten-Orchestrierung: Koordination zwischen Agenten — Routing, Handoffs, Ergebnisaggregation — fügt Overhead zusätzlich zur einzelnen Aufruflatenz hinzu.
- Serialisierung und Deserialisierung: Das Konvertieren zwischen Formaten für jeden Aufruf fügt kleine, aber kumulative Verzögerungen hinzu.
In einer Multi-Agenten-Schleife akkumuliert sich Latenz über sequenzielle Aufrufe. Wenn jeder Schritt einige Sekunden dauert und die Schleife mehrere Schritte ausführt, kann die Gesamtantwortzeit Zehntausende von Sekunden erreichen. Verzweigung — bei der ein Agent mehrere Ansätze ausprobiert — und Retries — bei denen ein Agent einen fehlgeschlagenen Schritt wiederholt — können die Gesamtlatenz noch weiter erhöhen. Als anschauliches Beispiel könnte ein einzelner Agenten-Aufruf 3 bis 8 Sekunden dauern, und eine Multi-Agenten-Kette aus mehreren Schritten könnte 30 bis 60 Sekunden erreichen. Diese Zahlen sind Beispiele, nicht universell — die tatsächliche Latenz hängt von Modellwahl, Tool-Leistung und Orchestrierungsdesign ab.
Latenzbudgets für Produktions-KI-Agenten
Ein Latenzbudget ist die maximal akzeptable Antwortzeit für eine bestimmte Aufgabe, aufgeteilt auf jeden Schritt in der Agenten-Kette. Ohne ein Budget haben Teams keine Möglichkeit zu entscheiden, wann Latenz akzeptabel ist oder wann die Architektur geändert werden muss.
Beispiel-Latenzbudgets — diese sind anschaulich, keine universellen SLAs:
- Echtzeit-Interaktionen (z. B. Chat, Live-Support): unter 5 Sekunden
- Near-Real-Time-Aufgaben (z. B. Datenanalyse, Berichterstellung): unter 30 Sekunden
- Hintergrundaufgaben (z. B. Batch-Verarbeitung, geplante Agenten): unter 5 Minuten
Sobald ein Budget festgelegt ist, weisen Sie es den Schritten in der Agenten-Kette zu. Wenn die geschätzte Gesamtsumme das Budget überschreitet, muss sich die Architektur ändern — parallelisieren Sie Tool-Aufrufe, verkürzen Sie Schlussfolgern, leiten Sie einfachere Aufgaben an schnellere Modelle weiter oder verlagern Sie Arbeit in die Hintergrundverarbeitung.
Latenz reduzieren, ohne die Schlussfolgerungstiefe zu opfern
Mehrere Techniken reduzieren Latenz, ohne den Agenten zu zwingen, weniger tief zu schlussfolgern:
- Streaming-Antworten: Streamen Sie die Ausgabe an den Nutzer, während sie generiert wird, sodass der Nutzer Fortschritt sieht, anstatt auf eine vollständige Antwort zu warten.
- Modell-Routing: Leiten Sie einfache Aufgaben an kleinere, schnellere Modelle weiter und reservieren Sie große Modelle für Aufgaben, die tieferes Schlussfolgern erfordern. Routing-Entscheidungen sollten auf Aufgabenkomplexität, Risiko und Qualitätsanforderungen basieren — nicht auf einem festen Verhältnis.
- Parallele Tool-Aufrufe: Führen Sie unabhängige Tool-Aufrufe parallel statt sequenziell aus, um die Gesamt-Wartezeit zu senken.
- Caching: Cachen Sie LLM-Ausgaben und Tool-Ergebnisse für ähnliche Eingaben, um redundante Aufrufe zu vermeiden.
- Spekulative Ausführung (optional, fortgeschritten): Für Schritte mit vorhersagbaren Mustern führen Sie wahrscheinliche nächste Schritte aus, bevor der aktuelle Schritt abgeschlossen ist.
Retrieval-Augmented Generation veranschaulicht den Latenz-Kompromiss gut. RAG fügt Retrieval-Overhead hinzu, aber gutes Grounding kann die Anzahl der Retries und Schlussfolgern-Schleifen reduzieren, die ein Agent benötigt, was die Gesamtlatenz senken kann. Die Netto-Auswirkung hängt von der Implementierung ab — RAG reduziert nicht immer Latenz, aber gut konzipiertes Retrieval kann es.
Engpass 3: Token-Kosten-Explosion in Multi-Agenten-Schleifen
Token-Kosten ist der Engpass, der Teams überrascht. Piloten laufen mit wenigen Nutzern und wenigen Randfällen, sodass die Token-Nutzung handhabbar bleibt. Die Produktion skaliert die Nutzung, und Multi-Agenten-Schleifen verstärken Kosten auf eine Weise, die Pilotdaten nie offenbart haben. Ohne eine Kostenprognose kann der KI-Agenten-Einsatz in der Produktion Budgets durchbrennen, bevor es jemand bemerkt.
Warum Multi-Agenten-Schleifen Token unvorhersehbar verbrennen
Multi-Agenten-Schleifen treiben die Token-Kosten beim KI-Agenten-Einsatz schnell oder superlinear in die Höhe aufgrund mehrerer Faktoren:
- Wiederholter Kontext: Jeder Turn in einer Schleife sendet Kontext erneut — System-Prompt, Konversationsverlauf, Tool-Ergebnisse — an das Modell. Während der Kontext wächst, kostet jeder Turn mehr Tokens als der vorherige.
- Retries: Wenn ein Agent eine ungültige Ausgabe erzeugt, wiederholt die Schleife den Versuch und sendet den vollständigen Kontext erneut plus das Fehler-Feedback.
- Verzweigung: Wenn ein Agent mehrere Ansätze ausprobiert, verbraucht jeder Zweig Tokens, und nur die Ausgabe eines Zweigs wird möglicherweise verwendet.
- Multi-Agenten-Austausch: Agenten, die miteinander kommunizieren, verbrauchen Tokens für jede Nachricht und fügen Overhead hinzu, den Single-Agent-Systeme nicht haben.
Als anschauliches Beispiel könnte eine Pilot-Sitzung 5.000 Tokens verwenden. Bei 1.000 Sitzungen pro Tag in der Produktion werden das 5 Millionen Tokens pro Tag — und das, bevor Retries, Verzweigung und Kontextwachstum berücksichtigt werden, die Produktionsverkehr einführen. Kosten können schnell oder superlinear steigen, nicht linear, wenn diese Faktoren sich verstärken.
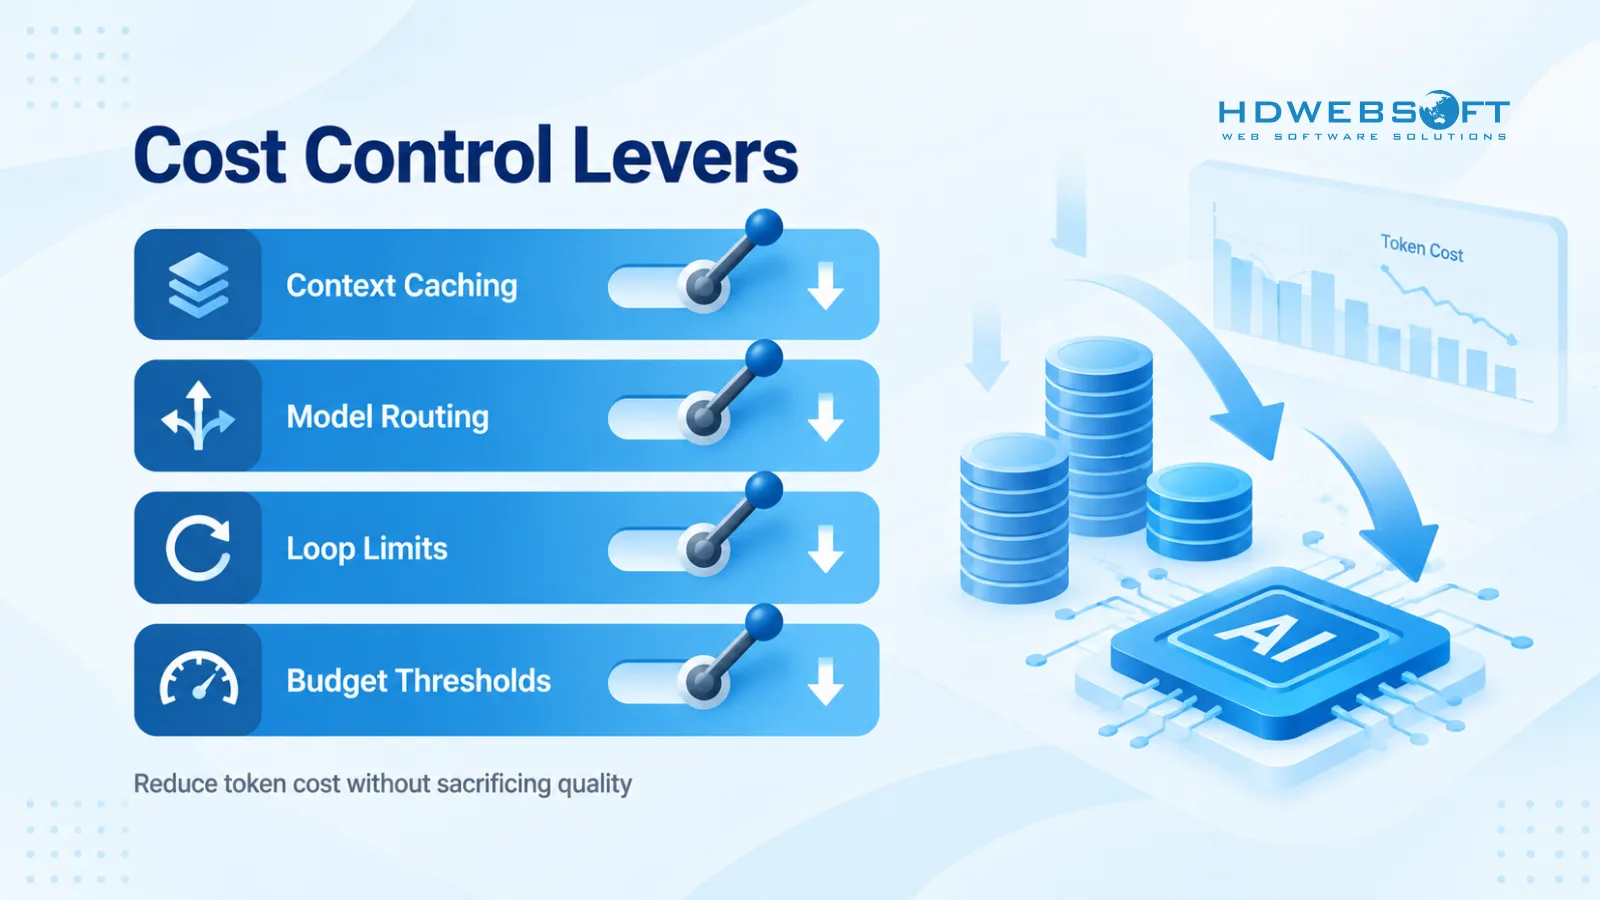
Kostenhebel: Context Caching, Modell-Routing, Schleifenlimits
Mehrere Hebel kontrollieren Token-Kosten in der Produktion:
- Context Caching: Cachen Sie Prompt-Präfixe, Tool-Ergebnisse und LLM-Ausgaben für ähnliche Eingaben, um erneutes Senden oder erneutes Generieren desselben Inhalts zu vermeiden.
- Modell-Routing: Leiten Sie Aufgaben an das kleinste Modell weiter, das die Qualitätsanforderungen erfüllt. Routing-Entscheidungen sollten auf Aufgabenkomplexität, Risiko und Qualitätsanforderungen basieren — nicht auf einem festen Verhältnis wie 80 % klein und 20 % groß.
- Schleifenlimits: Legen Sie eine maximale Anzahl von Turns pro Sitzung fest. Wenn das Limit erreicht ist, beenden Sie die Schleife und eskalieren Sie an einen Menschen oder einen Fallback-Pfad.
- Prompt-Kompression: Fassen Sie zusammen oder komprimieren Sie Kontext, anstatt bei jedem Turn den vollständigen Verlauf erneut zu senden.
- Batch-Verarbeitung: Verlagern Sie nicht-echtzeit Aufgaben in die Batch-Verarbeitung, wo Kosten ohne Latenzdruck optimiert werden können.
Eine Token-Kostenprognose vor dem Einsatz erstellen
Eine Token-Kostenprognose ist eine Voraussetzung für den KI-Agenten-Einsatz in der Produktion, kein Nachgedanke. Erstellen Sie die Prognose vor dem Launch:
- Schätzen Sie durchschnittliche Tokens pro Sitzung: Berücksichtigen Sie System-Prompt, Kontext, Tool-Ergebnisse und Ausgabe. Berücksichtigen Sie Retries und Verzweigung.
- Multiplizieren Sie mit erwarteten Sitzungen pro Tag: Verwenden Sie realistisches Produktionsvolumen, nicht Pilotvolumen.
- Wenden Sie Modellpreise an: Berechnen Sie tägliche und monatliche Kosten zu aktuellen Token-Preisen.
- Fügen Sie einen Puffer für Varianz hinzu: Produktionsverkehr ist unvorhersehbar; fügen Sie einen Puffer für unerwartete Spitzen hinzu.
- Trennen Sie feste und variable Kosten: Feste Kosten umfassen System-Prompts und Baseline-Kontext; variable Kosten skalieren mit Turns, Tool-Aufrufen und Retries.
Sobald die Prognose steht, legen Sie Budgetschwellen mit einer Stopp- oder Eskalationsrichtlinie fest. Wenn die Ausgaben eine Schwelle überschreiten, kann das System den Agenten stoppen, an einen Menschen eskalieren, zu einem günstigeren Modell wechseln oder das Team warnen — die Richtlinie hängt vom Anwendungsfall ab. Der Schlüssel ist, eine Richtlinie vor dem Launch zu haben, nicht die Budgetüberschreitung nach Erhalt der Rechnung zu entdecken.
Engpass 4: Sicherheitslücken und unkontrollierte Agenten-Ausgaben
Sicherheit ist der vierte Engpass, und er ist derjenige, auf den traditionelle Anwendungssicherheitsteams am wenigsten vorbereitet sind. Agenten generieren nicht nur Text — sie rufen Tools auf, greifen auf Daten zu und führen Aktionen aus, was Bedrohungen einführt, für die konventionelle AppSec-Kontrollen nicht konzipiert wurden. Der Einsatz von KI-Agenten in der Produktion ohne agentenspezifische Guardrails setzt Organisationen Injections-Angriffen, Datenexfiltration und unsicheren Tool-Aufrufen aus.
Indirekte Prompt-Injection und unsichere Tool-Aufrufe
Indirekte Prompt-Injection ist das primäre Sicherheitsrisiko für Produktionsagenten und eine führende Ursache für KI-Agenten-Einsatzfehler. Anders als bei der direkten Prompt-Injection, bei der ein Angreifer den Prompt direkt manipuliert, versteckt die indirekte Injection bösartige Anweisungen in Daten, die der Agent abruft oder verarbeitet — nutzergenerierter Inhalt, abgerufene Dokumente, Tool-Ergebnisse oder externe Webseiten.
Wenn ein Agent diesen Inhalt liest, befolgt er möglicherweise die injizierten Anweisungen, als wären sie legitim. Ein Agent, der eine Kunden-E-Mail mit versteckten Anweisungen liest, könnte Daten leaken, ein sensibles Tool aufrufen oder einen Datensatz ändern, den er nicht berühren sollte. Da die Injection über Daten erfolgt, nicht über den Prompt selbst, erfasst die Eingabevalidierung allein sie nicht.
Das Risiko verstärkt sich, wenn Agenten Tool-Aufruf-Fähigkeiten haben. Ein Agent, der E-Mails senden, Datenbanken ändern oder Zahlungen initiieren kann, birgt ein weit höheres Risiko als ein Agent, der nur Text generiert. Jeder Tool-Aufruf ist eine potenzielle Aktion mit realen Konsequenzen, und unkontrollierte Tool-Aufrufe können Schaden anrichten, bevor es jemand bemerkt.
Datenexfiltrationsrisiken in Agenten-Workflows
Agenten haben oft Zugriff auf mehrere Datenquellen — Datenbanken, APIs, Dateispeicher — und dieser Zugriff erzeugt Exfiltrationsrisiko. Ein Agent, der sensible Daten lesen und E-Mails senden oder externe APIs aufrufen kann, kann diese Daten über seine Ausgaben oder Tool-Aufrufe exfiltrieren.
Multi-Agenten-Systeme verstärken das Risiko. Agent A hat möglicherweise breiten Datenzugriff, weil seine Aufgaben es erfordern, während Agent B einen engeren Geltungsbereich hat. Wenn Agent B Daten von Agent A anfordern kann und die Ausgaben von Agent B in einen externen Kanal fließen, können Daten von einem Agenten mit hohem Zugriff zu einem externen Ziel gelangen, ohne dass einer der Agenten explizit seinen eigenen Geltungsbereich verletzt.
Maßnahmen umfassen:
- Prinzip der minimalen Rechte: Geben Sie jedem Agenten den minimalen Datenzugriff, den seine Aufgaben erfordern, so eng begrenzt wie möglich.
- Ausgabefilterung: Validieren Sie Agenten-Ausgaben, bevor sie externe Kanäle erreichen, und blockieren Sie Inhalte, die sensible Daten enthalten.
- Audit-Protokollierung: Protokollieren Sie jeden Tool-Aufruf, seine Parameter und sein Ergebnis, sodass Exfiltrationsversuche nachverfolgbar sind.
Warum traditionelle AppSec notwendig, aber nicht ausreichend ist
Traditionelle Anwendungssicherheit bleibt notwendig, ist aber für agentenspezifische Risiken nicht ausreichend. WAFs, Eingabevalidierung, Authentifizierung und Autorisierung sind weiterhin wichtig — sie sind die Grundlage. Aber sie decken nicht die Bedrohungen ab, die Agenten einführen:
- Prompt-Injection ist keine traditionelle Code-Injection. Sie exploitiert das instruktionsfolgende Verhalten des Modells, keine Code-Schwachstelle, sodass WAF-Regeln und Eingabesanitisierung sie nicht erfassen.
- Agenten entscheiden dynamisch, welche Tools aufgerufen werden. Es gibt keine feste Route zum Filtern — das eigene Schlussfolgern des Agenten bestimmt die Aktion, und traditionelle Sicherheitskontrollen können nicht jeden möglichen Tool-Aufruf-Pfad vorhersagen oder filtern.
- Agenten-Ausgaben können sensible Daten enthalten, die über Protokolle, E-Mails oder externe API-Aufrufe geleakt werden, selbst wenn der zugrunde liegende Datenspeicher ordnungsgemäß gesichert ist.
Agentenspezifische Guardrails sind zusätzlich zu traditioneller AppSec erforderlich: Ausgabevalidierung, Tool-Aufruf-Allowlists, menschliche Freigabe für sensible Aktionen und vollständige Audit-Trails. Für einen tieferen Einblick in LLM-spezifische Bedrohungsmodelle und Maßnahmen siehe LLM-Sicherheit für agentische KI.
So setzen Sie KI-Agenten zuverlässig in der Produktion ein
Die Bewältigung der vier Engpässe erfordert einen strukturierten Ansatz, der Guardrails, Caching und Observability kombiniert. Jede Komponente adressiert einen oder mehrere Engpässe, und zusammen bilden sie das Produktionsfundament, das Piloten fehlt. Für Teams, die lernen, wie man KI-Agenten in der Produktion einsetzt, sind die folgenden Komponenten unerlässlich.
Gestaffelte Guardrails: Das Rückgrat der Agenten-Zuverlässigkeit
Gestaffelte Guardrails kombinieren mehrere Arten von Kontrolle, die jeweils unterschiedliche Fehlermodi adressieren:
- Deterministische Kontrollen: Schema-Validierung für Ausgaben, Tool-Aufruf-Allowlists, Schleifenlimits und Berechtigungsprüfungen. Dies sind Regeln, die nicht vom Modell abhängen — sie setzen Einschränkungen unabhängig davon durch, was der Agent generiert, und bilden die erste Schicht der KI-Agenten-Zuverlässigkeit.
- Modellbasierte oder klassifikatorbasierte Prüfungen: Inhaltsfilter, Halluzinationsdetektoren und Ausgabeklassifikatoren, die Probleme erfassen, die deterministische Regeln nicht können. Diese verwenden kleinere Modelle oder Klassifikatoren, um Agenten-Ausgaben zu bewerten, bevor sie Nutzer oder Tools erreichen.
- Zugriffskontrolle: Prinzip der minimalen Rechte für jeden Agenten, begrenzte Tool-Berechtigungen und Datenzugriffslimits, die an die Rolle des Agenten gebunden sind.
- Menschliche Freigabe: Für sensible Aktionen — Zahlungen, Datenänderungen, externe Kommunikation — ist eine explizite menschliche Freigabe erforderlich, bevor der Agent die Aktion ausführt.
Keine einzelne Schicht ist ausreichend. Deterministische Regeln erfassen Schema-Verletzungen und unautorisierte Tool-Aufrufe, verpassen aber subtile Inhaltsprobleme. Modellbasierte Prüfungen erfassen Inhaltsprobleme, können aber selbst für adversarielle Eingaben anfällig sein. Menschliche Freigabe erfasst risikoreiche Aktionen, skaliert aber nicht auf jede Entscheidung. Die Stärke gestaffelter Guardrails liegt darin, dass jede Schicht die Lücken abdeckt, die die anderen offen lassen, was den KI-Agenten-Einsatz in der Produktion wesentlich zuverlässiger macht als jede einzelne Kontrolle.
Intelligentes Context Caching zur gleichzeitigen Senkung von Latenz und Kosten
Context Caching adressiert Latenz und Kosten gleichzeitig, indem redundante Arbeit reduziert wird:
- System-Prompts und stabilen Kontext cachen: Vermeiden Sie, dass dasselbe Prompt-Präfix bei jedem Turn erneut gesendet wird.
- Tool-Ergebnisse cachen: Wenn mehrere Turns dasselbe Tool-Ergebnis benötigen, cachen Sie es, anstatt das Tool erneut aufzurufen.
- Semantisches Caching für LLM-Ausgaben: Für ähnliche Eingaben geben Sie ein gecachtes Ergebnis zurück, anstatt neu zu generieren.
Caching führt eigene Risiken ein, die Produktionsteams verwalten müssen:
- Cache-Invalidierung: Wenn sich zugrunde liegende Daten ändern, müssen gecachte Ergebnisse invalidiert oder aktualisiert werden. Veraltete Cache führt zu falschen Antworten.
- Tenant-Isolation: Servieren Sie niemals die gecachten Ergebnisse eines Tenants an einen anderen. Cache-Schlüssel müssen Tenant-Kontext enthalten.
- Datenfrische: Legen Sie TTLs fest, die der Aktualisierungshäufigkeit der Daten entsprechen. Ein zu veralteter Cache ist schlimmer als kein Cache.
- Sensible oder risikoreiche Ausgaben: Cachen Sie keine Ausgaben, die PII, Finanzentscheidungen, medizinischen Rat oder andere sensible Inhalte enthalten, es sei denn, die Caching-Schicht hat äquivalente Sicherheitskontrollen. Im Zweifel nicht cachen.
Observability und Evaluierung als Produktionsanforderungen
Observability für KI-Agenten unterscheidet sich von traditioneller Anwendungs-Observability. Agenten treffen dynamische Entscheidungen, rufen externe Tools auf und erzeugen Ausgaben, die mit einfachen Bestanden/Nicht-Bestanden-Prüfungen schwer zu validieren sind. Der KI-Agenten-Einsatz in der Produktion erfordert Observability, die Folgendes abdeckt:
- Tool-Entscheidungen: Welche Tools wurden mit welchen Parametern aufgerufen und welche Ergebnisse kamen zurück.
- Routing-Entscheidungen: Welches Modell oder welcher Zweig wurde ausgewählt und warum.
- Zwischenzustand: Ausgabe von jedem Schritt in der Agenten-Kette, nicht die verborgene Chain-of-Thought des Modells.
- Modell- und Tool-Metadaten: Modellversion, Tool-Version und verwendete Parameter, sodass Regressionen auf spezifische Versionen zurückverfolgt werden können.
- Guardrail-Ergebnisse: Ob jede Schicht bestanden oder fehlgeschlagen ist, und der Ablehnungsgrund, wenn ein Guardrail eine Aktion blockiert.
- Latenz- und Kosten-Traces: Aufschlüsselung von Zeit und Token-Kosten pro Schritt, sodass Engpässe sichtbar werden.
- Endergebnis: Das Endergebnis der Arbeit des Agenten mit Erfolgs- oder Fehlerstatus.
Redaction, Datenklassifizierung und Aufbewahrungsrichtlinie sind obligatorisch. Protokollieren Sie niemals vollständige Prompts oder vollständigen Kontext, wenn PII oder Secrets vorhanden sein können. Klassifizieren Sie Daten vor der Protokollierung, redigieren Sie sensible Felder und setzen Sie Aufbewahrungslimits durch, damit Protokolle keine Belastung werden. Versuchen Sie nicht, die verborgene Chain-of-Thought des Modells zu protokollieren — sie ist nicht zuverlässig verfügbar, und das Erzwingen kann die Ausgabequalität verschlechtern.
Die Evaluierung geht über das Testen der endgültigen Ausgabe hinaus. Testen Sie jeden Schritt in der Agenten-Kette, sodass Regressionen an dem Schritt erfasst werden, an dem sie entstehen, und nicht nur am Ende. Setzen Sie Warnungen für Drift-Metriken, Latenzbudget-Verstöße, Kosten-Schwellen und Guardrail-Ablehnungsraten, sodass Probleme auftauchen, bevor Nutzer sie bemerken.
Grounding-Retrieval zur Reduzierung von Drift und Kosten
Retrieval-Augmented Generation kann, wenn gut implementiert, sowohl Drift als auch Kosten reduzieren. Genaues Grounding gibt dem Agenten relevanten, aktuellen Kontext, was die Anzahl der Schlussfolgern-Turns und die Wahrscheinlichkeit von Halluzinationen verringert. Weniger Turns bedeuten weniger Tokens und niedrigere Latenz. Grounding verstärkt auch die ursprünglichen Anweisungen, indem es konkreten, abgerufenen Kontext bereitstellt, der das Schlussfolgern des Agenten verankert.
RAG ist kein kostenloser Gewinn — es fügt Retrieval-Overhead hinzu und führt eigene Fehlermodi ein, wenn die Retrieval-Qualität schlecht ist. Aber gut konzipiertes Retrieval kann Retries und Schlussfolgern-Schleifen reduzieren und einen Nettonutzen für Drift, Kosten und Latenz erzeugen. Für einen tieferen Einblick in Retrieval-Orchestrierung, Evaluierung und Grounding siehe Retrieval-Orchestrierung und Grounding in agentischem RAG.
Wie HDWEBSOFT KI-Agenten-Produktionslaunches entschärft
HDWEBSOFT hilft Teams, KI-Agenten vom Pilot in die Produktion zu überführen, durch ein strukturiertes Launch-Framework für gut begrenzte Bereitstellungen. Das Framework ist kein Paket mit festem Umfang und festem Zeitplan — es ist ein phasierter Ansatz, der sich an die Komplexität des Anwendungsfalls, die Reife der bestehenden Agentenlogik und die Produktionsbereitschaft der Organisation anpasst. Für den KI-Agenten-Einsatz im Unternehmen hilft dieser strukturierte Ansatz Teams, die vier Engpässe vom ersten Tag an zu vermeiden.
Was das Launch-Framework abdeckt
Das Framework deckt die Komponenten ab, die der KI-Agenten-Einsatz in der Produktion erfordert, die Piloten jedoch typischerweise auslassen:
- Architekturdesign: Produktionsreife Architektur, die Guardrails, Observability und Kostenkontrollen von Anfang an berücksichtigt.
- Implementierung gestaffelter Guardrails: Deterministische Kontrollen, modellbasierte Prüfungen, Zugriffskontrolle und menschliche Freigabe-Gates, zugeschnitten auf das Risikoprofil des Anwendungsfalls.
- Context-Caching-Setup: Caching-Strategie mit Invalidierung, Tenant-Isolation und Handhabung sensibler Ausgaben.
- Observability-Stack: Protokollierung, Warnung und Evaluierung mit integrierter Redaction, Datenklassifizierung und Aufbewahrungsrichtlinie.
- Kontrolliertes Rollout: Phasierte Bereitstellung, die mit einem engen Umfang beginnt und basierend auf bewiesenen Ergebnissen erweitert wird.
Das Framework eignet sich für Anwendungsfälle mit klarem Umfang und bestehender oder einfacher Agentenlogik. Es ist kein Sprint von Null an — es ist ein strukturierter Weg in die Produktion für Agenten, die ihren Wert im Pilot bewiesen haben und das Engineering-Rigor benötigen, um im Maßstab zu überleben.
Ein phasierter Ansatz, kein fester Zeitplan
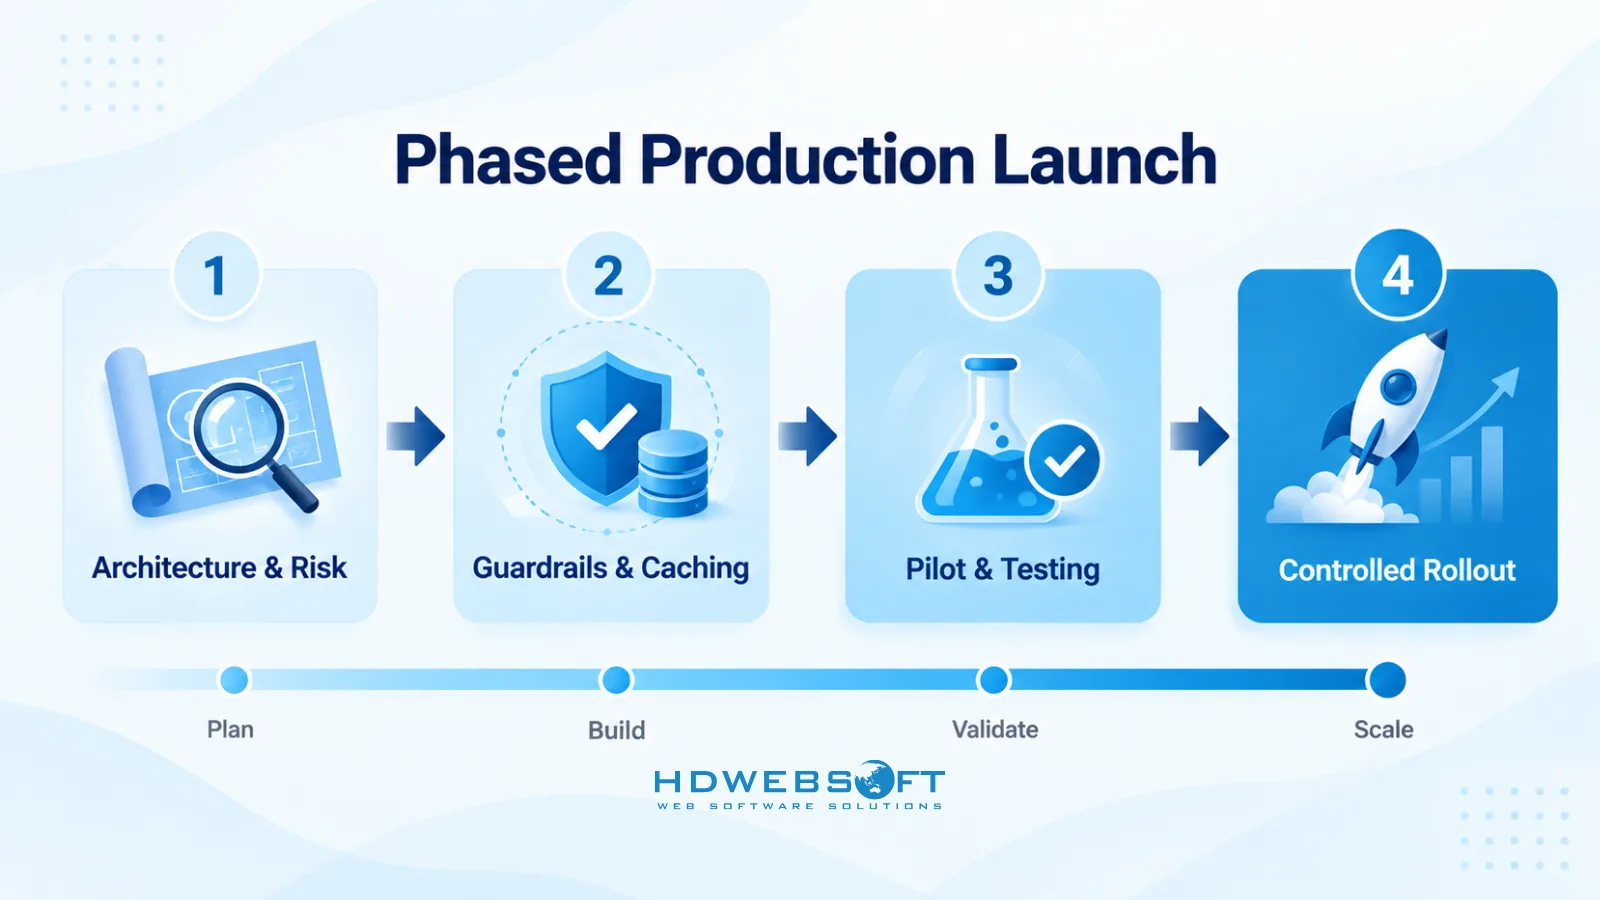
Der Launch folgt einem phasierten Ansatz statt einem festen Zeitplan. Die Phasen sind:
- Architektursitzung und Risikobewertung: Definieren Sie den Anwendungsfall, Erfolgs-Metriken, Risikoprofil und Produktionsanforderungen. Identifizieren Sie, welche Engpässe — Drift, Latenz, Kosten, Sicherheit — für die Bereitstellung am relevantesten sind.
- Implementierung von Guardrails, Caching und Observability: Bauen Sie das Produktionsfundament, bevor der Agent echten Verkehr berührt. Gestaffelte Guardrails, Caching mit Invalidierung und Observability mit Redaction werden in dieser Phase eingerichtet.
- Pilot-Bereitstellung und Tests: Setzen Sie den Agenten in einer kontrollierten Umgebung ein, die die Produktion spiegelt, mit aktiven Guardrails und Observability. Testen Sie gegen realistische Last, Randfälle und Fehlermodi.
- Kontrolliertes Rollout und Monitoring: Rollen Sie schrittweise aus, überwachen Sie Drift-Metriken, Latenz, Kosten und Guardrail-Ergebnisse und erweitern Sie den Umfang basierend auf bewiesenen Ergebnissen.
Die Dauer jeder Phase hängt von der Komplexität des Anwendungsfalls, der Reife der bestehenden Agentenlogik und der Produktionsbereitschaft der Organisation ab. Das Framework bietet Struktur und Disziplin, keinen starren Zeitplan.
Warum ein strukturierter Launch den Produktionseinsatz entschärft
Ein strukturierter Launch entschärft den KI-Agenten-Einsatz in der Produktion auf mehrere Arten:
- Umfangsklarheit: Ein gut begrenzter Anwendungsfall verhindert Scope Creep, der der häufigste Grund ist, warum Produktionsbereitstellungen Budget und Zeitplan überschreiten.
- Fokus auf einen wertvollen Anwendungsfall: Anstatt zu versuchen, jeden Agenten gleichzeitig einzusetzen, konzentriert sich das Framework auf einen Anwendungsfall, bei dem der Erfolg am wahrscheinlichsten und der Wert am höchsten ist.
- Guardrails und Observability von Anfang an: Produktionsfundamente werden vor dem Launch gebaut, nicht nach dem ersten Vorfall nachgerüstet.
- Baseline für Skalierung: Ein erfolgreiches kontrolliertes Rollout liefert die Baseline — Metriken, Guardrail-Schwellen, Kostenmuster — auf die zukünftige Skalierungsentscheidungen vertrauen.
Für Teams, die bereit sind, vom Pilot zur Produktion zu wechseln, ist der nächste Schritt eine technische Architektursitzung mit unserem KI-Leiter, um den Anwendungsfall zu kartieren, die relevanten Engpässe zu identifizieren und die Produktionsanforderungen zu definieren. Vereinbaren Sie eine technische Architektursitzung mit unserem KI-Leiter, um das Gespräch zu beginnen.
Fazit
Der KI-Agenten-Einsatz in der Produktion ist eine Engineering-Disziplin, keine Modellausstattung. Die vier Engpässe — Prompt Drift, API-Latenz, Token-Kosten und Sicherheitslücken — sind vorhersagbar, diagnostizierbar und behebbar, aber nur, wenn Teams vor der Produktion dafür konzipieren, statt nach dem ersten Vorfall. Ein erfolgreicher KI-Agenten-Einsatz erfordert gestaffelte Guardrails, intelligentes Context Caching und strukturierte Observability von Anfang an.
Gestaffelte Guardrails, intelligentes Context Caching mit ordnungsgemäßer Invalidierung und Tenant-Isolation sowie strukturierte Observability mit Redaction und Aufbewahrungsrichtlinie bilden das Produktionsfundament, das Piloten fehlt. Eine Token-Kostenprognose mit Budgetschwellen und einer Stopp- oder Eskalationsrichtlinie ist eine Voraussetzung, kein Nachgedanke. Und ein strukturiertes Launch-Framework — phasiert, nicht starr getaktet — gibt Teams die Disziplin, einen Anwendungsfall gut einzusetzen, bevor sie zum nächsten skalieren.
HDWEBSOFT hilft Teams, diesen Übergang mit einem phasierten Launch-Framework zu navigieren, das Produktionsfundamente aufbaut, bevor der Agent echten Verkehr berührt. Für Organisationen, die bereit sind voranzuschreiten, ist der nächste Schritt eine technische Architektursitzung, um den Anwendungsfall zu definieren, die relevanten Engpässe zu identifizieren und die Bereitstellung zu planen.
FAQ
Was ist der KI-Agenten-Einsatz in der Produktion?
Der KI-Agenten-Einsatz in der Produktion ist der Betrieb eines autonomen KI-Systems, das unter realer Last, mit echten Nutzern und echten Konsequenzen schlussfolgert, Tools aufruft und Aktionen ausführt. Er erfordert gestaffelte Guardrails, Observability, Kostenkontrollen und Rollback-Verfahren, die Piloten typischerweise fehlen. Ein erfolgreicher KI-Agenten-Einsatz behandelt Zuverlässigkeit, Sicherheit und Kostenkontrolle als Kern-Engineering-Anforderungen.
Warum scheitern KI-Agenten-Piloten beim Übergang in die Produktion?
Piloten scheitern in der Produktion aufgrund von vier technischen Engpässen: Prompt Drift, API-Latenz, Token-Kosten und Sicherheitslücken. Teams unterschätzen diese, weil Piloten in kontrollierten Umgebungen mit wenigen Nutzern, wenigen Randfällen und ohne echten Kostendruck laufen. Ohne Guardrails, Observability und Kostenprognosen, die für die Produktion konzipiert sind, scheitert der KI-Agenten-Einsatz, wenn Agenten driften, langsam werden, Tokens verbrennen und Daten leaken.
Was ist Prompt Drift und wie kontrollieren Sie es?
Prompt Drift, auch Context- oder Instruction Drift genannt, ist der allmähliche Verlust der Anweisungseinhaltung, wenn ein Agent längere Sitzungen oder Multi-Turn-Schleifen verarbeitet. Er wird durch Kontextwachstum, Trunkierung, widersprüchliche Anweisungen, veralteten Speicher und Zwischenergebnisse verursacht. Kontrollieren Sie ihn durch periodische Re-Injection von Einschränkungen, Kontextfenster-Management, deterministische Checkpoints und Drift-Erkennung mit mehreren Signalen — Aufgabenerfolgsquote, Einschränkungs-Verletzungsrate, Tool-Aufruf-Korrektheit, Regression-Evals und semantische Distanz.
Wie viel kostet es, KI-Agenten in der Produktion zu betreiben?
Die Kosten hängen von durchschnittlichen Tokens pro Sitzung, Sitzungen pro Tag und Modellpreisen ab. Multi-Agenten-Schleifen können Kosten schnell oder superlinear treiben aufgrund von wiederholtem Kontext, Retries und Verzweigung. Erstellen Sie vor dem Launch eine Token-Kostenprognose und legen Sie Budgetschwellen mit einer Stopp- oder Eskalationsrichtlinie fest, sodass Budgetüberschreitungen erfasst werden, bevor die Rechnung eintrifft.
Was sind gestaffelte Guardrails für KI-Agenten?
Gestaffelte Guardrails kombinieren mehrere Arten von Kontrolle: deterministische Regeln (Schema-Validierung, Tool-Aufruf-Allowlists, Schleifenlimits, Berechtigungsprüfungen), modellbasierte oder klassifikatorbasierte Prüfungen (Inhaltsfilter, Halluzinationsdetektoren), Zugriffskontrolle (minimale Rechte, begrenzte Tool-Berechtigungen) und menschliche Freigabe für sensible Aktionen. Keine einzelne Schicht ist ausreichend — jede deckt Lücken ab, die die anderen offen lassen, und zusammen bilden sie das Rückgrat der KI-Agenten-Zuverlässigkeit in der Produktion.
Wie funktioniert das HDWEBSOFT-KI-Agenten-Launch-Framework?
Das Launch-Framework von HDWEBSOFT ist ein phasierter Ansatz für gut begrenzte Bereitstellungen: Architektursitzung und Risikobewertung, Implementierung von Guardrails, Caching und Observability, Pilot-Bereitstellung und Tests sowie kontrolliertes Rollout und Monitoring. Das Framework passt sich an die Komplexität des Anwendungsfalls und die Bereitschaft der Organisation an, anstatt einem festen Zeitplan zu folgen. Für den KI-Agenten-Einsatz im Unternehmen hilft dieser strukturierte Ansatz Teams, die vier Engpässe von Anfang an zu vermeiden.