El despliegue de agentes de IA es donde la mayoría de los pilotos prometedores se rompen. Una demostración que responde preguntas en un entorno controlado rara vez sobrevive al contacto con usuarios reales, datos reales y presupuestos reales. Gartner predice que más del 40% de los proyectos de IA agéntica serán cancelados para finales de 2027, con el aumento de costos y los controles de riesgo inadecuados entre las razones principales. La brecha entre el piloto y la IA agéntica en producción no es solo un problema tecnológico — es un problema de disciplina de ingeniería que pocos equipos anticipan antes de llegar a producción.
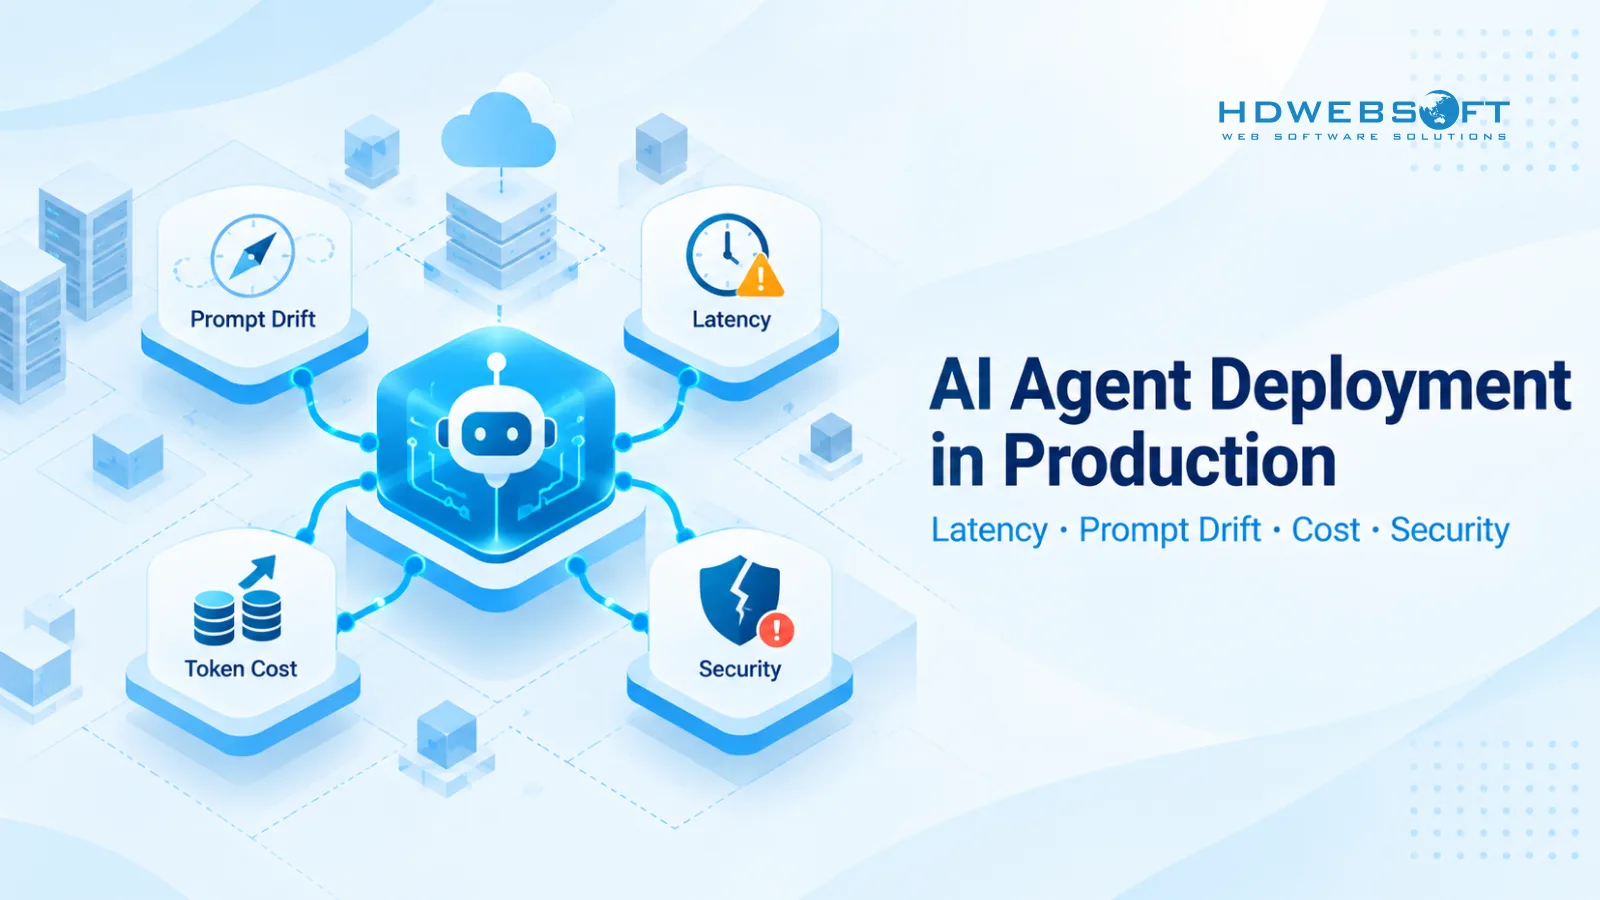
Los pilotos tienen éxito porque se ejecutan en entornos controlados con pocos usuarios, pocos casos límite y sin presión real de costos. La producción expone a los agentes a picos de tráfico, entradas ambiguas, contenido adversarial y restricciones presupuestarias que los pilotos nunca simulan. Sin barreras de protección, observabilidad y controles de costo diseñados para producción desde el inicio, los agentes se desvían, se ralentizan, consumen tokens en exceso y filtran datos. Este artículo desglosa los cuatro cuellos de botella técnicos que rompen el despliegue de agentes de IA en producción — deriva de prompts, latencia de API, costo de tokens y brechas de seguridad — y explica cómo las barreras de protección por capas, el almacenamiento inteligente en caché del contexto y la observabilidad estructurada ayudan a los equipos a desplegar agentes de IA en producción de forma fiable.
Puntos Clave
- Gartner predice que más del 40% de los proyectos de IA agéntica serán cancelados para finales de 2027, con el aumento de costos y los controles de riesgo inadecuados entre las razones principales.
- Cuatro cuellos de botella técnicos rompen los despliegues en producción: deriva de prompts, latencia de API, costo de tokens y brechas de seguridad.
- Las barreras de protección por capas — que combinan reglas deterministas, verificaciones basadas en modelos, control de acceso y aprobación humana — forman la columna vertebral de la fiabilidad de los agentes de IA.
- Los bucles multi-agente pueden elevar el costo de tokens rápidamente o de forma superlineal debido al contexto repetido, los reintentos y la ramificación; los límites de bucle, el enrutamiento de modelos y el almacenamiento en caché del contexto son palancas esenciales.
- Un pronóstico de costo de tokens con umbrales presupuestarios y una política de parada o escalado es un requisito previo para el despliegue en producción, no una ocurrencia tardía.
- La observabilidad para agentes de IA requiere redacción, clasificación de datos y política de retención — nunca registre prompts completos ni contexto cuando haya PII o secretos presentes.
Qué Significa Realmente el Despliegue de Agentes de IA en Producción
El despliegue de agentes de IA en producción no es simplemente ejecutar un modelo en un servidor. Es operar un sistema autónomo que razona, llama herramientas y realiza acciones bajo carga real, con usuarios reales y consecuencias reales. Producción significa que el sistema debe mantenerse fiable, seguro y con costo controlado cuando el tráfico se dispara, las entradas se vuelven desordenadas y los presupuestos se ajustan.
Piloto vs Producción: La Brecha Que Mata los Proyectos
La brecha entre el piloto y la producción es donde mueren la mayoría de los proyectos. Los pilotos se ejecutan en entornos controlados con pocos usuarios, pocos casos límite y sin presión real de costos. La producción expone a los agentes a picos de tráfico, entradas ambiguas, contenido adversarial y restricciones presupuestarias que los pilotos nunca simulan.
| Dimensión | Piloto | Producción |
|---|---|---|
| Usuarios | Un puñado de evaluadores | Miles o más, patrones impredecibles |
| Casos límite | Curados, limitados | Ilimitados, adversariales |
| SLA | Mejor esfuerzo | Contractual o vinculado a expectativas del usuario |
| Presupuesto | Tolerante | Límites estrictos, alertas de costo, escalado |
| Observabilidad | Inspección manual | Dashboards en tiempo real, alertas, trazas de auditoría |
| Reversión | Reiniciar la demostración | Reversión controlada, valores predeterminados a prueba de fallos |
Los equipos que tratan los pilotos como experimentos en lugar de prototipos de producción rara vez tienen éxito al escalar. Los equipos más exitosos diseñan para producción desde el inicio, construyendo barreras de protección, observabilidad y controles de costo como requisitos fundamentales en lugar de ocurrencias tardías.
Los Cuatro Cuellos de Botella Técnicos Que Rompen los Despliegues en Producción
Cuando los agentes pasan del piloto a la producción, cuatro cuellos de botella técnicos explican la mayoría de los fracasos en el despliegue de agentes de IA:
- Deriva de prompts — los agentes pierden gradualmente la adherencia a las instrucciones originales a medida que el contexto crece y las salidas intermedias se acumulan.
- Latencia de API — las llamadas secuenciales entre inferencia de LLM, llamadas a herramientas y orquestación acumulan latencia que rompe los flujos de trabajo en tiempo real.
- Costo de tokens — los bucles multi-agente, los reintentos y la ramificación elevan el uso de tokens rápidamente o de forma superlineal.
- Brechas de seguridad — inyección indirecta de prompts, llamadas a herramientas inseguras y riesgos de exfiltración de datos que la AppSec tradicional no cubre por completo.
Cada cuello de botella es predecible, diagnosticable y abordar — pero solo si los equipos diseñan para ellos antes de la producción, no después. Para el despliegue de agentes de IA empresariales, estos cuatro problemas explican la mayoría de los fracasos en producción.
Cuello de Botella 1: La Deriva de Prompts Erosiona la Fiabilidad del Agente
La deriva de prompts, también llamada deriva de contexto o de instrucciones, es la pérdida gradual de adherencia a las instrucciones a medida que un agente procesa conversaciones más largas o bucles de múltiples turnos. El agente comienza alineado con sus instrucciones originales, pero a medida que la interacción crece, sus salidas se desvían cada vez más del comportamiento previsto.
Qué Causa la Deriva de Prompts en Bucles de Agentes Multi-Turno
Varios mecanismos provocan la deriva de prompts en el despliegue de agentes de IA en producción:
- Crecimiento del contexto: A medida que una conversación o bucle de agente se extiende, la ventana de contexto se llena con salidas intermedias, resultados de llamadas a herramientas y mensajes de usuario. El prompt del sistema original y las restricciones ocupan una porción cada vez menor de la atención del modelo.
- Truncamiento: Cuando el contexto excede la ventana del modelo, el contenido más antiguo — a menudo incluyendo instrucciones críticas — se trunca o se resume, perdiendo fidelidad.
- Instrucciones en conflicto: Las nuevas instrucciones de salidas de herramientas, mensajes de usuario u otros agentes pueden entrar en conflicto con el prompt del sistema original, y el modelo puede seguir la instrucción más reciente sin reglas de precedencia explícitas.
- Memoria obsoleta: La información almacenada en memoria o sistemas de recuperación puede quedar desactualizada, llevando al agente a actuar sobre un contexto que ya no refleja la realidad.
- Salidas intermedias: Las salidas de pasos anteriores en una cadena multi-agente influyen en el razonamiento de pasos posteriores. Si una salida temprana es sutilmente incorrecta, el error se compone aguas abajo.
Ninguno de estos mecanismos requiere que el modelo “prefiera el contexto reciente” — surgen de las realidades prácticas de la gestión del contexto, el truncamiento y el sheer volumen de contenido intermedio que los agentes en producción generan.
Cómo la Deriva de Prompts Degrada la Calidad de las Salidas Con el Tiempo
Las consecuencias de la deriva se componen a lo largo de sesiones largas y cadenas multi-agente, socavando la fiabilidad del agente de IA. Los agentes comienzan a alucinar, llamar a las herramientas equivocadas, violar restricciones o perder el rastro del objetivo original. En bucles multi-agente, la deriva es especialmente peligrosa: el agente A pasa contexto al agente B, que pasa al agente C, y cada traspaso introduce otra oportunidad de pérdida de instrucciones.
En los registros de producción, la deriva se manifiesta como una degradación sutil de calidad que es fácil pasar por alto. Las salidas pueden seguir pareciendo plausibles en la superficie, pero ya no satisfacen las restricciones originales — un agente de soporte al cliente comienza a omitir descargos de responsabilidad obligatorios, un agente de análisis de datos comienza a omitir intervalos de confianza, o un agente de programación deja de seguir la guía de estilo del equipo. Sin métricas de detección de deriva, estas regresiones suelen pasar desapercibidas hasta que un usuario se queja o una auditoría detecta la brecha.
Detección y Contención de la Deriva de Prompts
Controlar la deriva requiere tanto prevención como detección. Las técnicas de prevención incluyen:
- Reinyección periódica: Reinyectar el prompt del sistema y las restricciones críticas a intervalos regulares, en lugar de depender de que el prompt original permanezca visible a lo largo de una sesión larga.
- Gestión de la ventana de contexto: Resumir o podar el contenido intermedio para mantener las instrucciones originales prominentes. Conservar solo lo que el siguiente paso necesita.
- Puntos de control deterministas: Validar la salida del agente en cada turno contra las restricciones originales, no solo al final de la sesión.
La detección requiere múltiples señales, no una sola métrica. Una detección de deriva efectiva combina:
- Tasa de éxito de tareas: ¿El agente sigue completando su tarea correctamente?
- Tasa de violación de restricciones: ¿Con qué frecuencia el agente rompe reglas explícitas?
- Corrección de llamadas a herramientas: ¿Se llaman a las herramientas correctas con los parámetros correctos?
- Evaluaciones de regresión: Ejecutar un conjunto fijo de evaluaciones periódicamente para detectar regresiones de calidad contra una línea base conocida.
- Distancia semántica: Medir cuánto se han desviado las salidas del comportamiento previsto, como una señal entre muchas.
Ninguna métrica única detecta toda la deriva. Los equipos que dependen solo de la distancia semántica o solo de la tasa de éxito de tareas perderán regresiones que las otras señales detectan. Un enfoque multi-señal es la única forma fiable de detectar la deriva en el despliegue de agentes de IA en producción.
Cuello de Botella 2: La Latencia de API Rompe los Flujos de Trabajo de Agentes en Tiempo Real
La latencia es el segundo cuello de botella que rompe los despliegues en producción. Los flujos de trabajo de agentes encadenan múltiples llamadas — inferencia de LLM, ejecución de herramientas, recuperación, orquestación — y la latencia se acumula a lo largo de cada paso secuencial. Cuando la ramificación o los reintentos entran en escena, el tiempo de respuesta total puede aumentar bruscamente, haciendo más difícil mantener el despliegue de agentes de IA en producción dentro de tiempos de respuesta aceptables.
Dónde Se Oculta la Latencia en las Cadenas de Llamadas del Agente
La latencia en el despliegue de agentes de IA proviene de varias fuentes:
- Inferencia de LLM: El tiempo de generación del propio modelo, que escala con la longitud de salida y el tamaño del modelo.
- Latencia de llamadas a herramientas: APIs externas, bases de datos y servicios que el agente llama, cada uno añadiendo tiempo de ida y vuelta.
- Sobrecarga de recuperación RAG: La recuperación, la incrustación y la clasificación añaden tiempo antes de que el modelo comience a generar.
- Orquestación multi-agente: La coordinación entre agentes — enrutamiento, traspasos, agregación de resultados — añade sobrecarga además de la latencia de llamadas individuales.
- Serialización y deserialización: La conversión entre formatos para cada llamada añade pequeños pero acumulativos retrasos.
En un bucle multi-agente, la latencia se acumula a lo largo de llamadas secuenciales. Si cada paso toma unos segundos y el bucle ejecuta varios pasos, el tiempo de respuesta total puede alcanzar decenas de segundos. La ramificación — donde un agente prueba múltiples enfoques — y los reintentos — donde un agente reintenta un paso fallido — pueden elevar la latencia total aún más. Como ejemplo ilustrativo, una sola llamada de agente podría tomar de 3 a 8 segundos, y una cadena multi-agente de varios pasos podría alcanzar de 30 a 60 segundos. Estos números son ejemplos, no universales — la latencia real depende de la elección del modelo, el rendimiento de las herramientas y el diseño de la orquestación.
Presupuestos de Latencia para Agentes de IA en Producción
Un presupuesto de latencia es el tiempo máximo de respuesta aceptable para una tarea dada, asignado a lo largo de cada paso en la cadena del agente. Sin un presupuesto, los equipos no tienen forma de decidir cuándo la latencia es aceptable o cuándo la arquitectura debe cambiar.
Ejemplos de presupuestos de latencia — estos son ilustrativos, no SLAs universales:
- Interacciones en tiempo real (p. ej., chat, soporte en vivo): menos de 5 segundos
- Tareas casi en tiempo real (p. ej., análisis de datos, generación de informes): menos de 30 segundos
- Tareas en segundo plano (p. ej., procesamiento por lotes, agentes programados): menos de 5 minutos
Una vez establecido el presupuesto, asígnelo a lo largo de los pasos en la cadena del agente. Si el total estimado excede el presupuesto, la arquitectura debe cambiar — paralelizar llamadas a herramientas, acortar el razonamiento, enrutar tareas más simples a modelos más rápidos, o mover el trabajo a procesamiento en segundo plano.
Reducción de la Latencia Sin Sacrificar la Profundidad del Razonamiento
Varias técnicas reducen la latencia sin forzar al agente a razonar con menos profundidad:
- Respuestas en streaming: Transmitir la salida al usuario a medida que se genera, para que el usuario vea progreso en lugar de esperar una respuesta completa.
- Enrutamiento de modelos: Enrutar tareas simples a modelos más pequeños y más rápidos y reservar modelos grandes para tareas que requieren razonamiento más profundo. Las decisiones de enrutamiento deben basarse en la complejidad de la tarea, el riesgo y los requisitos de calidad — no en una proporción fija.
- Llamadas a herramientas en paralelo: Ejecutar llamadas a herramientas independientes en paralelo en lugar de secuencialmente, reduciendo el tiempo total de espera.
- Almacenamiento en caché: Cachear las salidas de LLM y los resultados de herramientas para entradas similares y evitar llamadas redundantes.
- Ejecución especulativa (opcional, avanzado): Para pasos con patrones predecibles, ejecutar los siguientes pasos probables antes de que el paso actual se complete.
La generación aumentada por recuperación ilustra bien la compensación de latencia. RAG añade sobrecarga de recuperación, pero un buen anclaje puede reducir el número de reintentos y bucles de razonamiento que un agente necesita, lo que puede reducir la latencia total. El efecto neto depende de la implementación — RAG no siempre reduce la latencia, pero una recuperación bien diseñada puede.
Cuello de Botella 3: Explosión del Costo de Tokens en Bucles Multi-Agente
El costo de tokens es el cuello de botella que sorprende a los equipos. Los pilotos se ejecutan con pocos usuarios y pocos casos límite, por lo que el uso de tokens se mantiene manejable. La producción escala el uso, y los bucles multi-agente amplifican el costo de formas que los datos del piloto nunca revelaron. Sin un pronóstico de costos, el despliegue de agentes de IA en producción puede agotar los presupuestos antes de que nadie lo note.
Por Qué los Bucles Multi-Agente Consumen Tokens de Forma Impredecible
Los bucles multi-agente elevan el costo de tokens rápidamente o de forma superlineal en el despliegue de agentes de IA debido a varios factores:
- Contexto repetido: Cada turno en un bucle reenvía contexto — prompt del sistema, historial de conversación, resultados de herramientas — al modelo. A medida que el contexto crece, cada turno cuesta más tokens que el anterior.
- Reintentos: Cuando un agente produce una salida inválida, el bucle reintenta, enviando el contexto completo nuevamente más la retroalimentación del error.
- Ramificación: Cuando un agente prueba múltiples enfoques, cada rama consume tokens, y solo la salida de una rama puede usarse.
- Intercambios multi-agente: Los agentes que se comunican entre sí consumen tokens por cada mensaje, añadiendo una sobrecarga que los sistemas de un solo agente no tienen.
Como ejemplo ilustrativo, una sesión de piloto podría usar 5.000 tokens. A 1.000 sesiones por día en producción, eso se convierte en 5 millones de tokens por día — y eso es antes de contabilizar los reintentos, la ramificación y el crecimiento del contexto que el tráfico de producción introduce. El costo puede aumentar rápidamente o de forma superlineal, no lineal, cuando estos factores se componen.
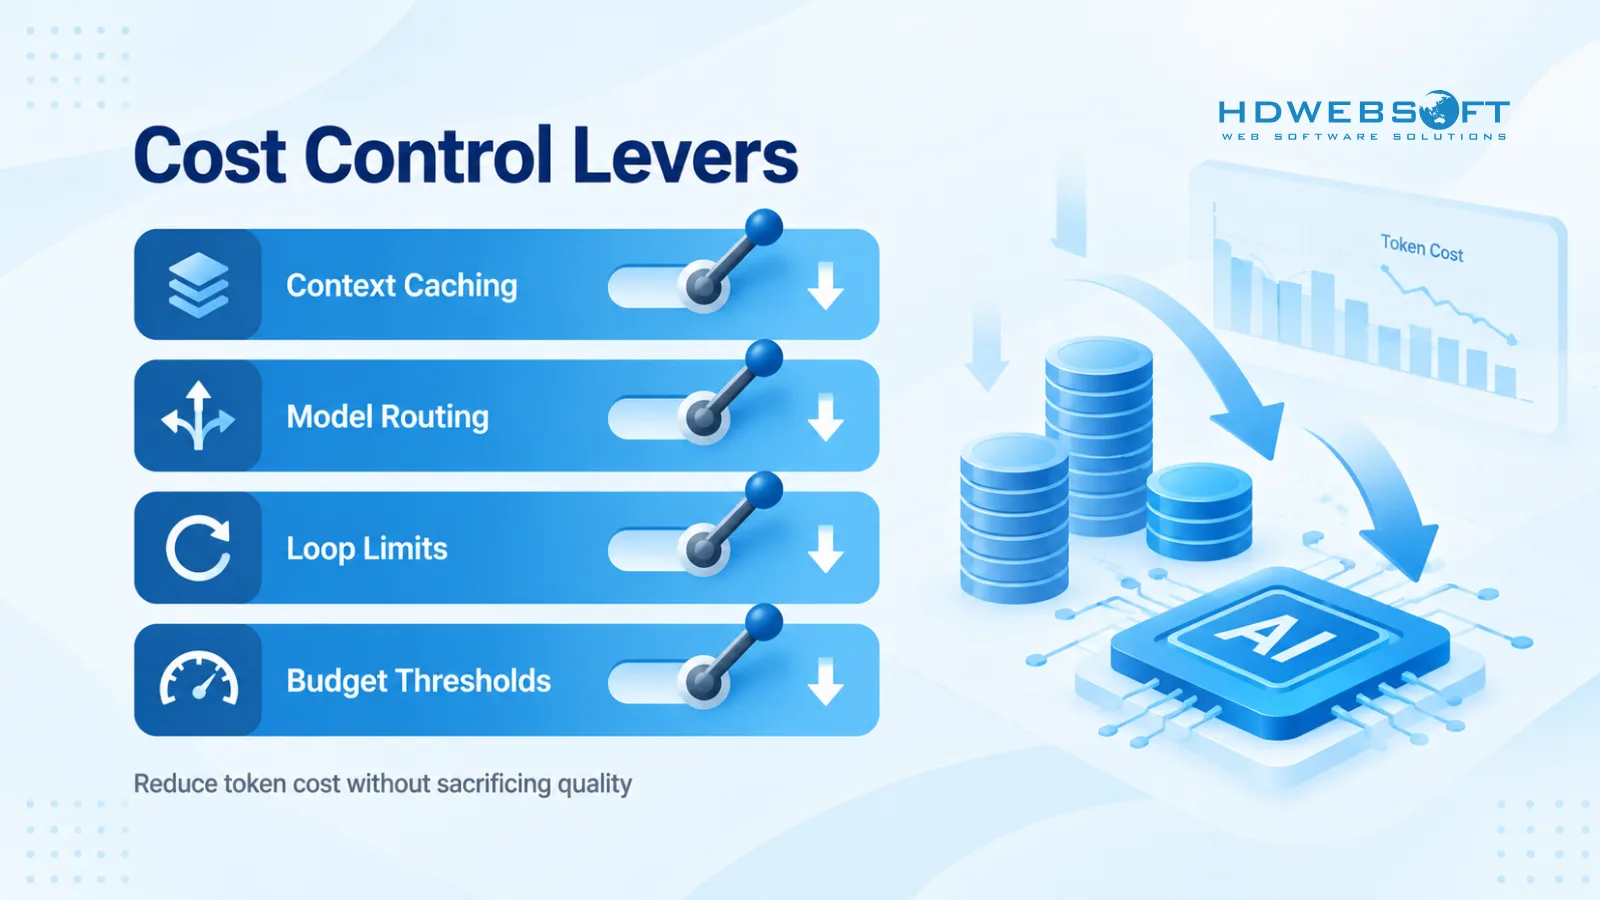
Palancas de Costo: Almacenamiento en Caché del Contexto, Enrutamiento de Modelos, Límites de Bucle
Varias palancas controlan el costo de tokens en producción:
- Almacenamiento en caché del contexto: Cachear los prefijos de prompts, los resultados de herramientas y las salidas de LLM para entradas similares y evitar reenviar o regenerar el mismo contenido.
- Enrutamiento de modelos: Enrutar tareas al modelo más pequeño que cumpla con los requisitos de calidad. Las decisiones de enrutamiento deben basarse en la complejidad de la tarea, el riesgo y los requisitos de calidad — no en una proporción fija como 80% pequeño y 20% grande.
- Límites de bucle: Establecer un número máximo de turnos por sesión. Cuando se alcanza el límite, terminar el bucle y escalar a un humano o a una ruta de respaldo.
- Compresión de prompts: Resumir o comprimir el contexto en lugar de reenviar el historial completo en cada turno.
- Procesamiento por lotes: Mover tareas que no son en tiempo real a procesamiento por lotes, donde el costo puede optimizarse sin presión de latencia.
Construcción de un Pronóstico de Costo de Tokens Antes de Desplegar
Un pronóstico de costo de tokens es un requisito previo para el despliegue de agentes de IA en producción, no una ocurrencia tardía. Construya el pronóstico antes del lanzamiento:
- Estime los tokens promedio por sesión: Incluya el prompt del sistema, el contexto, los resultados de herramientas y la salida. Contabilice los reintentos y la ramificación.
- Multiplique por las sesiones esperadas por día: Use un volumen de producción realista, no el volumen del piloto.
- Aplique el precio del modelo: Calcule el costo diario y mensual a los precios actuales de tokens.
- Añada un margen para la varianza: El tráfico de producción es impredecible; añada un margen para picos inesperados.
- Separe costos fijos y variables: Los costos fijos incluyen los prompts del sistema y el contexto base; los costos variables escalan con los turnos, las llamadas a herramientas y los reintentos.
Una vez que el pronóstico esté en su lugar, establezca umbrales presupuestarios con una política de parada o escalado. Cuando el gasto cruza un umbral, el sistema puede detener el agente, escalar a un humano, cambiar a un modelo más económico o alertar al equipo — la política depende del caso de uso. La clave es tener una política antes del lanzamiento, no descubrir la brecha presupuestaria después de que llegue la factura.
Cuello de Botella 4: Brechas de Seguridad y Salidas del Agente Sin Control
La seguridad es el cuarto cuello de botella, y es el que los equipos tradicionales de seguridad de aplicaciones están menos preparados para enfrentar. Los agentes no solo generan texto — llaman a herramientas, acceden a datos y realizan acciones, lo que introduce amenazas que los controles convencionales de AppSec no fueron diseñados para abordar. Desplegar agentes de IA en producción sin barreras de protección específicas para agentes deja a las organizaciones expuestas a ataques de inyección, exfiltración de datos y llamadas a herramientas inseguras.
Inyección Indirecta de Prompts y Llamadas a Herramientas Inseguras
La inyección indirecta de prompts es el principal riesgo de seguridad para los agentes en producción y una de las principales causas de fracaso en el despliegue de agentes de IA. A diferencia de la inyección directa de prompts, donde un atacante manipula el prompt directamente, la inyección indirecta oculta instrucciones maliciosas dentro de los datos que el agente recupera o procesa — contenido generado por usuarios, documentos recuperados, salidas de herramientas o páginas web externas.
Cuando un agente lee este contenido, puede seguir las instrucciones inyectadas como si fueran legítimas. Un agente que lee un correo electrónico de un cliente que contiene instrucciones ocultas podría filtrar datos, llamar a una herramienta sensible o modificar un registro que no debería tocar. Debido a que la inyección llega a través de los datos, no a través del prompt mismo, la validación de entradas por sí sola no la detecta.
El riesgo se agrava cuando los agentes tienen capacidades de llamada a herramientas. Un agente que puede enviar correos, modificar bases de datos o iniciar pagos conlleva mucho más riesgo que un agente que solo genera texto. Cada llamada a herramientas es una acción potencial con consecuencias reales, y las llamadas a herramientas sin control pueden causar daños antes de que nadie lo note.
Riesgos de Exfiltración de Datos en Flujos de Trabajo del Agente
Los agentes a menudo tienen acceso a múltiples fuentes de datos — bases de datos, APIs, almacenes de archivos — y ese acceso crea riesgo de exfiltración. Un agente que puede leer datos sensibles y enviar correos o llamar a APIs externas puede exfiltrar esos datos a través de sus salidas o llamadas a herramientas.
Los sistemas multi-agente amplifican el riesgo. El agente A puede tener un amplio acceso a datos porque sus tareas lo requieren, mientras que el agente B tiene un alcance más estrecho. Si el agente B puede solicitar datos al agente A, y las salidas del agente B fluyen a un canal externo, los datos pueden moverse de un agente de alto acceso a un destino externo sin que ninguno de los agentes viole explícitamente su propio alcance.
Las mitigaciones incluyen:
- Principio de mínimo privilegio: Dar a cada agente el acceso mínimo a datos que sus tareas requieren, con el alcance lo más restringido posible.
- Filtrado de salidas: Validar las salidas del agente antes de que lleguen a canales externos, bloqueando el contenido que contiene datos sensibles.
- Registros de auditoría: Registrar cada llamada a herramientas, sus parámetros y su resultado, para que los intentos de exfiltración sean rastreables.
Por Qué la AppSec Tradicional Es Necesaria Pero No Suficiente
La seguridad de aplicaciones tradicional sigue siendo necesaria pero no es suficiente para los riesgos específicos de los agentes. Los WAF, la validación de entradas, la autenticación y la autorización siguen importando — son la base. Pero no cubren las amenazas que los agentes introducen:
- La inyección de prompts no es una inyección de código tradicional. Explota el comportamiento de seguimiento de instrucciones del modelo, no una vulnerabilidad de código, por lo que las reglas del WAF y la sanitización de entradas no la detectan.
- Los agentes deciden qué herramientas llamar dinámicamente. No hay una ruta fija que filtrar — el propio razonamiento del agente determina la acción, y los controles de seguridad tradicionales no pueden predecir ni filtrar cada posible ruta de llamada a herramientas.
- Las salidas del agente pueden contener datos sensibles filtrados a través de registros, correos o llamadas a APIs externas, incluso cuando el almacén de datos subyacente está debidamente protegido.
Se requieren barreras de protección específicas para los agentes además de la AppSec tradicional: validación de salidas, listas de permitidos para llamadas a herramientas, aprobación humana para acciones sensibles y trazas de auditoría completas. Para un análisis más profundo de los modelos de amenazas y mitigaciones específicas de LLM, consulte seguridad LLM para IA agéntica.
Cómo Desplegar Agentes de IA en Producción de Forma Fiable
Abordar los cuatro cuellos de botella requiere un enfoque estructurado que combine barreras de protección, almacenamiento en caché y observabilidad. Cada componente aborda uno o más cuellos de botella, y juntos forman la base de producción que los pilotos carecen. Para los equipos que aprenden cómo desplegar agentes de IA en producción, los siguientes componentes son esenciales.
Barreras de Protección por Capas: La Columna Vertebral de la Fiabilidad del Agente
Las barreras de protección por capas combinan múltiples tipos de control, cada uno abordando diferentes modos de fallo:
- Controles deterministas: Validación de esquema para salidas, listas de permitidos para llamadas a herramientas, límites de bucle y verificaciones de permisos. Estas son reglas que no dependen del modelo — imponen restricciones independientemente de lo que el agente genere, formando la primera capa de fiabilidad del agente de IA.
- Verificaciones basadas en modelos o clasificadores: Filtros de contenido, detectores de alucinaciones y clasificadores de salida que detectan problemas que las reglas deterministas no pueden. Estos usan modelos más pequeños o clasificadores para evaluar las salidas del agente antes de que lleguen a los usuarios o a las herramientas.
- Control de acceso: Principio de mínimo privilegio para cada agente, permisos de herramientas con alcance limitado y límites de acceso a datos vinculados al rol del agente.
- Aprobación humana: Para acciones sensibles — pagos, modificaciones de datos, comunicaciones externas — requerir aprobación humana explícita antes de que el agente ejecute la acción.
Ninguna capa por sí sola es suficiente. Las reglas deterministas detectan violaciones de esquema y llamadas a herramientas no autorizadas pero pierden problemas sutiles de contenido. Las verificaciones basadas en modelos detectan problemas de contenido pero pueden ser ellas mismas vulnerables a entradas adversariales. La aprobación humana detecta acciones de alto riesgo pero no escala a cada decisión. La fortaleza de las barreras de protección por capas es que cada capa cubre las brechas que las demás dejan, haciendo el despliegue de agentes de IA en producción mucho más fiable que cualquier control individual.
Almacenamiento Inteligente en Caché del Contexto para Reducir Latencia y Costo Simultáneamente
El almacenamiento en caché del contexto aborda la latencia y el costo simultáneamente al reducir el trabajo redundante:
- Cachear los prompts del sistema y el contexto estable: Evitar reenviar el mismo prefijo de prompt en cada turno.
- Cachear los resultados de herramientas: Si múltiples turnos necesitan la misma salida de herramienta, cachearla en lugar de llamar a la herramienta nuevamente.
- Caché semántico para salidas de LLM: Para entradas similares, devolver una salida cacheada en lugar de regenerar.
El almacenamiento en caché introduce sus propios riesgos que los equipos de producción deben gestionar:
- Invalidación de caché: Cuando los datos subyacentes cambian, los resultados cacheados deben invalidarse o actualizarse. Una caché obsoleta conduce a respuestas incorrectas.
- Aislamiento de inquilinos: Nunca servir los resultados cacheados de un inquilino a otro. Las claves de caché deben incluir el contexto del inquilino.
- Actualización de datos: Establecer TTLs que coincidan con la frecuencia de actualización de los datos. Una caché demasiado obsoleta es peor que ninguna caché.
- Salidas sensibles o de alto riesgo: No cachear salidas que contengan PII, decisiones financieras, consejos médicos u otro contenido sensible a menos que la capa de caché tenga controles de seguridad equivalentes. En caso de duda, no cachear.
Observabilidad y Evaluación como Requisitos de Producción
La observabilidad para agentes de IA difiere de la observabilidad de aplicaciones tradicionales. Los agentes toman decisiones dinámicas, llaman a herramientas externas y producen salidas que son difíciles de validar con simples verificaciones de aprobado/reprobado. El despliegue de agentes de IA en producción requiere observabilidad que cubra:
- Decisiones de herramientas: Qué herramientas se llamaron, con qué parámetros y qué resultados regresaron.
- Decisiones de enrutamiento: Qué modelo o rama se seleccionó y por qué.
- Estado intermedio: La salida de cada paso en la cadena del agente, no el chain-of-thought oculto del modelo.
- Metadatos de modelo y herramienta: Versión del modelo, versión de la herramienta y parámetros usados, para que las regresiones puedan rastrearse a versiones específicas.
- Resultados de barreras de protección: Si cada capa pasó o falló, y la razón de rechazo cuando una barrera bloquea una acción.
- Trazas de latencia y costo: Desglose de tiempo y costo de tokens por paso, para que los cuellos de botella sean visibles.
- Resultado final: El resultado final del trabajo del agente, con estado de éxito o fracaso.
La redacción, la clasificación de datos y la política de retención son obligatorias. Nunca registre prompts completos ni contexto completo cuando pueda haber PII o secretos presentes. Clasifique los datos antes de registrarlos, redacte los campos sensibles y aplique límites de retención para que los registros no se conviertan en un pasivo. No intente registrar el chain-of-thought oculto del modelo — no está disponible de forma fiable, y forzarlo puede degradar la calidad de la salida.
La evaluación va más allá de probar la salida final. Pruebe cada paso en la cadena del agente, para que las regresiones se detecten en el paso donde se originan en lugar de solo al final. Configure alertas para métricas de deriva, brechas del presupuesto de latencia, umbrales de costo y tasas de rechazo de barreras de protección, para que los problemas salgan a la superficie antes que los usuarios.
Anclaje de la Recuperación para Reducir la Deriva y el Costo
La generación aumentada por recuperación, cuando se implementa bien, puede reducir tanto la deriva como el costo. Un anclaje preciso proporciona al agente un contexto relevante y actual, lo que reduce el número de turnos de razonamiento que necesita y la probabilidad de alucinación. Menos turnos significa menos tokens y menor latencia. El anclaje también refuerza las instrucciones originales al proporcionar un contexto concreto y recuperado que ancla el razonamiento del agente.
RAG no es una victoria gratuita — añade sobrecarga de recuperación e introduce sus propios modos de fallo si la calidad de la recuperación es pobre. Pero una recuperación bien diseñada puede reducir los reintentos y los bucles de razonamiento, produciendo un beneficio neto para la deriva, el costo y la latencia. Para un análisis más profundo de la orquestación de recuperación, la evaluación y el anclaje, consulte orquestación de recuperación y anclaje en RAG agéntico.
Cómo HDWEBSOFT Reduce los Riesgos en los Lanzamientos de Agentes de IA en Producción
HDWEBSOFT ayuda a los equipos a mover los agentes de IA del piloto a la producción a través de un marco de lanzamiento estructurado para despliegues bien delimitados. El marco no es un paquete de alcance y cronograma fijos — es un enfoque por fases que se adapta a la complejidad del caso de uso, la madurez de la lógica del agente existente y la preparación para producción de la organización. Para el despliegue de agentes de IA empresariales, este enfoque estructurado ayuda a los equipos a evitar los cuatro cuellos de botella desde el día uno.
Qué Cubre el Marco de Lanzamiento
El marco cubre los componentes que el despliegue de agentes de IA en producción requiere pero que los pilotos típicamente omiten:
- Diseño de arquitectura: Arquitectura lista para producción que contemple barreras de protección, observabilidad y controles de costo desde el inicio.
- Implementación de barreras de protección por capas: Controles deterministas, verificaciones basadas en modelos, control de acceso y puertas de aprobación humana adaptadas al perfil de riesgo del caso de uso.
- Configuración del almacenamiento en caché del contexto: Estrategia de caché con invalidación, aislamiento de inquilinos y manejo de salidas sensibles.
- Stack de observabilidad: Registro, alertas y evaluación con redacción, clasificación de datos y política de retención integradas.
- Lanzamiento controlado: Despliegue por fases que comienza con un alcance estrecho y se expande en función de resultados probados.
El marco se adapta a casos de uso con un alcance claro y lógica de agente existente o simple. No es un sprint de construcción desde cero — es un camino estructurado hacia la producción para agentes que han demostrado su valor en el piloto y necesitan el rigor de ingeniería para sobrevivir a escala.
Un Enfoque por Fases, No un Cronograma Fijo
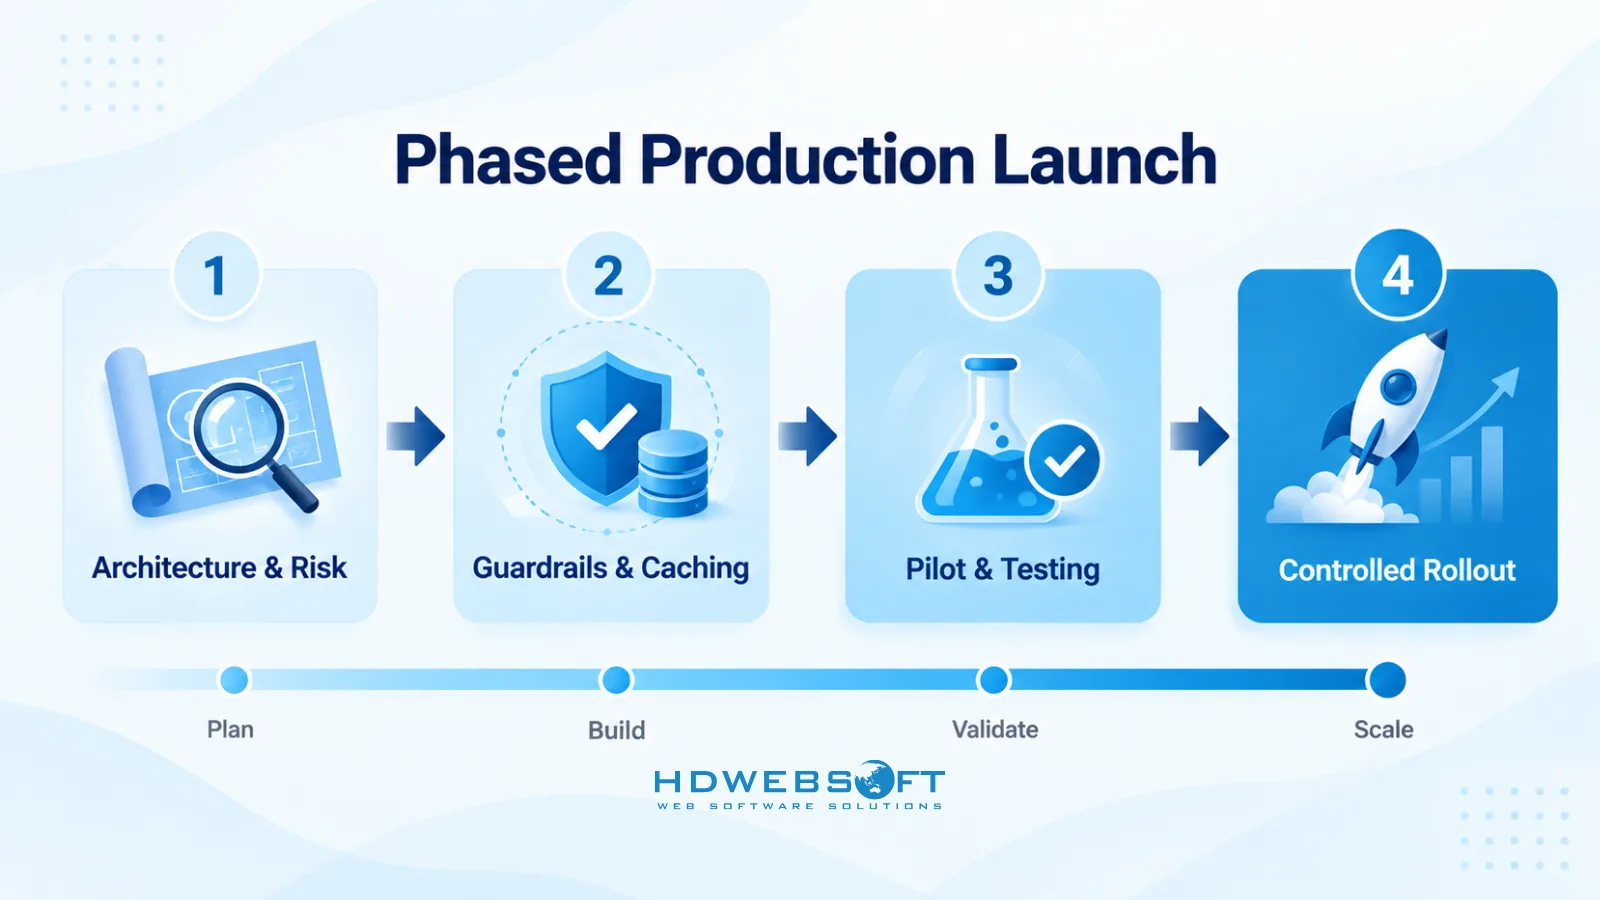
El lanzamiento sigue un enfoque por fases en lugar de un cronograma fijo. Las fases son:
- Sesión de arquitectura y evaluación de riesgos: Definir el caso de uso, las métricas de éxito, el perfil de riesgo y los requisitos de producción. Identificar qué cuellos de botella — deriva, latencia, costo, seguridad — son más relevantes para el despliegue.
- Implementación de barreras de protección, caché y observabilidad: Construir la base de producción antes de que el agente toque tráfico real. Las barreras de protección por capas, el almacenamiento en caché con invalidación y la observabilidad con redacción se configuran en esta fase.
- Despliegue del piloto y pruebas: Desplegar el agente en un entorno controlado que refleje la producción, con todas las barreras de protección y la observabilidad activas. Probar contra carga realista, casos límite y modos de fallo.
- Lanzamiento controlado y monitoreo: Desplegar gradualmente, monitorear métricas de deriva, latencia, costo y resultados de barreras de protección, y expandir el alcance en función de resultados probados.
La duración de cada fase depende de la complejidad del caso de uso, la madurez de la lógica del agente existente y la preparación para producción de la organización. El marco proporciona estructura y disciplina, no un cronograma rígido.
Por Qué un Lanzamiento Estructurado Reduce los Riesgos del Despliegue en Producción
Un lanzamiento estructurado reduce los riesgos del despliegue de agentes de IA en producción de varias formas:
- Claridad del alcance: Un caso de uso bien delimitado previene el alcance descontrolado, que es la razón más común por la que los despliegues en producción exceden el presupuesto y el cronograma.
- Enfoque en un caso de uso de alto valor: En lugar de intentar desplegar todos los agentes a la vez, el marco se enfoca en un caso de uso donde el éxito es más probable y el valor es mayor.
- Barreras de protección y observabilidad desde el inicio: Las bases de producción se construyen antes del lanzamiento, no se añaden después del primer incidente.
- Línea base para escalar: Un lanzamiento controlado exitoso proporciona la línea base — métricas, umbrales de barreras de protección, patrones de costo — en la que las decisiones futuras de escalado se apoyan.
Para los equipos listos para pasar del piloto a la producción, el siguiente paso es una sesión de arquitectura técnica con nuestro líder de IA para mapear el caso de uso, identificar los cuellos de botella relevantes y definir los requisitos de producción. Programe una Sesión de Arquitectura Técnica con nuestro Líder de IA para iniciar la conversación.
Conclusión
El despliegue de agentes de IA en producción es una disciplina de ingeniería, no una capacidad del modelo. Los cuatro cuellos de botella — deriva de prompts, latencia de API, costo de tokens y brechas de seguridad — son predecibles, diagnosticables y abordar, pero solo cuando los equipos diseñan para ellos antes de la producción en lugar de después del primer incidente. Un despliegue exitoso de agentes de IA requiere barreras de protección por capas, almacenamiento inteligente en caché del contexto y observabilidad estructurada desde el inicio.
Las barreras de protección por capas, el almacenamiento inteligente en caché del contexto con invalidación y aislamiento de inquilinos adecuados, y la observabilidad estructurada con redacción y política de retención forman la base de producción que los pilotos carecen. Un pronóstico de costo de tokens con umbrales presupuestarios y una política de parada o escalado es un requisito previo, no una ocurrencia tardía. Y un marco de lanzamiento estructurado — por fases, no con un cronograma rígido — da a los equipos la disciplina para desplegar un caso de uso bien antes de escalar al siguiente.
HDWEBSOFT ayuda a los equipos a navegar esta transición con un marco de lanzamiento por fases que construye las bases de producción antes de que el agente toque tráfico real. Para las organizaciones listas para avanzar, el siguiente paso es una sesión de arquitectura técnica para definir el caso de uso, identificar los cuellos de botella relevantes y planificar el despliegue.
Preguntas Frecuentes
¿Qué es el despliegue de agentes de IA en producción?
El despliegue de agentes de IA en producción es la operación de un sistema de IA autónomo que razona, llama a herramientas y realiza acciones bajo carga real, con usuarios reales y consecuencias reales. Requiere barreras de protección por capas, observabilidad, controles de costo y procedimientos de reversión que los pilotos típicamente carecen. Un despliegue exitoso de agentes de IA trata la fiabilidad, la seguridad y el control de costo como requisitos fundamentales de ingeniería.
¿Por qué los pilotos de agentes de IA fallan al pasar a producción?
Los pilotos fallan en producción debido a cuatro cuellos de botella técnicos: deriva de prompts, latencia de API, costo de tokens y brechas de seguridad. Los equipos subestiman estos porque los pilotos se ejecutan en entornos controlados con pocos usuarios, pocos casos límite y sin presión real de costos. Sin barreras de protección, observabilidad y pronósticos de costo diseñados para producción, el despliegue de agentes de IA falla cuando los agentes se desvían, se ralentizan, consumen tokens en exceso y filtran datos.
¿Qué es la deriva de prompts y cómo se controla?
La deriva de prompts, también llamada deriva de contexto o de instrucciones, es la pérdida gradual de adherencia a las instrucciones a medida que un agente procesa sesiones más largas o bucles de múltiples turnos. Es causada por el crecimiento del contexto, el truncamiento, las instrucciones en conflicto, la memoria obsoleta y las salidas intermedias. Contrólele reinyectando las restricciones periódicamente, gestionando las ventanas de contexto, añadiendo puntos de control deterministas y detectando la deriva con múltiples señales — tasa de éxito de tareas, tasa de violación de restricciones, corrección de llamadas a herramientas, evaluaciones de regresión y distancia semántica.
¿Cuánto cuesta ejecutar agentes de IA en producción?
El costo depende de los tokens promedio por sesión, las sesiones por día y el precio del modelo. Los bucles multi-agente pueden elevar el costo rápidamente o de forma superlineal debido al contexto repetido, los reintentos y la ramificación. Construya un pronóstico de costo de tokens antes del lanzamiento y establezca umbrales presupuestarios con una política de parada o escalado para que las brechas de gasto se detecten antes de que llegue la factura.
¿Qué son las barreras de protección por capas para agentes de IA?
Las barreras de protección por capas combinan múltiples tipos de control: reglas deterministas (validación de esquema, listas de permitidos para llamadas a herramientas, límites de bucle, verificaciones de permisos), verificaciones basadas en modelos o clasificadores (filtros de contenido, detectores de alucinaciones), control de acceso (mínimo privilegio, permisos de herramientas con alcance limitado) y aprobación humana para acciones sensibles. Ninguna capa por sí sola es suficiente — cada una cubre las brechas que las demás dejan, y juntas forman la columna vertebral de la fiabilidad del agente de IA en producción.
¿Cómo funciona el marco de lanzamiento de agentes de IA de HDWEBSOFT?
El marco de lanzamiento de HDWEBSOFT es un enfoque por fases para despliegues bien delimitados: sesión de arquitectura y evaluación de riesgos, implementación de barreras de protección, caché y observabilidad, despliegue del piloto y pruebas, y lanzamiento controlado y monitoreo. El marco se adapta a la complejidad del caso de uso y la preparación de la organización, en lugar de seguir un cronograma fijo. Para el despliegue de agentes de IA empresariales, este enfoque estructurado ayuda a los equipos a evitar los cuatro cuellos de botella desde el inicio.