
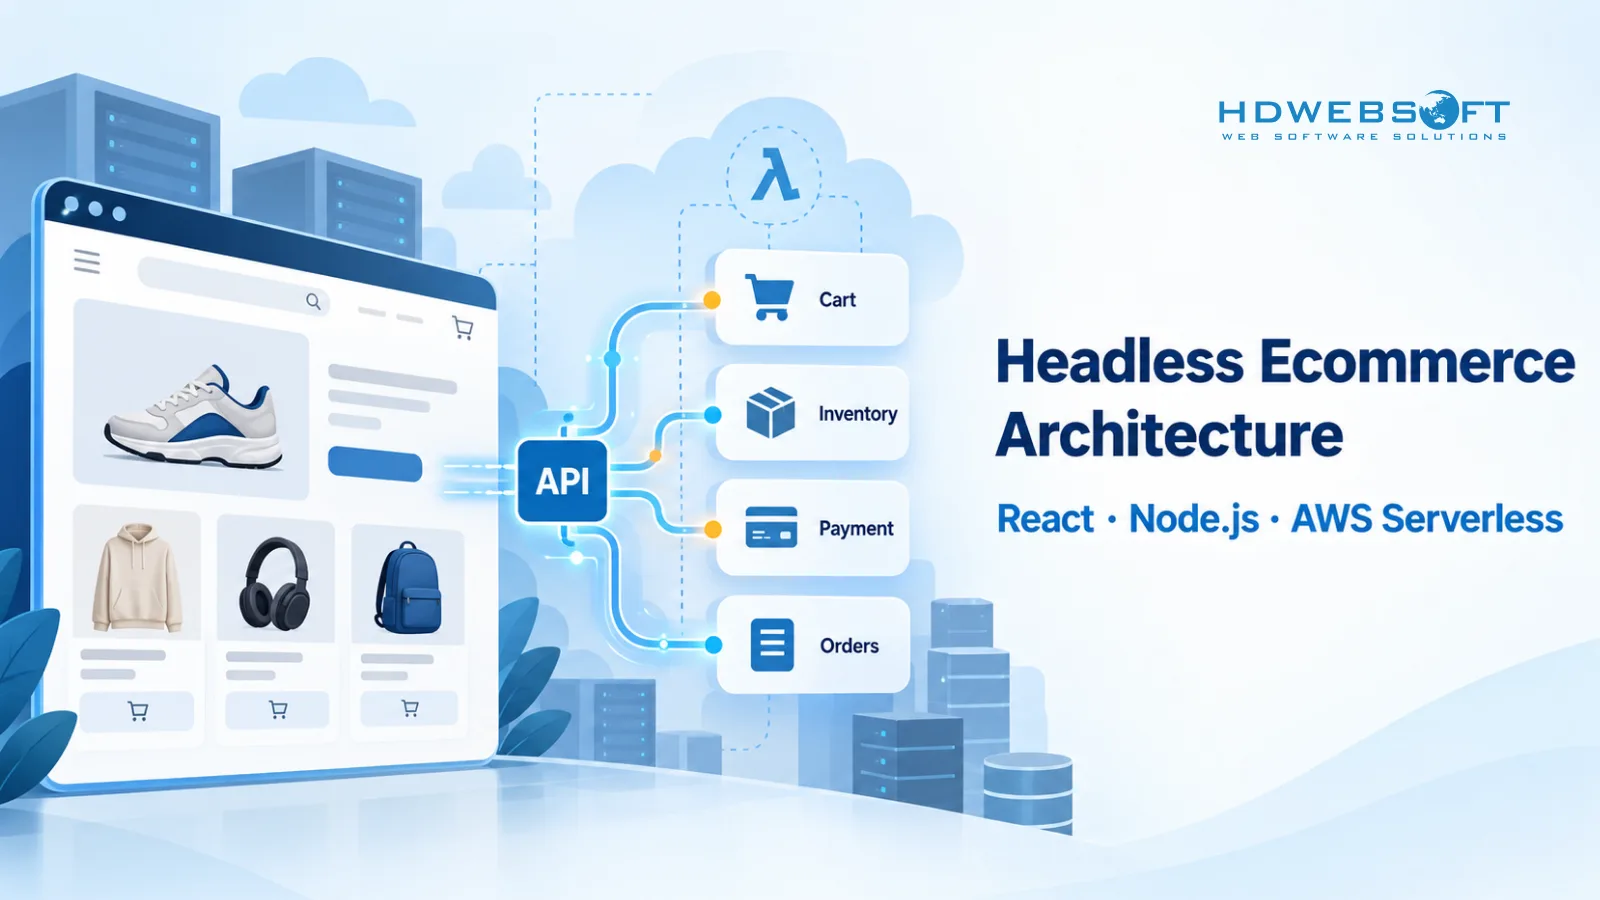
Les plateformes e-commerce à fort trafic échouent rarement parce qu’un framework frontend est trop lent. Les problèmes apparaissent généralement lorsque le rendu du storefront, les API catalogue, le checkout, l’inventaire, le paiement, la personnalisation et les intégrations tierces se disputent la capacité pendant le même pic de trafic.
Une architecture e-commerce headless sépare le storefront côté client du moteur commerce via des API. Cela permet à la couche de présentation, aux services backend, aux intégrations et aux workloads de support de scaler et d’évoluer plus indépendamment.
Pour les marques qui préparent des flash sales, une expansion internationale, des expériences omnicanales ou des parcours d’achat fortement personnalisés, cette séparation peut créer une base technique plus solide. Cependant, l’architecture headless ne garantit pas automatiquement des chargements sous la seconde ni une concurrence massive. La performance dépend toujours du caching, de la conception des API, de la capacité de la base de données, du traitement asynchrone, de l’observabilité et de tests de charge réalistes.
Pour une vue d’ensemble de l’architecture et de l’UX dans le retail en ligne, consultez notre guide des services de développement e-commerce.
Points clés
- L’e-commerce headless sépare le storefront des capacités commerce du backend, permettant à chaque couche de scaler et d’évoluer plus indépendamment.
- Un stack de référence courant combine React, un BFF Node.js/GraphQL, un moteur commerce et des services AWS serverless pour les workloads asynchrones.
- Les storefronts rapides dépendent de la stratégie de rendu, du caching CDN, de la conception des API et de la performance en aval — pas de React seul.
- Le checkout doit garder un chemin synchrone réduit tandis que les tâches post-commande appropriées passent au traitement événementiel.
- Le commerce à fort trafic exige idempotence, files d’attente, backpressure, cohérence des stocks et planification de capacité au-delà du simple auto-scaling.
- La personnalisation IA doit avoir un budget de latence et un comportement de repli pour ne jamais devenir une dépendance critique du storefront.
Ce qu’une architecture e-commerce headless à fort trafic doit résoudre
Dans sa forme la plus simple, l’e-commerce headless sépare l’expérience client de la plateforme commerce en backend.
Dans un système e-commerce traditionnel, la présentation, la logique catalogue, le checkout, les plugins et les workflows backend peuvent vivre dans la même application. Cela fonctionne bien jusqu’à ce que différentes parties du système doivent scaler, livrer ou changer indépendamment.
Avec l’architecture headless, un storefront React, une application mobile, une interface marketplace ou un autre frontend communique avec les capacités commerce via des API.
Cela crée des frontières plus claires entre :
- l’expérience client
- le catalogue et les prix
- le panier et le checkout
- le traitement des commandes
- l’inventaire
- la recherche
- la personnalisation
- les intégrations tierces
Le headless et le composable commerce sont liés, mais pas identiques.
Le headless commerce sépare principalement la couche de présentation du backend. Le composable commerce va plus loin en traitant des capacités comme la recherche, le paiement, les promotions, le contenu et le checkout comme des composants modulaires pouvant être remplacés ou évoluer indépendamment.
Les principes MACH décrivent cette approche plus large autour de la modularité, des API, de la livraison cloud-native et de la présentation headless.
Pour les marques à fort trafic, l’architecture doit partir des exigences de charge plutôt que d’un stack technologique préféré.
Au lieu de dire : « Le système doit supporter 100 000 utilisateurs simultanés. »
Les équipes devraient traduire cet objectif en caractéristiques mesurables :
- requêtes par seconde
- ratio navigation/checkout
- appels API par parcours client
- taux de cache-hit
- répartition géographique
- durée des pics
- limites des API en aval
Cent mille personnes consultant des pages catalogue en cache, c’est très différent de cent mille clients tentant simultanément de réserver un stock limité et de soumettre un paiement.
Les frontières de défaillance comptent aussi.
Si le service de recommandation tombe, les clients doivent-ils toujours pouvoir naviguer ? Si la synchronisation CRM ralentit, le checkout doit-il s’arrêter ? Si le fournisseur d’e-mails devient indisponible, une commande doit-elle échouer ?
Un système headless bien conçu empêche les capacités optionnelles d’entraîner les flux commerce critiques dans leur chute.
Architecture de référence : React, Node.js, GraphQL & AWS Serverless
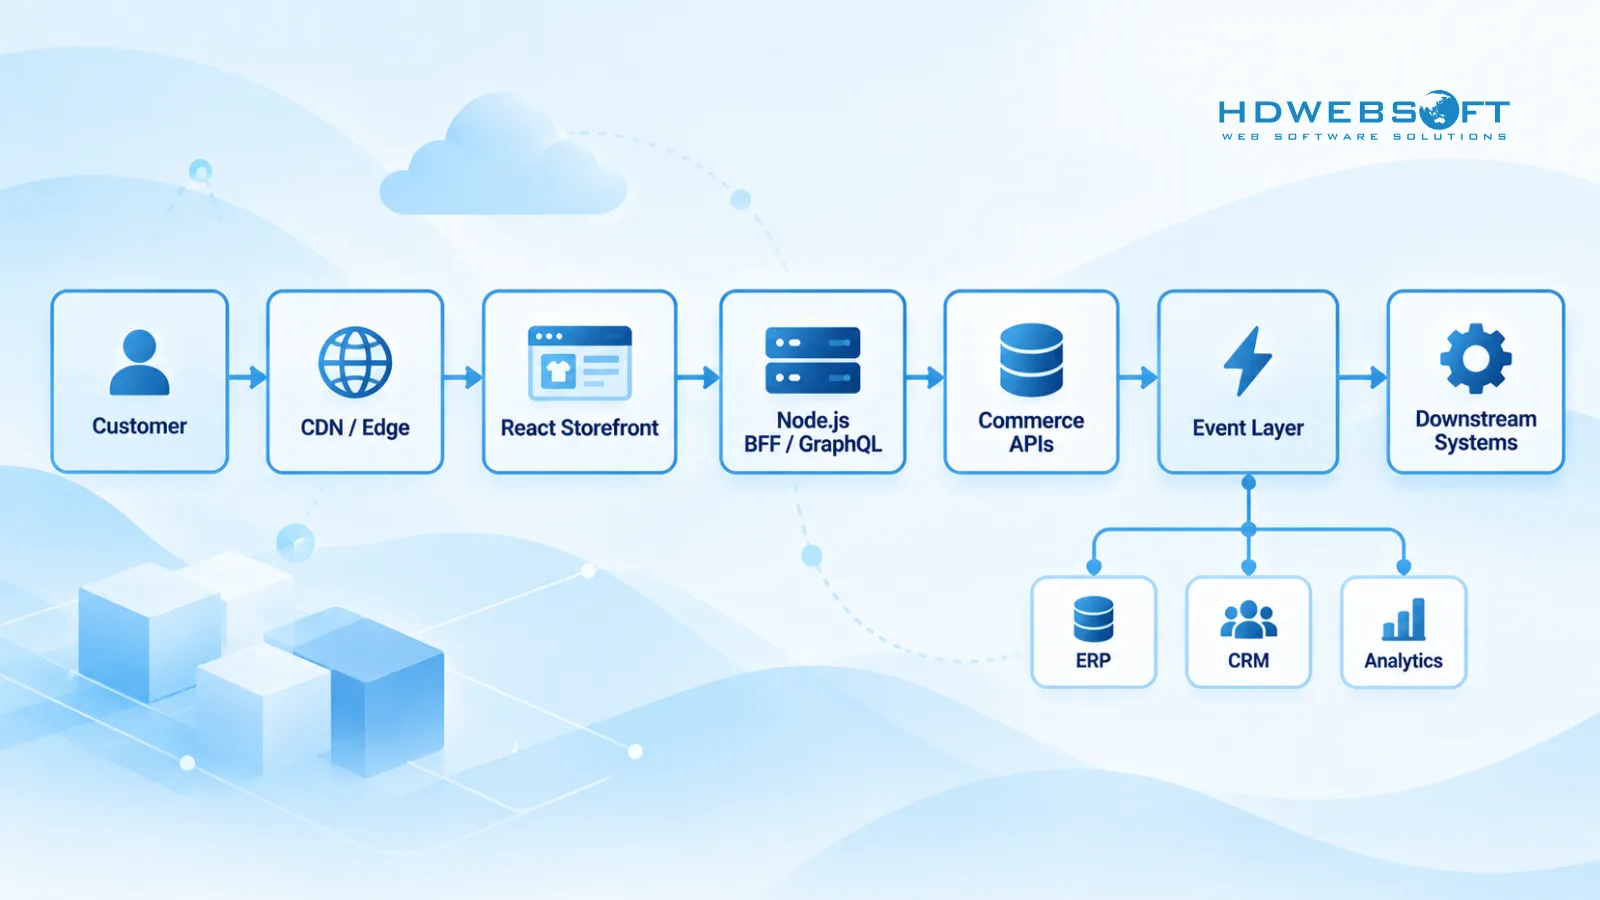
Une architecture e-commerce headless pratique peut se représenter ainsi : Customer → CDN/Edge → React Storefront → Node.js BFF/GraphQL → Commerce APIs → Event Layer → Downstream Systems
C’est une architecture de référence, pas un stack obligatoire. GraphQL peut être remplacé par REST, Lambda par des conteneurs, ou un backend sur mesure par une plateforme headless commerce commerciale.
L’essentiel est d’établir des frontières claires.
Storefront React et distribution Edge
React offre la flexibilité nécessaire pour construire la découverte produit, le compte, le panier et le checkout, mais React seul ne rend pas un storefront rapide.
Différentes pages requièrent généralement différentes stratégies de rendu.
Les pages produit et catégorie peuvent bénéficier du SSR, du rendu statique ou incrémental et du caching CDN. Les pages panier, compte et checkout dépendent davantage de données propres au client et offrent donc un potentiel de cache partagé moindre.
Les storefronts à fort trafic devraient aussi considérer :
- le caching CDN et Edge
- l’optimisation des images et assets statiques
- les patterns stale-while-revalidate
- l’invalidation du cache pour le catalogue et les prix
- les clés de cache par locale, devise et région
La personnalisation ajoute un autre défi. Si chaque réponse devient totalement unique, l’efficacité du cache chute fortement.
Une meilleure architecture garde souvent la majeure partie de la page cachable tout en chargeant séparément certains composants personnalisés.
Node.js BFF et GraphQL
Un storefront connecté directement à de nombreux services backend peut vite créer une cascade d’API.
Une page produit peut nécessiter des données du catalogue, des prix, de l’inventaire, des promotions, du CMS, des avis et des recommandations.
Un Backend-for-Frontend (BFF) crée une frontière dédiée pour agréger ces services.
Un BFF Node.js peut gérer :
- l’agrégation d’API
- l’authentification et les sessions
- la transformation des réponses
- les timeouts
- le comportement de repli
- la normalisation des erreurs
GraphQL peut fournir un contrat flexible entre le storefront et le BFF, mais il doit être soigneusement conçu.
Un mauvais design de resolvers peut créer des requêtes N+1 ou des appels backend séquentiels. Les systèmes en production peuvent donc nécessiter du batching, des limites de complexité de requête, du caching, des requêtes persistées et des budgets de timeout stricts.
Le BFF doit aussi empêcher les services optionnels de dicter la latence totale de la page. Si une API de recommandation est lente, la page produit devrait généralement continuer à s’afficher sans attendre indéfiniment.
Moteur commerce et couche événementielle
Le moteur commerce reste responsable des règles métier faisant foi, notamment :
- le catalogue
- les prix
- les promotions
- le panier
- le checkout
- l’inventaire
- les commandes
Le storefront peut optimiser la présentation, mais les règles critiques pour l’activité doivent rester derrière des API contrôlées.
Pour les workflows asynchrones, les services AWS peuvent offrir une couche de découplage supplémentaire.
Un flux typique : OrderCreated → EventBridge / SQS → Lambda → ERP / CRM / Fulfillment / Analytics
EventBridge peut router un événement métier vers plusieurs consommateurs, tandis que SQS met en tampon les workloads quand les consommateurs ne peuvent traiter les événements au rythme où ils sont produits.
Cette architecture s’aligne sur les principes plus larges de l’infrastructure cloud-native en permettant à chaque composant de scaler selon son propre workload.
Les organisations construisant fortement sur l’infrastructure Amazon peuvent également explorer les services de développement AWS de HDWEBSOFT pour l’architecture cloud, le développement serverless, la migration et le DevOps.
Le serverless n’est pas automatiquement le bon choix pour chaque composant. Les workloads à haut débit soutenu ou les services aux exigences de connexion complexes peuvent encore bénéficier de conteneurs ou d’architectures hybrides.
Checkout en temps réel et traitement des commandes à grande échelle
Le fort trafic crée le plus grand risque là où la vitesse rencontre l’exactitude transactionnelle.
Les pages de navigation tolèrent souvent le caching ou des données légèrement obsolètes. Le checkout ne tolère ni doubles débits, ni doubles commandes, ni survente d’un stock limité.
Le chemin synchrone du checkout doit donc rester focalisé.
Un chemin critique typique : valider le panier → confirmer les prix actuels → réserver l’inventaire → autoriser le paiement → créer la commande
Une fois la commande durable créée, de nombreux autres workflows peuvent s’exécuter de façon asynchrone :
- e-mail de confirmation
- synchronisation CRM
- mises à jour ERP
- analytics
- mises à jour de fidélité
- événements marketing
- feedback pour les recommandations
Cela empêche les intégrations non critiques d’allonger le temps de checkout du client.
Le guide AWS pour intégrer les microservices avec les services serverless fournit des patterns pour la communication asynchrone, le routage d’événements et le traitement par files d’attente.
Idempotence et sécurité des retries
Les retries sont normaux dans les systèmes e-commerce distribués. Un client peut cliquer deux fois sur checkout. Un timeout réseau peut pousser le navigateur à réessayer. Les prestataires de paiement peuvent renvoyer des webhooks. Les consommateurs de files peuvent recevoir le même événement plus d’une fois. L’application doit donc être conçue pour que répéter la même requête ne répète pas l’action métier. Une clé d’idempotence peut associer plusieurs soumissions de checkout identiques à une transaction existante au lieu de créer plusieurs commandes.
Le même principe s’applique aux workers en arrière-plan. Les retries doivent aussi être contrôlés. Les défaillances temporaires peuvent justifier un retry avec backoff, tandis que des données invalides ne doivent pas être réessayées indéfiniment. Les événements en échec peuvent finalement être déplacés vers une dead-letter queue pour investigation.
Backpressure et limites en aval
Auto-scaler agressivement chaque service ne garantit pas la stabilité. Imaginez une flash sale générant des milliers d’événements de commande alors qu’une intégration ERP ne peut traiter qu’un nombre limité de requêtes par seconde. Si chaque commande déclenche immédiatement un appel ERP, le système en aval devient le goulot d’étranglement. Une file d’attente absorbe le pic et laisse le consommateur traiter le travail à un rythme soutenable. C’est le backpressure : protéger les systèmes plus lents au lieu de laisser la scalabilité en amont les submerger.
Cohérence de l’inventaire
L’inventaire est un autre défi du fort trafic. S’il reste un produit et que 20 clients tentent le checkout en même temps, chaque requête ne doit pas lire indépendamment « 1 disponible » et réussir à l’acheter. Le système d’inventaire faisant foi peut exiger des réservations atomiques, des mises à jour conditionnelles ou des contrôles de concurrence optimistes. Les réservations peuvent aussi expirer lorsque le paiement échoue ou que le checkout est abandonné. Le modèle de cohérence exact dépend de l’entreprise. Les produits en édition limitée exigent des contrôles plus stricts qu’un stock facilement réapprovisionnable.
Ingénierie de performance & scalabilité pour les flash sales
L’architecture headless crée des frontières de scalabilité utiles, mais ces frontières doivent encore être conçues et testées.
Les grands pics de demande retail rendent cela particulièrement important.
Adobe a rapporté que les consommateurs américains ont dépensé 257,8 milliards de dollars en ligne pendant la saison des fêtes 2025, avec 25 jours dépassant chacun 4 milliards de dollars de dépenses en ligne, contre 18 jours l’année précédente. L’analyse couvrait plus de mille milliards de visites sur des sites retail américains. Voir le rapport Adobe Analytics sur l’e-commerce des fêtes 2026.
L’implication n’est pas que chaque plateforme e-commerce a besoin de la même capacité. C’est que les pics de trafic peuvent se répéter pendant une campagne ou une saison d’achats plutôt que lors d’un événement isolé.
Construire un budget de latence
La performance doit être mesurée sur toute la chaîne de requête : CDN → rendu React → BFF → API commerce → personnalisation optionnelle
Optimiser le frontend ne peut compenser une cascade d’API backend ajoutant plusieurs secondes.
Différents parcours clients exigent aussi différentes attentes de performance.
La navigation produit est très sensible à la latence et favorable au cache. Le checkout peut prendre plus de temps car il doit confirmer paiement et inventaire. Le traitement des commandes en arrière-plan peut souvent tolérer des secondes, voire des minutes.
Un budget de latence aide les équipes à allouer un temps acceptable à chaque couche au lieu d’optimiser à l’aveugle.
Cacher au bon niveau
Le commerce headless utilise souvent plusieurs caches :
- cache CDN et pages
- cache d’API
- cache catalogue/recherche
- cache GraphQL ou objets
- cache de recommandations
La question clé est la fraîcheur.
Les descriptions produit peuvent rester en cache plus longtemps que les prix promotionnels. L’inventaire affiché pendant la navigation tolère une courte obsolescence, tandis que l’inventaire au checkout doit être vérifié auprès de la source faisant foi.
Une politique de cache correcte réduit la charge backend sans compromettre l’exactitude transactionnelle.
Scaler toute la chaîne de dépendances
Lambda peut scaler rapidement, mais d’autres dépendances pas nécessairement.
Contraintes potentielles :
- connexions à la base de données
- quotas des prestataires de paiement
- limites de la plateforme commerce
- débit de l’ERP
- API tierces
- systèmes d’inventaire
Cela signifie : l’auto-scaling du compute ne scale pas automatiquement tout le système.
Limites de concurrence, files d’attente, gestion des connexions à la base et rate limits des tiers relèvent tous de la planification de capacité.
Les équipes en production devraient aussi surveiller les latences p95 et p99, pas seulement les moyennes.
Métriques utiles à fort trafic :
- TTFB / LCP
- latence p95/p99 du BFF
- temps de complétion du checkout
- taux d’erreur des API
- taux de cache-hit
- profondeur et âge des files
- échecs de paiement
- retard du traitement des commandes
Ces métriques relient le comportement de l’infrastructure à l’expérience client.
Personnalisation IA sans ralentir le parcours commerce
L’architecture headless facilite l’isolation de la personnalisation par rapport aux fonctionnalités commerce centrales.
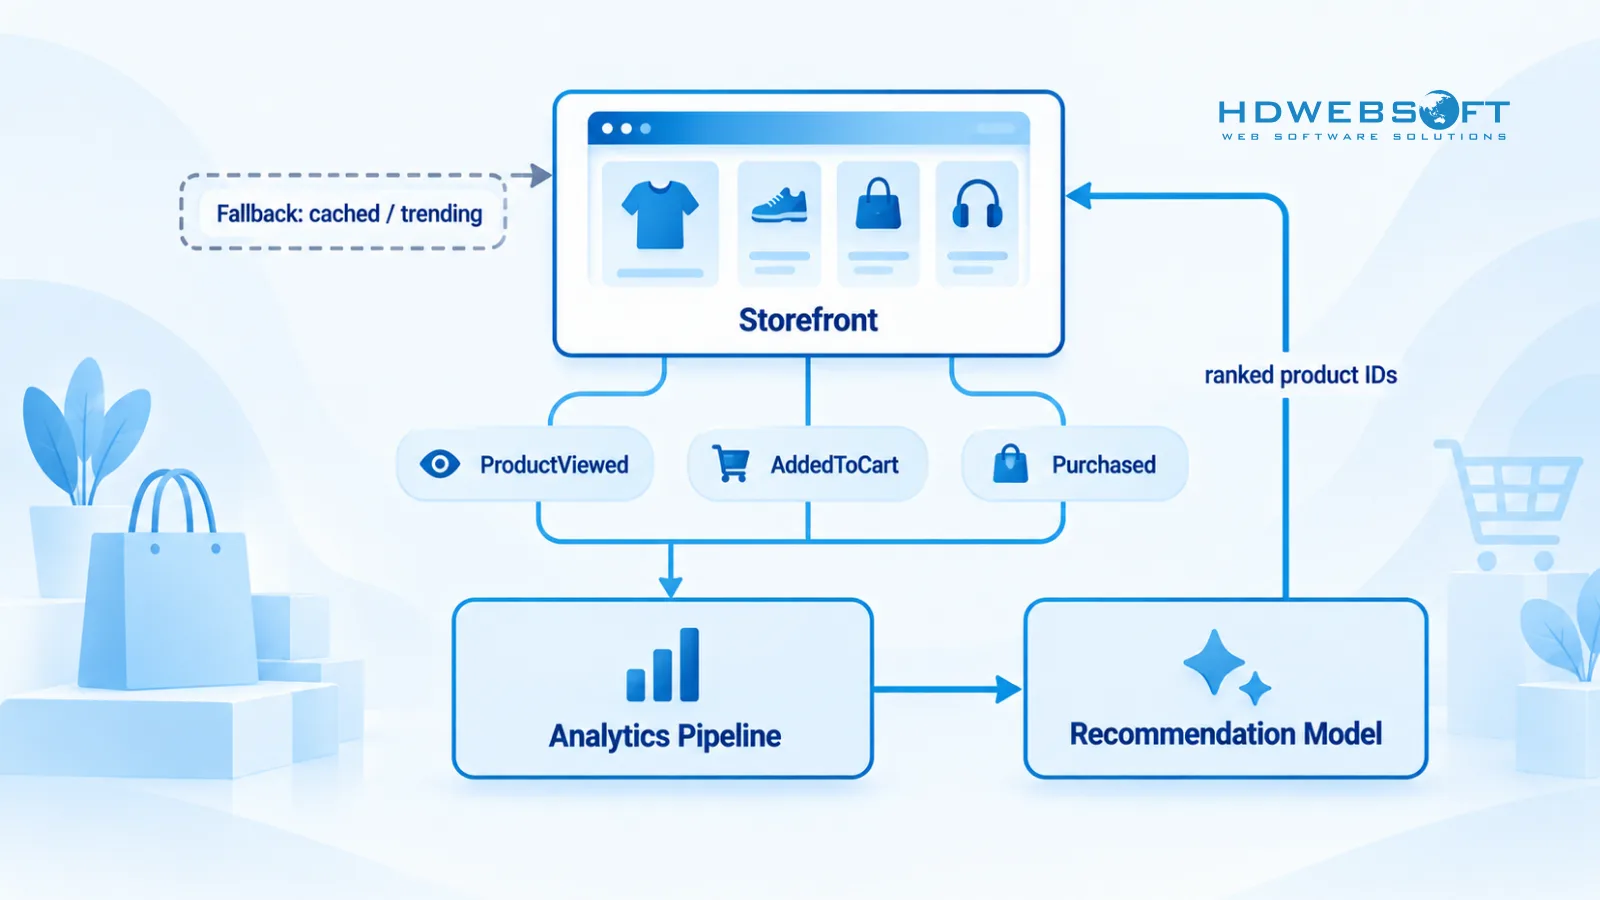
Plutôt que d’embarquer la logique de recommandation dans le storefront ou le moteur commerce, les entreprises peuvent exposer les recommandations comme un service indépendant.
Ce service peut utiliser :
- l’historique de navigation
- le comportement d’achat
- les données catalogue
- les préférences client
- les relations entre produits
- les signaux d’inventaire
La sortie peut simplement être des ID produit classés ou des offres renvoyés via une API.
Le storefront n’a pas besoin de savoir comment fonctionne le modèle sous-jacent.
Garder l’IA hors du chemin critique
Les recommandations IA doivent enrichir le parcours d’achat, pas déterminer s’il fonctionne.
Si une API de recommandation devient lente, les pages produit devraient généralement continuer à s’afficher.
L’architecture peut définir un budget de latence et un comportement de repli comme :
- recommandations en cache
- produits tendance
- meilleures ventes par catégorie
- alternatives basées sur des règles
De même, les pannes de modèle ou recommandations invalides ne doivent pas perturber le checkout.
Les événements commerce comme ProductViewed, AddedToCart, SearchPerformed et Purchased peuvent alimenter des pipelines d’analytics ou de modèles de façon asynchrone.
Cela crée une boucle de feedback sans placer l’entraînement IA ou l’inférence lourde directement dans les flux transactionnels.
Pour les entreprises construisant des storefronts sur mesure, des marketplaces, des systèmes de recommandation et des intégrations commerce, les services de développement de logiciels e-commerce de HDWEBSOFT couvrent à la fois les plateformes commerce centrales et les fonctionnalités augmentées par l’IA.
Quand le headless commerce mérite sa complexité
L’architecture headless crée de la flexibilité, mais la flexibilité introduit des services, API, déploiements, monitoring et responsabilités opérationnelles supplémentaires.
Elle doit donc résoudre une contrainte réelle.
| Dimension | Monolithe traditionnel | Headless | Composable |
|---|---|---|---|
| Indépendance frontend | Faible | Élevée | Élevée |
| Modularité backend | Faible | Variable | Élevée |
| Scalabilité indépendante | Limitée | Moyenne–Élevée | Élevée |
| Support multicanal | Faible | Élevée | Élevée |
| Complexité opérationnelle | Faible | Moyenne | Plus élevée |
| Exigence d’ingénierie | Faible | Plus élevée | La plus élevée |
Le headless convient plutôt aux entreprises qui ont :
- plusieurs storefronts ou canaux digitaux
- des exigences UX fortement personnalisées
- des intégrations complexes
- plusieurs régions ou marques
- des releases frontend fréquentes
- des contraintes substantielles de performance ou de scalabilité
Il peut être inutile lorsque :
- le catalogue est simple
- les intégrations sont limitées
- un storefront SaaS répond déjà aux besoins
- l’équipe d’ingénierie est petite
- les exigences de personnalisation sont faibles
La bonne question n’est pas : « Le headless est-il plus moderne ? » C’est : « Quelle contrainte métier ou architecturale le headless supprime-t-il ? »
Comment HDWEBSOFT aborde l’architecture e-commerce
Pour les systèmes e-commerce existants, la modernisation doit partir du goulot d’étranglement actuel plutôt que d’un stack prédéterminé.
Un processus pratique :
- Évaluation de l’architecture — Examiner les patterns de trafic, intégrations, goulots de performance, flux de données et points de défaillance.
- Définir les frontières — Déterminer quels workloads frontend, commerce, d’intégration ou d’arrière-plan nécessitent réellement une scalabilité indépendante.
- Valider la performance — Tester en charge les parcours clients critiques et les services en aval.
- Déployer progressivement — Séparer les composants là où cela crée une valeur mesurable au lieu de remplacer toute la plateforme en une étape.
L’étude de cas Salesforce Integration to an All-in-One Seller Workspace de HDWEBSOFT illustre le versant intégration de l’e-commerce d’entreprise. Le projet impliquait une synchronisation bidirectionnelle entre Lightspeed POS et Salesforce pour les données d’inventaire, de clients et de commandes.
Le cas ne représente pas exactement l’architecture de référence React–Node.js–AWS décrite ici. Sa pertinence tient au défi d’intégration plus large : les plateformes e-commerce d’entreprise opèrent rarement seules. Les données commerce doivent souvent circuler de façon fiable entre POS, CRM, inventaire, fulfillment, comptabilité et autres systèmes.
Conclusion
La scalabilité de l’e-commerce headless ne consiste pas à remplacer un monolithe par autant de technologies modernes que possible.
L’objectif est de créer des frontières claires pour que le storefront, les transactions commerce, les workloads asynchrones, les intégrations et les services optionnels comme l’IA puissent scaler et échouer selon leurs propres exigences.
React apporte la flexibilité frontend. Node.js et GraphQL créent une couche d’API storefront contrôlée. Les services serverless AWS supportent les workloads événementiels. Mais le succès en production dépend toujours du caching, des budgets de latence, de l’idempotence, du backpressure, de la cohérence de l’inventaire, de l’observabilité et de tests de charge réalistes.
Vous planifiez une plateforme e-commerce headless ou préparez une boutique existante à un trafic plus élevé ? Contactez HDWEBSOFT pour discuter de votre architecture et de vos exigences de scalabilité.
Questions fréquentes
Qu’est-ce qu’une architecture e-commerce headless ?
L’e-commerce headless sépare le storefront côté client du moteur commerce en backend. Le frontend communique avec le catalogue, les prix, le panier, le checkout, l’inventaire et d’autres services via des API.
Quel rôle jouent React et Node.js dans l’e-commerce headless ?
React peut alimenter le storefront, tandis que Node.js fournit une couche Backend-for-Frontend qui agrège les API commerce, gère l’authentification, contrôle les timeouts et expose des interfaces REST ou GraphQL optimisées pour le frontend.
L’e-commerce headless peut-il gérer des flash sales à fort trafic ?
Oui, mais l’architecture headless seule ne garantit pas la scalabilité. La performance dépend aussi du caching, de la capacité des API, des limites de la base de données, des prestataires de paiement, du contrôle des stocks, des files d’attente et des intégrations en aval.
Quelle est la différence entre headless et composable commerce ?
Le headless sépare principalement la présentation frontend du backend. Le composable commerce découpe en outre les capacités métier en composants modulaires pouvant être sélectionnés et faire évoluer indépendamment.
Pourquoi utiliser les services serverless AWS pour l’e-commerce ?
AWS Lambda, EventBridge et SQS prennent en charge les workloads événementiels, le traitement en arrière-plan, la mise en tampon du trafic et la scalabilité indépendante. Cependant, des conteneurs ou une infrastructure hybride peuvent mieux convenir à certaines charges soutenues.
Comment ajouter la personnalisation IA sans ralentir le storefront ?
Traiter les recommandations comme un service indépendant doté d’un budget de latence et d’un comportement de repli. Si le service IA est lent ou indisponible, le storefront peut renvoyer des recommandations en cache, populaires ou basées sur des règles.
