
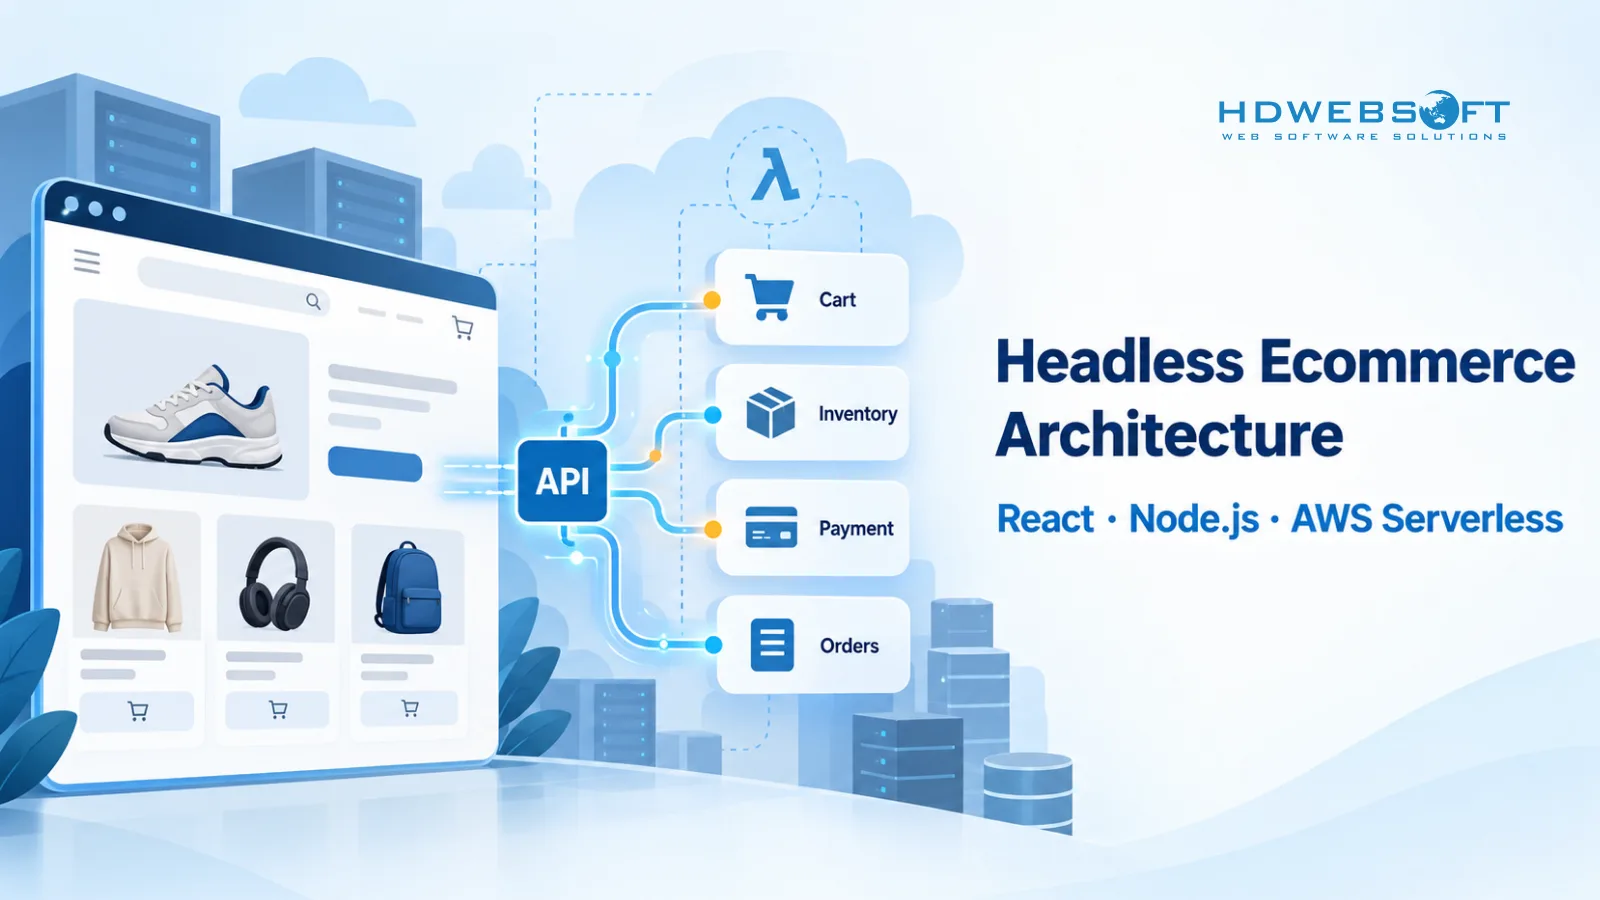
แพลตฟอร์ม ecommerce ทราฟฟิกสูงแทบไม่เคยล่มเพราะ frontend framework ตัวใดตัวหนึ่งช้าเกินไป ปัญหามักเกิดเมื่อ storefront rendering, catalog API, checkout, inventory, payment, personalization และการเชื่อมต่อ third-party ต่างแย่งกันใช้ทรัพยากรในช่วงทราฟฟิกพุ่งพรวดเดียวกัน
สถาปัตยกรรม headless ecommerce แยก storefront ฝั่งลูกค้าออกจาก commerce engine ผ่าน API ทำให้ชั้น presentation, บริการ backend, การเชื่อมต่อ และ workload สนับสนุนขยายตัวและพัฒนาได้อย่างอิสระมากขึ้น
สำหรับแบรนด์ที่เตรียมพร้อมสำหรับ flash sale, การขยายตัวระหว่างประเทศ, ประสบการณ์ omnichannel หรือเส้นทางการช้อปปิ้งที่ปรับเฉพาะบุคคลสูง การแยกส่วนนี้สามารถสร้างรากฐานทางเทคนิคที่แข็งแกร่งกว่าได้ อย่างไรก็ตาม สถาปัตยกรรม headless ไม่ได้รับประกันการโหลดหน้าต่ำกว่า 1 วินาทีหรือความพร้อมกันมหาศาลโดยอัตโนมัติ ประสิทธิภาพยังขึ้นกับ caching, การออกแบบ API, ความจุฐานข้อมูล, การประมวลผลแบบอะซิงโครนัส, observability และ load testing ที่สมจริง
สำหรับภาพรวมที่กว้างขึ้นของสถาปัตยกรรมและ UX ในรีเทลออนไลน์ ดูคู่มือบริการพัฒนา ecommerceของเรา
ประเด็นสำคัญ
- Headless ecommerce แยก storefront ออกจากความสามารถ commerce ใน backend ทำให้แต่ละชั้นขยายตัวและพัฒนาได้อย่างอิสระมากขึ้น
- Stack อ้างอิงทั่วไปผสม React, BFF Node.js/GraphQL, commerce engine และบริการ AWS serverless สำหรับ workload อะซิงโครนัส
- Storefront ที่เร็วขึ้นอยู่กับกลยุทธ์การ render, CDN caching, การออกแบบ API และประสิทธิภาพ downstream — ไม่ใช่แค่ React เพียงอย่างเดียว
- Checkout ควรคงเส้นทางซิงโครนัสให้เล็ก โดยย้ายงานหลังสั่งซื้อที่เหมาะสมไปสู่การประมวลผลแบบ event-driven
- Commerce ทราฟฟิกสูงต้องการ idempotency, queue, backpressure, ความสอดคล้องของ inventory และ capacity planning ที่เกินกว่า auto-scaling ธรรมดา
- AI personalization ควรมี latency budget และพฤติกรรม fallback เพื่อไม่ให้กลายเป็น dependency วิกฤตของ storefront
สถาปัตยกรรม Headless Ecommerce ทราฟฟิกสูงต้องแก้อะไร
ในรูปแบบง่ายที่สุด headless ecommerce แยกประสบการณ์ลูกค้าออกจากแพลตฟอร์ม commerce ใน backend
ในระบบ ecommerce แบบดั้งเดิม presentation, ตรรกะ catalog, checkout, plugin และ workflow backend อาจอยู่ในแอปพลิเคชันเดียวกัน วิธีนี้ใช้ได้ดีจนกว่าส่วนต่าง ๆ ของระบบต้องขยายตัว release หรือเปลี่ยนแปลงอย่างอิสระ
ด้วยสถาปัตยกรรม headless, React storefront, mobile app, อินเทอร์เฟซ marketplace หรือ frontend อื่นสื่อสารกับความสามารถ commerce ผ่าน API
สิ่งนี้สร้างขอบเขตที่ชัดเจนขึ้นระหว่าง:
- ประสบการณ์ลูกค้า
- catalog และ pricing
- cart และ checkout
- การประมวลผลคำสั่งซื้อ
- inventory
- search
- personalization
- การเชื่อมต่อ third-party
Headless กับ composable commerce เกี่ยวข้องกันแต่ไม่เหมือนกัน
Headless commerce แยกชั้น presentation ออกจาก backend เป็นหลัก Composable commerce ก้าวไปไกลกว่าโดยมองความสามารถอย่าง search, payment, promotions, content และ checkout เป็นองค์ประกอบแบบโมดูลที่แทนที่หรือพัฒนาแยกกันได้
MACH Principles อธิบายแนวทางที่กว้างกว่านี้รอบ modular, API, cloud-native delivery และ headless presentation
สำหรับแบรนด์ทราฟฟิกสูง สถาปัตยกรรมควรเริ่มจากข้อกำหนด workload แทนที่จะเป็น stack ที่ชื่นชอบ
แทนที่จะพูดว่า “ระบบต้องรองรับผู้ใช้พร้อมกัน 100,000 คน”
ทีมควรแปลเป้าหมายนั้นเป็นลักษณะที่วัดได้:
- request ต่อวินาที
- อัตราส่วน browsing ต่อ checkout
- API call ต่อเส้นทางลูกค้า
- cache-hit rate
- การกระจายทางภูมิศาสตร์
- ระยะเวลาพีค
- ขีดจำกัด API ของ downstream
คนหนึ่งแสนคนดูหน้า catalog ที่ cache ไว้ต่างจากคนหนึ่งแสนคนที่พยายามจอง inventory จำกัดและ submit payment พร้อมกันอย่างมาก
ขอบเขตความล้มเหลวก็สำคัญเช่นกัน
ถ้าบริการ recommendation ล่ม ลูกค้าควรยังเรียกดูสินค้าได้ไหม? ถ้าการ sync CRM ช้าลง checkout ควรหยุดไหม? ถ้า email provider ใช้ไม่ได้ คำสั่งซื้อควรล้มเหลวหรือไม่?
ระบบ headless ที่ออกแบบดีจะป้องกันไม่ให้ความสามารถที่เป็นทางเลือกดึง flow commerce ที่สำคัญล้มไปด้วย
สถาปัตยกรรมอ้างอิง: React, Node.js, GraphQL & AWS Serverless
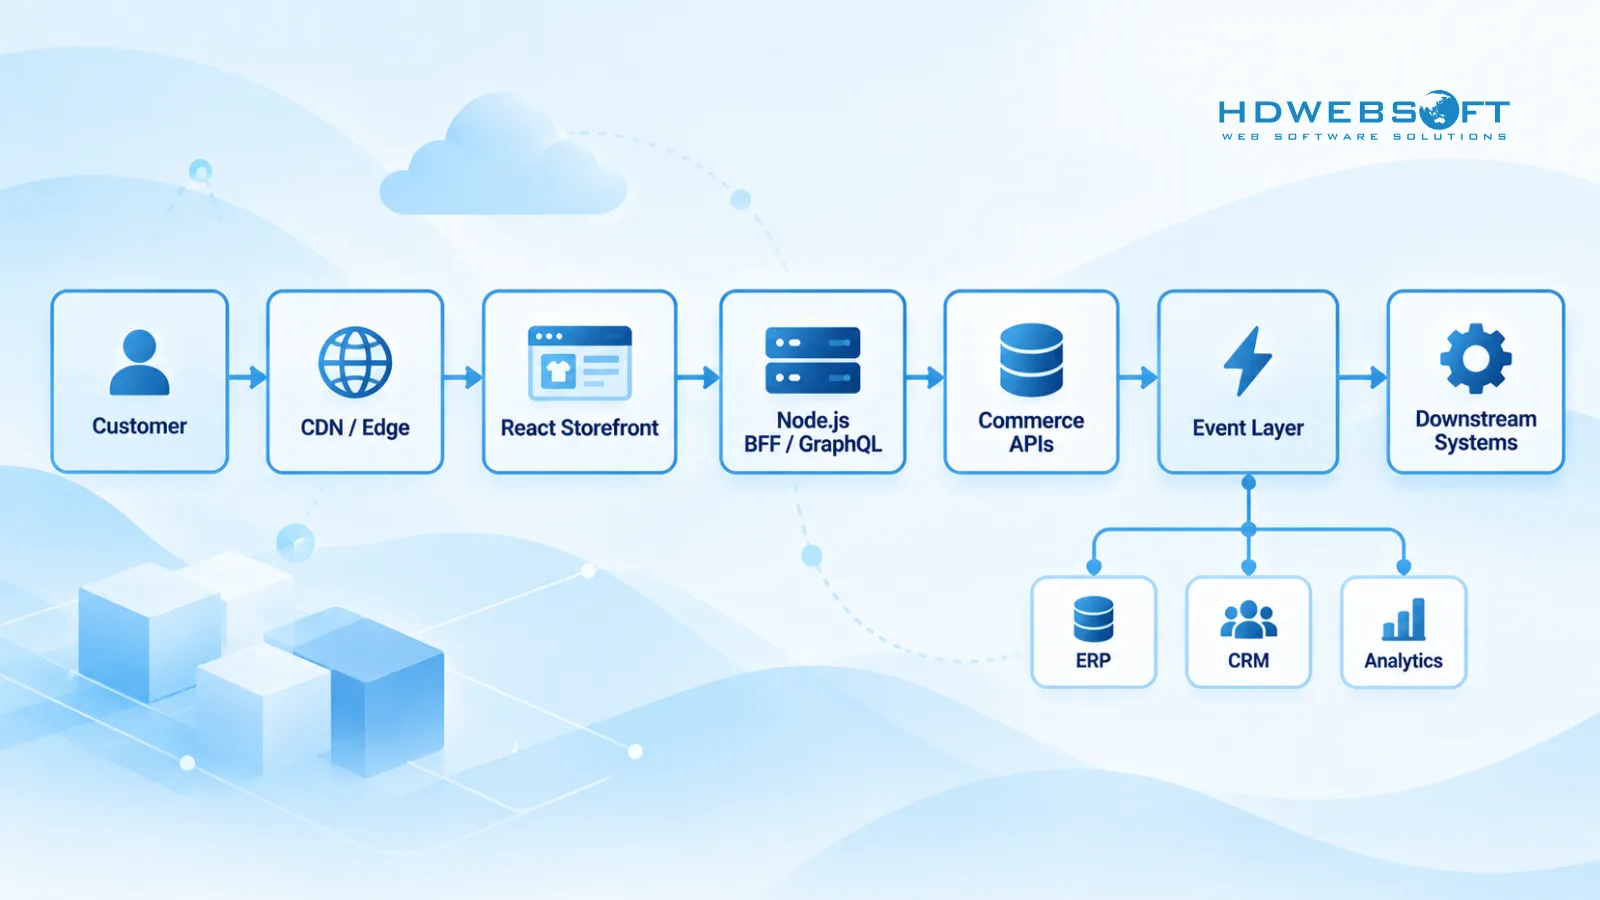
สถาปัตยกรรม headless ecommerce ที่ใช้ได้จริงสามารถแสดงเป็น: Customer → CDN/Edge → React Storefront → Node.js BFF/GraphQL → Commerce APIs → Event Layer → Downstream Systems
นี่คือสถาปัตยกรรมอ้างอิง ไม่ใช่ stack บังคับ GraphQL อาจถูกแทนด้วย REST, Lambda ด้วย container หรือ backend ที่พัฒนาเองด้วยแพลตฟอร์ม headless commerce เชิงพาณิชย์
สิ่งสำคัญคือการสร้างขอบเขตที่ชัดเจน
React Storefront และการส่งมอบผ่าน Edge
React ให้ความยืดหยุ่นในการสร้างประสบการณ์ product discovery, account, cart และ checkout แต่ React เองไม่ได้ทำให้ storefront เร็ว
หน้าประเภทต่าง ๆ มักต้องการกลยุทธ์ render ต่างกัน
หน้า product และ category อาจได้ประโยชน์จาก SSR, static หรือ incremental rendering และ CDN caching หน้า cart, account และ checkout พึ่งพาข้อมูลเฉพาะลูกค้ามากกว่า จึงมีศักยภาพ shared-cache ต่ำกว่า
Storefront ทราฟฟิกสูงควรพิจารณาด้วย:
- CDN และ edge caching
- รูปภาพและ static asset ที่ปรับให้เหมาะสม
- รูปแบบ stale-while-revalidate
- cache invalidation สำหรับ catalog และ pricing
- cache key ตาม locale, currency และภูมิภาค
Personalization เพิ่มความท้าทายอีกอย่าง ถ้าทุก response กลายเป็นเอกลักษณ์โดยสมบูรณ์ ประสิทธิภาพ cache จะลดลงอย่างมาก
สถาปัตยกรรมที่ดีกว่ามักคงส่วนใหญ่ของหน้าให้ cache ได้ ในขณะที่โหลดเฉพาะ component ที่ personalize เลือกไว้แยกต่างหาก
Node.js BFF และ GraphQL
Storefront ที่เชื่อมต่อโดยตรงกับบริการ backend หลายตัวสามารถสร้าง API waterfall ได้อย่างรวดเร็ว
หน้า product เดียวอาจต้องการข้อมูลจาก catalog, pricing, inventory, promotions, CMS, review และ recommendation
Backend-for-Frontend (BFF) สร้างขอบเขตเฉพาะสำหรับรวมบริการเหล่านั้น
Node.js BFF สามารถจัดการ:
- การรวม API
- การยืนยันตัวตนและ session
- การแปลง response
- timeout
- พฤติกรรม fallback
- การทำ error ให้เป็นมาตรฐาน
GraphQL สามารถให้ contract ที่ยืดหยุ่นระหว่าง storefront และ BFF แต่ต้องออกแบบอย่างระมัดระวัง
การออกแบบ resolver ที่ไม่ดีสามารถสร้าง N+1 request หรือเรียก backend ตามลำดับได้ ระบบ production จึงอาจต้องการ batching, ขีดจำกัดความซับซ้อนของ query, caching, persisted query และ timeout budget ที่เข้มงวด
BFF ควรป้องกันไม่ให้บริการที่เป็นทางเลือกควบคุม latency รวมของหน้าด้วย ถ้า recommendation API ช้า หน้า product มักควร render ต่อโดยไม่รออย่างไม่มีกำหนด
Commerce Engine และ Event Layer
Commerce engine ยังรับผิดชอบ business rule ที่เป็น authoritative เช่น:
- catalog
- pricing
- promotions
- cart
- checkout
- inventory
- คำสั่งซื้อ
Storefront สามารถปรับ presentation ให้เหมาะสมได้ แต่ rule ที่สำคัญต่อธุรกิจควรอยู่หลัง API ที่ควบคุมได้
สำหรับ workflow อะซิงโครนัส บริการ AWS สามารถให้ชั้น decoupling เพิ่มเติม
Flow ทั่วไปอาจเป็น: OrderCreated → EventBridge / SQS → Lambda → ERP / CRM / Fulfillment / Analytics
EventBridge สามารถ route business event เดียวไปยัง consumer หลายตัว ในขณะที่ SQS สามารถกักตุน workload เมื่อ consumer ไม่สามารถประมวลผล event ในอัตราเดียวกับที่ผลิตออกมาได้
สถาปัตยกรรมนี้สอดคล้องกับหลักการโครงสร้างพื้นฐาน cloud-nativeที่กว้างกว่า โดยอนุญาตให้ component ขยายตัวตาม workload ของตนเอง
องค์กรที่สร้างระบบบนโครงสร้างพื้นฐาน Amazon อย่างหนักยังสามารถสำรวจบริการพัฒนา AWSของ HDWEBSOFT สำหรับสถาปัตยกรรม cloud, การพัฒนา serverless, migration และ DevOps
Serverless ไม่ได้เป็นตัวเลือกที่ถูกต้องสำหรับทุก component โดยอัตโนมัติ Workload throughput สูงต่อเนื่องหรือบริการที่มีข้อกำหนดการเชื่อมต่อซับซ้อนอาจยังได้ประโยชน์จาก container หรือสถาปัตยกรรมไฮบริด
Checkout แบบเรียลไทม์และการประมวลผลคำสั่งซื้อในระดับใหญ่
ทราฟฟิกสูงสร้างความเสี่ยงมากที่สุดตรงจุดที่ความเร็วและความถูกต้องของธุรกรรมมาบรรจบกัน
หน้า browsing มักทนต่อ caching หรือข้อมูลเก่าเล็กน้อยได้ แต่ checkout ทนต่อการเรียกเก็บซ้ำ คำสั่งซื้อซ้ำ หรือการขายเกิน inventory จำกัดไม่ได้
เส้นทาง checkout ซิงโครนัสจึงควรคงความโฟกัส
Critical path ทั่วไปอาจรวม: validate cart → ยืนยัน pricing ปัจจุบัน → จอง inventory → authorize payment → สร้างคำสั่งซื้อ
เมื่อคำสั่งซื้อที่ durable มีอยู่แล้ว workflow อื่นมากมายสามารถเกิดขึ้นแบบอะซิงโครนัส:
- email ยืนยัน
- การ sync CRM
- การอัปเดต ERP
- analytics
- การอัปเดต loyalty
- marketing event
- feedback สำหรับ recommendation
สิ่งนี้ป้องกันไม่ให้การเชื่อมต่อที่ไม่สำคัญยืดเวลา checkout ของลูกค้า
คำแนะนำ AWS สำหรับการเชื่อมต่อ microservice กับบริการ serverless ให้รูปแบบสำหรับการสื่อสารอะซิงโครนัส, event routing และการประมวลผลแบบ queue
Idempotency และความปลอดภัยในการ Retry
Retry เป็นเรื่องปกติในระบบ ecommerce แบบกระจาย ลูกค้าอาจคลิก checkout สองครั้ง Network timeout อาจทำให้ browser retry Payment provider อาจส่ง webhook ซ้ำ Consumer ของ queue อาจรับ event เดียวกันมากกว่าหนึ่งครั้ง แอปพลิเคชันจึงควรออกแบบเพื่อให้การทำ request เดิมซ้ำไม่ทำการกระทำทางธุรกิจซ้ำ Idempotency key สามารถเชื่อมการ submit checkout ที่เหมือนกันหลายครั้งเข้ากับธุรกรรมเดิมหนึ่งรายการ แทนที่จะสร้างหลายคำสั่งซื้อ
หลักการเดียวกันใช้กับ background worker ด้วย Retry ควรถูกควบคุมเช่นกัน ความล้มเหลวชั่วคราวอาจสมเหตุสมผลในการ retry พร้อม backoff แต่ข้อมูลที่ไม่ถูกต้องไม่ควรถูก retry อย่างไม่มีที่สิ้นสุด Event ที่ล้มเหลวในที่สุดสามารถย้ายไปยัง dead-letter queue เพื่อสอบสวนได้
Backpressure และขีดจำกัด Downstream
การ auto-scale ทุกบริการอย่างรุนแรงไม่รับประกันความเสถียร ลองจินตนาการ flash sale ที่สร้าง order event หลายพันรายการ ในขณะที่การเชื่อมต่อ ERP ประมวลผล request ต่อวินาทีได้จำกัด ถ้าทุกคำสั่งซื้อกระตุ้นการเรียก ERP ทันที ระบบ downstream จะกลายเป็นคอขวด Queue ดูดซับแรงพุ่งและให้ consumer ประมวลผลงานในอัตราที่ยั่งยืน นี่คือ backpressure: การปกป้องระบบที่ช้ากว่า แทนที่จะให้ความสามารถในการขยายตัวฝั่ง upstream ถาโถมเข้าใส่
ความสอดคล้องของ Inventory
Inventory เป็นอีกความท้าทายของทราฟฟิกสูง ถ้าเหลือสินค้าหนึ่งชิ้นและลูกค้า 20 คนพยายาม checkout พร้อมกัน แต่ละ request ต้องไม่อ่าน “เหลือ 1” อย่างอิสระแล้วซื้อสำเร็จพร้อมกันทั้งหมด ระบบ inventory ที่เป็น authoritative อาจต้องการ atomic reservation, conditional update หรือ optimistic concurrency control Reservation ยังสามารถหมดอายุเมื่อ payment ล้มเหลวหรือ checkout ถูกทิ้งกลางคัน โมเดลความสอดคล้องที่แน่นอนขึ้นกับธุรกิจ สินค้า limited-edition ต้องการการควบคุมเข้มงวดกว่า inventory ที่เติมได้ง่าย
วิศวกรรมประสิทธิภาพและความสามารถในการขยายตัวสำหรับ Flash Sale
สถาปัตยกรรม headless สร้างขอบเขตการขยายตัวที่มีประโยชน์ แต่ขอบเขตเหล่านั้นยังต้องได้รับการออกแบบและทดสอบ
ยอด demand ของรีเทลขนาดใหญ่ทำให้สิ่งนี้สำคัญเป็นพิเศษ
Adobe รายงานว่าผู้บริโภคสหรัฐใช้จ่ายออนไลน์ 257.8 พันล้านดอลลาร์ในช่วงฤดูกาลวันหยุด 2025 โดยมี 25 วันที่การใช้จ่ายออนไลน์เกิน 4 พันล้านดอลลาร์ เทียบกับ 18 วันในปีก่อน การวิเคราะห์ครอบคลุมการเข้าชมเว็บไซต์รีเทลสหรัฐมากกว่าหนึ่งล้านล้านครั้ง ดูรายงาน ecommerce ฤดูกาลวันหยุด 2026 ของ Adobe Analytics
นัยไม่ใช่ว่าทุกแพลตฟอร์ม ecommerce ต้องการความจุเท่ากัน แต่คือยอดทราฟฟิกอาจเกิดซ้ำตลอดแคมเปญหรือฤดูกาลช้อปปิ้ง แทนที่จะเป็นเหตุการณ์เดียวที่โดดเดี่ยว
สร้าง Latency Budget
ประสิทธิภาพควรถูกวัดตลอด request chain ทั้งหมด: CDN → React rendering → BFF → commerce APIs → personalization ที่เป็นทางเลือก
การปรับ frontend ไม่สามารถชดเชย backend API waterfall ที่เพิ่มเวลาหลายวินาทีได้
เส้นทางลูกค้าที่ต่างกันยังต้องการความคาดหวังประสิทธิภาพต่างกัน
การเรียกดู product อ่อนไหวต่อ latency มากและเป็นมิตรกับ cache Checkout อาจใช้เวลานานกว่าเพราะต้องยืนยัน payment และ inventory การประมวลผลคำสั่งซื้อเบื้องหลังมักทนต่อหลักวินาทีหรือนาทีได้
Latency budget ช่วยให้ทีมจัดสรรเวลาที่ยอมรับได้ให้แต่ละชั้น แทนที่จะปรับแต่งอย่างไม่มีทิศทาง
Cache ในชั้นที่ถูกต้อง
Commerce แบบ headless มักใช้ cache หลายชั้น:
- CDN และ page cache
- API cache
- catalog/search cache
- GraphQL หรือ object cache
- recommendation cache
คำถามสำคัญคือความสดของข้อมูล
คำอธิบายสินค้าสามารถ cache นานกว่า promotional pricing Inventory ที่แสดงระหว่าง browsing ทนต่อความเก่าสั้นได้ ในขณะที่ inventory ตอน checkout ต้องตรวจสอบกับแหล่ง authoritative
นโยบาย cache ที่ถูกต้องลดภาระ backend โดยไม่ประนีประนอมความถูกต้องของธุรกรรม
ขยาย Dependency Chain ทั้งหมด
Lambda อาจ scale ได้เร็ว แต่ dependency อื่นอาจไม่
ข้อจำกัดที่เป็นไปได้:
- database connection
- quota ของ payment provider
- ขีดจำกัดแพลตฟอร์ม commerce
- throughput ของ ERP
- API ของ third-party
- ระบบ inventory
หมายความว่า: auto-scaling ของ compute ไม่ได้ขยายทั้งระบบโดยอัตโนมัติ
Concurrency limit, queueing, การจัดการ database connection และ rate limit ของ third-party ล้วนอยู่ใน capacity planning
ทีม production ควรเฝ้าดู latency p95 และ p99 ด้วย ไม่ใช่แค่ค่าเฉลี่ย
Metric ทราฟฟิกสูงที่มีประโยชน์:
- TTFB / LCP
- latency p95/p99 ของ BFF
- เวลาทำ checkout สำเร็จ
- อัตรา error ของ API
- cache-hit ratio
- queue depth และ queue age
- payment ล้มเหลว
- ความล่าช้าในการประมวลผลคำสั่งซื้อ
Metric เหล่านี้เชื่อมพฤติกรรมโครงสร้างพื้นฐานเข้ากับประสบการณ์ลูกค้า
AI Personalization โดยไม่ทำให้เส้นทาง Commerce ช้าลง
สถาปัตยกรรม headless ทำให้แยก personalization ออกจากฟังก์ชัน commerce หลักได้ง่ายขึ้น
แทนที่จะฝังตรรกะ recommendation ไว้ใน storefront หรือ commerce engine ธุรกิจสามารถ expose recommendation เป็นบริการอิสระได้
บริการนั้นอาจใช้:
- ประวัติการ browsing
- พฤติกรรมการซื้อ
- ข้อมูล catalog
- ความชอบของลูกค้า
- ความสัมพันธ์ของสินค้า
- สัญญาณ inventory
Output อาจเป็นเพียง product ID หรือ offer ที่จัดอันดับแล้วส่งคืนผ่าน API
Storefront ไม่จำเป็นต้องรู้ว่าโมเดลข้างใต้ทำงานอย่างไร
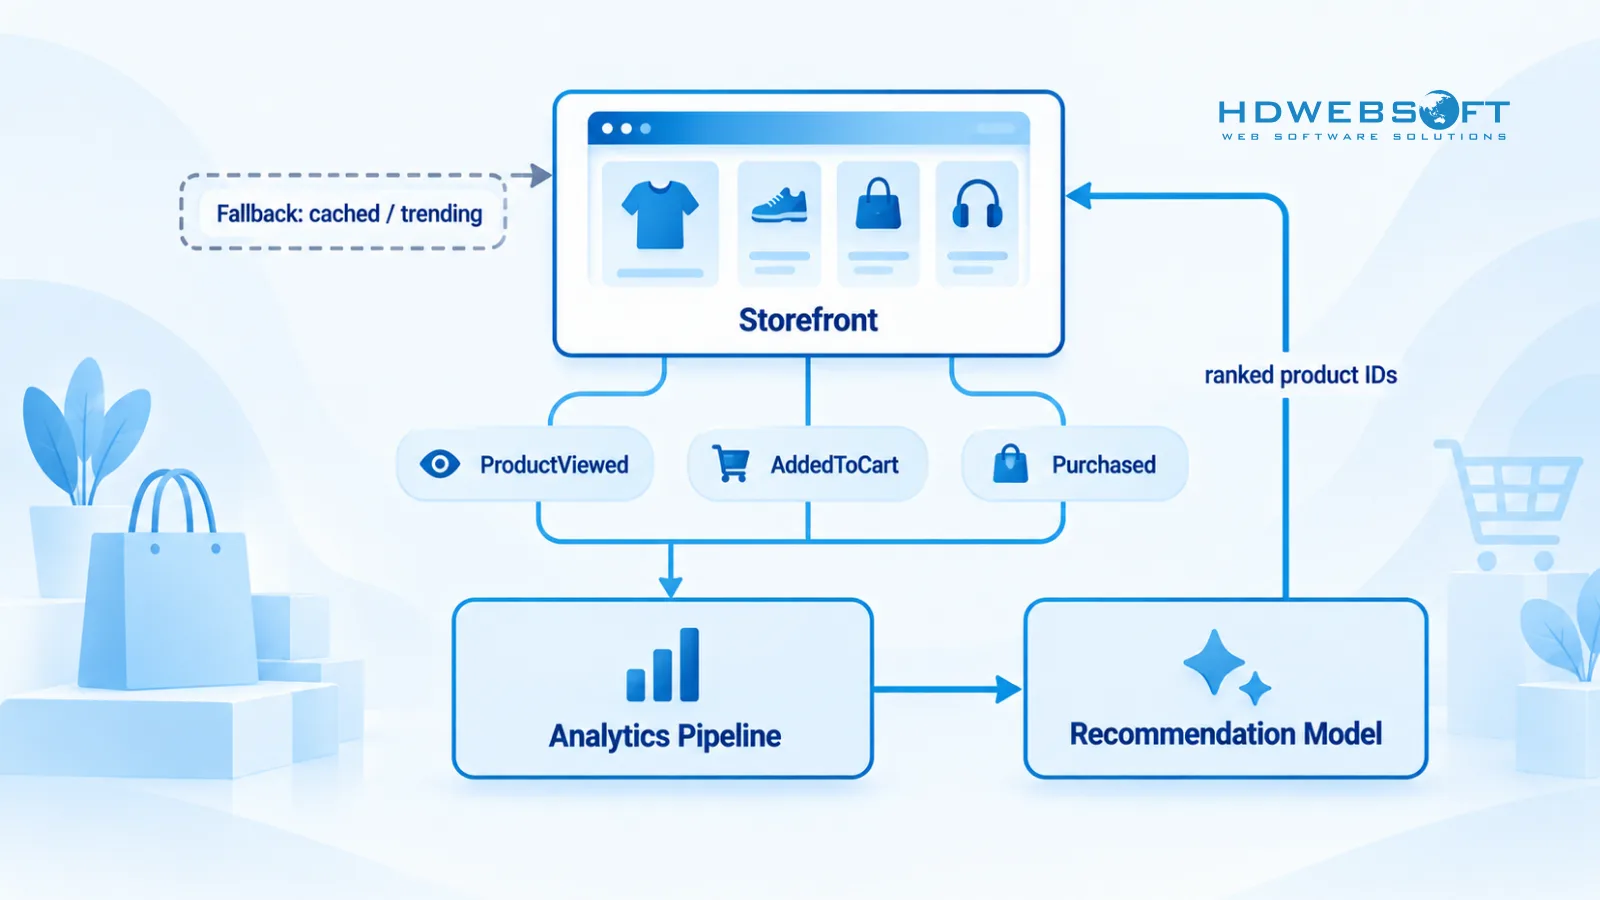
เก็บ AI ไว้นอก Critical Path
Recommendation AI ควรเสริมเส้นทางการช้อปปิ้ง ไม่ใช่ควบคุมว่าเส้นทางนั้นทำงานหรือไม่
ถ้า recommendation API ช้าลง หน้า product มักควร render ต่อ
สถาปัตยกรรมสามารถกำหนด latency budget และพฤติกรรม fallback เช่น:
- recommendation ที่ cache ไว้
- สินค้า trending
- best seller ตาม category
- ทางเลือกตามกฎ
ในทำนองเดียวกัน ความล้มเหลวของโมเดลหรือ recommendation ที่ไม่ถูกต้องไม่ควรรบกวน checkout
Commerce event เช่น ProductViewed, AddedToCart, SearchPerformed และ Purchased สามารถป้อนเข้า analytics หรือ pipeline โมเดลแบบอะซิงโครนัสได้
สิ่งนี้สร้าง feedback loop โดยไม่นำการเทรน AI หรือ inference หนักไปไว้ใน flow ธุรกรรมโดยตรง
สำหรับบริษัทที่สร้าง storefront เฉพาะทาง, marketplace, ระบบ recommendation และการเชื่อมต่อ commerce บริการพัฒนาซอฟต์แวร์ e-commerceของ HDWEBSOFT ครอบคลุมทั้งแพลตฟอร์ม commerce หลักและฟังก์ชันที่ขับเคลื่อนด้วย AI
เมื่อไหร่ Headless Commerce คุ้มกับความซับซ้อน
สถาปัตยกรรม headless สร้างความยืดหยุ่น แต่ความยืดหยุ่นเพิ่มบริการ, API, deployment, monitoring และความรับผิดชอบด้านการดำเนินงานเพิ่มเติม
ดังนั้นมันควรแก้ข้อจำกัดที่แท้จริง
| มิติ | Monolith ดั้งเดิม | Headless | Composable |
|---|---|---|---|
| ความอิสระของ frontend | ต่ำ | สูง | สูง |
| ความเป็นโมดูลของ backend | ต่ำ | แตกต่างกัน | สูง |
| การขยายตัวอิสระ | จำกัด | กลาง–สูง | สูง |
| รองรับหลายช่องทาง | ต่ำ | สูง | สูง |
| ความซับซ้อนการดำเนินงาน | ต่ำ | กลาง | สูงกว่า |
| ความต้องการด้านวิศวกรรม | ต่ำ | สูงกว่า | สูงสุด |
Headless มักเหมาะกับธุรกิจที่มี:
- หลาย storefront หรือช่องทางดิจิทัล
- ข้อกำหนด UX ที่ปรับแต่งสูง
- การเชื่อมต่อที่ซับซ้อน
- หลายภูมิภาคหรือแบรนด์
- release frontend บ่อย
- ข้อจำกัดด้านประสิทธิภาพหรือการขยายตัวอย่างมีนัยสำคัญ
อาจไม่จำเป็นเมื่อ:
- catalog เรียบง่าย
- การเชื่อมต่อจำกัด
- storefront SaaS ตอบโจทย์อยู่แล้ว
- ทีมวิศวกรรมเล็ก
- ข้อกำหนดการปรับแต่งต่ำ
คำถามที่ถูกไม่ใช่ “headless ทันสมัยกว่าไหม?” แต่คือ “headless ขจัดข้อจำกัดทางธุรกิจหรือสถาปัตยกรรมข้อใดออกไป?”
HDWEBSOFT เข้าหาสถาปัตยกรรม Ecommerce อย่างไร
สำหรับระบบ ecommerce ที่มีอยู่ การปรับปรุงให้ทันสมัยควรเริ่มจากคอขวดปัจจุบัน ไม่ใช่ stack ที่ตั้งไว้ล่วงหน้า
กระบวนการที่ใช้ได้จริงอาจรวม:
- ประเมินสถาปัตยกรรม — ทบทวนรูปแบบทราฟฟิก, การเชื่อมต่อ, คอขวดประสิทธิภาพ, การไหลของข้อมูล และจุดเสี่ยงล้มเหลว
- กำหนดขอบเขต — ตัดสินว่า workload frontend, commerce, การเชื่อมต่อ หรือเบื้องหลังใดต้องการการขยายตัวอิสระจริง ๆ
- ตรวจสอบประสิทธิภาพ — load-test เส้นทางลูกค้าที่สำคัญและบริการ downstream
- Rollout แบบค่อยเป็นค่อยไป — แยก component ในจุดที่สร้างคุณค่าที่วัดได้ แทนที่จะแทนที่ทั้งแพลตฟอร์มในขั้นตอนเดียว
Case study Salesforce Integration to an All-in-One Seller Workspace ของ HDWEBSOFT แสดงด้านการเชื่อมต่อของ enterprise ecommerce โครงการนี้เกี่ยวข้องกับการ sync สองทิศทางระหว่าง Lightspeed POS และ Salesforce สำหรับข้อมูล inventory, ลูกค้า และคำสั่งซื้อ
เคสนี้ไม่ได้เป็นตัวแทนของสถาปัตยกรรมอ้างอิง React–Node.js–AWS ที่อธิบายไว้ ความเกี่ยวข้องอยู่ที่ความท้าทายการเชื่อมต่อที่กว้างกว่า: แพลตฟอร์ม ecommerce ระดับองค์กรแทบไม่เคยทำงานเดี่ยว ข้อมูล commerce มักต้องเคลื่อนย้ายอย่างน่าเชื่อถือระหว่าง POS, CRM, inventory, fulfillment, การบัญชี และระบบอื่น ๆ
สรุป
ความสามารถในการขยายตัวของ headless ecommerce ไม่ใช่การแทนที่ monolith หนึ่งตัวด้วยเทคโนโลยีทันสมัยให้มากที่สุดเท่าที่จะเป็นไปได้
เป้าหมายคือสร้างขอบเขตที่ชัดเจนเพื่อให้ storefront, ธุรกรรม commerce, workload อะซิงโครนัส, การเชื่อมต่อ และบริการที่เป็นทางเลือกอย่าง AI สามารถขยายตัวและล้มเหลวตามข้อกำหนดของตนเอง
React ให้ความยืดหยุ่นของ frontend Node.js และ GraphQL สร้างชั้น API ของ storefront ที่ควบคุมได้ บริการ AWS serverless รองรับ workload แบบ event-driven แต่ความสำเร็จใน production ยังขึ้นกับ caching, latency budget, idempotency, backpressure, ความสอดคล้องของ inventory, observability และ load testing ที่สมจริง
กำลังวางแผนแพลตฟอร์ม headless ecommerce หรือเตรียมร้านค้าที่มีอยู่สำหรับทราฟฟิกที่สูงขึ้น? ติดต่อ HDWEBSOFT เพื่อพูดคุยเกี่ยวกับสถาปัตยกรรมและข้อกำหนดการขยายตัวของคุณ
คำถามที่พบบ่อย
สถาปัตยกรรม headless ecommerce คืออะไร?
Headless ecommerce แยก storefront ฝั่งลูกค้าออกจาก commerce engine ใน backend โดย frontend สื่อสารกับ catalog, pricing, cart, checkout, inventory และบริการอื่น ๆ ผ่าน API
React และ Node.js มีบทบาทอย่างไรใน headless ecommerce?
React สามารถขับเคลื่อน storefront ในขณะที่ Node.js ให้ชั้น Backend-for-Frontend ที่รวม commerce APIs จัดการการยืนยันตัวตน ควบคุม timeout และ expose REST หรือ GraphQL ที่ปรับให้เหมาะกับ frontend
Headless ecommerce รองรับ flash sale ทราฟฟิกสูงได้หรือไม่?
ได้ แต่สถาปัตยกรรม headless เพียงอย่างเดียวไม่รับประกันความสามารถในการขยายตัว ประสิทธิภาพยังขึ้นกับ caching, ความจุ API, ขีดจำกัดฐานข้อมูล, payment provider, การควบคุม inventory, queue และการเชื่อมต่อ downstream
Headless กับ composable commerce ต่างกันอย่างไร?
Headless แยกชั้น presentation ของ frontend ออกจาก backend เป็นหลัก Composable commerce ยังแบ่งความสามารถทางธุรกิจออกเป็นองค์ประกอบแบบโมดูลที่เลือกและพัฒนาแยกกันได้อีกด้วย
ทำไมต้องใช้บริการ AWS serverless สำหรับ ecommerce?
AWS Lambda, EventBridge และ SQS รองรับ workload แบบ event-driven, การประมวลผลเบื้องหลัง, การกักตุนทราฟฟิก และการขยายตัวอิสระ อย่างไรก็ตาม container หรือโครงสร้างพื้นฐานแบบไฮบริดอาจเหมาะกว่าสำหรับบาง workload ที่ทำงานต่อเนื่อง
จะเพิ่ม AI personalization โดยไม่ทำให้ storefront ช้าลงได้อย่างไร?
ปฏิบัติต่อ recommendation เป็นบริการอิสระที่มี latency budget และพฤติกรรม fallback หากบริการ AI ช้าหรือใช้ไม่ได้ storefront สามารถส่งคืน recommendation ที่ cache ไว้ ยอดนิยม หรือตามกฎแทนได้
