
Las plataformas de ecommerce de alto tráfico rara vez fallan porque un framework frontend sea demasiado lento. Los problemas suelen aparecer cuando el renderizado del storefront, las APIs de catálogo, el checkout, el inventario, el pago, la personalización y las integraciones de terceros compiten por capacidad durante el mismo pico de tráfico.
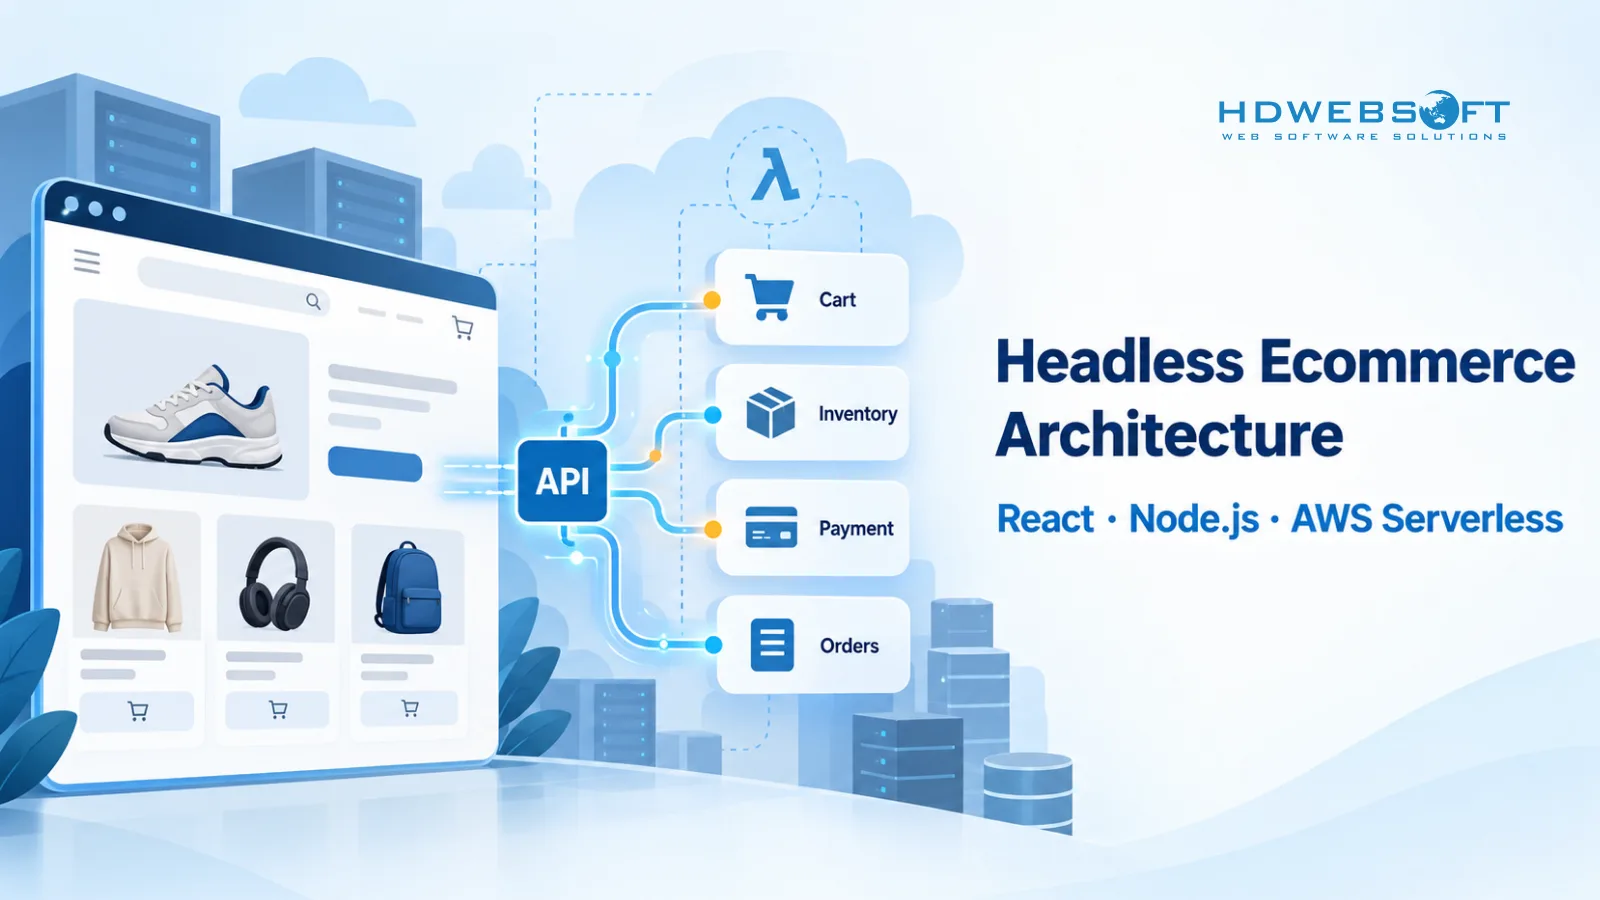
Una arquitectura ecommerce headless separa el storefront orientado al cliente del motor de comercio mediante APIs. Esto permite que la capa de presentación, los servicios backend, las integraciones y las cargas de trabajo de soporte escalen y evolucionen con mayor independencia.
Para marcas que se preparan para flash sales, expansión internacional, experiencias omnicanal o recorridos de compra altamente personalizados, esa separación puede crear una base técnica más sólida. Sin embargo, la arquitectura headless no garantiza automáticamente cargas de menos de un segundo ni concurrencia masiva. El rendimiento sigue dependiendo del caching, el diseño de APIs, la capacidad de la base de datos, el procesamiento asíncrono, la observabilidad y pruebas de carga realistas.
Para una visión más amplia de arquitectura y UX en el retail online, consulta nuestra guía de servicios de desarrollo ecommerce.
Puntos clave
- El ecommerce headless separa el storefront de las capacidades de comercio del backend, permitiendo que cada capa escale y evolucione con mayor independencia.
- Un stack de referencia común combina React, un BFF Node.js/GraphQL, un motor de comercio y servicios AWS serverless para cargas de trabajo asíncronas.
- Los storefronts rápidos dependen de la estrategia de renderizado, el caching CDN, el diseño de APIs y el rendimiento posterior, no solo de React.
- El checkout debe mantener su ruta síncrona pequeña mientras las tareas post-pedido adecuadas pasan a procesamiento orientado a eventos.
- El comercio de alto tráfico requiere idempotencia, colas, backpressure, consistencia de inventario y planificación de capacidad más allá del simple auto-escalado.
- La personalización IA debe tener un presupuesto de latencia y un comportamiento de respaldo para no convertirse nunca en una dependencia crítica del storefront.
Qué debe resolver una arquitectura ecommerce headless de alto tráfico
En su forma más simple, el ecommerce headless separa la experiencia del cliente de la plataforma de comercio backend.
En un sistema ecommerce tradicional, la presentación, la lógica de catálogo, el checkout, los plugins y los flujos de trabajo backend pueden vivir dentro de la misma aplicación. Esto puede funcionar bien hasta que distintas partes del sistema necesiten escalar, publicar o cambiar de forma independiente.
Con la arquitectura headless, un storefront React, una app móvil, una interfaz de marketplace u otro frontend se comunica con las capacidades de comercio mediante APIs.
Esto crea límites más claros entre:
- experiencia del cliente
- catálogo y precios
- carrito y checkout
- procesamiento de pedidos
- inventario
- búsqueda
- personalización
- integraciones de terceros
Headless y composable commerce están relacionados, pero no son idénticos.
El headless commerce separa principalmente la capa de presentación del backend. El composable commerce va más allá al tratar capacidades como búsqueda, pago, promociones, contenido y checkout como componentes modulares que pueden reemplazarse o evolucionar de forma independiente.
Los principios MACH describen este enfoque más amplio en torno a modularidad, APIs, entrega cloud-native y presentación headless.
Para marcas de alto tráfico, la arquitectura debe comenzar con los requisitos de carga en lugar de un stack tecnológico preferido.
En lugar de decir: “El sistema debe soportar 100.000 usuarios simultáneos.”
Los equipos deberían traducir ese objetivo a características medibles:
- peticiones por segundo
- ratio navegación-checkout
- llamadas API por recorrido del cliente
- tasa de cache-hit
- distribución geográfica
- duración del pico
- límites de las APIs posteriores
Cien mil personas viendo páginas de catálogo en caché es muy diferente de cien mil clientes intentando reservar inventario limitado y enviar pagos simultáneamente.
Los límites de fallo también importan.
Si el servicio de recomendaciones falla, ¿deberían los clientes seguir pudiendo navegar por los productos? Si la sincronización CRM se ralentiza, ¿debería detenerse el checkout? Si el proveedor de email deja de estar disponible, ¿debería fallar un pedido?
Un sistema headless bien diseñado evita que las capacidades opcionales derriben los flujos de comercio críticos.
Arquitectura de referencia: React, Node.js, GraphQL & AWS Serverless
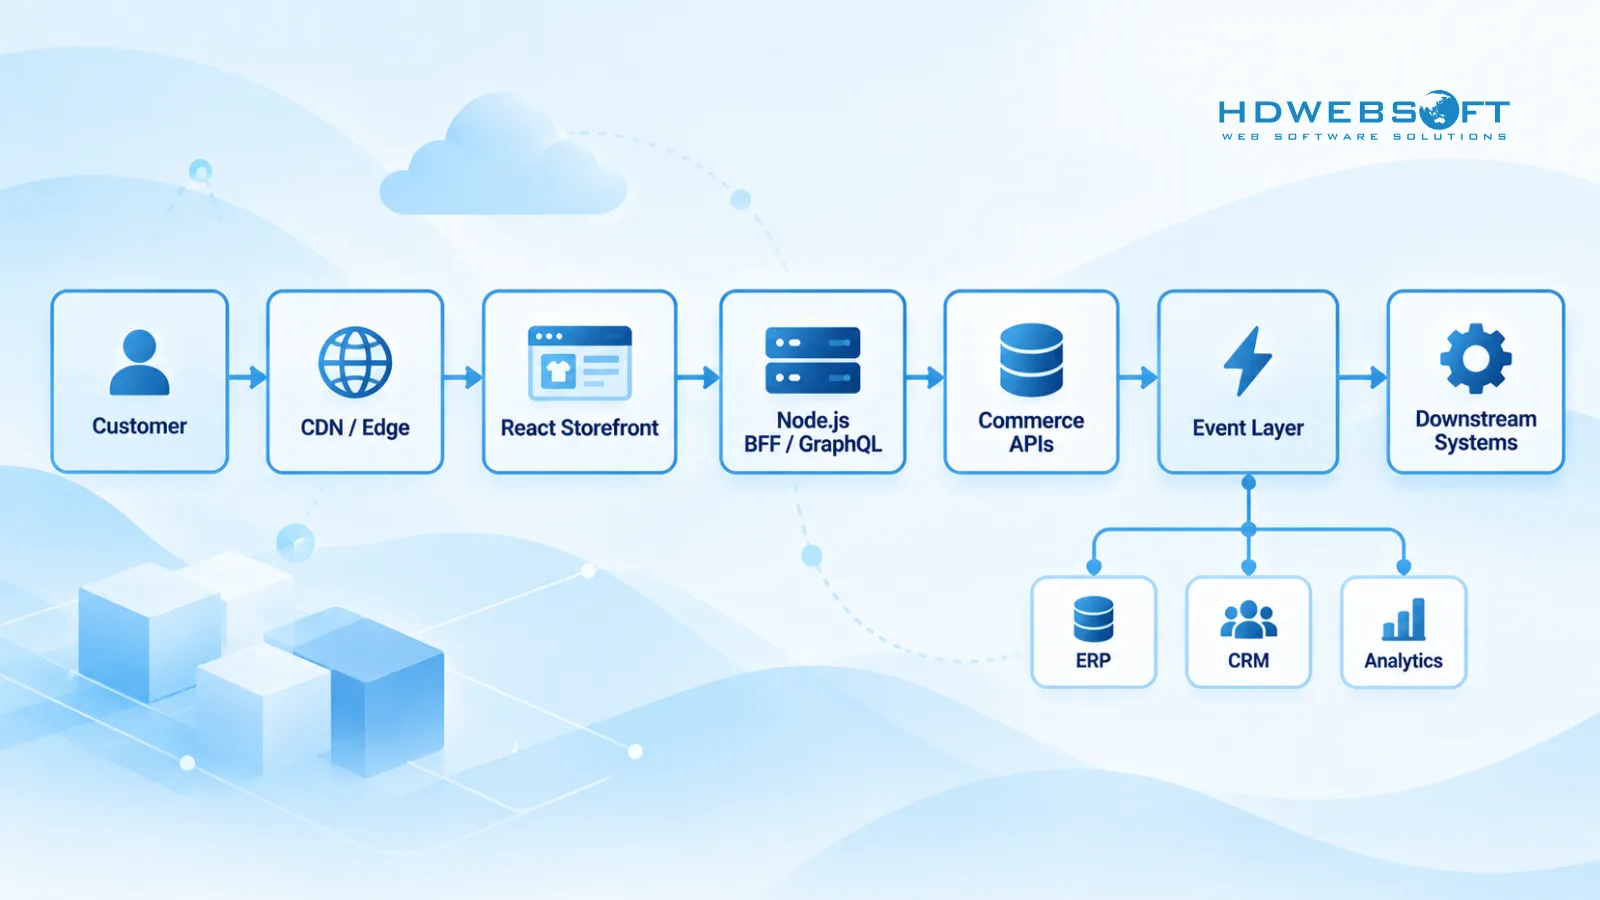
Una arquitectura ecommerce headless práctica puede representarse así: Customer → CDN/Edge → React Storefront → Node.js BFF/GraphQL → Commerce APIs → Event Layer → Downstream Systems
Es una arquitectura de referencia, no un stack obligatorio. GraphQL puede sustituirse por REST, Lambda por contenedores, o un backend propio por una plataforma headless commerce comercial.
Lo importante es establecer límites claros.
Storefront React y entrega Edge
React ofrece flexibilidad para construir experiencias de descubrimiento de producto, cuenta, carrito y checkout, pero React por sí solo no hace rápido un storefront.
Diferentes páginas suelen requerir diferentes estrategias de renderizado.
Las páginas de producto y categoría pueden beneficiarse de SSR, renderizado estático o incremental y caching CDN. Las páginas de carrito, cuenta y checkout dependen más de datos específicos del cliente y por tanto tienen menor potencial de caché compartida.
Los storefronts de alto tráfico también deberían considerar:
- caching CDN y Edge
- imágenes y assets estáticos optimizados
- patrones stale-while-revalidate
- invalidación de caché para catálogo y precios
- claves de caché por locale, moneda y región
La personalización añade otro desafío. Si cada respuesta se vuelve completamente única, la eficiencia de la caché cae drásticamente.
Una arquitectura mejor suele mantener la mayor parte de la página cacheable mientras carga por separado los componentes personalizados seleccionados.
Node.js BFF y GraphQL
Un storefront que se conecta directamente a muchos servicios backend puede crear rápidamente una cascada de APIs.
Una página de producto puede necesitar datos de catálogo, precios, inventario, promociones, CMS, reseñas y recomendaciones.
Un Backend-for-Frontend (BFF) crea un límite dedicado para agregar esos servicios.
Un BFF Node.js puede encargarse de:
- agregación de APIs
- autenticación y sesiones
- transformación de respuestas
- timeouts
- comportamiento de respaldo
- normalización de errores
GraphQL puede proporcionar un contrato flexible entre el storefront y el BFF, pero debe diseñarse con cuidado.
Un mal diseño de resolvers puede crear peticiones N+1 o llamadas backend secuenciales. Los sistemas en producción pueden necesitar por tanto batching, límites de complejidad de consulta, caching, consultas persistidas y presupuestos de timeout estrictos.
El BFF también debe evitar que los servicios opcionales controlen la latencia total de la página. Si una API de recomendaciones es lenta, la página de producto normalmente debería seguir renderizando sin esperar indefinidamente.
Motor de comercio y capa de eventos
El motor de comercio sigue siendo responsable de las reglas de negocio autoritativas como:
- catálogo
- precios
- promociones
- carrito
- checkout
- inventario
- pedidos
El storefront puede optimizar la presentación, pero las reglas críticas de negocio deben permanecer detrás de APIs controladas.
Para flujos de trabajo asíncronos, los servicios AWS pueden aportar otra capa de desacoplamiento.
Un flujo típico podría ser: OrderCreated → EventBridge / SQS → Lambda → ERP / CRM / Fulfillment / Analytics
EventBridge puede enrutar un evento de negocio a múltiples consumidores, mientras que SQS puede amortiguar cargas cuando los consumidores no pueden procesar eventos al mismo ritmo en que se producen.
Esta arquitectura se alinea con los principios más amplios de infraestructura cloud-native al permitir que los componentes escalen según su propia carga de trabajo.
Las organizaciones que construyen intensamente sobre infraestructura Amazon también pueden explorar los servicios de desarrollo AWS de HDWEBSOFT para arquitectura cloud, desarrollo serverless, migración y DevOps.
Serverless no es automáticamente la opción correcta para cada componente. Las cargas de trabajo de alto rendimiento sostenido o los servicios con requisitos de conexión complejos pueden beneficiarse aún de contenedores o arquitecturas híbridas.
Checkout en tiempo real y procesamiento de pedidos a escala
El alto tráfico crea el mayor riesgo donde la velocidad se encuentra con la corrección transaccional.
Las páginas de navegación a menudo toleran caching o datos ligeramente obsoletos. El checkout no puede tolerar cargos duplicados, pedidos duplicados ni sobreventa de inventario limitado.
La ruta síncrona del checkout debe permanecer por tanto enfocada.
Una ruta crítica típica: validar carrito → confirmar precios actuales → reservar inventario → autorizar pago → crear pedido
Una vez que existe el pedido duradero, muchos otros flujos pueden ocurrir de forma asíncrona:
- email de confirmación
- sincronización CRM
- actualizaciones ERP
- analytics
- actualizaciones de fidelidad
- eventos de marketing
- feedback de recomendaciones
Esto evita que integraciones no críticas prolonguen el tiempo de checkout del cliente.
La guía de AWS para integrar microservicios con servicios serverless ofrece patrones para comunicación asíncrona, enrutamiento de eventos y procesamiento basado en colas.
Idempotencia y seguridad en reintentos
Los reintentos son normales en sistemas ecommerce distribuidos. Un cliente puede hacer clic en checkout dos veces. Un timeout de red puede hacer que el navegador reintente. Los proveedores de pago pueden reenviar webhooks. Los consumidores de colas pueden recibir el mismo evento más de una vez. La aplicación debe diseñarse por tanto para que repetir la misma petición no repita la acción de negocio. Una clave de idempotencia puede asociar múltiples envíos de checkout idénticos con una transacción existente en lugar de crear múltiples pedidos.
El mismo principio se aplica a los workers en segundo plano. Los reintentos también deben controlarse. Los fallos temporales pueden justificar reintento con backoff, mientras que los datos inválidos no deberían reintentarse indefinidamente. Los eventos fallidos pueden moverse finalmente a una dead-letter queue para investigación.
Backpressure y límites posteriores
Auto-escalar agresivamente cada servicio no garantiza estabilidad. Imagina una flash sale que genera miles de eventos de pedido mientras una integración ERP solo puede procesar un número limitado de peticiones por segundo. Si cada pedido dispara inmediatamente una llamada al ERP, el sistema posterior se convierte en el cuello de botella. Una cola absorbe el pico y permite al consumidor procesar el trabajo a un ritmo sostenible. Esto es backpressure: proteger los sistemas más lentos en lugar de permitir que la escalabilidad aguas arriba los desborde.
Consistencia de inventario
El inventario es otro desafío del alto tráfico. Si queda un producto y 20 clientes intentan hacer checkout al mismo tiempo, cada petición no debe leer independientemente “1 disponible” y comprarlo con éxito. El sistema de inventario autoritativo puede requerir reservas atómicas, actualizaciones condicionales o controles de concurrencia optimistas. Las reservas también pueden expirar cuando el pago falla o el checkout se abandona. El modelo de consistencia exacto depende del negocio. Los productos de edición limitada requieren controles más estrictos que el inventario que puede reponerse fácilmente.
Ingeniería de rendimiento y escalabilidad para flash sales
La arquitectura headless crea límites de escalado útiles, pero esos límites aún deben diseñarse y probarse.
Los grandes picos de demanda del retail hacen esto particularmente importante.
Adobe informó que los consumidores de EE. UU. gastaron 257.800 millones de dólares online durante la temporada navideña de 2025, con 25 días superando los 4.000 millones de dólares en gasto online, frente a 18 días el año anterior. El análisis cubrió más de un billón de visitas a sitios de retail de EE. UU. Consulta el informe de ecommerce navideño 2026 de Adobe Analytics.
La implicación no es que toda plataforma ecommerce necesite la misma capacidad. Es que los picos de tráfico pueden ocurrir repetidamente durante una campaña o temporada de compras en lugar de en un único evento aislado.
Construir un presupuesto de latencia
El rendimiento debe medirse en toda la cadena de petición: CDN → renderizado React → BFF → APIs de comercio → personalización opcional
Optimizar el frontend no puede compensar una cascada de APIs backend que añade varios segundos.
Los distintos recorridos del cliente también requieren expectativas de rendimiento diferentes.
La navegación de producto es muy sensible a la latencia y favorable a la caché. El checkout puede tardar más porque debe confirmar pago e inventario. El procesamiento de pedidos en segundo plano a menudo tolera segundos o minutos.
Un presupuesto de latencia ayuda a los equipos a asignar tiempo aceptable a cada capa en lugar de optimizar a ciegas.
Cachear en la capa correcta
El comercio headless suele usar varias cachés:
- caché CDN y de páginas
- caché de APIs
- caché de catálogo/búsqueda
- caché GraphQL o de objetos
- caché de recomendaciones
La cuestión clave es la frescura.
Las descripciones de producto pueden permanecer en caché más tiempo que los precios promocionales. El inventario mostrado durante la navegación tolera una breve obsolescencia, mientras que el inventario en el checkout debe verificarse contra la fuente autoritativa.
Una política de caché correcta reduce la carga del backend sin comprometer la exactitud transaccional.
Escalar toda la cadena de dependencias
Lambda puede escalar rápidamente, pero otras dependencias quizá no.
Posibles restricciones:
- conexiones a la base de datos
- cuotas de proveedores de pago
- límites de la plataforma de comercio
- rendimiento del ERP
- APIs de terceros
- sistemas de inventario
Esto significa: el auto-escalado del cómputo no escala automáticamente todo el sistema.
Los límites de concurrencia, las colas, la gestión de conexiones a la base de datos y los rate limits de terceros pertenecen todos a la planificación de capacidad.
Los equipos en producción también deberían monitorizar la latencia p95 y p99 en lugar de solo promedios.
Métricas útiles de alto tráfico:
- TTFB / LCP
- latencia p95/p99 del BFF
- tiempo de finalización del checkout
- tasa de error de APIs
- tasa de cache-hit
- profundidad y antigüedad de colas
- fallos de pago
- retraso del procesamiento de pedidos
Estas métricas conectan el comportamiento de la infraestructura con la experiencia del cliente.
Personalización IA sin ralentizar el recorrido de compra
La arquitectura headless facilita aislar la personalización de la funcionalidad central del comercio.
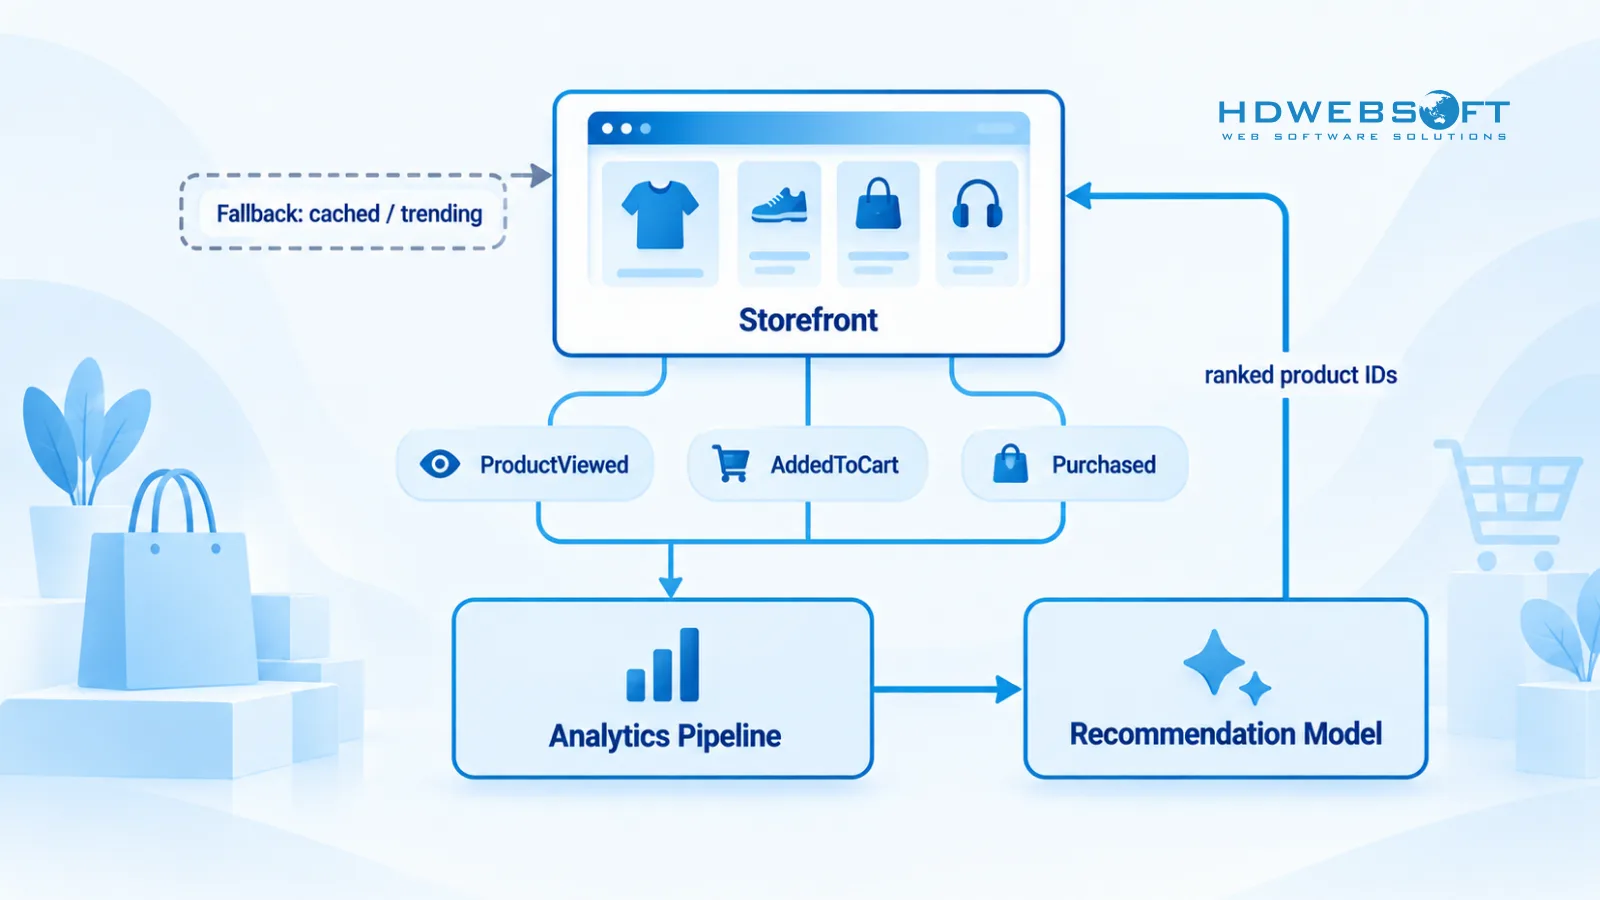
En lugar de integrar la lógica de recomendación dentro del storefront o el motor de comercio, las empresas pueden exponer las recomendaciones como un servicio independiente.
Ese servicio puede usar:
- historial de navegación
- comportamiento de compra
- datos de catálogo
- preferencias del cliente
- relaciones entre productos
- señales de inventario
La salida puede ser simplemente IDs de producto u ofertas ordenados devueltos mediante una API.
El storefront no necesita saber cómo funciona el modelo subyacente.
Mantener la IA fuera de la ruta crítica
Las recomendaciones de IA deberían mejorar el recorrido de compra, no controlar si el recorrido funciona.
Si una API de recomendaciones se vuelve lenta, las páginas de producto normalmente deberían seguir renderizando.
La arquitectura puede definir un presupuesto de latencia y un comportamiento de respaldo como:
- recomendaciones en caché
- productos en tendencia
- más vendidos por categoría
- alternativas basadas en reglas
De igual modo, los fallos del modelo o las recomendaciones inválidas no deberían interferir con el checkout.
Los eventos de comercio como ProductViewed, AddedToCart, SearchPerformed y Purchased pueden alimentar pipelines de analytics o de modelos de forma asíncrona.
Esto crea un bucle de retroalimentación sin poner el entrenamiento de IA o la inferencia pesada directamente dentro de los flujos transaccionales.
Para empresas que construyen storefronts personalizados, marketplaces, sistemas de recomendación e integraciones de comercio, los servicios de desarrollo de software e-commerce de HDWEBSOFT cubren tanto las plataformas de comercio centrales como la funcionalidad habilitada por IA.
Cuándo merece la pena la complejidad del headless commerce
La arquitectura headless crea flexibilidad, pero la flexibilidad introduce servicios, APIs, despliegues, monitorización y responsabilidades operativas adicionales.
Por tanto debe resolver una restricción real.
| Dimensión | Monolito tradicional | Headless | Composable |
|---|---|---|---|
| Independencia del frontend | Baja | Alta | Alta |
| Modularidad del backend | Baja | Variable | Alta |
| Escalado independiente | Limitado | Medio–Alto | Alto |
| Soporte multicanal | Bajo | Alto | Alto |
| Complejidad operativa | Baja | Media | Mayor |
| Exigencia de ingeniería | Baja | Mayor | La mayor |
Headless tiende a encajar en empresas que tienen:
- múltiples storefronts o canales digitales
- requisitos de UX altamente personalizados
- integraciones complejas
- múltiples regiones o marcas
- releases de frontend frecuentes
- restricciones sustanciales de rendimiento o escalado
Puede ser innecesario cuando:
- el catálogo es simple
- las integraciones son limitadas
- un storefront SaaS ya cumple los requisitos
- el equipo de ingeniería es pequeño
- los requisitos de personalización son bajos
La pregunta correcta no es: “¿Es el headless más moderno?” Es: “¿Qué restricción de negocio o arquitectura elimina el headless?”
Cómo aborda HDWEBSOFT la arquitectura ecommerce
Para sistemas ecommerce existentes, la modernización debe comenzar por el cuello de botella actual en lugar de un stack predeterminado.
Un proceso práctico puede incluir:
- Evaluación de arquitectura — Revisar patrones de tráfico, integraciones, cuellos de rendimiento, flujos de datos y puntos de fallo.
- Definir límites — Determinar qué cargas de frontend, comercio, integración o segundo plano necesitan realmente escalado independiente.
- Validar el rendimiento — Probar con carga los recorridos de cliente críticos y los servicios posteriores.
- Desplegar incrementalmente — Separar componentes donde ello cree valor medible en lugar de reemplazar toda la plataforma de una vez.
El caso de estudio Salesforce Integration to an All-in-One Seller Workspace de HDWEBSOFT demuestra el lado de integración del ecommerce empresarial. El proyecto implicó sincronización bidireccional entre Lightspeed POS y Salesforce para información de inventario, clientes y pedidos.
El caso no representa exactamente la arquitectura de referencia React–Node.js–AWS descrita aquí. Su relevancia es el desafío de integración más amplio: las plataformas ecommerce empresariales rara vez operan solas. Los datos de comercio a menudo deben moverse de forma fiable entre POS, CRM, inventario, fulfillment, contabilidad y otros sistemas.
Conclusión
La escalabilidad del ecommerce headless no consiste en reemplazar un monolito con tantas tecnologías modernas como sea posible.
El objetivo es crear límites claros para que el storefront, las transacciones de comercio, las cargas asíncronas, las integraciones y los servicios opcionales como la IA puedan escalar y fallar según sus propios requisitos.
React aporta flexibilidad al frontend. Node.js y GraphQL crean una capa de API de storefront controlada. Los servicios serverless de AWS soportan cargas orientadas a eventos. Pero el éxito en producción sigue dependiendo del caching, los presupuestos de latencia, la idempotencia, el backpressure, la consistencia de inventario, la observabilidad y pruebas de carga realistas.
¿Estás planificando una plataforma ecommerce headless o preparando una tienda existente para mayor tráfico? Contacta con HDWEBSOFT para hablar de tu arquitectura y requisitos de escalado.
Preguntas frecuentes
¿Qué es una arquitectura ecommerce headless?
El ecommerce headless separa el storefront orientado al cliente del motor de comercio en el backend. El frontend se comunica con catálogo, precios, carrito, checkout, inventario y otros servicios a través de APIs.
¿Qué papel juegan React y Node.js en el ecommerce headless?
React puede impulsar el storefront, mientras que Node.js proporciona una capa Backend-for-Frontend que agrega las APIs de comercio, gestiona la autenticación, controla los timeouts y expone interfaces REST o GraphQL optimizadas para el frontend.
¿Puede el ecommerce headless manejar flash sales de alto tráfico?
Sí, pero la arquitectura headless por sí sola no garantiza escalabilidad. El rendimiento también depende del caching, la capacidad de las APIs, los límites de la base de datos, los proveedores de pago, el control de inventario, las colas y las integraciones posteriores.
¿Cuál es la diferencia entre headless y composable commerce?
Headless separa principalmente la presentación frontend del backend. Composable commerce además divide las capacidades de negocio en componentes modulares que pueden seleccionarse y evolucionar de forma independiente.
¿Por qué usar servicios serverless de AWS para ecommerce?
AWS Lambda, EventBridge y SQS soportan cargas de trabajo orientadas a eventos, procesamiento en segundo plano, amortiguación de tráfico y escalado independiente. Sin embargo, contenedores o infraestructura híbrida pueden ser más apropiados para algunas cargas sostenidas.
¿Cómo añadir personalización IA sin ralentizar el storefront?
Tratar las recomendaciones como un servicio independiente con presupuesto de latencia y comportamiento de respaldo. Si el servicio de IA es lento o no está disponible, el storefront puede devolver recomendaciones en caché, populares o basadas en reglas.
