
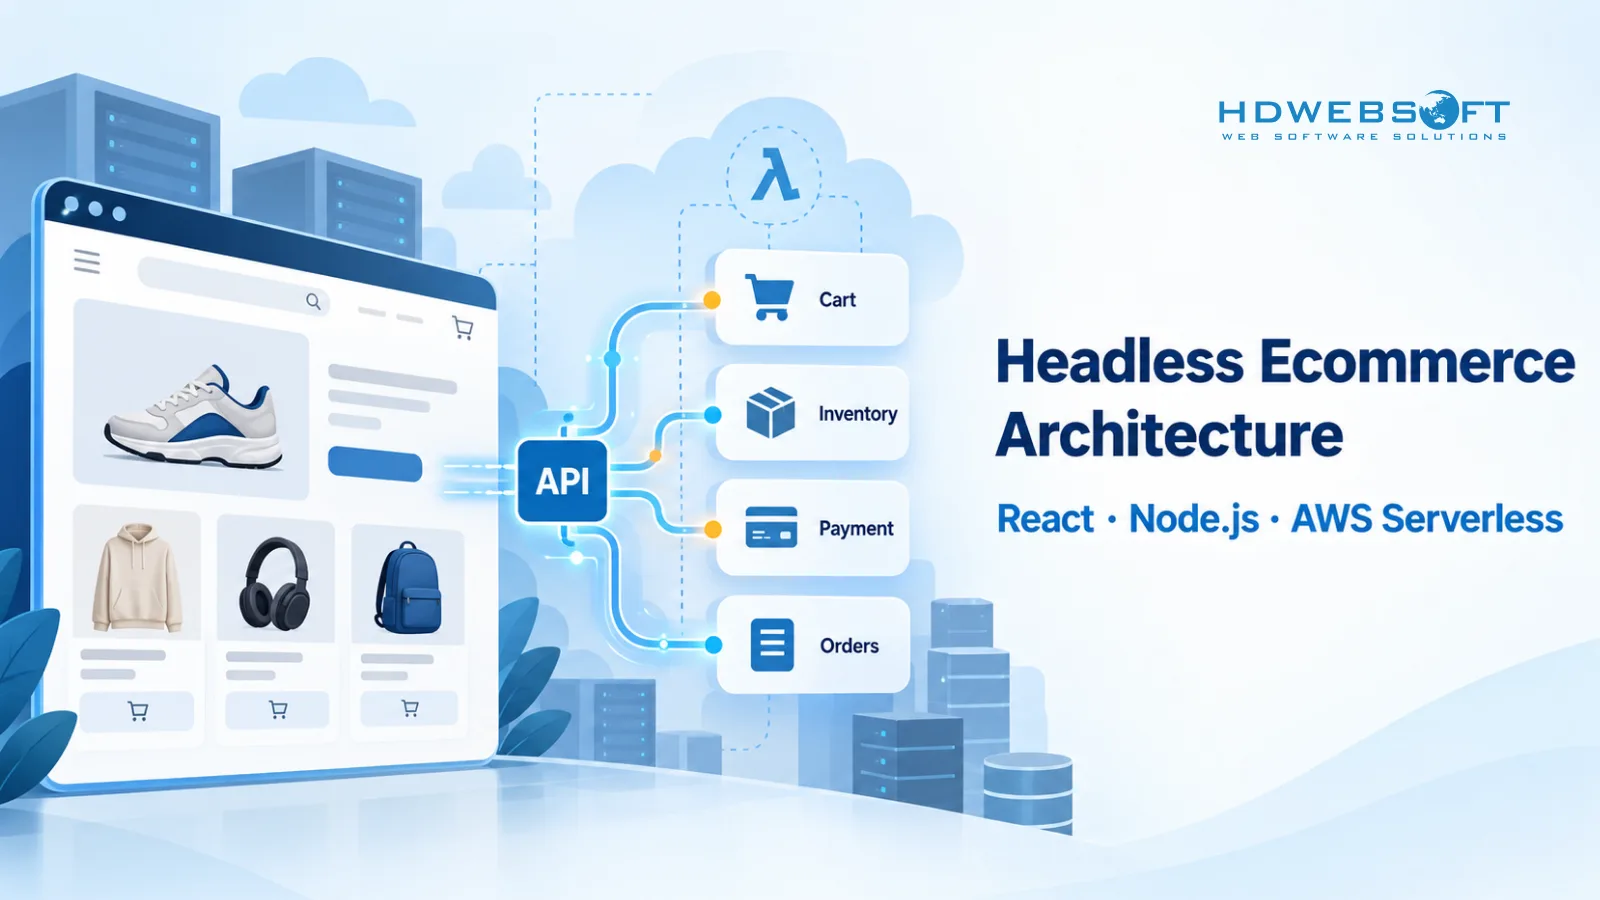
Le piattaforme ecommerce ad alto traffico raramente falliscono perché un framework frontend è troppo lento. I problemi compaiono di solito quando il rendering dello storefront, le API di catalogo, il checkout, l’inventario, i pagamenti, la personalizzazione e le integrazioni di terze parti competono per la capacità durante lo stesso picco di traffico.
Un’architettura ecommerce headless separa lo storefront rivolto al cliente dal motore commerce tramite API. Questo permette al livello di presentazione, ai servizi backend, alle integrazioni e ai workload di supporto di scalare ed evolvere in modo più indipendente.
Per i brand che si preparano a flash sale, espansione internazionale, esperienze omnichannel o percorsi d’acquisto fortemente personalizzati, questa separazione può creare una base tecnica più solida. Tuttavia, l’architettura headless non garantisce automaticamente caricamenti sotto il secondo o concorrenza massiccia. Le prestazioni dipendono ancora da caching, design delle API, capacità del database, elaborazione asincrona, osservabilità e load testing realistico.
Per una visione più ampia di architettura e UX nel retail online, consulta la nostra guida ai servizi di sviluppo ecommerce.
Punti chiave
- L’ecommerce headless separa lo storefront dalle capacità commerce del backend, permettendo a ogni livello di scalare ed evolvere in modo più indipendente.
- Uno stack di riferimento comune combina React, un BFF Node.js/GraphQL, un motore commerce e servizi AWS serverless per i workload asincroni.
- Gli storefront veloci dipendono dalla strategia di rendering, dal caching CDN, dal design delle API e dalle prestazioni a valle — non solo da React.
- Il checkout dovrebbe mantenere il percorso sincrono ridotto mentre le attività post-ordine appropriate passano all’elaborazione event-driven.
- Il commerce ad alto traffico richiede idempotenza, code, backpressure, coerenza dell’inventario e capacity planning oltre il semplice auto-scaling.
- La personalizzazione AI deve avere un budget di latenza e un comportamento di fallback per non diventare mai una dipendenza critica dello storefront.
Cosa deve risolvere un’architettura ecommerce headless ad alto traffico
Nella sua forma più semplice, l’ecommerce headless separa l’esperienza del cliente dalla piattaforma commerce di backend.
In un sistema ecommerce tradizionale, presentazione, logica di catalogo, checkout, plugin e workflow backend possono convivere nella stessa applicazione. Funziona bene finché parti diverse del sistema non devono scalare, rilasciare o cambiare in modo indipendente.
Con l’architettura headless, uno storefront React, una mobile app, un’interfaccia marketplace o un altro frontend comunica con le capacità commerce tramite API.
Questo crea confini più chiari tra:
- esperienza del cliente
- catalogo e prezzi
- carrello e checkout
- elaborazione degli ordini
- inventario
- ricerca
- personalizzazione
- integrazioni di terze parti
Headless e composable commerce sono correlati, ma non identici.
L’headless commerce separa principalmente il livello di presentazione dal backend. Il composable commerce va oltre trattando capacità come ricerca, pagamento, promozioni, contenuti e checkout come componenti modulari sostituibili o evolvibili in modo indipendente.
I principi MACH descrivono questo approccio più ampio attorno a modularità, API, cloud-native delivery e presentazione headless.
Per i brand ad alto traffico, l’architettura dovrebbe partire dai requisiti di carico anziché da uno stack tecnologico preferito.
Invece di dire: “Il sistema deve gestire 100.000 utenti simultanei.”
I team dovrebbero tradurre quell’obiettivo in caratteristiche misurabili:
- richieste al secondo
- rapporto browsing-checkout
- chiamate API per customer journey
- cache-hit rate
- distribuzione geografica
- durata del picco
- limiti delle API a valle
Centomila persone che visualizzano pagine di catalogo in cache sono molto diverse da centomila clienti che tentano simultaneamente di riservare inventario limitato e inviare un pagamento.
Anche i confini di fallimento contano.
Se il servizio di raccomandazioni fallisce, i clienti dovrebbero poter continuare a navigare i prodotti? Se la sincronizzazione CRM rallenta, il checkout dovrebbe fermarsi? Se il provider email diventa non disponibile, un ordine dovrebbe fallire?
Un sistema headless ben progettato impedisce alle capacità opzionali di trascinare a fondo i flussi commerce critici.
Architettura di riferimento: React, Node.js, GraphQL & AWS Serverless
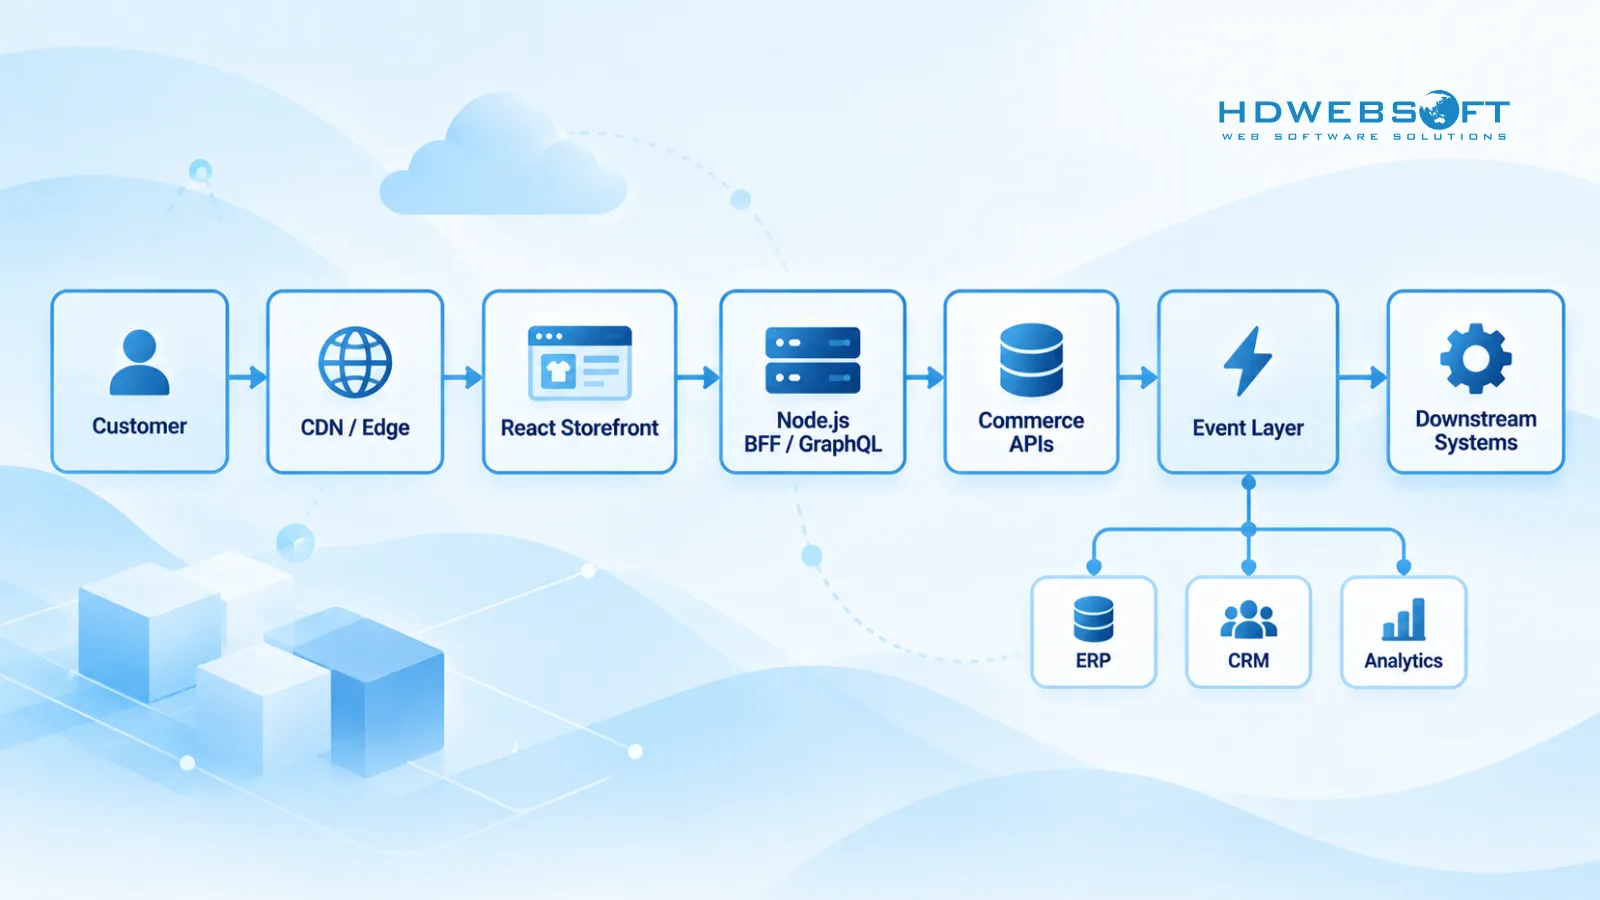
Un’architettura ecommerce headless pratica può essere rappresentata così: Customer → CDN/Edge → React Storefront → Node.js BFF/GraphQL → Commerce APIs → Event Layer → Downstream Systems
È un’architettura di riferimento, non uno stack obbligatorio. GraphQL può essere sostituito da REST, Lambda da container, o un backend custom da una piattaforma headless commerce commerciale.
L’importante è stabilire confini chiari.
React Storefront ed Edge Delivery
React offre flessibilità per costruire esperienze di product discovery, account, carrello e checkout, ma React da solo non rende veloce uno storefront.
Pagine diverse richiedono di solito strategie di rendering diverse.
Le pagine prodotto e categoria possono beneficiare di SSR, rendering statico o incrementale e caching CDN. Le pagine carrello, account e checkout dipendono maggiormente da dati specifici del cliente e hanno quindi minore potenziale di cache condivisa.
Gli storefront ad alto traffico dovrebbero inoltre considerare:
- caching CDN ed Edge
- immagini e asset statici ottimizzati
- pattern stale-while-revalidate
- invalidazione della cache per catalogo e prezzi
- chiavi di cache per locale, valuta e regione
La personalizzazione aggiunge un’altra sfida. Se ogni risposta diventa completamente unica, l’efficienza della cache crolla drasticamente.
Un’architettura migliore spesso mantiene cacheable la maggior parte della pagina caricando separatamente i componenti personalizzati selezionati.
Node.js BFF e GraphQL
Uno storefront che si connette direttamente a molti servizi backend può creare rapidamente una cascata di API.
Una singola pagina prodotto può richiedere dati da catalogo, prezzi, inventario, promozioni, CMS, recensioni e raccomandazioni.
Un Backend-for-Frontend (BFF) crea un confine dedicato per aggregare quei servizi.
Un BFF Node.js può gestire:
- aggregazione delle API
- autenticazione e sessioni
- trasformazione delle risposte
- timeout
- comportamento di fallback
- normalizzazione degli errori
GraphQL può fornire un contratto flessibile tra storefront e BFF, ma va progettato con cura.
Un cattivo design dei resolver può creare richieste N+1 o chiamate backend sequenziali. I sistemi in produzione possono quindi richiedere batching, limiti di complessità delle query, caching, persisted query e budget di timeout rigorosi.
Il BFF dovrebbe inoltre impedire che i servizi opzionali controllino la latenza totale della pagina. Se un’API di raccomandazioni è lenta, la pagina prodotto dovrebbe di norma continuare il rendering senza attendere all’infinito.
Motore commerce ed Event Layer
Il motore commerce resta responsabile delle regole di business authoritative come:
- catalogo
- prezzi
- promozioni
- carrello
- checkout
- inventario
- ordini
Lo storefront può ottimizzare la presentazione, ma le regole critiche per il business dovrebbero restare dietro API controllate.
Per i workflow asincroni, i servizi AWS possono fornire un ulteriore livello di disaccoppiamento.
Un flusso tipico potrebbe essere: OrderCreated → EventBridge / SQS → Lambda → ERP / CRM / Fulfillment / Analytics
EventBridge può instradare un evento di business a più consumer, mentre SQS può bufferizzare i workload quando i consumer non riescono a processare gli eventi alla stessa velocità con cui vengono prodotti.
Questa architettura si allinea ai principi più ampi dell’infrastruttura cloud-native permettendo ai componenti di scalare in base al proprio workload.
Le organizzazioni che costruiscono intensamente su infrastruttura Amazon possono inoltre esplorare i servizi di sviluppo AWS di HDWEBSOFT per architettura cloud, sviluppo serverless, migrazione e DevOps.
Serverless non è automaticamente la scelta giusta per ogni componente. Workload a throughput elevato sostenuto o servizi con requisiti di connessione complessi possono ancora beneficiare di container o architetture ibride.
Checkout in tempo reale ed elaborazione degli ordini su larga scala
L’alto traffico crea il rischio maggiore dove velocità e correttezza transazionale si incontrano.
Le pagine di browsing tollerano spesso caching o dati leggermente obsoleti. Il checkout non può tollerare addebiti duplicati, ordini duplicati o overselling di inventario limitato.
Il percorso sincrono del checkout dovrebbe quindi restare focalizzato.
Un percorso critico tipico può includere: validare il carrello → confermare i prezzi attuali → riservare l’inventario → autorizzare il pagamento → creare l’ordine
Una volta che l’ordine durevole esiste, molti altri workflow possono avvenire in modo asincrono:
- email di conferma
- sincronizzazione CRM
- aggiornamenti ERP
- analytics
- aggiornamenti loyalty
- eventi di marketing
- feedback per le raccomandazioni
Questo impedisce alle integrazioni non critiche di allungare i tempi di checkout del cliente.
La guida AWS per integrare i microservizi con i servizi serverless fornisce pattern per la comunicazione asincrona, l’event routing e l’elaborazione basata su code.
Idempotenza e sicurezza dei retry
I retry sono normali nei sistemi ecommerce distribuiti. Un cliente può cliccare checkout due volte. Un timeout di rete può far riprovare il browser. I provider di pagamento possono reinviare webhook. I consumer delle code possono ricevere lo stesso evento più di una volta. L’applicazione dovrebbe quindi essere progettata affinché ripetere la stessa richiesta non ripeta l’azione di business. Una chiave di idempotenza può associare più invii di checkout identici a una transazione esistente invece di creare più ordini.
Lo stesso principio si applica ai worker in background. Anche i retry dovrebbero essere controllati. I fallimenti temporanei possono giustificare il retry con backoff, mentre i dati non validi non dovrebbero essere riprovati all’infinito. Gli eventi falliti possono infine essere spostati in una dead-letter queue per l’indagine.
Backpressure e limiti a valle
Auto-scalare aggressivamente ogni servizio non garantisce stabilità. Immagina una flash sale che genera migliaia di eventi d’ordine mentre un’integrazione ERP può processare solo un numero limitato di richieste al secondo. Se ogni ordine attiva immediatamente una chiamata all’ERP, il sistema a valle diventa il collo di bottiglia. Una coda assorbe il picco e permette al consumer di processare il lavoro a un ritmo sostenibile. Questo è il backpressure: proteggere i sistemi più lenti invece di lasciare che la scalabilità a monte li travolga.
Coerenza dell’inventario
L’inventario è un’altra sfida dell’alto traffico. Se resta un prodotto e 20 clienti tentano il checkout contemporaneamente, ogni richiesta non deve leggere indipendentemente “1 disponibile” e acquistarlo con successo. Il sistema di inventario authoritative può richiedere prenotazioni atomiche, aggiornamenti condizionali o controlli di concorrenza ottimistici. Le prenotazioni possono inoltre scadere quando il pagamento fallisce o il checkout viene abbandonato. Il modello di coerenza esatto dipende dal business. I prodotti in edizione limitata richiedono controlli più rigorosi dell’inventario facilmente rifornibile.
Ingegneria di performance e scalabilità per le flash sale
L’architettura headless crea confini di scalabilità utili, ma quei confini devono comunque essere progettati e testati.
I grandi picchi di domanda retail rendono questo aspetto particolarmente importante.
Adobe ha riportato che i consumatori statunitensi hanno speso 257,8 miliardi di dollari online durante le festività 2025, con 25 giorni singoli oltre i 4 miliardi di dollari di spesa online, rispetto ai 18 giorni dell’anno precedente. L’analisi ha coperto oltre mille miliardi di visite a siti retail statunitensi. Vedi il report ecommerce delle festività 2026 di Adobe Analytics.
L’implicazione non è che ogni piattaforma ecommerce necessiti della stessa capacità. È che i picchi di traffico possono verificarsi ripetutamente durante una campagna o una stagione di shopping anziché in un singolo evento isolato.
Costruire un budget di latenza
Le prestazioni dovrebbero essere misurate lungo l’intera catena di richiesta: CDN → rendering React → BFF → API commerce → personalizzazione opzionale
Ottimizzare il frontend non può compensare una cascata di API backend che aggiunge diversi secondi.
Customer journey diverse richiedono anche aspettative di performance diverse.
La navigazione dei prodotti è molto sensibile alla latenza e favorevole alla cache. Il checkout può richiedere più tempo perché deve confermare pagamento e inventario. L’elaborazione degli ordini in background può spesso tollerare secondi o minuti.
Un budget di latenza aiuta i team ad allocare il tempo accettabile a ogni livello anziché ottimizzare alla cieca.
Cachare nel livello giusto
Il commerce headless usa spesso diverse cache:
- cache CDN e delle pagine
- cache delle API
- cache di catalogo/ricerca
- cache GraphQL o degli oggetti
- cache delle raccomandazioni
La questione chiave è la freschezza.
Le descrizioni dei prodotti possono restare in cache più a lungo dei prezzi promozionali. L’inventario mostrato durante il browsing tollera una breve obsolescenza, mentre l’inventario al checkout deve essere verificato contro la fonte authoritative.
Una politica di cache corretta riduce il carico sul backend senza compromettere l’accuratezza transazionale.
Scalare l’intera catena di dipendenze
Lambda può scalare rapidamente, ma altre dipendenze forse no.
Possibili vincoli:
- connessioni al database
- quote dei provider di pagamento
- limiti della piattaforma commerce
- throughput dell’ERP
- API di terze parti
- sistemi di inventario
Questo significa: l’auto-scaling del compute non scala automaticamente l’intero sistema.
Limiti di concorrenza, code, gestione delle connessioni al database e rate limit di terze parti appartengono tutti al capacity planning.
I team di produzione dovrebbero inoltre monitorare la latenza p95 e p99 invece delle sole medie.
Metriche utili ad alto traffico:
- TTFB / LCP
- latenza p95/p99 del BFF
- tempo di completamento del checkout
- tasso di errore delle API
- cache-hit ratio
- profondità ed età delle code
- pagamenti falliti
- ritardo nell’elaborazione degli ordini
Queste metriche collegano il comportamento dell’infrastruttura all’esperienza del cliente.
Personalizzazione AI senza rallentare il percorso d’acquisto
L’architettura headless facilita l’isolamento della personalizzazione dalla funzionalità commerce di base.
Invece di incorporare la logica di raccomandazione nello storefront o nel motore commerce, le aziende possono esporre le raccomandazioni come servizio indipendente.
Quel servizio può usare:
- cronologia di navigazione
- comportamento d’acquisto
- dati di catalogo
- preferenze del cliente
- relazioni tra prodotti
- segnali di inventario
L’output può essere semplicemente ID prodotto o offerte classificati restituiti tramite un’API.
Lo storefront non deve sapere come funziona il modello sottostante.
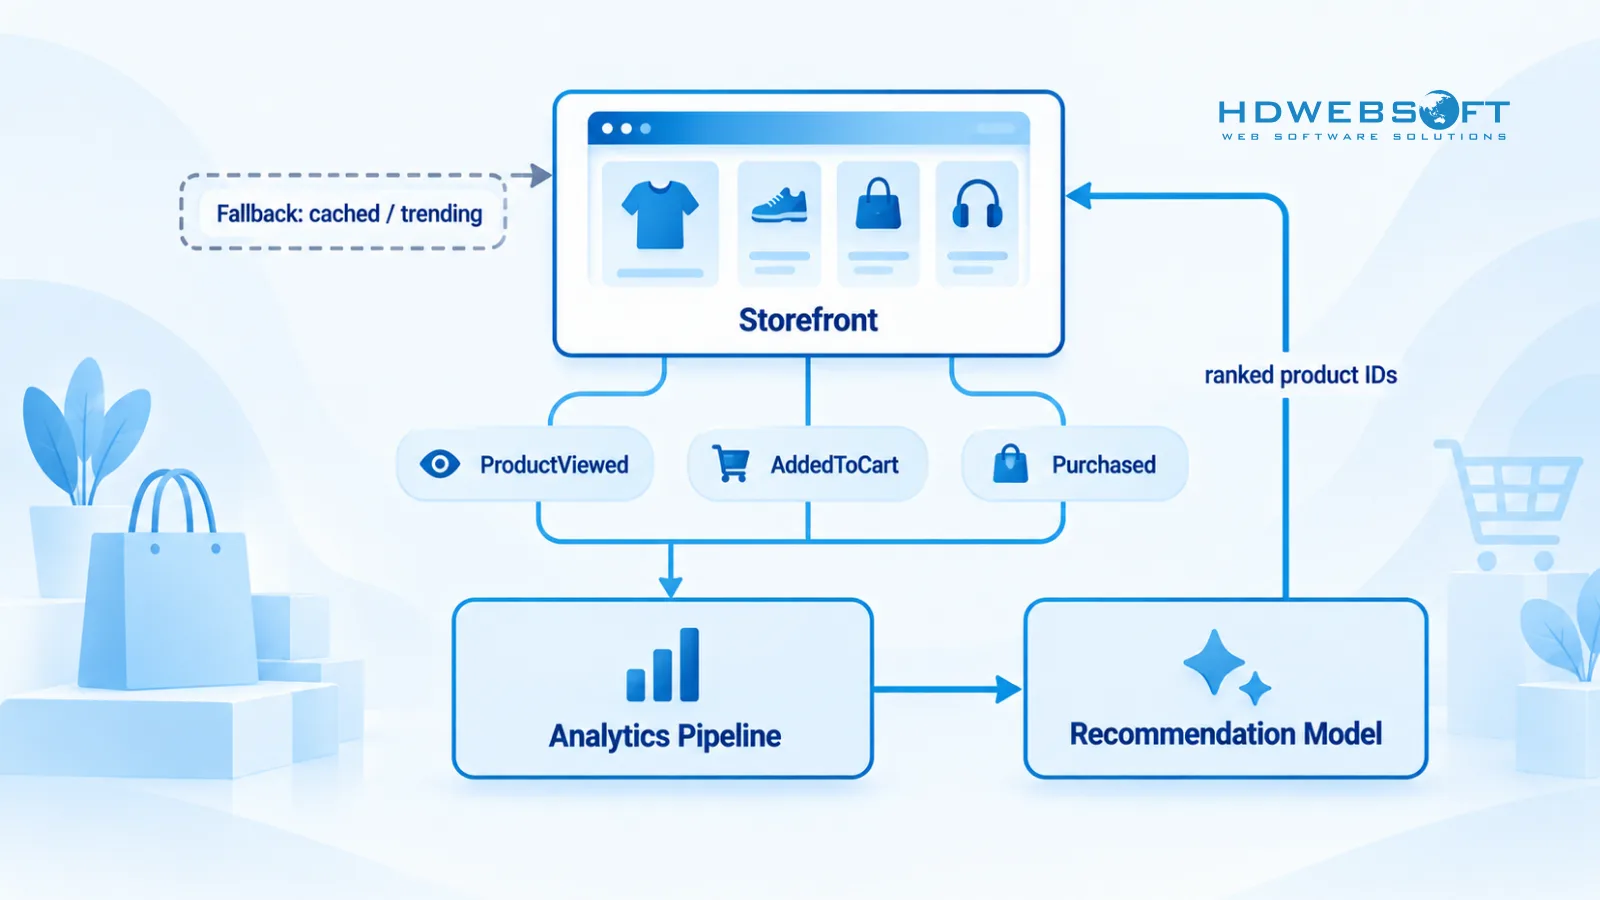
Tenere l’AI fuori dal percorso critico
Le raccomandazioni AI dovrebbero migliorare il percorso d’acquisto, non determinare se quel percorso funziona.
Se un’API di raccomandazioni diventa lenta, le pagine prodotto dovrebbero di norma continuare il rendering.
L’architettura può definire un budget di latenza e un comportamento di fallback come:
- raccomandazioni in cache
- prodotti di tendenza
- best seller per categoria
- alternative basate su regole
Allo stesso modo, i fallimenti del modello o le raccomandazioni non valide non dovrebbero interferire con il checkout.
Gli eventi commerce come ProductViewed, AddedToCart, SearchPerformed e Purchased possono alimentare pipeline di analytics o di modelli in modo asincrono.
Questo crea un ciclo di feedback senza inserire il training AI o l’inferenza pesante direttamente nei flussi transazionali.
Per le aziende che costruiscono storefront personalizzati, marketplace, sistemi di raccomandazione e integrazioni commerce, i servizi di sviluppo software e-commerce di HDWEBSOFT coprono sia le piattaforme commerce di base sia le funzionalità abilitate dall’AI.
Quando il headless commerce vale la complessità
L’architettura headless crea flessibilità, ma la flessibilità introduce servizi, API, deployment, monitoraggio e responsabilità operative aggiuntive.
Dovrebbe quindi risolvere un vincolo reale.
| Dimensione | Monolite tradizionale | Headless | Composable |
|---|---|---|---|
| Indipendenza del frontend | Bassa | Alta | Alta |
| Modularità del backend | Bassa | Variabile | Alta |
| Scalabilità indipendente | Limitata | Medio–Alta | Alta |
| Supporto multicanale | Basso | Alto | Alto |
| Complessità operativa | Bassa | Media | Più alta |
| Impegno di engineering | Basso | Più alto | Il più alto |
Headless tende ad adattarsi ad aziende che hanno:
- più storefront o canali digitali
- requisiti UX fortemente personalizzati
- integrazioni complesse
- più regioni o brand
- release frontend frequenti
- vincoli sostanziali di performance o scalabilità
Può essere superfluo quando:
- il catalogo è semplice
- le integrazioni sono limitate
- uno storefront SaaS soddisfa già i requisiti
- il team di engineering è piccolo
- i requisiti di personalizzazione sono bassi
La domanda giusta non è: “Il headless è più moderno?” Ma: “Quale vincolo di business o architettura il headless rimuove?”
Come HDWEBSOFT affronta l’architettura ecommerce
Per i sistemi ecommerce esistenti, la modernizzazione dovrebbe partire dal collo di bottiglia attuale anziché da uno stack predeterminato.
Un processo pratico può includere:
- Valutazione dell’architettura — Esaminare pattern di traffico, integrazioni, colli di bottiglia delle prestazioni, flussi di dati e punti di fallimento.
- Definire i confini — Determinare quali workload frontend, commerce, di integrazione o di background necessitano realmente di scalabilità indipendente.
- Validare le prestazioni — Sottoporre a load test le customer journey critiche e i servizi a valle.
- Rilasciare incrementalmente — Separare i componenti dove ciò crea valore misurabile anziché sostituire l’intera piattaforma in un passo unico.
Il case study Salesforce Integration to an All-in-One Seller Workspace di HDWEBSOFT dimostra il lato integrazione dell’ecommerce enterprise. Il progetto ha coinvolto la sincronizzazione bidirezionale tra Lightspeed POS e Salesforce per informazioni su inventario, clienti e ordini.
Il caso non rappresenta esattamente l’architettura di riferimento React–Node.js–AWS descritta qui. La sua rilevanza sta nella sfida di integrazione più ampia: le piattaforme ecommerce enterprise raramente operano da sole. I dati commerce devono spesso muoversi in modo affidabile tra POS, CRM, inventario, fulfillment, contabilità e altri sistemi.
Conclusione
La scalabilità dell’ecommerce headless non consiste nel sostituire un monolite con quante più tecnologie moderne possibile.
L’obiettivo è creare confini chiari affinché storefront, transazioni commerce, workload asincroni, integrazioni e servizi opzionali come l’AI possano scalare e fallire secondo i propri requisiti.
React offre flessibilità al frontend. Node.js e GraphQL creano un livello API dello storefront controllato. I servizi serverless AWS supportano i workload event-driven. Ma il successo in produzione dipende ancora da caching, budget di latenza, idempotenza, backpressure, coerenza dell’inventario, osservabilità e load testing realistico.
Stai pianificando una piattaforma ecommerce headless o preparando un negozio esistente per traffico più elevato? Contatta HDWEBSOFT per discutere la tua architettura e i tuoi requisiti di scalabilità.
Domande frequenti
Cos’è un’architettura ecommerce headless?
L’ecommerce headless separa lo storefront rivolto al cliente dal motore commerce nel backend. Il frontend comunica con catalogo, prezzi, carrello, checkout, inventario e altri servizi tramite API.
Che ruolo hanno React e Node.js nell’ecommerce headless?
React può alimentare lo storefront, mentre Node.js fornisce un livello Backend-for-Frontend che aggrega le API commerce, gestisce l’autenticazione, controlla i timeout ed espone interfacce REST o GraphQL ottimizzate per il frontend.
L’ecommerce headless può gestire flash sale ad alto traffico?
Sì, ma l’architettura headless da sola non garantisce la scalabilità. Le prestazioni dipendono anche da caching, capacità delle API, limiti del database, provider di pagamento, controllo dell’inventario, code e integrazioni a valle.
Qual è la differenza tra headless e composable commerce?
Headless separa principalmente la presentazione frontend dal backend. Il composable commerce scompone inoltre le capacità di business in componenti modulari selezionabili ed evolvibili in modo indipendente.
Perché usare i servizi serverless AWS per l’ecommerce?
AWS Lambda, EventBridge e SQS supportano workload event-driven, elaborazione in background, buffering del traffico e scalabilità indipendente. Tuttavia, container o infrastrutture ibride possono essere più adatte per alcuni carichi sostenuti.
Come aggiungere la personalizzazione AI senza rallentare lo storefront?
Trattare le raccomandazioni come un servizio indipendente con budget di latenza e comportamento di fallback. Se il servizio AI è lento o non disponibile, lo storefront può restituire raccomandazioni in cache, popolari o basate su regole.
