
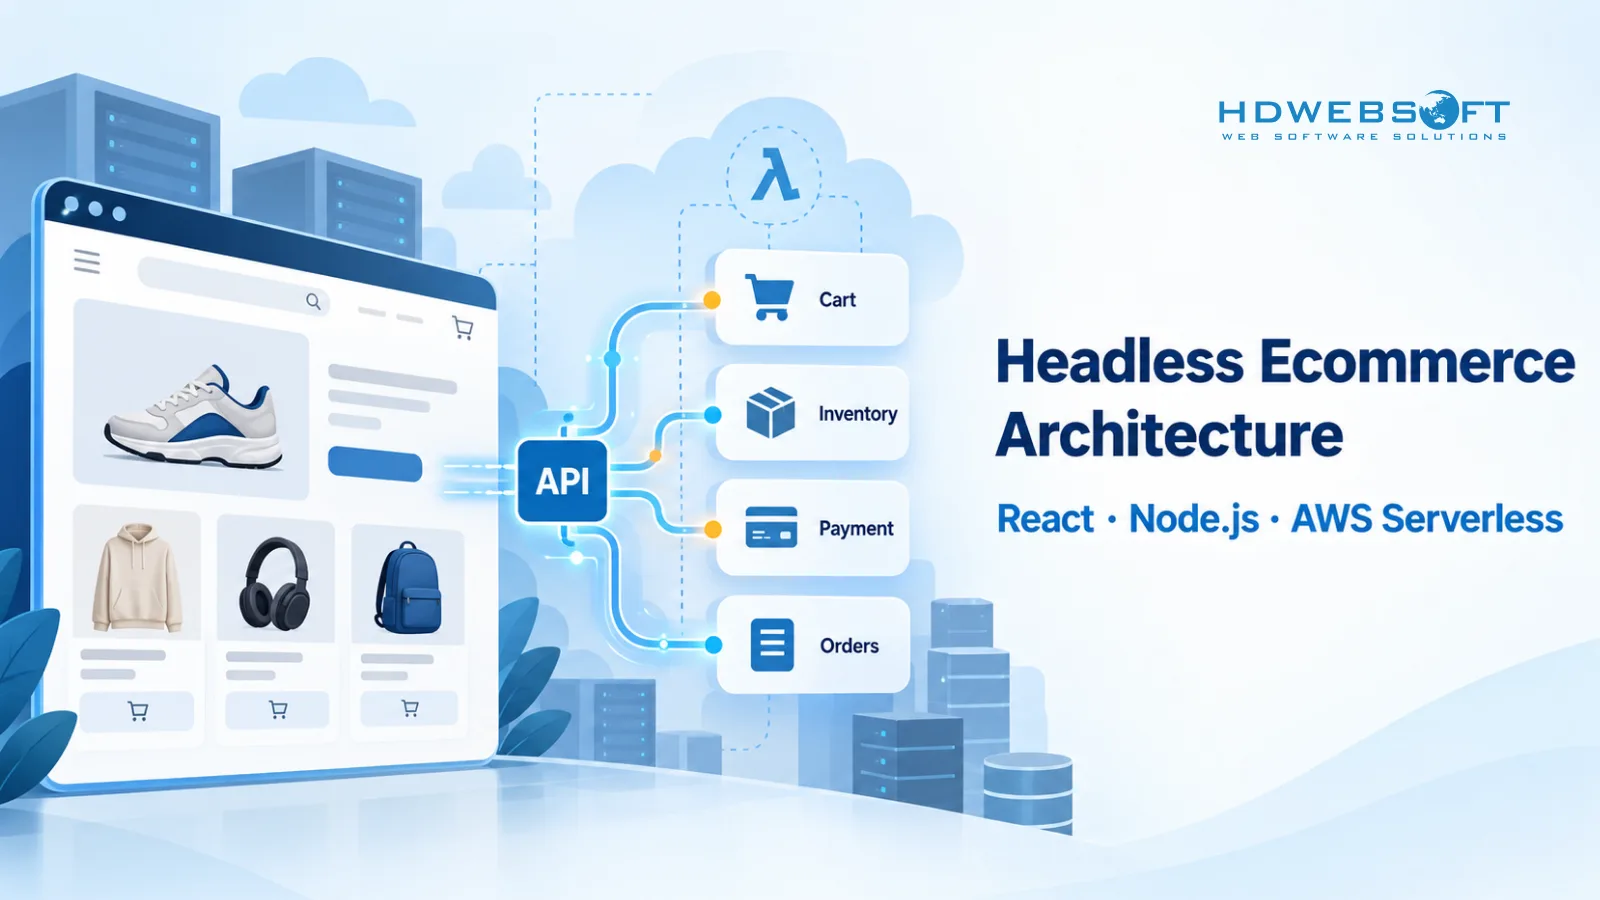
High-Traffic-Ecommerce-Plattformen scheitern selten daran, dass ein einzelnes Frontend-Framework zu langsam ist. Probleme entstehen meist dann, wenn Storefront-Rendering, Katalog-APIs, Checkout, Inventar, Zahlungen, Personalisierung und Drittanbieter-Integrationen während derselben Traffic-Spitze um Kapazität konkurrieren.
Eine Headless-Ecommerce-Architektur trennt das kundenseitige Storefront über APIs vom Commerce-Engine. Dadurch können Präsentationsschicht, Backend-Services, Integrationen und unterstützende Workloads unabhängiger skalieren und sich weiterentwickeln.
Für Marken, die Flash Sales, internationale Expansion, Omnichannel-Erlebnisse oder stark personalisierte Shopping-Journeys vorbereiten, kann diese Trennung eine stärkere technische Grundlage schaffen. Allerdings garantiert eine Headless-Architektur nicht automatisch Ladezeiten unter einer Sekunde oder massive Parallelität. Die Performance hängt weiterhin von Caching, API-Design, Datenbankkapazität, asynchroner Verarbeitung, Observability und realistischem Load-Testing ab.
Für einen umfassenderen Blick auf Architektur und UX im Online-Handel lesen Sie unseren Leitfaden zu Ecommerce-Entwicklungsdienstleistungen.
Kernaussagen
- Headless Ecommerce trennt das Storefront von den Backend-Commerce-Funktionen, sodass jede Schicht unabhängiger skalieren und sich weiterentwickeln kann.
- Ein gängiger Referenz-Stack kombiniert React, ein Node.js/GraphQL-BFF, ein Commerce-Engine und AWS-Serverless-Services für asynchrone Workloads.
- Schnelle Storefronts hängen von Rendering-Strategie, CDN-Caching, API-Design und Downstream-Performance ab – nicht nur von React.
- Der Checkout sollte den synchronen Pfad klein halten, während geeignete Aufgaben nach der Bestellung in ereignisgesteuerte Verarbeitung wechseln.
- High-Traffic-Commerce erfordert Idempotenz, Queues, Backpressure, Inventarkonsistenz und Kapazitätsplanung, die über einfaches Auto-Scaling hinausgeht.
- AI-Personalisierung sollte ein Latenzbudget und ein Fallback-Verhalten haben, damit sie nie zur kritischen Storefront-Abhängigkeit wird.
Was eine Headless-Ecommerce-Architektur für hohen Traffic lösen muss
Vereinfacht gesagt trennt Headless Ecommerce das Kundenerlebnis von der Backend-Commerce-Plattform.
In einem traditionellen Ecommerce-System können Präsentation, Kataloglogik, Checkout, Plugins und Backend-Workflows in derselben Anwendung liegen. Das funktioniert gut, bis verschiedene Teile des Systems unabhängig skalieren, releasen oder sich ändern müssen.
Mit einer Headless-Architektur kommuniziert ein React-Storefront, eine mobile App, eine Marketplace-Oberfläche oder ein anderes Frontend über APIs mit den Commerce-Funktionen.
Das schafft klarere Grenzen zwischen:
- Kundenerlebnis
- Katalog und Preisen
- Warenkorb und Checkout
- Bestellabwicklung
- Inventar
- Suche
- Personalisierung
- Drittanbieter-Integrationen
Headless und Composable Commerce sind verwandt, aber nicht identisch.
Headless Commerce trennt primär die Präsentationsschicht vom Backend. Composable Commerce geht weiter und behandelt Funktionen wie Suche, Zahlung, Promotions, Content und Checkout als modulare Komponenten, die unabhängig ersetzt oder weiterentwickelt werden können.
Die MACH-Prinzipien beschreiben diesen breiteren Ansatz rund um Modularität, APIs, Cloud-Native-Delivery und Headless-Präsentation.
Für High-Traffic-Marken sollte die Architektur mit Workload-Anforderungen beginnen, nicht mit einem bevorzugten Technologie-Stack.
Statt zu sagen: „Das System muss 100.000 gleichzeitige Nutzer bewältigen.“
Sollten Teams dieses Ziel in messbare Merkmale übersetzen:
- Anfragen pro Sekunde
- Verhältnis Browsing zu Checkout
- API-Aufrufe pro Customer Journey
- Cache-Hit-Rate
- geografische Verteilung
- Spitzenlastdauer
- Limits der Downstream-APIs
Hunderttausend Menschen, die gecachte Katalogseiten ansehen, sind etwas völlig anderes als hunderttausend Kunden, die gleichzeitig begrenztes Inventar reservieren und Zahlungen absenden wollen.
Fehlergrenzen sind ebenfalls wichtig.
Wenn der Empfehlungsservice ausfällt, sollten Kunden weiterhin Produkte durchsuchen können? Wenn die CRM-Synchronisation langsamer wird, sollte der Checkout stoppen? Wenn der E-Mail-Anbieter nicht verfügbar ist, sollte eine Bestellung fehlschlagen?
Ein gut konzipiertes Headless-System verhindert, dass optionale Funktionen kritische Commerce-Abläufe mitreißen.
Referenzarchitektur: React, Node.js, GraphQL & AWS Serverless
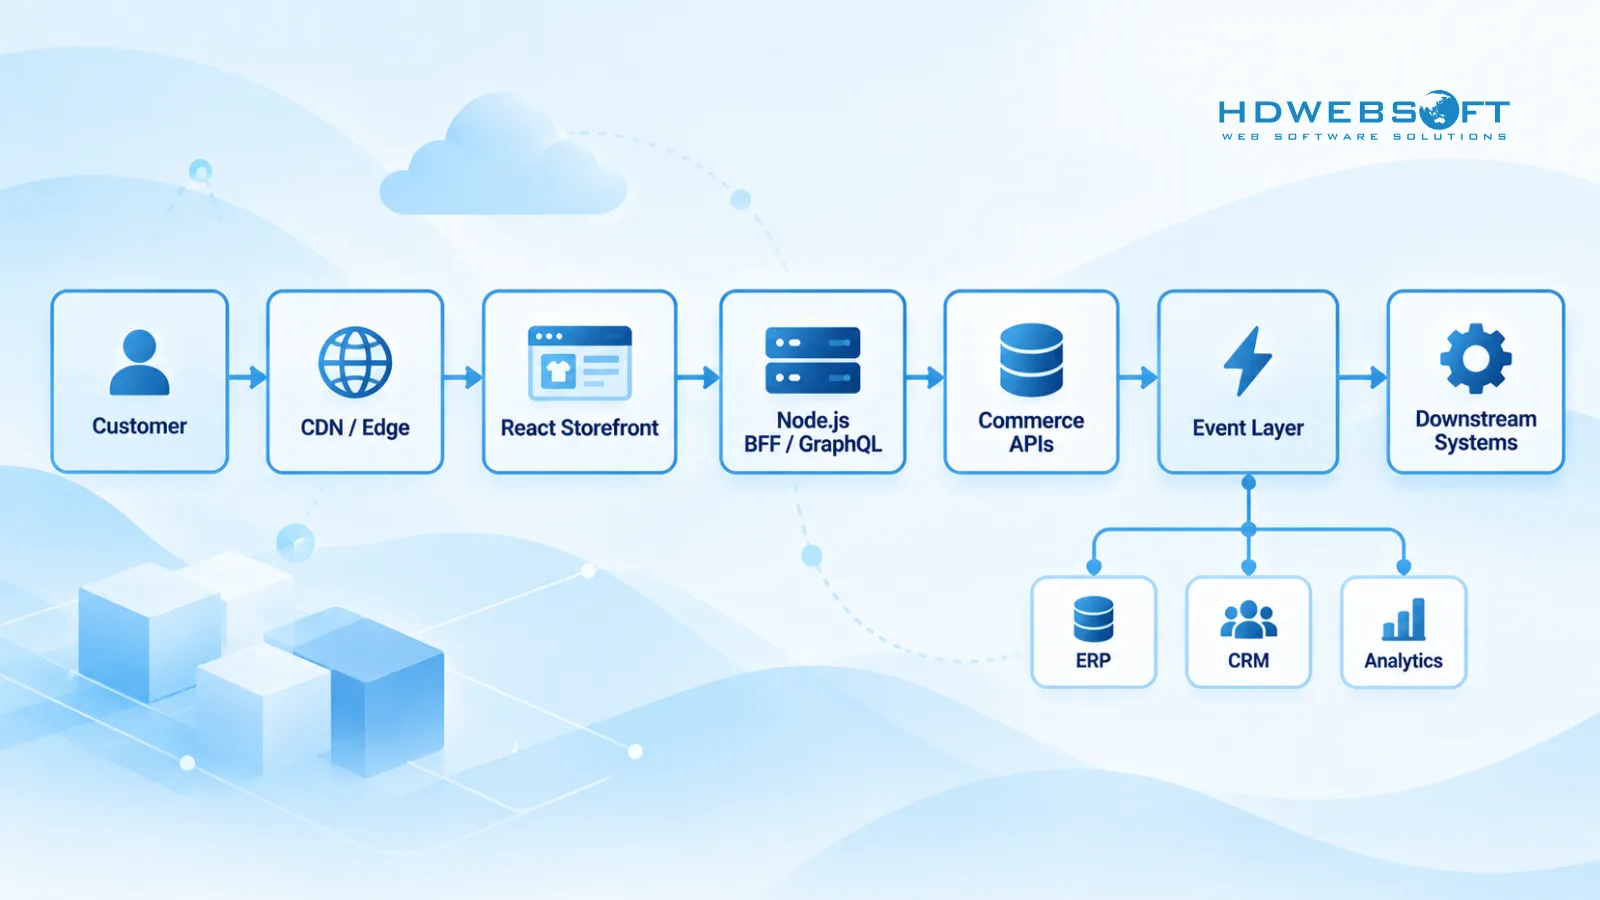
Eine praktische Headless-Ecommerce-Architektur lässt sich so darstellen: Customer → CDN/Edge → React Storefront → Node.js BFF/GraphQL → Commerce APIs → Event Layer → Downstream Systems
Dies ist eine Referenzarchitektur, kein obligatorischer Stack. GraphQL kann durch REST ersetzt werden, Lambda durch Container oder ein eigenes Backend durch eine kommerzielle Headless-Commerce-Plattform.
Wichtig ist, klare Grenzen zu etablieren.
React Storefront und Edge Delivery
React bietet Flexibilität für Produktsuche, Konto, Warenkorb und Checkout-Erlebnisse, aber React allein macht ein Storefront nicht schnell.
Verschiedene Seiten erfordern meist unterschiedliche Rendering-Strategien.
Produkt- und Kategorieseiten können von SSR, statischem oder inkrementellem Rendering und CDN-Caching profitieren. Warenkorb-, Konto- und Checkout-Seiten hängen stärker von kundenspezifischen Daten ab und haben daher ein geringeres Shared-Cache-Potenzial.
High-Traffic-Storefronts sollten außerdem berücksichtigen:
- CDN- und Edge-Caching
- optimierte Bilder und statische Assets
- Stale-While-Revalidate-Muster
- Cache-Invalidierung für Katalog und Preise
- Cache-Keys nach Locale, Währung und Region
Personalisierung bringt eine zusätzliche Herausforderung. Wenn jede Antwort vollständig einzigartig wird, sinkt die Cache-Effizienz dramatisch.
Eine bessere Architektur hält den Großteil der Seite cachebar, während ausgewählte personalisierte Komponenten separat geladen werden.
Node.js BFF und GraphQL
Ein Storefront, das direkt mit vielen Backend-Services verbunden ist, kann schnell einen API-Waterfall erzeugen.
Eine einzelne Produktseite benötigt möglicherweise Daten aus Katalog, Preisen, Inventar, Promotions, CMS, Bewertungen und Empfehlungen.
Ein Backend-for-Frontend (BFF) schafft eine dedizierte Grenze zur Aggregation dieser Services.
Ein Node.js-BFF kann übernehmen:
- API-Aggregation
- Authentifizierung und Sessions
- Response-Transformation
- Timeouts
- Fallback-Verhalten
- Fehler-Normalisierung
GraphQL kann einen flexiblen Vertrag zwischen Storefront und BFF bieten, muss aber sorgfältig designt werden.
Schlechtes Resolver-Design kann N+1-Requests oder sequenzielle Backend-Aufrufe erzeugen. Produktionssysteme benötigen daher möglicherweise Batching, Query-Complexity-Limits, Caching, Persisted Queries und strikte Timeout-Budgets.
Das BFF sollte außerdem verhindern, dass optionale Services die Gesamtlatenz der Seite bestimmen. Wenn eine Empfehlungs-API langsam ist, sollte die Produktseite in der Regel ohne endloses Warten weiter rendern.
Commerce Engine und Event Layer
Das Commerce-Engine bleibt für verbindliche Geschäftsregeln verantwortlich, etwa:
- Katalog
- Preise
- Promotions
- Warenkorb
- Checkout
- Inventar
- Bestellungen
Das Storefront kann die Präsentation optimieren, aber geschäftskritische Regeln sollten hinter kontrollierten APIs bleiben.
Für asynchrone Workflows können AWS-Services eine weitere Entkopplungsebene bieten.
Ein typischer Flow: OrderCreated → EventBridge / SQS → Lambda → ERP / CRM / Fulfillment / Analytics
EventBridge kann ein Geschäftsereignis an mehrere Consumer routen, während SQS Workloads puffert, wenn Consumer Ereignisse nicht in der Rate verarbeiten können, in der sie erzeugt werden.
Diese Architektur folgt den breiteren Prinzipien der Cloud-nativen Infrastruktur, indem Komponenten nach ihrem eigenen Workload skalieren können.
Organisationen, die stark auf Amazon-Infrastruktur setzen, können zudem die AWS-Entwicklungsdienste von HDWEBSOFT für Cloud-Architektur, Serverless-Entwicklung, Migration und DevOps prüfen.
Serverless ist nicht automatisch die richtige Wahl für jede Komponente. Anhaltende Hochdurchsatz-Workloads oder Services mit komplexen Verbindungsanforderungen profitieren möglicherweise weiterhin von Containern oder hybriden Architekturen.
Echtzeit-Checkout und Bestellabwicklung im großen Maßstab
Hoher Traffic erzeugt das größte Risiko dort, wo Geschwindigkeit und Transaktionskorrektheit aufeinandertreffen.
Browsing-Seiten tolerieren oft Caching oder leicht veraltete Daten. Der Checkout toleriert keine Doppelbelastungen, Doppelbestellungen oder den Überverkauf begrenzten Inventars.
Der synchrone Checkout-Pfad sollte daher fokussiert bleiben.
Ein typischer kritischer Pfad: Warenkorb validieren → aktuelle Preise bestätigen → Inventar reservieren → Zahlung autorisieren → Bestellung anlegen
Sobald die dauerhafte Bestellung existiert, können viele weitere Workflows asynchron ablaufen:
- Bestätigungs-E-Mail
- CRM-Synchronisation
- ERP-Updates
- Analytics
- Loyalty-Updates
- Marketing-Events
- Empfehlungs-Feedback
So verhindern Sie, dass unkritische Integrationen die Checkout-Zeit des Kunden verlängern.
Der AWS-Leitfaden zur Integration von Microservices mit Serverless-Services beschreibt Muster für asynchrone Kommunikation, Event-Routing und Queue-basierte Verarbeitung.
Idempotenz und Retry-Sicherheit
Retries sind in verteilten Ecommerce-Systemen normal. Ein Kunde kann zweimal auf Checkout klicken. Ein Netzwerk-Timeout kann den Browser zum Retry veranlassen. Zahlungsanbieter senden Webhooks möglicherweise erneut. Queue-Consumer erhalten dasselbe Event unter Umständen mehrfach. Die Anwendung sollte daher so konzipiert sein, dass die Wiederholung derselben Anfrage nicht dieselbe Geschäftsaktion wiederholt. Ein Idempotenzschlüssel kann mehrere identische Checkout-Übermittlungen einer bestehenden Transaktion zuordnen, statt mehrere Bestellungen zu erzeugen.
Dasselbe Prinzip gilt für Hintergrund-Worker. Auch Retries sollten kontrolliert werden. Temporäre Fehler können einen Retry mit Backoff rechtfertigen, ungültige Daten sollten jedoch nicht endlos wiederholt werden. Fehlgeschlagene Events können schließlich zur Untersuchung in eine Dead-Letter-Queue verschoben werden.
Backpressure und Downstream-Limits
Jeden Service aggressiv auto-zu-skalieren garantiert keine Stabilität. Stellen Sie sich einen Flash Sale vor, der Tausende Bestellereignisse erzeugt, während eine ERP-Integration nur eine begrenzte Zahl von Anfragen pro Sekunde verarbeiten kann. Wenn jede Bestellung sofort einen ERP-Aufruf auslöst, wird das Downstream-System zum Engpass. Eine Queue absorbiert die Spitze und lässt den Consumer mit einer nachhaltigen Rate arbeiten. Das ist Backpressure: langsamere Systeme schützen, statt sie von der Skalierbarkeit im Upstream überrollen zu lassen.
Inventarkonsistenz
Inventar ist eine weitere Herausforderung bei hohem Traffic. Wenn nur noch ein Produkt verfügbar ist und 20 Kunden gleichzeitig den Checkout versuchen, darf nicht jede Anfrage unabhängig „1 verfügbar“ lesen und erfolgreich kaufen. Das verbindliche Inventarsystem benötigt möglicherweise atomare Reservierungen, bedingte Updates oder optimistische Nebenläufigkeitskontrolle. Reservierungen können zudem verfallen, wenn die Zahlung fehlschlägt oder der Checkout abgebrochen wird. Das genaue Konsistenzmodell hängt vom Geschäft ab. Limitierte Produkte erfordern strengere Kontrollen als Inventar, das sich leicht auffüllen lässt.
Performance- & Skalierbarkeits-Engineering für Flash Sales
Headless-Architektur schafft nützliche Skalierungsgrenzen, aber diese Grenzen müssen dennoch entworfen und getestet werden.
Große Nachfragespitzen im Handel machen das besonders wichtig.
Adobe meldete, dass US-Verbraucher in der Weihnachtssaison 2025 online 257,8 Milliarden US-Dollar ausgaben; an 25 einzelnen Tagen wurden jeweils mehr als 4 Milliarden US-Dollar online ausgegeben, gegenüber 18 solchen Tagen im Vorjahr. Die Analyse umfasste über eine Billion Besuche auf US-Einzelhandelsseiten. Siehe den Adobe-Analytics-Bericht zur Holiday-Ecommerce-Saison 2026.
Die Konsequenz ist nicht, dass jede Ecommerce-Plattform dieselbe Kapazität braucht. Vielmehr können Traffic-Spitzen während einer Kampagne oder Shopping-Saison wiederholt auftreten – nicht nur bei einem einzelnen Ereignis.
Ein Latenzbudget aufstellen
Performance sollte über die gesamte Anfragekette gemessen werden: CDN → React-Rendering → BFF → Commerce-APIs → optionale Personalisierung
Frontend-Optimierung kann einen Backend-API-Waterfall, der mehrere Sekunden hinzufügt, nicht kompensieren.
Verschiedene Customer Journeys erfordern auch unterschiedliche Performance-Erwartungen.
Produkt-Browsing ist latenzsensibel und cachefreundlich. Der Checkout darf länger dauern, da Zahlung und Inventar bestätigt werden müssen. Die Bestellabwicklung im Hintergrund toleriert oft Sekunden oder Minuten.
Ein Latenzbudget hilft Teams, jeder Schicht eine akzeptable Zeit zuzuweisen, statt blind zu optimieren.
Auf der richtigen Ebene cachen
Headless Commerce nutzt oft mehrere Caches:
- CDN- und Page-Cache
- API-Cache
- Katalog-/Such-Cache
- GraphQL- oder Objekt-Cache
- Empfehlungs-Cache
Die Schlüsselfrage ist die Frische.
Produktbeschreibungen können länger gecacht bleiben als Aktionspreise. Beim Browsen angezeigtes Inventar toleriert kurze Veraltung, während Inventar beim Checkout gegen die verbindliche Quelle verifiziert werden muss.
Eine korrekte Cache-Policy reduziert die Backend-Last, ohne die Transaktionsgenauigkeit zu gefährden.
Die gesamte Abhängigkeitskette skalieren
Lambda kann schnell skalieren, andere Abhängigkeiten möglicherweise nicht.
Mögliche Engpässe:
- Datenbankverbindungen
- Quotas der Zahlungsanbieter
- Limits der Commerce-Plattform
- ERP-Durchsatz
- Drittanbieter-APIs
- Inventarsysteme
Das heißt: Auto-Scaling von Compute skaliert nicht automatisch das ganze System.
Concurrency-Limits, Queueing, Datenbankverbindungs-Management und Rate-Limits von Drittanbietern gehören alle in die Kapazitätsplanung.
Produktionsteams sollten außerdem p95- und p99-Latenzen überwachen, nicht nur Durchschnittswerte.
Nützliche High-Traffic-Metriken:
- TTFB / LCP
- p95/p99-Latenz des BFF
- Checkout-Abschlusszeit
- API-Fehlerrate
- Cache-Hit-Rate
- Queue-Tiefe und Queue-Alter
- Zahlungsfehler
- Verzögerung der Bestellabwicklung
Diese Metriken verbinden Infrastrukturverhalten mit dem Kundenerlebnis.
AI-Personalisierung ohne Verlangsamung der Commerce-Journey
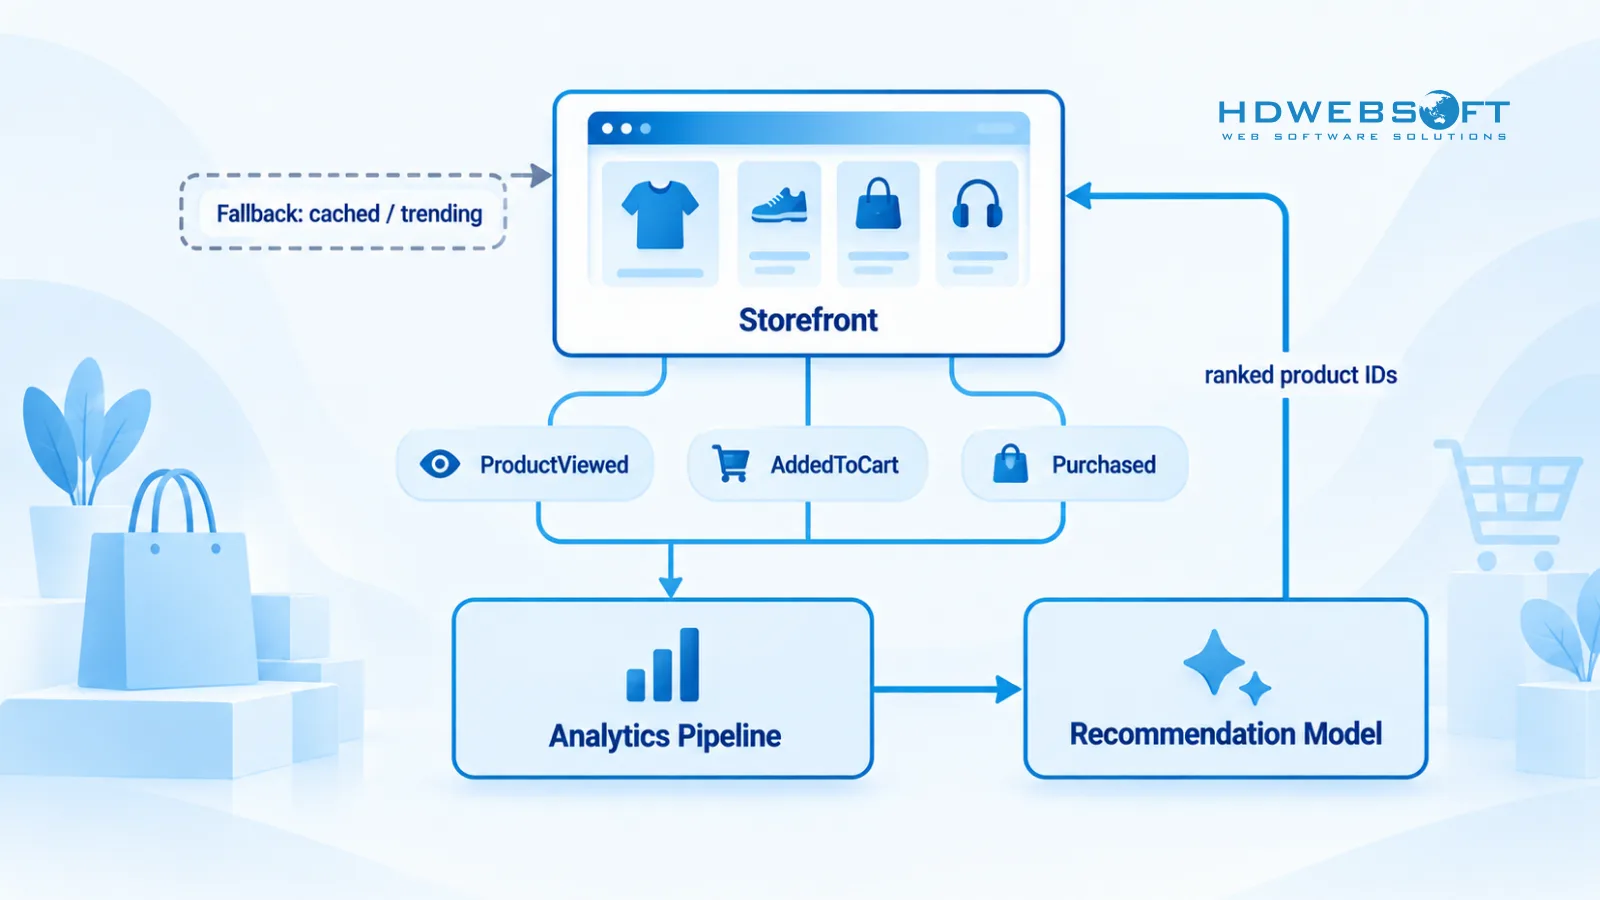
Headless-Architektur erleichtert es, Personalisierung von der Kernfunktion des Commerce zu isolieren.
Statt Empfehlungslogik im Storefront oder Commerce-Engine einzubetten, können Unternehmen Empfehlungen als unabhängigen Service bereitstellen.
Dieser Service kann nutzen:
- Browsing-Verlauf
- Kaufverhalten
- Katalogdaten
- Kundenpräferenzen
- Produktbeziehungen
- Inventarsignale
Die Ausgabe kann schlicht eine Liste bewerteter Produkt-IDs oder Angebote sein, die über eine API zurückgegeben werden.
Das Storefront muss nicht wissen, wie das zugrunde liegende Modell funktioniert.
AI außerhalb des kritischen Pfads halten
AI-Empfehlungen sollten die Shopping-Journey verbessern, nicht darüber entscheiden, ob sie funktioniert.
Wird eine Empfehlungs-API langsam, sollten Produktseiten in der Regel weiter rendern.
Die Architektur kann ein Latenzbudget und Fallback-Verhalten definieren, etwa:
- gecachte Empfehlungen
- Trending-Produkte
- Kategorie-Bestseller
- regelbasierte Alternativen
Ebenso dürfen Modellfehler oder ungültige Empfehlungen den Checkout nicht beeinträchtigen.
Commerce-Events wie ProductViewed, AddedToCart, SearchPerformed und Purchased können asynchron in Analytics- oder Modell-Pipelines einfließen.
So entsteht eine Feedback-Schleife, ohne AI-Training oder schwere Inferenz direkt in Transaktionsabläufe zu legen.
Für Unternehmen, die individuelle Storefronts, Marktplätze, Empfehlungssysteme und Commerce-Integrationen aufbauen, decken die E-Commerce-Softwareentwicklungsdienste von HDWEBSOFT sowohl zentrale Commerce-Plattformen als auch AI-gestützte Funktionen ab.
Wann sich die Komplexität von Headless Commerce lohnt
Headless-Architektur schafft Flexibilität, aber Flexibilität bringt zusätzliche Services, APIs, Deployments, Monitoring und betriebliche Verantwortung.
Sie sollte daher eine echte Einschränkung lösen.
| Dimension | Traditioneller Monolith | Headless | Composable |
|---|---|---|---|
| Frontend-Unabhängigkeit | Gering | Hoch | Hoch |
| Backend-Modularität | Gering | Variiert | Hoch |
| Unabhängige Skalierung | Begrenzt | Mittel–Hoch | Hoch |
| Multi-Channel-Unterstützung | Gering | Hoch | Hoch |
| Betriebskomplexität | Gering | Mittel | Höher |
| Engineering-Aufwand | Gering | Höher | Am höchsten |
Headless passt eher zu Unternehmen mit:
- mehreren Storefronts oder digitalen Kanälen
- stark angepassten UX-Anforderungen
- komplexen Integrationen
- mehreren Regionen oder Marken
- häufigen Frontend-Releases
- erheblichen Performance- oder Skalierungsanforderungen
Es kann überflüssig sein, wenn:
- der Katalog einfach ist
- Integrationen begrenzt sind
- ein SaaS-Storefront die Anforderungen bereits erfüllt
- das Engineering-Team klein ist
- die Anpassungsanforderungen gering sind
Die richtige Frage lautet nicht: „Ist Headless moderner?“ Sondern: „Welche geschäftliche oder architektonische Einschränkung beseitigt Headless?“
Wie HDWEBSOFT Ecommerce-Architektur angeht
Bei bestehenden Ecommerce-Systemen sollte die Modernisierung beim aktuellen Engpass beginnen, nicht bei einem vorab festgelegten Stack.
Ein praktischer Prozess:
- Architektur-Assessment — Traffic-Muster, Integrationen, Performance-Engpässe, Datenflüsse und Fehlerpunkte prüfen.
- Grenzen definieren — Festlegen, welche Frontend-, Commerce-, Integrations- oder Hintergrund-Workloads wirklich unabhängige Skalierung brauchen.
- Performance validieren — Kritische Customer Journeys und Downstream-Services per Load-Test prüfen.
- Inkrementell ausrollen — Komponenten dort trennen, wo messbarer Mehrwert entsteht, statt die gesamte Plattform in einem Schritt zu ersetzen.
Die Fallstudie „Salesforce Integration to an All-in-One Seller Workspace“ von HDWEBSOFT zeigt die Integrationsseite des Enterprise-Ecommerce. Das Projekt umfasste die bidirektionale Synchronisation zwischen Lightspeed POS und Salesforce für Inventar-, Kunden- und Bestelldaten.
Der Fall stellt nicht exakt die hier beschriebene React–Node.js–AWS-Referenzarchitektur dar. Seine Relevanz liegt in der breiteren Integrationsherausforderung: Enterprise-Ecommerce-Plattformen operieren selten allein. Commerce-Daten müssen oft zuverlässig zwischen POS, CRM, Inventar, Fulfillment, Buchhaltung und anderen Systemen fließen.
Fazit
Skalierbarkeit im Headless Ecommerce bedeutet nicht, einen Monolithen durch möglichst viele moderne Technologien zu ersetzen.
Ziel ist es, klare Grenzen zu schaffen, damit Storefront, Commerce-Transaktionen, asynchrone Workloads, Integrationen und optionale Services wie AI jeweils nach ihren eigenen Anforderungen skalieren und ausfallen können.
React bietet Frontend-Flexibilität. Node.js und GraphQL schaffen eine kontrollierte Storefront-API-Schicht. AWS-Serverless-Services unterstützen ereignisgesteuerte Workloads. Doch der Erfolg in der Produktion hängt weiterhin von Caching, Latenzbudgets, Idempotenz, Backpressure, Inventarkonsistenz, Observability und realistischem Load-Testing ab.
Planen Sie eine Headless-Ecommerce-Plattform oder bereiten Sie einen bestehenden Shop auf höheren Traffic vor? Kontaktieren Sie HDWEBSOFT, um über Ihre Architektur- und Skalierungsanforderungen zu sprechen.
Häufige Fragen
Was ist eine Headless-Ecommerce-Architektur?
Headless Ecommerce trennt das kundenseitige Storefront vom Backend-Commerce-Engine. Das Frontend kommuniziert über APIs mit Katalog, Preisen, Warenkorb, Checkout, Inventar und weiteren Services.
Welche Rolle spielen React und Node.js im Headless Ecommerce?
React kann das Storefront antreiben, während Node.js eine Backend-for-Frontend-Schicht bereitstellt, die Commerce-APIs aggregiert, Authentifizierung verwaltet, Timeouts steuert und für das Frontend optimierte REST- oder GraphQL-Schnittstellen bereitstellt.
Kann Headless Ecommerce Flash Sales mit hohem Traffic bewältigen?
Ja, aber eine Headless-Architektur allein garantiert keine Skalierbarkeit. Die Performance hängt auch von Caching, API-Kapazität, Datenbanklimits, Zahlungsanbietern, Inventarkontrolle, Queues und Downstream-Integrationen ab.
Was ist der Unterschied zwischen Headless und Composable Commerce?
Headless trennt primär die Frontend-Präsentation vom Backend. Composable Commerce zerlegt darüber hinaus Geschäftsfunktionen in modulare Komponenten, die unabhängig ausgewählt und weiterentwickelt werden können.
Warum AWS-Serverless-Services für Ecommerce nutzen?
AWS Lambda, EventBridge und SQS unterstützen ereignisgesteuerte Workloads, Hintergrundverarbeitung, Traffic-Pufferung und unabhängige Skalierung. Für manche Dauerlasten können Container oder hybride Infrastruktur jedoch besser geeignet sein.
Wie lässt sich AI-Personalisierung ohne Verlangsamung des Storefronts einbauen?
Empfehlungen als unabhängigen Service mit Latenzbudget und Fallback-Verhalten behandeln. Wenn der AI-Service langsam oder nicht verfügbar ist, kann das Storefront zwischengespeicherte, beliebte oder regelbasierte Empfehlungen ausgeben.
