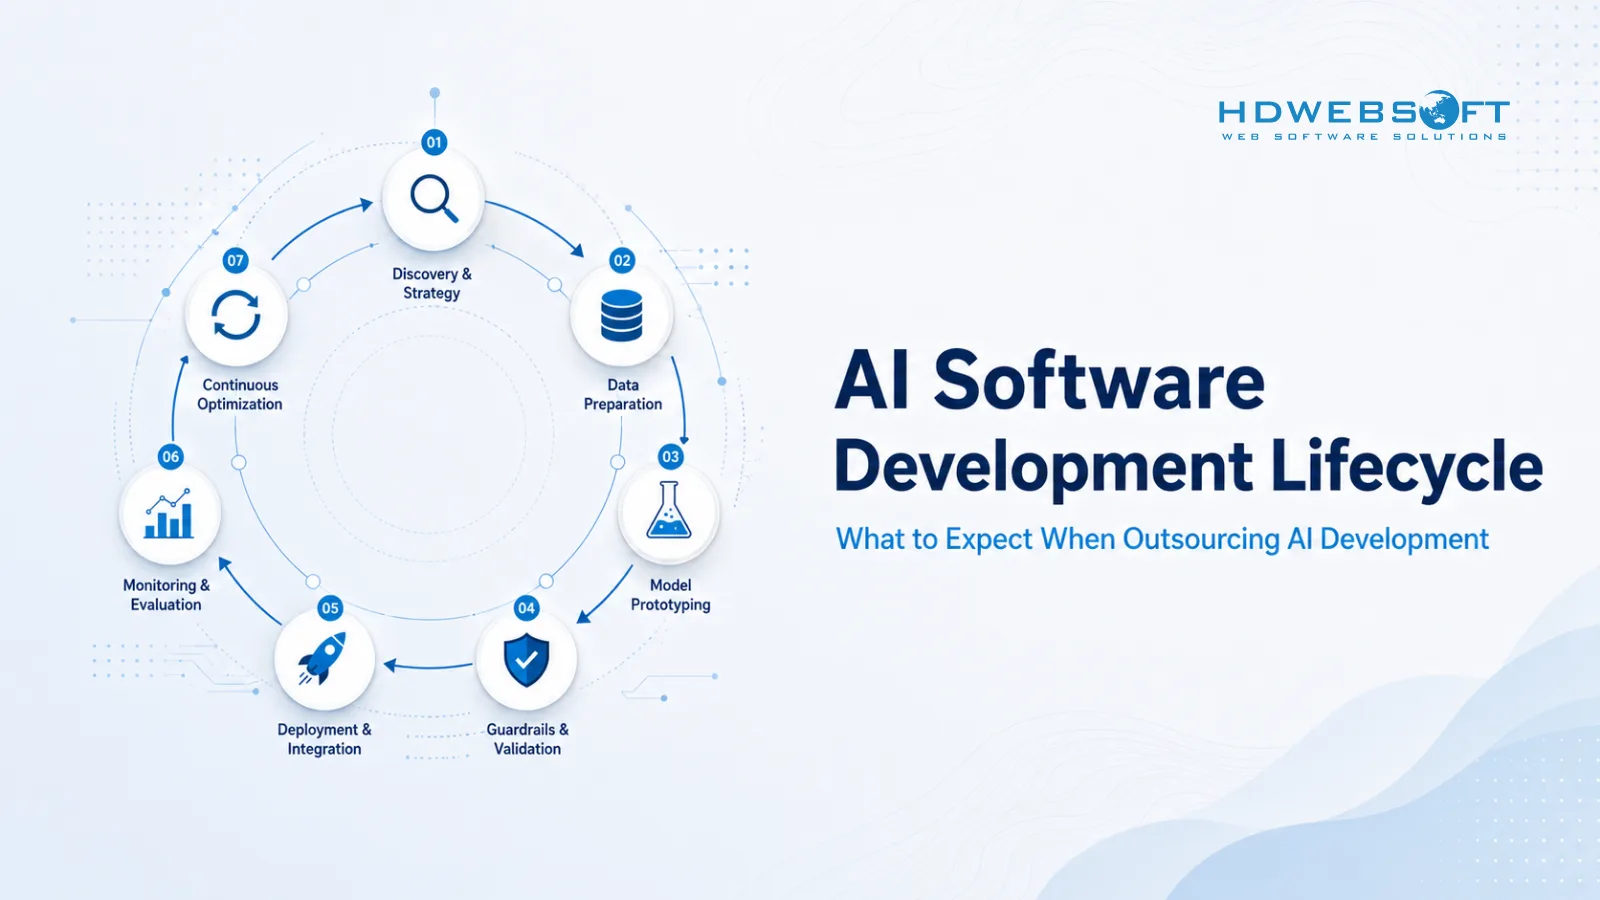
AI software development lifecycle เป็นกระบวนการแบบ end-to-end สำหรับสร้าง deploy และบำรุงรักษาระบบ AI ต่างจากการพัฒนาซอฟต์แวร์แบบดั้งเดิมตรงที่เพิ่ม data readiness, model evaluation, guardrails, observability และการ retraining อย่างต่อเนื่องไว้เป็นขั้นตอนหลัก ไม่ใช่ส่วนเสริมที่เลือกทำได้ เมื่อคุณ outsource การพัฒนา AI การเข้าใจ lifecycle นี้ช่วยแยกพันธมิตรที่ส่งมอบระบบ production ได้จริง ออกจากพันธมิตรที่ส่งเพียง demo ซึ่งไม่สามารถขยายผลได้
คู่มือนี้อธิบายเจ็ดขั้นตอนของ AI software development lifecycle จากมุมมองของการ outsourcing ตั้งแต่สิ่งที่พันธมิตรทำ สิ่งที่คุณต้องจัดเตรียม Deliverables ที่ควรได้รับ ไปจนถึงจุดที่ต้องตัดสินใจ go/no-go นอกจากนี้ยังครอบคลุมความเป็นเจ้าของ AI acceptance criteria การส่งมอบระบบ และการเลือก engagement model ให้เหมาะกับความไม่แน่นอนของโครงการ สำหรับสถาปัตยกรรมของ guardrails และ observability ดูคู่มือหลักของเราเรื่อง agentic AI in production
สรุปประเด็นสำคัญ
- AI SDLC เพิ่ม data readiness, model evaluation, guardrails, monitoring และการเพิ่มประสิทธิภาพอย่างต่อเนื่องจากการส่งมอบซอฟต์แวร์แบบดั้งเดิม
- แต่ละขั้นตอนต้องมี Deliverables ที่เป็นรูปธรรมและจุดตรวจสอบการอนุมัติ ลูกค้าไม่ควรโอนความรับผิดชอบทั้งหมด แต่ต้องมีส่วนร่วมในการตัดสินใจทางธุรกิจ การเข้าถึงข้อมูล และการยอมรับ production
- การยอมรับ AI อิงจาก quality thresholds และขอบเขตความล้มเหลวที่ยอมรับได้ ไม่ใช่ผลลัพธ์ที่สมบูรณ์แบบ ทั้งสองเรื่องต้องกำหนดร่วมกับพันธมิตรก่อนเริ่มพัฒนา
- ความเป็นเจ้าของต้องชัดเจนตั้งแต่วันแรก ลูกค้าเป็นเจ้าของการตัดสินใจด้านธุรกิจ domain และข้อมูล พันธมิตรเป็นเจ้าของ technical execution ส่วนขอบเขต การประเมิน และการยอมรับ production ต้องได้รับการอนุมัติร่วมกัน
- engagement model ควรสอดคล้องกับความไม่แน่นอนของโครงการและความสามารถภายใน: project-based สำหรับ outcomes ที่ชัดเจน dedicated team สำหรับงานที่เน้น R&D และ hybrid สำหรับการส่งมอบที่พันธมิตรนำก่อนวางแผนโอนงานให้ทีมภายใน
ทำไม AI SDLC จึงแตกต่างจากการพัฒนาซอฟต์แวร์แบบดั้งเดิม
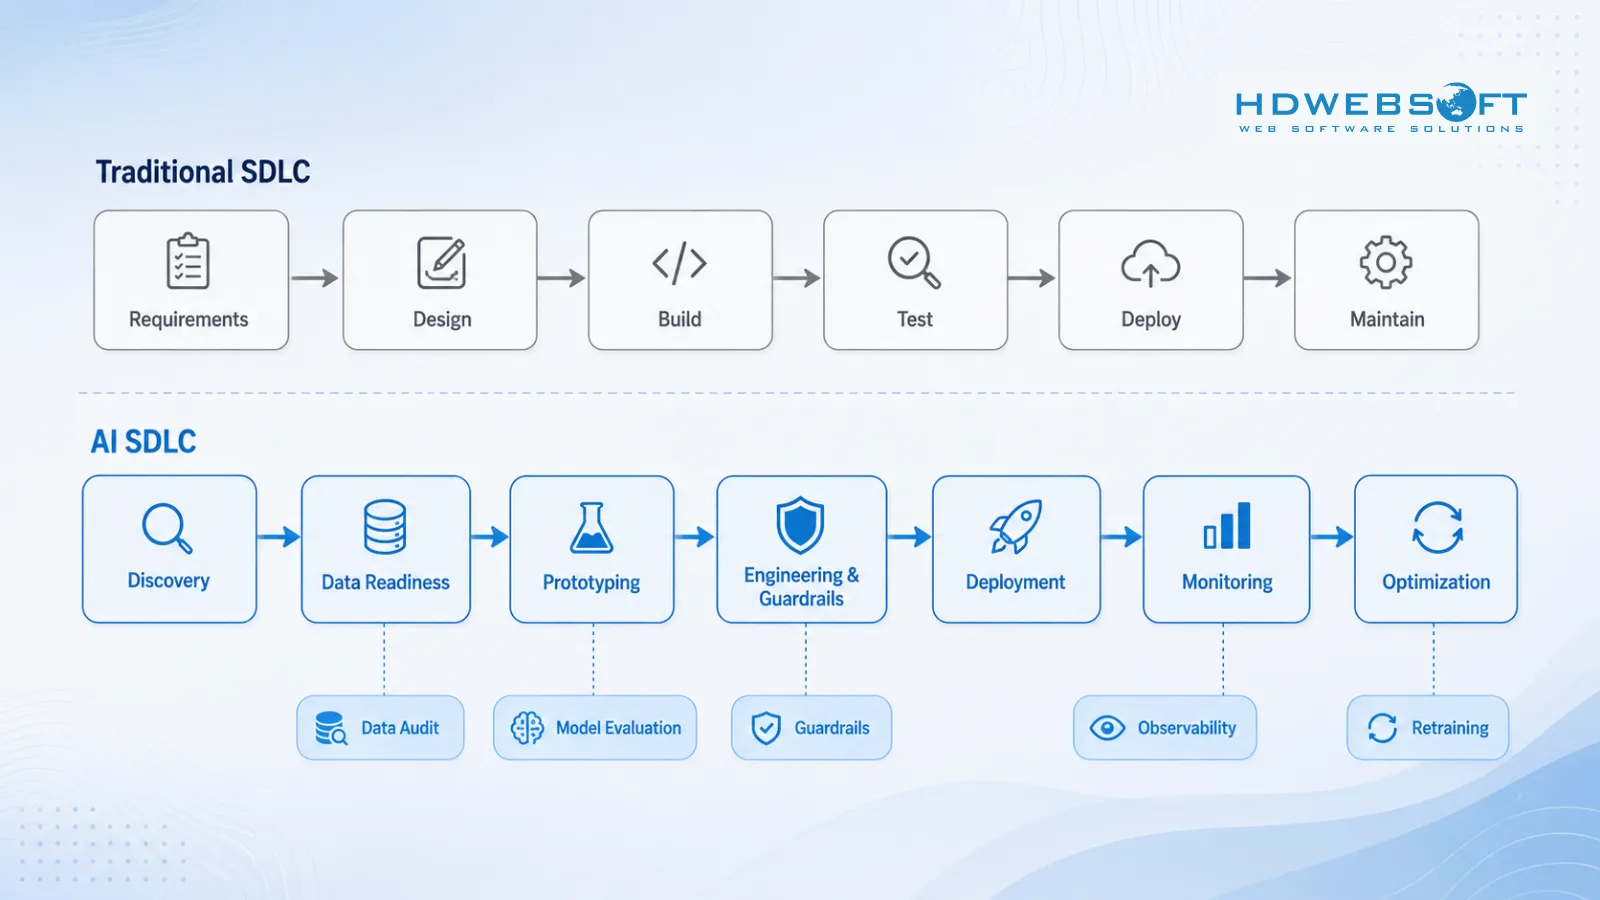
การพัฒนาซอฟต์แวร์แบบดั้งเดิมเป็นไปตามวงจรที่คุ้นเคย ได้แก่ requirements, design, build, test, deploy และ maintain โค้ดมีพฤติกรรมแบบ deterministic unit test จึงผ่านหรือไม่ผ่าน เมื่อฟีเจอร์ทำงานแล้วก็มักทำงานต่อไปจนกว่าจะมีการเปลี่ยนแปลง กระบวนการพัฒนา AI ทำให้วงจรนี้ซับซ้อนขึ้น
AI เปลี่ยนรูปแบบดังกล่าว เพราะผลลัพธ์เป็น probabilistic อินพุตเดียวกันอาจให้ผลลัพธ์ต่างกันได้ โมเดลที่ทำงานได้ดีในการทดสอบอาจมีประสิทธิภาพลดลงใน production เมื่อข้อมูลเปลี่ยนแปลง นี่คือเหตุผลที่ AI software development lifecycle ต้องเพิ่มขั้นตอนและกิจกรรมที่ SDLC แบบดั้งเดิมไม่จำเป็นต้องมี และเหตุใดการ outsourcing AI จึงต้องกำหนดความคาดหวังต่างออกไป
การพึ่งพาข้อมูลและ Output แบบ Probabilistic
ระบบ AI พึ่งพาข้อมูลในทุกขั้นตอน ได้แก่ training, evaluation และ production โมเดลจะดีได้เท่ากับข้อมูลที่ใช้ฝึก และผลลัพธ์เป็นความน่าจะเป็น ไม่ใช่ความแน่นอน ไม่มี assertion-style test ที่พิสูจน์ได้ว่าโมเดล “ถูกต้อง” ในทุกกรณี แต่ทีมจะสร้าง evaluation harnesses เพื่อวัดประสิทธิภาพจากชุดข้อมูลที่เป็นตัวแทน NIST AI Risk Management Framework ให้แนวทางที่เชื่อถือได้สำหรับจัดการความเสี่ยงเหล่านี้ตลอด lifecycle
ดังนั้น lifecycle ต้องมีขั้นตอน data readiness ก่อนเริ่มงานโมเดล และมีขั้นตอน evaluation ที่ทำงานอย่างต่อเนื่อง ไม่ใช่ทำเฉพาะก่อนเปิดตัว
การประเมินโมเดล Guardrails และ Monitoring
เนื่องจากผลลัพธ์ของ AI เป็น probabilistic การประเมินจึงไม่เคยหยุด ทีมต้องมี guardrails เช่น จุดตรวจสอบโดยมนุษย์ กลไก fail-safe และการตรวจจับอคติ เพื่อให้ระบบปลอดภัยใน production นอกจากนี้ยังต้องมี monitoring ที่ติดตามทั้งสุขภาพของระบบและพฤติกรรมของโมเดล เพราะประสิทธิภาพโมเดลอาจลดลงโดยไม่เกิด error แม้แต่รายการเดียว
สิ่งเหล่านี้เป็นข้อกำหนดของ production ไม่ใช่สิ่งที่มีไว้ทำก็ดีไม่ทำก็ได้ ช่องว่างระหว่าง pilot ที่ประสบความสำเร็จกับระบบ production ที่เสถียร มักอยู่ที่ guardrails และ observability ไม่ใช่คุณภาพของโมเดล
Data Drift การลดลงของโมเดลและการเพิ่มประสิทธิภาพอย่างต่อเนื่อง
โมเดล AI มีประสิทธิภาพลดลงเมื่อเวลาผ่านไป ข้อมูลที่โมเดลพบใน production อาจเปลี่ยนจากข้อมูลที่ใช้ฝึก (data drift) และความสัมพันธ์ระหว่าง input กับ output อาจเปลี่ยนไป (concept drift) โมเดลที่มี accuracy 95% ตอนเปิดตัวอาจลดลงเหลือ 80% ในอีกหกเดือนต่อมา แม้ไม่มีการเปลี่ยนโค้ด
นี่คือเหตุผลที่ AI software development lifecycle ไม่สิ้นสุดที่ deployment การเพิ่มประสิทธิภาพและการ retraining อย่างต่อเนื่องเป็นขั้นตอนที่ฝังอยู่ใน lifecycle ไม่ใช่ส่วนเสริมหลังเปิดตัว ซอฟต์แวร์แบบดั้งเดิมไม่ต้อง retrain แต่ AI ต้องทำ ความแตกต่างเพียงข้อนี้ส่งผลต่อระยะเวลา ต้นทุน และความเป็นเจ้าของ MLOps practices ของ Google อธิบายแนวคิดนี้เป็น continuous pipeline แทนการ deploy เพียงครั้งเดียว
สิ่งที่ต้องตกลงก่อนโครงการ Outsourcing AI เริ่ม
ก่อนเริ่มขั้นตอนใดของ lifecycle ลูกค้าและพันธมิตร outsourcing ต้องตกลงหลักการสำคัญร่วมกัน การข้ามขั้นตอนนี้เป็นหนึ่งในเหตุผลที่พบบ่อยที่สุดที่ทำให้โครงการ AI หยุดชะงักกลางทาง เพราะพันธมิตรอาจสร้างระบบที่ถูกต้องทางเทคนิคแต่ไม่ตรงกับสิ่งที่ธุรกิจต้องการจริง
Business Outcomes และ Success Metrics
โครงการควรเริ่มจาก business outcome ที่วัดผลได้ ไม่ใช่เป้าหมายด้านเทคโนโลยี เช่น “ลดเวลาในการคัดแยกเคสด้วยมือ 30%” เป็น outcome ที่มีประโยชน์ แต่ “สร้าง AI chatbot” ยังไม่ใช่ Success metrics ควรเชื่อมโยงกับผลกระทบทางธุรกิจ ไม่ใช่เฉพาะตัวชี้วัดทางเทคนิคอย่าง accuracy หรือ F1 score เพราะโมเดลที่มี accuracy สูงก็ยังทำให้ธุรกิจล้มเหลวได้ หากเพิ่มประสิทธิภาพให้กับสิ่งที่ไม่ใช่เป้าหมาย
ลูกค้าควรแต่งตั้ง AI champion ซึ่งเป็นผู้มีอำนาจตัดสินใจเรื่อง trade-off ระหว่างขอบเขต ระยะเวลา และคุณภาพ หากไม่มีผู้ตัดสินใจหลักเพียงคนเดียว กระบวนการอนุมัติจะยืดเยื้อและโครงการจะสูญเสียแรงขับเคลื่อน
ความรับผิดชอบด้านข้อมูล การเข้าถึงและการปฏิบัติตามกฎระเบียบ
ทั้งสองฝ่ายต้องระบุรายละเอียดเกี่ยวกับข้อมูลให้ชัดเจน: ปัจจุบันมีข้อมูลอะไรบ้าง ใครเป็นเจ้าของข้อมูล ข้อมูลอยู่ในรูปแบบใด มีการติดป้ายกำกับหรือไม่ มี PII หรือไม่ และใครรับผิดชอบการเก็บหรือติดป้ายกำกับข้อมูลเพิ่มเติมเมื่อพบช่องว่าง
การเข้าถึงระบบก็สำคัญไม่แพ้กัน ลูกค้าต้องจัดเตรียม API credentials, sandbox environments และกำหนดเวลาสำหรับการเข้าถึง production environment ข้อกำหนดด้าน compliance เช่น GDPR, HIPAA, data residency และ audit obligations ควรจัดทำเป็นเอกสารก่อนที่พันธมิตรจะเริ่มเข้าถึงข้อมูล
สิทธิ์การตัดสินใจและการมีส่วนร่วมของลูกค้า
การ outsourcing AI ไม่ได้หมายถึงการ outsourcing การตัดสินใจ ข้อตกลงควรระบุว่าใครมีอำนาจตัดสินใจเรื่องใดในแต่ละขั้นตอน การตัดสินใจทางเทคนิคอาจอยู่กับพันธมิตร ส่วนการตัดสินใจด้านธุรกิจและ compliance อยู่กับลูกค้า การเปลี่ยนแปลงขอบเขต evaluation thresholds และการยอมรับ production ต้องได้รับการอนุมัติร่วมกัน
ข้อตกลงควรกำหนดรอบการทบทวน เช่น รายสัปดาห์ รายสองสัปดาห์ หรือ phase-gate รวมถึงช่องทาง escalation เมื่อเกิด blockers
Pilot และ Production Acceptance Criteria
ก่อนเริ่มโครงการต้องกำหนดสองเรื่องให้ชัดเจน คืออะไรนับเป็น pilot completion และอะไรนับเป็น production readiness pilot completion ไม่ใช่แค่ “demo ทำงาน” แต่หมายถึง prototype ผ่าน performance threshold ที่กำหนดจากชุดข้อมูลที่เป็นตัวแทน ส่วน production readiness กว้างกว่า โดยรวม performance threshold, guardrail coverage, observability, incident plan และ cost ceiling
ข้อตกลงควรระบุด้วยว่าใครเป็นผู้อนุมัติการเปลี่ยนจาก pilot ไป production และใครรับผิดชอบการดำเนินงานหลังเปิดตัว รายละเอียดเหล่านี้จะกล่าวถึงเพิ่มเติมในบทความนี้
7 ขั้นตอนของ AI Software Development Lifecycle
เจ็ดขั้นตอนด้านล่างเป็นแกนหลักของ AI software development lifecycle แต่ละขั้นตอนใช้โครงสร้างเดียวกัน ได้แก่ วัตถุประสงค์ กิจกรรมหลัก สิ่งที่พันธมิตรทำ สิ่งที่ลูกค้าจัดเตรียม Deliverables ที่คาดหวัง และจุดตรวจสอบการอนุมัติเมื่อจบขั้นตอน การเข้าใจ AI project phases เหล่านี้จำเป็นต่อการตั้งความคาดหวังที่สมจริงเมื่อ outsourcing การพัฒนา AI
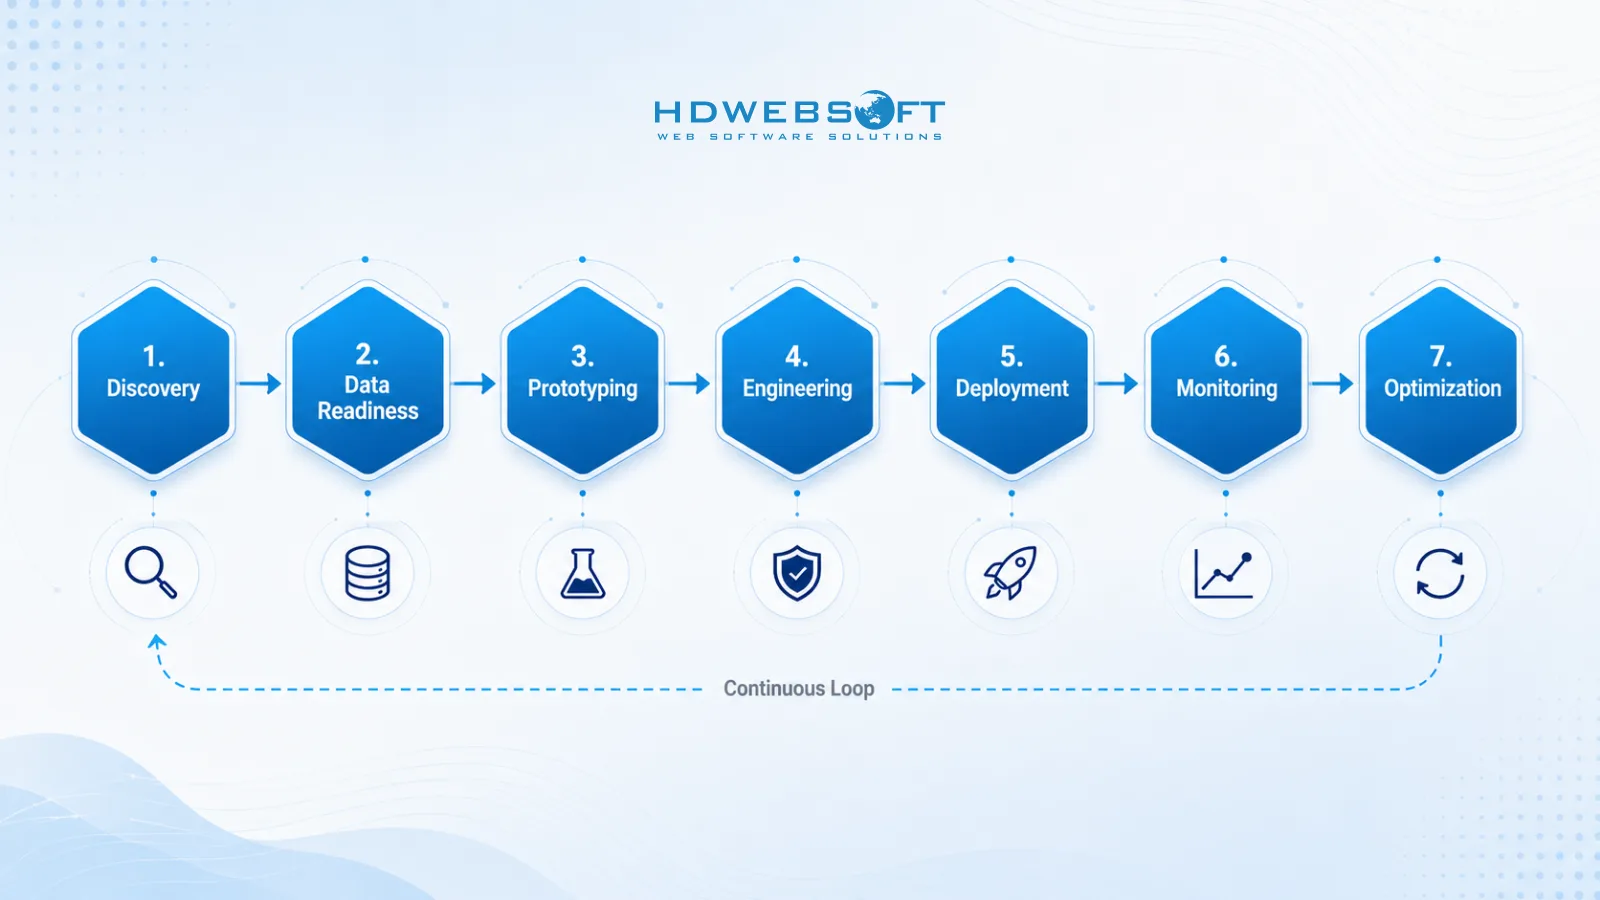
1. Discovery และ Problem Framing
- วัตถุประสงค์: พิจารณาว่าปัญหาจำเป็นต้องใช้ AI จริงหรือไม่ หรือ rule-based solution หรือซอฟต์แวร์แบบดั้งเดิมจะแก้ปัญหาได้ถูกกว่าและเชื่อถือได้มากกว่า
- กิจกรรมหลัก: Problem framing, นิยาม success criteria, feasibility check, ROI hypothesis
- พันธมิตรทำอะไร: ท้าทายสมมติฐานของ use case เสนอทางเลือก จัด discovery workshop และให้คำแนะนำ go/no-go
- ลูกค้าจัดหาอะไร: Business context, workflow ปัจจุบัน, จุดปวด, สรุปข้อมูลที่มี และ success metrics ที่สำคัญต่อธุรกิจ
- Deliverables ที่คาดหวัง: Discovery report, success metrics ที่เสนอ และคำแนะนำ go/no-go
- จุดตรวจสอบการอนุมัติ: ลูกค้าอนุมัติขอบเขตและ success metrics ก่อนเริ่มงานข้อมูล
พันธมิตรที่ตอบรับทุกคำขอ AI โดยไม่ท้าทาย use case ถือเป็นสัญญาณเตือน พันธมิตรที่ดีจะบอกคุณเมื่อ AI ไม่ใช่เครื่องมือที่เหมาะสม
2. Data Readiness และ Feasibility Assessment
- วัตถุประสงค์: พิจารณาว่าข้อมูลที่มีเพียงพอทั้งด้านปริมาณ คุณภาพ และโครงสร้างสำหรับสร้างระบบ AI หรือไม่
- กิจกรรมหลัก: Data audit (ปริมาณ, คุณภาพ, ความครอบคลุมป้ายกำกับ, อคติ), pipeline assessment, compliance check
- พันธมิตรทำอะไร: ดำเนิน data audit ระบุช่องว่าง เสนอ data strategy และสรุปผลการประเมิน feasibility
- ลูกค้าจัดหาอะไร: การเข้าถึงข้อมูล ความรู้ domain เกี่ยวกับความหมายของข้อมูล และข้อจำกัดการปฏิบัติตามกฎระเบียบ
- Deliverables ที่คาดหวัง: Data readiness report, gap list และ data strategy
- จุดตรวจสอบการอนุมัติ: ตัดสินใจ go/no-go จากความเพียงพอของข้อมูล หากข้อมูลขาดหายหรือคุณภาพต่ำ โครงการอาจต้องหยุดเพื่อเก็บหรือติดป้ายกำกับข้อมูลเพิ่มเติมก่อนดำเนินการต่อ
สำหรับกรอบโดยละเอียดเบื้องหลังการประเมินข้อมูล ดู AI data readiness
3. Prototyping และ Model Selection
- วัตถุประสงค์: พิสูจน์ความเป็นไปได้ทางเทคนิคด้วยต้นทุนต่ำ ก่อน commit กับงาน engineering เต็มรูปแบบ
- กิจกรรมหลัก: Model selection (build vs buy vs fine-tune), rapid prototyping, baseline evaluation กับชุดข้อมูลที่เป็นตัวแทน
- พันธมิตรทำอะไร: สร้าง prototype ดำเนิน baseline evaluation และแนะนำแนวทางโมเดล
- ลูกค้าจัดหาอะไร: ข้อมูลตัวอย่าง ข้อเสนอแนะธุรกิจเกี่ยวกับ output ของ prototype และการยอมรับหรือปฏิเสธ baseline
- Deliverables ที่คาดหวัง: Working prototype และ evaluation baseline report
- จุดตรวจสอบการอนุมัติ: ตัดสินใจ go/no-go จากตัวชี้วัด คำถามไม่ใช่ “demo ดูดีไหม” แต่คือ “baseline ผ่าน threshold ที่ตกลงกันไว้ใน discovery หรือไม่”
pilot หลายโครงการหยุดอยู่ที่ขั้นตอนนี้แล้วเรียกว่าเสร็จ แต่ prototype เป็นจุดเริ่มต้น ไม่ใช่ Deliverable สุดท้าย
4. Engineering และ Guardrails Build-Out
- วัตถุประสงค์: เปลี่ยน prototype ให้เป็นระบบ production-grade พร้อมสร้างโครงสร้างความปลอดภัยไว้ในระบบตั้งแต่ต้น
- กิจกรรมหลัก: MLOps setup, guardrail design (human-in-the-loop, fail-safe, bias detection), automated evaluation harness, CI/CD สำหรับ model updates
- พันธมิตรทำอะไร: ออกแบบสถาปัตยกรรม วิศวกรรมระบบ ใช้ guardrails และสร้าง evaluation harness
- ลูกค้าจัดหาอะไร: กฎธุรกิจสำหรับ guardrails (เช่น เมื่อมนุษย์ต้องตรวจสอบการตัดสินใจ AI) และสถานการณ์ UAT
- Deliverables ที่คาดหวัง: Production-ready codebase, guardrail specification และ evaluation harness
- จุดตรวจสอบการอนุมัติ: ตรวจสอบ guardrail coverage และ pass rate ของ evaluation harness ก่อนอนุมัติ deployment
นี่คือขั้นตอนที่มักถูกมองข้ามเมื่อปิดช่องว่างระหว่าง pilot กับ production
5. Integration และ Production Deployment
- วัตถุประสงค์: เชื่อมต่อระบบ AI เข้ากับ stack เดิมของลูกค้า และ deploy อย่างเป็นระบบและควบคุมได้
- กิจกรรมหลัก: API integration, canary หรือ blue-green rollout, monitoring setup, incident response plan
- พันธมิตรทำอะไร: จัดการ integration engineering, deployment orchestration และ monitoring configuration
- ลูกค้าจัดหาอะไร: การเข้าถึงระบบ production, integration points และ sign-off บน production readiness checklist
- Deliverables ที่คาดหวัง: Deployed system, deployment runbook และ monitoring dashboard
- จุดตรวจสอบการอนุมัติ: อนุมัติ production readiness checklist และตรวจสอบว่า canary cohort แรกมีเสถียรภาพ
การ deployment ควรทำอย่างค่อยเป็นค่อยไป ไม่ใช่ big-bang launch canary releases ช่วยตรวจพบปัญหาก่อนที่จะกระทบผู้ใช้ทั้งหมด
6. Evaluation, Monitoring และ Observability
- วัตถุประสงค์: ทำให้มั่นใจว่าโมเดลยังทำงานได้ตามเกณฑ์หลังเปิดใช้งานจริง
- กิจกรรมหลัก: Real-time monitoring, drift detection, audit logging, anomaly response, periodic evaluation
- พันธมิตรทำอะไร: ตั้งค่า monitoring กำหนด alerting และผลิต periodic evaluation reports
- ลูกค้าจัดหาอะไร: ข้อเสนอแนะธุรกิจเกี่ยวกับ live outputs, ผู้ติดต่อ escalation และข้อตกลง SLOs
- Deliverables ที่คาดหวัง: Observability dashboard, alerting configuration และ periodic evaluation report
- จุดตรวจสอบการอนุมัติ: ทบทวน SLO และ SLA ตามรอบเวลาที่กำหนด ขั้นตอนนี้ไม่มีจุดสิ้นสุดตายตัว แต่เป็นงานที่ต้องทำอย่างต่อเนื่อง
คุณไม่สามารถจัดการสิ่งที่วัดไม่ได้ หากไม่มี observability ปัญหาใน production จะวินิจฉัยได้ยาก
7. การเพิ่มประสิทธิภาพอย่างต่อเนื่องและการฝึกใหม่
- วัตถุประสงค์: รับมือกับประสิทธิภาพโมเดลที่ลดลงเมื่อเวลาผ่านไป ด้วยการ retraining การทดลอง และการเพิ่มประสิทธิภาพต้นทุน
- กิจกรรมหลัก: Scheduled retraining, A/B testing ของเวอร์ชันโมเดลใหม่, cost optimization, feature enhancement
- พันธมิตรทำอะไร: สร้าง retraining pipeline ออกแบบ A/B tests และผลิต optimization roadmap
- ลูกค้าจัดหาอะไร: ข้อเสนอแนะทางธุรกิจ การอนุมัติงบประมาณสำหรับ retraining runs และข้อมูลประกอบ roadmap
- Deliverables ที่คาดหวัง: Retraining pipeline, optimization roadmap และกระบวนการ version approval
- จุดตรวจสอบการอนุมัติ: Quarterly business review ครอบคลุมประสิทธิภาพโมเดลและต้นทุน
นี่คือความแตกต่างที่ใหญ่ที่สุดจาก SDLC แบบดั้งเดิม ซอฟต์แวร์ไม่ต้อง retrain แต่ AI ต้องทำ การวางแผนตั้งแต่ต้นช่วยป้องกันคุณภาพระบบที่ลดลงอย่างช้าๆ และมองไม่เห็น
ใครเป็นเจ้าของอะไรระหว่าง AI Software Development Lifecycle
ความไม่ชัดเจนเรื่องความเป็นเจ้าของเป็นหนึ่งในสาเหตุที่พบบ่อยที่สุดของความขัดแย้งในโครงการ AI ที่ outsource การแบ่งความรับผิดชอบด้านล่างเป็นแนวทางพื้นฐานที่ใช้งานได้จริงสำหรับ AI software development lifecycle สามารถปรับได้ แต่ควรปรับอย่างตั้งใจ ไม่ใช่ปล่อยให้เป็นไปตามสมมติฐาน
สิ่งที่ลูกค้าต้องเป็นเจ้าของ
- ความรู้ domain และ business context: ไม่มีใครเข้าใจธุรกิจได้ดีเท่าลูกค้า เรื่องนี้ไม่สามารถ outsource ได้
- การเข้าถึงข้อมูลและระบบ: ลูกค้าเป็นผู้ควบคุมว่าใครจะเข้าถึงข้อมูล เมื่อใด และภายใต้เงื่อนไขใด
- ตัวชี้วัดธุรกิจและ success criteria: ลูกค้านิยามว่าความสำเร็จมีลักษณะอย่างไรในเชิงธุรกิจ
- ความอดทนต่อความเสี่ยงและการตัดสินใจการปฏิบัติตามกฎระเบียบ: ลูกค้าตัดสินใจว่าความเสี่ยงใดยอมรับได้และข้อจำกัดการปฏิบัติตามใดใช้บังคับ
- User acceptance testing: ลูกค้าตรวจสอบว่าระบบทำงานสำหรับผู้ใช้จริงในเงื่อนไขจริง
- การอนุมัติ production ขั้นสุดท้าย: ลูกค้าเป็นผู้อนุมัติการนำระบบขึ้นใช้งานจริง
- ความเป็นเจ้าของธุรกิจหลังเปิดตัว: หาก AI ตัดสินใจผิด ธุรกิจเป็นผู้รับผิดชอบผลกระทบ ดังนั้นการยอมรับ production จึงเป็นการตัดสินใจที่จริงจัง ไม่ใช่เพียงการอนุมัติตามขั้นตอน
สิ่งที่พันธมิตร Outsourcing ต้องเป็นเจ้าของ
- การประเมินความเป็นไปได้ทางเทคนิค: พันธมิตรรับผิดชอบการประเมินอย่างตรงไปตรงมาว่าสิ่งใดทำได้จริงในทางเทคนิค
- สถาปัตยกรรมและวิศวกรรม: พันธมิตรออกแบบและสร้างระบบ
- Data และ model pipelines: พันธมิตรสร้างและบำรุงรักษา pipelines ที่ป้อนข้อมูลและอัปเดตโมเดล
- กระบวนการและ harness การประเมิน: พันธมิตรนิยามวิธีประเมินโมเดลและสร้าง tooling สำหรับมัน
- เอกสาร: พันธมิตรจัดทำเอกสารที่จำเป็นต่อการใช้งาน บำรุงรักษา และส่งมอบระบบในอนาคต
- Deployment readiness: พันธมิตรรับผิดชอบให้ระบบพร้อม deploy ไม่ใช่เพียงทำงานได้ใน sandbox
- การตั้งค่า monitoring: พันธมิตรกำหนด monitoring และ alerting ที่ระบบต้องการใน production
- แผน knowledge transfer: พันธมิตรรับผิดชอบการถ่ายโอนความรู้ให้ทีมภายใน หากเป็นส่วนหนึ่งของ engagement
สิ่งที่ต้องการการอนุมัติร่วม
- การตัดสินใจเรื่องขอบเขตและ change requests: ไม่มีฝ่ายใดเปลี่ยนขอบเขตได้ฝ่ายเดียว
- เกณฑ์และ thresholds การประเมิน: พันธมิตรเป็นผู้เสนอ แต่ลูกค้าเป็นผู้อนุมัติ เพราะ thresholds เป็นการตัดสินใจทางธุรกิจ
- การยอมรับ production: ทั้งสองฝ่าย sign off ว่าระบบตรงเกณฑ์ที่ตกลง
- กระบวนการ incident escalation: ทั้งสองฝ่ายตกลงว่าใครทำอะไรเมื่อเกิดปัญหา
- Roadmap หลังเปิดตัวและ retraining cadence: ทั้งสองฝ่ายตกลงว่าระบบจะพัฒนาอย่างไรหลังเปิดตัว
Acceptance Criteria ทำงานอย่างไรในการพัฒนา AI
Acceptance criteria เป็นจุดที่โครงการ AI มักผิดพลาดมากที่สุด ทีมมักใช้แนวคิดแบบซอฟต์แวร์ดั้งเดิมว่า “ฟีเจอร์ทำงานก็ส่งมอบได้” กับระบบที่คำว่า “ทำงาน” เป็นช่วงต่อเนื่อง ไม่ใช่ผลแบบผ่านหรือไม่ผ่าน การยอมรับ AI จึงเกี่ยวกับ quality thresholds และ failure boundaries ไม่ใช่ผลลัพธ์ที่สมบูรณ์แบบ ตาม McKinsey’s State of AI ช่องว่างระหว่าง pilot AI กับ production ยังเป็นความท้าทายสำคัญ และ acceptance criteria ที่ไม่ชัดเจนเป็นสาเหตุหลัก
Performance Thresholds แทน Output ที่สมบูรณ์แบบ
AI ไม่สามารถถูกต้อง 100% ได้ การยอมรับหมายถึงระบบต้องผ่าน performance threshold ที่กำหนดและเหมาะสมกับบริบทธุรกิจ โมเดลที่มี accuracy 95% อาจเหมาะกับการคัดแยก support tickets แต่ยอมรับไม่ได้สำหรับการวินิจฉัยทางการแพทย์ threshold เป็นการตัดสินใจทางธุรกิจ ไม่ใช่การตัดสินใจทางเทคนิค และควรกำหนดตั้งแต่ discovery ไม่ใช่ตอนท้ายโครงการ
Evaluation Data และ Human Review
การยอมรับต้องใช้ evaluation dataset ที่เป็นตัวแทนของสภาพแวดล้อม production ไม่ใช่ training data ต้องมีผู้กำหนด ground truth, sample size และ human review protocol ว่าใครจะตรวจสอบผลลัพธ์ บ่อยแค่ไหน และใช้ sample size เท่าใด คำถามเหล่านี้ควรตอบก่อนการอนุมัติ production ไม่ใช่ระหว่างกระบวนการ
ขอบเขตต้นทุน Latency และความล้มเหลว
ประสิทธิภาพไม่ใช่มิติเดียวของการยอมรับ ระบบยังต้องมีขอบเขตด้านต้นทุน latency และความล้มเหลว:
- Inference cost per request: งบประมาณ ceiling เท่าใด?
- Response latency: SLO เท่าใด (เช่น P95 ต่ำกว่า 2 วินาที)?
- Failure boundaries: เมื่อใด AI ควรปฏิเสธการตอบ? เมื่อใดควร escalate ไปมนุษย์? เมื่อใดควร trigger rollback?
ขอบเขตเหล่านี้เป็นส่วนหนึ่งของ production readiness โมเดลที่แม่นยำแต่ทำงานช้าเกินไปหรือมีต้นทุนสูงเกินไป ยังไม่ถือว่าผ่านเกณฑ์การยอมรับ
นิยามเมื่อระบบ AI พร้อมสำหรับ Production
Production readiness ไม่เหมือน pilot completion ระบบพร้อม production เมื่อผ่านเงื่อนไขทั้งหมดต่อไปนี้:
- Agreed performance threshold บน evaluation dataset
- Guardrail coverage สำหรับความเสี่ยงที่ระบุ
- Observability และ alerting พร้อมใช้งาน
- Incident response plan มีเอกสารและทดสอบ
- Cost ceiling นิยามและตรวจสอบแล้ว
การอนุมัติควรมาจากทั้ง client AI champion และ partner tech lead สำหรับข้อพิจารณาด้าน security และ human-in-the-loop ที่เกี่ยวข้องกับ readiness ดู LLM security for agentic AI
การอัพเดตโมเดลและการอนุมัติเวอร์ชัน
ระบบ AI เปลี่ยนแปลงหลังเปิดตัว เวอร์ชันโมเดลใหม่จึงต้องมีกระบวนการอนุมัติ เช่น ใครอนุมัติก่อน deploy, ใช้ A/B test protocol ใด และ rollback criteria ใดจะ trigger ให้กลับไปใช้เวอร์ชันก่อนหน้า หากไม่มีขั้นตอนนี้ ประสิทธิภาพที่ลดลงอย่างเงียบๆ อาจไปถึง production โดยไม่มีใครสังเกต
สิ่งที่คาดหวังที่แต่ละขั้นตอนเมื่อคุณ Outsource
ตารางด้านล่างสรุปสิ่งที่พันธมิตรทำ สิ่งที่ลูกค้าจัดเตรียม Deliverables ที่ควรได้รับ และจุดที่มีการอนุมัติในแต่ละขั้นตอน Deliverables เหล่านี้เป็น artifacts ที่เป็นรูปธรรม ไม่ใช่คำอธิบายกว้างๆ
| ขั้นตอน Lifecycle | พันธมิตรทำอะไร | ลูกค้าจัดหา | Deliverables ที่คาดหวัง | จุดตรวจสอบการอนุมัติ |
|---|---|---|---|---|
| Discovery | Challenge use case, ดำเนิน feasibility | Business context, สรุปข้อมูล | Discovery report, success metrics | Sign-off ขอบเขตและตัวชี้วัด |
| Data Readiness | Data audit, gap analysis | การเข้าถึงข้อมูล, ข้อจำกัดการปฏิบัติตาม | Data readiness report, data strategy | Go/no-go ความเพียงพอของข้อมูล |
| Prototyping | สร้าง PoC, ดำเนิน baseline eval | ข้อมูลตัวอย่าง, ข้อเสนอแนะธุรกิจ | Prototype, evaluation baseline | Go/no-go อิงตัวชี้วัด |
| Engineering & Guardrails | สถาปัตยกรรม, guardrails, eval harness | กฎธุรกิจ, สถานการณ์ UAT | Production codebase, guardrail spec, eval harness | ตรวจสอบ guardrail coverage |
| Deployment | Integration, rollout, monitoring | Prod access, readiness checklist | Deployed system, runbook, monitoring dashboard | Sign-off production readiness |
| Monitoring | Monitoring, drift detection, periodic eval | ข้อเสนอแนะธุรกิจ, ข้อตกลง SLO | Observability dashboard, eval report | การตรวจสอบ SLO/SLA ประจำ |
| Optimization | Retraining, A/B testing, cost optimization | งบประมาณ, input roadmap | Retraining pipeline, optimization roadmap | Quarterly business review |
สัญญาณเตือนของการส่งมอบ Lifecycle
สัญญาณเตือนบางอย่างเกี่ยวข้องโดยเฉพาะกับการส่งมอบ lifecycle และควรเฝ้าระวัง:
- ไม่มี acceptance criteria ที่นิยามสำหรับแต่ละขั้นตอน
- ไม่มีความแตกต่างระหว่าง prototype completion และ production readiness
- ไม่มีคำชี้แจงความรับผิดชอบลูกค้าที่ชัดเจน
- ไม่มีความเป็นเจ้าของหรือแผน monitoring หลังเปิดตัว
นี่ไม่ใช่สัญญาณเตือนทั่วไปในการเลือกพันธมิตร แต่เป็นสัญญาณว่าพันธมิตรดำเนิน AI SDLC ได้ถูกต้องหรือไม่ สำหรับการประเมินพันธมิตรในภาพรวม ดูคู่มือของเราเรื่อง choosing an AI development partner
ความคาดหวังที่สมจริงสำหรับไทม์ไลน์ ต้นทุนและความเสี่ยง
ทำไมไทม์ไลน์ AI เป็นแบบ Stage-Based
ไทม์ไลน์ของ AI ไม่ได้เป็นเส้นตรง แต่ละขั้นตอนขึ้นอยู่กับผลลัพธ์ของขั้นตอนก่อนหน้า หาก data readiness พบช่องว่าง โครงการอาจต้องหยุดเพื่อเก็บหรือติดป้ายกำกับข้อมูลเพิ่ม หาก prototype ไม่ผ่าน baseline ทีมอาจต้องเลือกแนวทางโมเดลใหม่ จึงทำให้ไทม์ไลน์แบบตายตัวไม่น่าเชื่อถือ
การประเมินควรระบุเป็นช่วง ไม่ใช่วันที่เดียว และควรคำนึงถึง data readiness ความซับซ้อนของ integration ข้อกำหนดด้าน compliance ผลการประเมินโมเดล การเปลี่ยนแปลงขอบเขต โครงสร้างพื้นฐาน และการพึ่งพาผู้จำหน่ายหรือโมเดล
สิ่งที่สามารถเปลี่ยนการประเมินเดิม
ปัจจัยหลายอย่างอาจทำให้ไทม์ไลน์เปลี่ยนหลังเริ่มโครงการ:
- คุณภาพข้อมูลต่ำกว่าคาด: ต้องการการเตรียมหรือติดป้ายข้อมูลเพิ่ม
- การประเมินโมเดลไม่ตรง threshold: ทีม iterate หรือเลือกแนวทางโมเดลใหม่
- ความซับซ้อนบูรณาการสูงกว่าคาด: ระบบ legacy ข้อจำกัดความปลอดภัย หรือข้อจำกัด API เพิ่มงาน
- การเปลี่ยนขอบเขตจากลูกค้า: ข้อกำหนดใหม่เปลี่ยนงาน
- ข้อกำหนดการปฏิบัติตามกฎระเบียบใหม่: ข้อกำหนดกฎระเบียบหรือความปลอดภัยเกิดระหว่างการพัฒนา
พันธมิตรที่มีวุฒิภาวะจะเปิดเผยความเสี่ยงเหล่านี้ตั้งแต่เนิ่นๆ และปรับแผน แทนที่จะซ่อนปัญหาจนพลาดกำหนดส่ง
หมวดต้นทุน AI แบบครั้งเดียวและที่เกิดซ้ำ
ต้นทุน AI แบ่งเป็นต้นทุนครั้งเดียวและต้นทุนที่เกิดซ้ำ การเข้าใจทั้งสองประเภทเป็นสิ่งสำคัญต่อการจัดทำงบประมาณ
ต้นทุนครั้งเดียว:
- Discovery และ feasibility
- การเตรียมและติดป้ายข้อมูล
- การพัฒนาและวิศวกรรม
- การสร้าง guardrail และ evaluation harness
- การตั้งค่า deployment
ต้นทุนที่เกิดซ้ำ:
- การใช้โมเดลหรือ API (inference)
- Cloud และโครงสร้างพื้นฐาน
- การประเมินและ monitoring
- การบำรุงรักษาและการเพิ่มประสิทธิภาพ
- การฝึกใหม่หรือการเปลี่ยนโมเดล
AI มีต้นทุนที่เกิดซ้ำสูงกว่าซอฟต์แวร์แบบดั้งเดิม เพราะ inference และ retraining ไม่หยุดหลัง deployment เมื่อประเมินข้อเสนอของพันธมิตร ควรขอรายละเอียดต้นทุนครั้งเดียวเทียบกับต้นทุนที่เกิดซ้ำอย่างชัดเจน
ทีมที่เป็นผู้ใหญ่จัดการความไม่แน่นอนทางเทคนิคอย่างไร
ทีมที่มีวุฒิภาวะไม่แสร้งทำเป็นว่า AI คาดการณ์ได้แน่นอน แต่จัดการความไม่แน่นอนด้วยวิธีต่อไปนี้:
- Stage-gate funding: Commit งบประมาณต่อขั้นตอน ไม่ใช่ทั้งหมดล่วงหน้า
- Evaluation-driven decisions: เคลื่อนไปข้างหน้าอิงผล ไม่ใช่วันปฏิทิน
- Phased engagement: ถือ discovery, pilot และ production เป็น commitment แยก
- Risk register: อัปเดตความเสี่ยงในแต่ละขั้นตอนและลดความเสี่ยงเชิงรุก
แนวทางนี้อาจใช้เวลาและงบประมาณในการวางแผนมากขึ้น แต่มีต้นทุนต่ำกว่ามากเมื่อเทียบกับการสร้างระบบที่ล้มเหลว
การเลือก Engagement Model ที่เหมาะสมสำหรับโครงการ AI ของคุณ
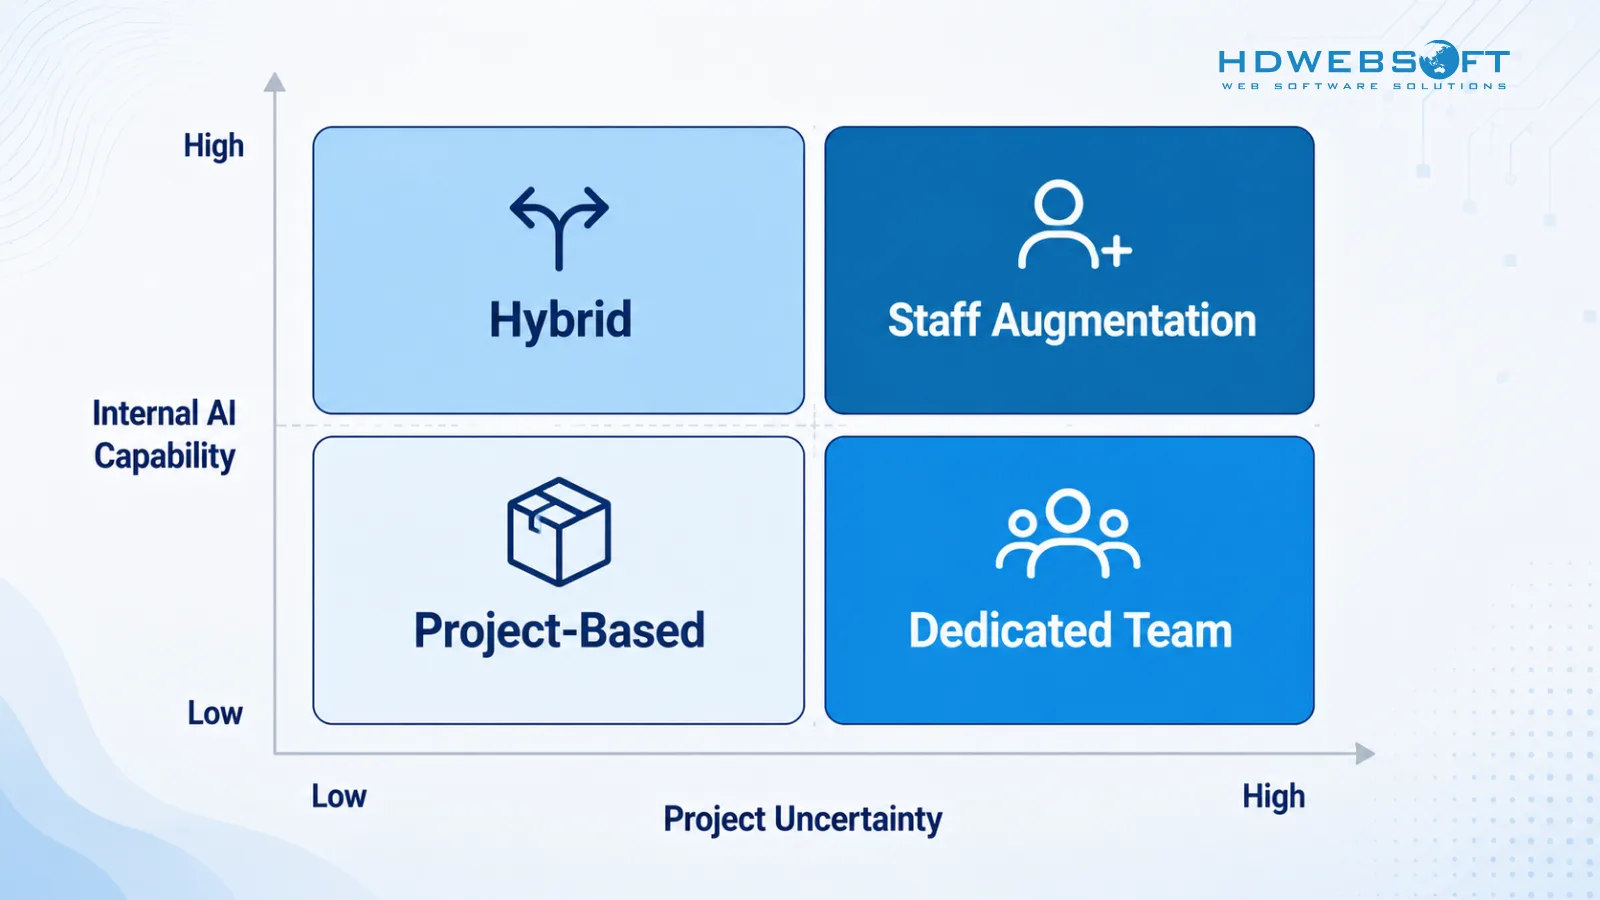
engagement model ควรสอดคล้องกับความไม่แน่นอนของโครงการ AI และความสามารถภายในของลูกค้า ไม่มีโมเดลใดเหมาะกับทุกโครงการ AI engagement models มีตั้งแต่การส่งมอบตามขอบเขตตายตัว ไปจนถึง dedicated team และ hybrid arrangement แต่ละรูปแบบเหมาะกับระดับความไม่แน่นอนที่แตกต่างกัน
การส่งมอบแบบ Project-Based สำหรับ Outcomes ที่นิยาม
การส่งมอบแบบ project-based เหมาะเมื่อ outcome และ acceptance criteria ค่อนข้างชัดเจน ข้อมูลพร้อม และขอบเขตคงที่ RAG chatbot ที่สร้างจาก knowledge base เดิมเป็นตัวอย่างที่ดี
ลูกค้าควบคุมขอบเขตและงบประมาณได้มาก พันธมิตรรับผิดชอบการส่งมอบทั้งหมดตั้งแต่ discovery ถึง deployment ข้อแลกเปลี่ยนคือความยืดหยุ่น หากพฤติกรรมของโมเดลเปลี่ยนกลางโครงการ ขอบเขตตายตัวอาจปรับได้ยาก
ทีม AI Dedicated สำหรับผลิตภาพที่พัฒนา
ทีม AI แบบ dedicated เหมาะกับผลิตภัณฑ์ที่ต้องทดลองและปรับปรุงอย่างต่อเนื่อง เช่น Agentic AI, multi-agent systems และผลิตภัณฑ์ที่ขอบเขตพัฒนาตามสิ่งที่โมเดลทำได้จริง
ลูกค้าดูแลทิศทางของผลิตภัณฑ์ ส่วนพันธมิตรจัดหาทีมและ technical execution โมเดลนี้ต้องการการบริหารเชิงรุกจากลูกค้ามากกว่า แต่รับมือกับความไม่แน่นอนได้ดีกว่าขอบเขตตายตัว
Staff Augmentation สำหรับทีม AI ภายในที่มีอยู่
Staff augmentation เหมาะเมื่อลูกค้ามีทีม AI ภายในอยู่แล้วและต้องการความเชี่ยวชาญเฉพาะ เช่น MLOps engineer หรือ ML researcher ลูกค้ายังคงควบคุมงานทั้งหมด ส่วนพันธมิตรจัดหาบุคลากร ไม่ได้เป็นเจ้าของการส่งมอบ
โมเดลนี้เหมาะเมื่อบริษัทมีความสามารถภายในเพียงพอที่จะบริหารทีมที่เสริมเข้ามา
Hybrid และ Phased Engagements
Hybrid engagement พบได้บ่อยในโครงการ AI พันธมิตรนำตั้งแต่ discovery ถึง production deployment จากนั้นจึงโอนความรับผิดชอบด้าน monitoring และ optimization ให้ทีมภายใน รูปแบบนี้เหมาะเมื่อลูกค้าต้องการสร้างความสามารถภายในเมื่อเวลาผ่านไป
หัวใจสำคัญคือการวางแผน knowledge transfer ไว้ใน engagement ตั้งแต่ต้น ไม่ใช่ค่อยเพิ่มเมื่อใกล้จบโครงการ
การจับคู่ Engagement Model กับความไม่แน่นอนของโครงการ
| สถานการณ์โครงการ | โมเดลที่แนะนำ | การควบคุมลูกค้า | ความรับผิดชอบพันธมิตร |
|---|---|---|---|
| Outcome ชัดเจน, ข้อมูลพร้อม, ขอบเขตเสถียร | Project-based | สูงเกี่ยวกับขอบเขต | การส่งมอบเต็ม |
| เน้น R&D, ขอบเขตพัฒนา | Dedicated team | ปานกลาง | ทีมและการดำเนินการ |
| ทีม AI ภายใน, ต้องการความเชี่ยวชาญ | Staff augmentation | สูงโดยรวม | การจัดหา talent |
| พันธมิตรนำแล้วโอนภายใน | Hybrid / phased | เพิ่มขึ้นเมื่อเวลา | ลดลงกับ knowledge transfer |
สำหรับสำรวจ engagement models โดยละเอียด ดูหน้า engagement models ของเรา
การส่งมอบและการสนับสนุนหลังเปิดตัวที่ดีมีลักษณะอย่างไร
ความล้มเหลวที่พบบ่อยในการ outsourcing คือการส่งมอบ source code โดยไม่มีสิ่งอื่น สำหรับระบบ AI โค้ดเป็นเพียงส่วนเล็กๆ ของสิ่งที่ทีมภายในต้องใช้เพื่อดำเนินงานและบำรุงรักษาระบบ
เอกสารทางเทคนิคและการปฏิบัติการ
การส่งมอบควรรวม:
- เอกสารสถาปัตยกรรม
- เอกสารข้อมูลและโมเดล
- เอกสารการพึ่งพาโมเดลและ API
- คำแนะนำ deployment
- Runbooks และกระบวนการ incident
การเข้าถึง Evaluation และ Monitoring Assets
ทีมภายในต้องเข้าถึงเครื่องมือที่ช่วยรักษาสุขภาพของระบบ:
- Evaluation datasets หรือ methodology ที่ใช้
- การเข้าถึง monitoring dashboard
- การเข้าถึง alerting configuration
- การเข้าถึง audit log
Knowledge Transfer ไปทีมภายใน
knowledge transfer ควรมีโครงสร้าง ไม่ใช่การถ่ายทอดแบบไม่เป็นทางการ:
- บันทึกเซสชัน knowledge-transfer
- Code walkthroughs
- คำอธิบายพฤติกรรมโมเดล
- เซสชัน Q&A กับทีมวิศวกรรม
Monitoring, Optimization และ Retraining อย่างต่อเนื่อง
การส่งมอบควรทำให้ความเป็นเจ้าของหลังเปิดตัวชัดเจน:
- ใครรับผิดชอบ monitoring หลังส่งมอบ (ลูกค้า, พันธมิตร, หรือ hybrid)
- Retraining cadence และใครเป็นเจ้าของ
- การส่งมอบ optimization roadmap
- SLA สำหรับการสนับสนุนหลังเปิดตัวหากพันธมิตรบำรุงรักษาระบบต่อ
หากไม่มีความชัดเจนนี้ ระบบอาจเสื่อมประสิทธิภาพอย่างเงียบๆ และไม่มีใครสังเกตจนกว่าตัวชี้วัดทางธุรกิจจะลดลง
บทสรุป
AI software development lifecycle ไม่ใช่ SDLC แบบดั้งเดิมที่นำโมเดลมาติดตั้งเพิ่มภายหลัง แต่เพิ่ม data readiness, model evaluation, guardrails, observability และการ retraining อย่างต่อเนื่องเป็นขั้นตอนหลัก และถือว่า production เป็นจุดเริ่มต้นของวงจรการเพิ่มประสิทธิภาพ ไม่ใช่จุดจบของโครงการ เมื่อคุณ outsource การพัฒนา AI lifecycle นี้จะช่วยกำหนดความคาดหวังและความรับผิดชอบของทั้งสองฝ่าย
แต่ละขั้นตอนควรมี Deliverables ที่เป็นรูปธรรมและผ่านจุดตรวจสอบการอนุมัติที่กำหนด ความเป็นเจ้าของควรชัดเจน ลูกค้าเป็นเจ้าของการตัดสินใจด้านธุรกิจ domain และข้อมูล พันธมิตรเป็นเจ้าของ technical execution ส่วนขอบเขต การประเมิน และการยอมรับ production ต้องได้รับการอนุมัติร่วมกัน Acceptance criteria ควรกำหนดก่อนเริ่มพัฒนา โดยอิงจาก quality thresholds และ failure boundaries ไม่ใช่ผลลัพธ์ที่สมบูรณ์แบบ
หากคุณกำลังวางแผนโครงการ AI และต้องการพูดคุยว่า engagement model ใดเหมาะกับสถานการณ์ของคุณ ติดต่อ HDWEBSOFT หรือสำรวจ AI development services และ AI consulting services ของเรา การพูดคุยที่เหมาะสมก่อนเริ่มโครงการช่วยประหยัดได้มากกว่าการแก้ไขปัญหาหลังโครงการผิดพลาด
คำถามที่พบบ่อย
AI software development lifecycle คืออะไร?
AI software development lifecycle คือกระบวนการแบบ end-to-end สำหรับสร้าง deploy และบำรุงรักษาระบบ AI ครอบคลุม discovery, data readiness, prototyping, engineering, deployment, monitoring และการเพิ่มประสิทธิภาพอย่างต่อเนื่อง ต่างจาก SDLC แบบดั้งเดิมตรงที่รวมการเตรียมข้อมูล การประเมินโมเดล guardrails, observability และการ retraining ไว้เป็นขั้นตอนหลัก
AI software development lifecycle แตกต่างจาก SDLC แบบดั้งเดิมอย่างไร?
AI SDLC แตกต่างเพราะผลลัพธ์ของ AI เป็น probabilistic ไม่ใช่ deterministic lifecycle นี้เพิ่มการประเมินความพร้อมของข้อมูล การประเมินโมเดล guardrails การติดตาม data drift และการ retraining อย่างต่อเนื่อง ขณะที่ SDLC แบบดั้งเดิมสิ้นสุดที่ deployment แต่ AI SDLC ถือว่า production เป็นจุดเริ่มต้นของวงจรการเพิ่มประสิทธิภาพอย่างต่อเนื่อง
สิ่งใดควรตกลงก่อน outsourcing โครงการพัฒนา AI?
ก่อนเริ่มโครงการ ลูกค้าและพันธมิตรควรตกลงเรื่อง business outcomes, success metrics, available data, data ownership, system access, compliance requirements, ผู้มีอำนาจตัดสินใจของลูกค้า, pilot completion criteria, production readiness criteria และผู้รับผิดชอบการดำเนินงานหลังเปิดตัว
Deliverables ใดที่คู่ค้า outsourcing AI ควรมอบให้?
Deliverables ที่คาดหวัง ได้แก่ discovery report, data readiness report, working prototype, evaluation baseline, production codebase, guardrail specification, deployment runbook, monitoring dashboard, periodic evaluation report, retraining pipeline และเอกสาร knowledge transfer
ลูกค้าควรมีส่วนร่วมมากเพียงใดระหว่างการพัฒนา AI?
ลูกค้าควรมีส่วนร่วมในทุก phase gate ลูกค้าเป็นเจ้าของ business context, data access, success metrics, risk tolerance, compliance decisions, user acceptance testing และการอนุมัติ production ขั้นสุดท้าย พันธมิตรเป็นเจ้าของ technical execution, architecture, evaluation และเอกสาร ส่วนขอบเขต เกณฑ์การประเมิน และการยอมรับ production ต้องได้รับการอนุมัติร่วมกัน
ระบบ AI ถูกทดสอบและยอมรับอย่างไรก่อน production?
การยอมรับ AI อิงจาก performance thresholds, acceptable error rates, evaluation datasets, human review protocols, cost and latency boundaries, failure escalation rules และ safety guardrails ระบบพร้อมสำหรับ production เมื่อผ่าน quality thresholds ที่ตกลงกัน มี guardrail coverage, observability, incident plan และ cost ceiling
Engagement model ใดเหมาะสำหรับโครงการ AI ที่มีข้อกำหนดเปลี่ยนแปลง?
สำหรับโครงการ AI ที่มีขอบเขตเปลี่ยนแปลงและความไม่แน่นอนสูง dedicated AI team หรือ hybrid engagement มักเหมาะที่สุด Project-based delivery เหมาะเมื่อ outcomes และ acceptance criteria ชัดเจน ส่วน staff augmentation เหมาะเมื่อลูกค้ามีทีม AI ภายในอยู่แล้วและต้องการความเชี่ยวชาญเฉพาะด้าน
ใครรับผิดชอบการติดตามและการฝึกใหม่หลังเปิดตัว?
ควรตกลงเรื่องความเป็นเจ้าของหลังเปิดตัวก่อนเริ่มโครงการ ลูกค้าเป็นเจ้าของ business outcomes และการตัดสินใจเกี่ยวกับข้อมูล พันธมิตรอาจรับผิดชอบ monitoring, retraining และ optimization ภายใต้ support SLA หรืออาจโอนความรับผิดชอบให้ทีมภายในผ่าน hybrid engagement พร้อมแผน knowledge transfer