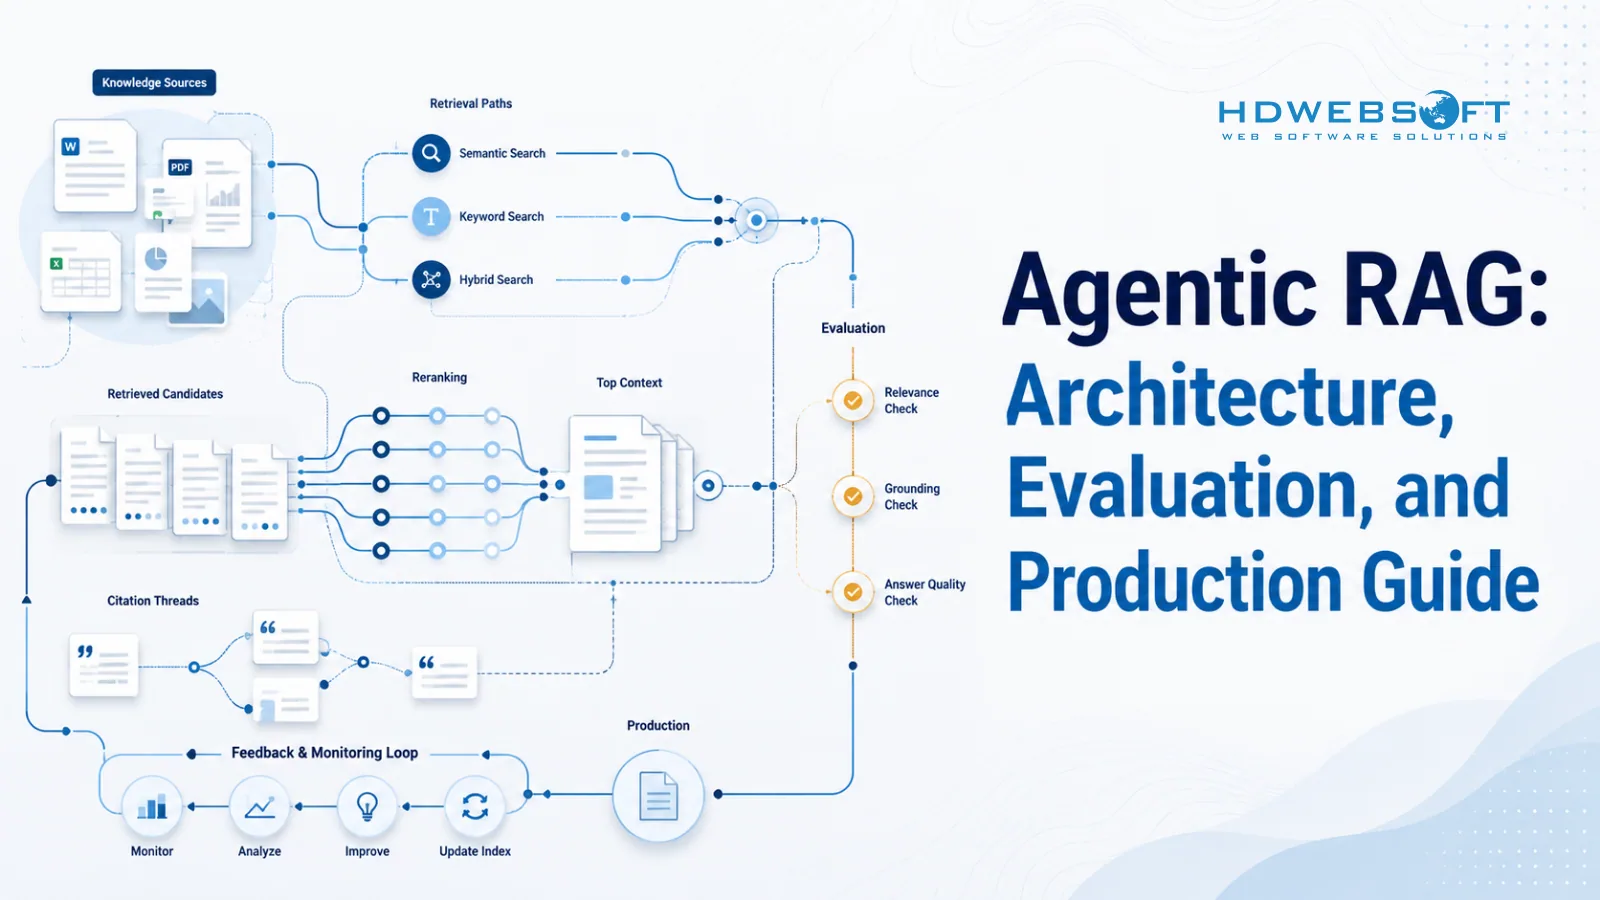
Agentic RAG คือสถาปัตยกรรม Retrieval-Augmented Generation ที่ AI agent สามารถวางแผนขั้นตอนการค้นคืนข้อมูล สอบถามแหล่งความรู้ ใช้เหตุผลกับบริบทที่ค้นคืนมา ใช้เครื่องมือ และตัดสินใจว่าจะทำอะไรต่อ แทนที่จะส่งผลการค้นหาเพียงรายการเดียวเข้าไปในพรอมป์ของ LLM ระบบ Agentic RAG สามารถตั้งคำถามเพื่อค้นข้อมูลเพิ่มเติม ตรวจสอบว่าหลักฐานเพียงพอหรือไม่ อ้างอิงแหล่งที่มา เรียกใช้ระบบธุรกิจ หรือส่งต่อให้มนุษย์เมื่อคำตอบยังไม่ปลอดภัยพอ
สำหรับทีมที่กำลังสำรวจ Agentic AI ในระบบจริง RAG มักเป็นตัวแยกระหว่างเดโมที่ดูน่าเชื่อถือกับเวิร์กโฟลว์ระดับองค์กรที่ใช้งานได้จริง ช่องว่างนี้สำคัญ เพราะการนำ AI ไปใช้ในองค์กรกำลังเติบโตอย่างรวดเร็ว: ผลสำรวจทั่วโลกของ McKinsey ในปี 2025 ระบุว่า 88% ของผู้ตอบแบบสำรวจกล่าวว่าองค์กรของตนใช้ AI เป็นประจำในอย่างน้อยหนึ่งฟังก์ชันธุรกิจ ขณะที่ 23% กำลังขยายระบบ Agentic AI และอีก 39% กำลังทดลองใช้งาน โมเดลเพียงอย่างเดียวอาจรู้รูปแบบทั่วไป แต่ไม่ได้รู้โดยอัตโนมัติถึงนโยบายล่าสุด แคตตาล็อกผลิตภัณฑ์ ข้อมูลลูกค้า ตั๋วสนับสนุน เอกสารวิศวกรรม หรือกฎการปฏิบัติตามข้อกำหนดของคุณ Agentic RAG จึงช่วยให้ AI agent ทำงานกับความรู้ที่เปลี่ยนแปลงได้อย่างมีการควบคุม
ประเด็นสำคัญ
- Agentic RAG ผสานการค้นคืนข้อมูล การใช้เหตุผล การประสานงาน และการใช้เครื่องมือ เพื่อให้ AI agent ทำงานกับบริบทที่มีแหล่งข้อมูลรองรับ
- RAG มักเหมาะกว่าการ Fine-tuning สำหรับความรู้ระดับองค์กรที่เป็นส่วนตัว เปลี่ยนแปลง และต้องอ้างอิงแหล่งที่มา
- Fine-tuning เหมาะกับการกำหนดพฤติกรรม น้ำเสียง รูปแบบ และรูปแบบการตอบสนองเฉพาะโดเมนที่ทำซ้ำได้
- การประเมิน RAG ควรวัดความเกี่ยวข้องของผลการค้นคืน ความสอดคล้องกับแหล่งข้อมูล ความแม่นยำของการอ้างอิง ความสำเร็จของงาน การตรวจสอบสิทธิ์ ความหน่วง และต้นทุน
- RAG ในระบบจริงต้องมีการนำเข้าข้อมูลอย่างปลอดภัย การควบคุมการเข้าถึง การตรวจสอบ ความเป็นปัจจุบันของความรู้ การจัดการเส้นทางสำรอง และการประเมินอย่างต่อเนื่อง
- ระบบ Agentic RAG ที่ดีที่สุดออกแบบรอบเวิร์กโฟลว์ระดับองค์กร ไม่ใช่เพียงรอบฐานข้อมูลเวกเตอร์
Agentic RAG คืออะไร?
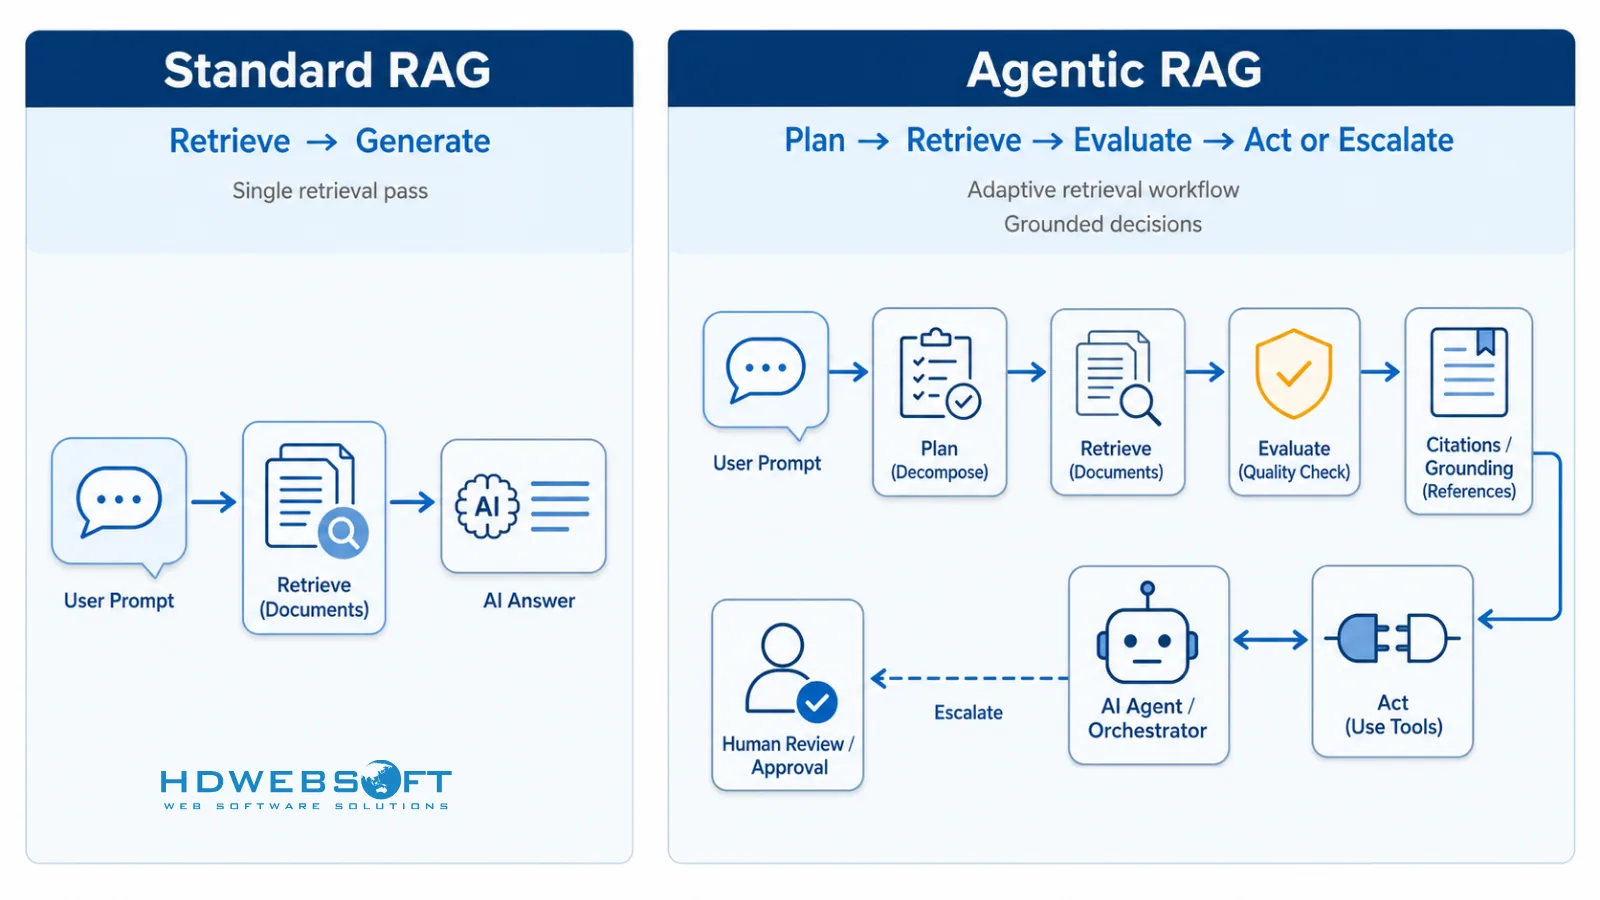
Agentic RAG ต่อยอดจาก Standard Retrieval-Augmented Generation ด้วยการให้ระบบ AI ควบคุมกระบวนการค้นคืนข้อมูลได้มากขึ้น ไปป์ไลน์ Standard RAG มักทำงานเป็นขั้นตอนง่าย ๆ คือค้นคืนส่วนข้อมูลที่เกี่ยวข้อง ใส่ลงในพรอมป์ แล้วสร้างคำตอบ วิธีนี้ใช้ได้กับคำถามจากฐานความรู้จำนวนมาก แต่มีข้อจำกัดเมื่อคำถามกว้าง คลุมเครือ ต้องคำนึงถึงสิทธิ์ หรือเชื่อมโยงกับเวิร์กโฟลว์จริง
Agentic RAG เพิ่มชั้นการวางแผนเข้ามา ทำให้ agent ตัดสินใจได้ว่าต้องใช้ข้อมูลอะไร ควรสอบถามแหล่งใด บริบทที่ได้เพียงพอหรือไม่ และต้องเรียกใช้เครื่องมือหรือขอการอนุมัติจากมนุษย์ก่อนดำเนินเวิร์กโฟลว์ต่อหรือไม่
ตัวอย่างเช่น Support Agent ที่ใช้ Standard RAG อาจค้นคืนบทความจากศูนย์ช่วยเหลือหนึ่งบทความแล้วตอบลูกค้า ส่วนระบบ Agentic RAG อาจตรวจสอบเวอร์ชันผลิตภัณฑ์ของลูกค้า ค้นคืนเอกสารที่ตรงกัน ตรวจสอบบันทึกเหตุขัดข้องล่าสุด ร่างคำตอบพร้อมการอ้างอิง และส่งต่อให้มนุษย์หากเกี่ยวข้องกับการคืนเงินหรือข้อผูกพันด้านระดับบริการ
Agentic RAG แตกต่างจาก standard RAG อย่างไร
ความแตกต่างในทางปฏิบัติคือระดับการควบคุมกระบวนการค้นคืนข้อมูล
| ความสามารถ | Standard RAG | Agentic RAG |
|---|---|---|
| กระบวนการค้นคืน | มักค้นคืนข้อมูลครั้งเดียว | หลายขั้นตอน มีการวางแผนและปรับตามสถานการณ์ |
| การจัดการคำถาม | เหมาะกับคำถามตรงไปตรงมา | เหมาะกว่าสำหรับงานคลุมเครือหรือมีหลายส่วน |
| การใช้แหล่งข้อมูล | ค้นคืนบริบทสำหรับคำตอบเดียว | เปรียบเทียบ ตรวจสอบ และลองค้นคืนจากแหล่งอื่นได้ |
| การใช้เครื่องมือ | มักแยกจากการค้นคืนข้อมูล | ผลการค้นคืนช่วยประกอบการตัดสินใจเรียกใช้เครื่องมือ |
| ความเหมาะกับเวิร์กโฟลว์ | ถามตอบจากฐานความรู้ | เวิร์กโฟลว์ที่ใช้ความรู้ประกอบการลงมือทำ |
นี่ไม่ได้หมายความว่าทุกระบบ RAG ต้องเป็น Agentic RAG หากผู้ใช้ถามคำถามง่าย ๆ จาก FAQ ที่ไม่ค่อยเปลี่ยนแปลง Standard RAG ก็อาจเพียงพอ Agentic RAG มีคุณค่าเมื่อระบบต้องใช้เหตุผลข้ามหลายแหล่ง รักษาสิทธิ์ อ้างอิงหลักฐาน และตัดสินใจขั้นตอนถัดไปในเวิร์กโฟลว์
กรณีการใช้งานทั่วไป
Agentic RAG มีประโยชน์เมื่อคำตอบต้องอ้างอิงความรู้ระดับองค์กรและเชื่อมโยงกับบริบททางธุรกิจ ตัวอย่างเช่น ผู้ช่วยความรู้ภายใน Agent สนับสนุนลูกค้า เครื่องมือถามตอบด้านการปฏิบัติตามข้อกำหนด ผู้ช่วยเอกสารสำหรับนักพัฒนา ระบบสนับสนุนการขาย ผู้ช่วยวิจัย และ Workflow Agent ที่เชื่อมต่อกับ CRM, ERP, ระบบ Ticketing หรือระบบจัดการเอกสาร หากแผนงานของคุณรวมการสนับสนุนแบบสนทนา คู่มือ Voice Chatbot ของเราอธิบายด้านการใช้งานกับลูกค้า ขณะที่ กรณีศึกษาแอปแชตบอต Flutter แสดงให้เห็นว่าการส่งมอบแชตบอตบนมือถือเชื่อมคำตอบจาก AI เข้ากับ CRM และเวิร์กโฟลว์ของแอปอย่างไร
รูปแบบร่วมของทุกกรณีใช้งานนั้นเรียบง่าย: agent ไม่ควรพึ่งพาความจำของโมเดลเพียงอย่างเดียว แต่ควรค้นคืนความรู้ที่ถูกต้อง ใช้ความรู้นั้นอย่างเหมาะสม และรู้ว่าเมื่อใดมีหลักฐานไม่เพียงพอที่จะดำเนินการต่อ
RAG เทียบกับ Fine-tuning สำหรับ AI Agent
การตัดสินใจระหว่าง RAG กับ Fine-tuning ไม่ได้อยู่ที่ว่าเทคนิคใดล้ำสมัยกว่า แต่อยู่ที่ว่าคุณกำลังแก้ปัญหาแบบใด
หลักง่าย ๆ คือ ใช้ RAG กับความรู้ที่เปลี่ยนแปลง และใช้ Fine-tuning กับพฤติกรรม RAG ช่วยให้ AI agent เข้าถึงข้อมูลที่เป็นปัจจุบัน เป็นส่วนตัว และอ้างอิงแหล่งที่มาได้ ส่วน Fine-tuning ช่วยกำหนดวิธีตอบ รูปแบบผลลัพธ์ การทำตามรูปแบบเฉพาะโดเมน หรือการทำงานที่ต้องทำซ้ำ
| ปัจจัยตัดสินใจ | RAG | Fine-tuning |
|---|---|---|
| เหมาะกับ | ความรู้ส่วนตัวหรือความรู้ที่เปลี่ยนแปลง | สไตล์ รูปแบบ พฤติกรรม และรูปแบบการตอบสนองเฉพาะโดเมน |
| ความเป็นปัจจุบันของข้อมูล | อัปเดตได้ง่ายกว่า | ต้องฝึกใหม่หรือปรับแต่งเพิ่มเติม |
| ความสามารถในการอธิบาย | อธิบายได้ง่ายกว่าด้วยการอ้างอิง | ย้อนกลับไปยังแหล่งที่มาได้ยากกว่า |
| การควบคุมความปลอดภัย | รองรับสิทธิ์ระดับเอกสารได้ | ควบคุมได้ยากหากความรู้ถูกฝังอยู่ในพฤติกรรมของโมเดล |
| ความเหมาะกับ Use Case ของ Agent | เหมาะกับคำตอบที่อ้างอิงแหล่งข้อมูล | เหมาะกับพฤติกรรมของงานที่ทำซ้ำ |
เมื่อ RAG ดีกว่า
RAG มักเป็นทางเลือกที่ดีกว่าเมื่อ agent ต้องเข้าถึงความรู้ที่เปลี่ยนแปลงบ่อย หรือต้องตรวจสอบย้อนกลับไปยังแหล่งที่มาได้ เช่น เอกสารผลิตภัณฑ์ นโยบายภายใน ประวัติการสนับสนุนลูกค้า แบบฟอร์มทางกฎหมาย เอกสารปฐมนิเทศ กฎการตั้งราคา คู่มือปฏิบัติงานของวิศวกร และฐานความรู้เฉพาะอุตสาหกรรม
RAG ยังเหมาะกว่าเมื่อสิทธิ์การเข้าถึงมีความสำคัญ หากผู้ใช้สองคนควรเห็นเอกสารคนละชุด ชั้นการค้นคืนข้อมูลสามารถบังคับใช้สิทธิ์เหล่านั้นก่อนส่งเนื้อหาให้โมเดล ซึ่งทำได้ยากหากความรู้ที่ละเอียดอ่อนถูกฝังอยู่ในโมเดลที่ Fine-tune แล้ว
สำหรับ AI agent, RAG มีประโยชน์อย่างยิ่งเมื่อการกระทำถัดไปต้องอาศัยบริบทที่มีแหล่งข้อมูลรองรับ ผู้ช่วยฝ่ายขายไม่ควรแนะนำข้อยกเว้นด้านราคาโดยไม่ตรวจสอบกฎปัจจุบัน Support Agent ไม่ควรเสนอวิธีแก้จากเอกสารที่ล้าสมัย และผู้ช่วยด้านการปฏิบัติตามข้อกำหนดควรอ้างอิงนโยบายที่ใช้
เมื่อ fine-tuning ดีกว่า
Fine-tuning มีประโยชน์เมื่อโมเดลต้องแสดงพฤติกรรมบางอย่างซ้ำ ๆ เช่น สร้างผลลัพธ์ในรูปแบบที่เคร่งครัด ใช้คำศัพท์เฉพาะโดเมน ทำตามสไตล์การเขียนเฉพาะ จัดประเภทคำขอในโครงสร้างที่คาดเดาได้ หรือเพิ่มประสิทธิภาพให้กับงานเฉพาะด้าน
Fine-tuning ไม่ได้ทดแทนการค้นคืนความรู้เมื่อคำตอบขึ้นอยู่กับข้อมูลองค์กรที่เป็นปัจจุบัน แม้ช่วยลดความซับซ้อนของพรอมป์และเพิ่มความสม่ำเสมอได้ แต่ไม่ควรนำมาใช้แทนระบบจัดการความรู้
เมื่อต้องใช้ทั้งสองอย่างร่วมกัน
ระบบ AI ใน Production จำนวนมากใช้ทั้งสองแนวทาง RAG จัดหาความรู้ที่เป็นปัจจุบันและอ้างอิงแหล่งที่มา ส่วน Fine-tuning ช่วยกำหนดพฤติกรรม รูปแบบผลลัพธ์ หรือรูปแบบการตอบสนองเฉพาะโดเมน การประเมินช่วยตรวจสอบความแม่นยำของระบบ ขณะที่ Guardrail ควบคุมสิ่งที่ agent เข้าถึงหรือดำเนินการได้
การผสานทั้งสองแนวทางมักแข็งแกร่งกว่าการบังคับให้เทคนิคเดียวแก้ปัญหาทุกประเภท
สถาปัตยกรรม Agentic RAG
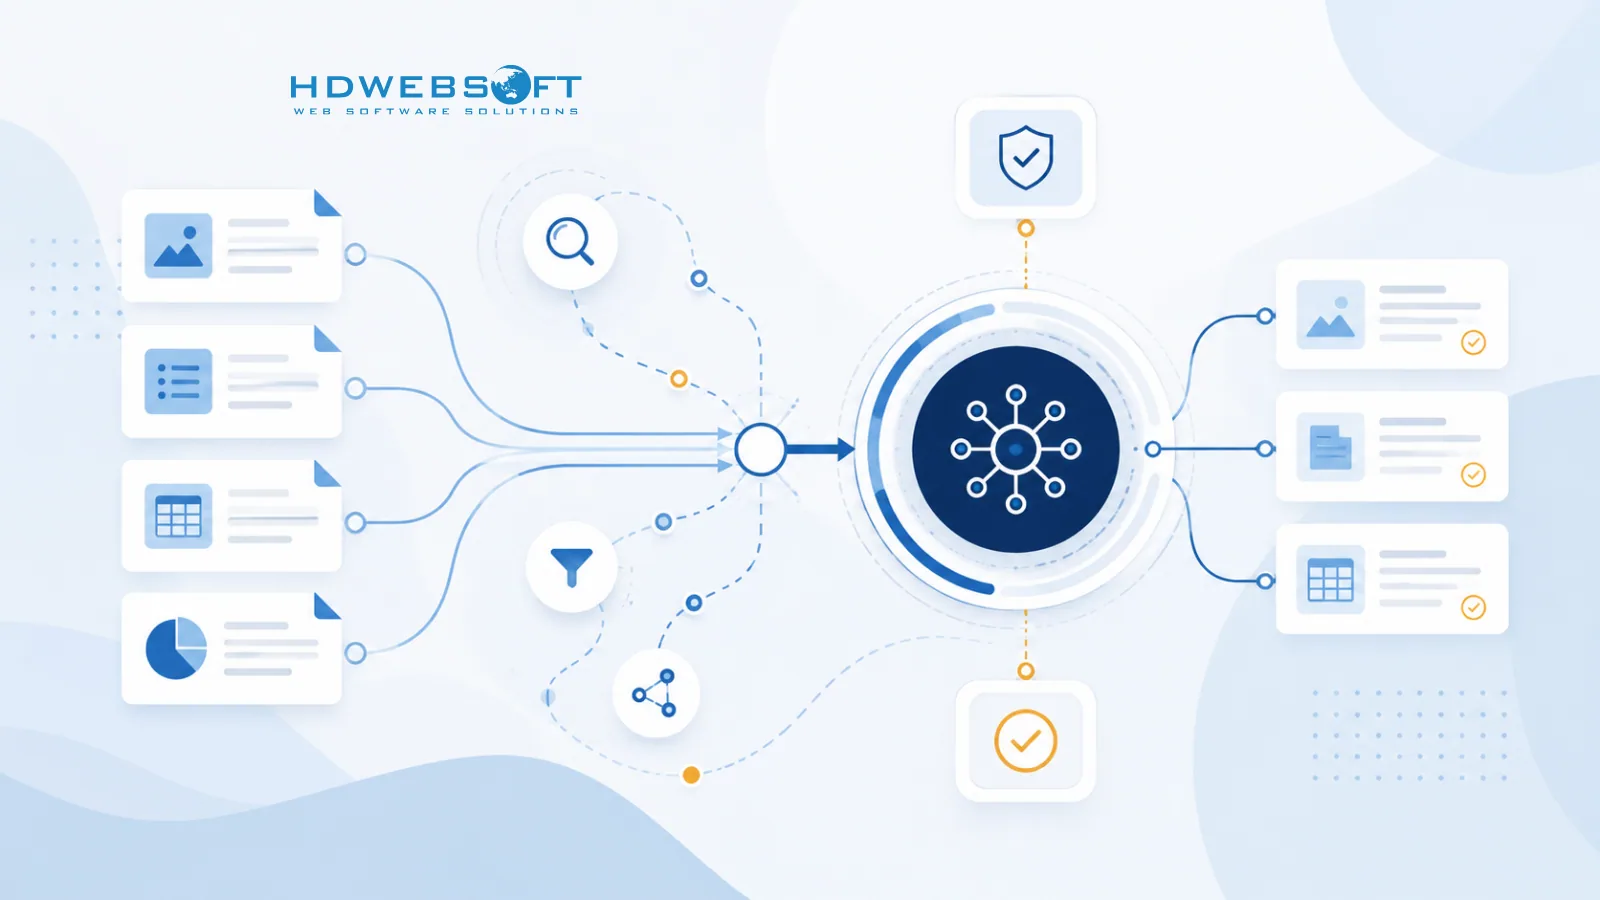
สถาปัตยกรรม Agentic RAG อธิบายองค์ประกอบของระบบและวิธีที่องค์ประกอบเหล่านั้นทำงานร่วมกัน สแต็กที่ใช้จริงอาจแตกต่างกัน แต่ความรับผิดชอบหลักเหมือนกัน ได้แก่ ทำความเข้าใจเจตนา ค้นคืนบริบทที่เกี่ยวข้อง ใช้เหตุผลกับบริบทนั้น เรียกใช้เครื่องมือเมื่อเหมาะสม ยึดโยงคำตอบกับแหล่งข้อมูล และติดตามคุณภาพเมื่อเวลาผ่านไป
คอมโพเนนต์หลักของระบบ agentic RAG
สถาปัตยกรรม Agentic RAG ในทางปฏิบัติมักประกอบด้วย:
- จุดติดต่อผู้ใช้หรือจุดเริ่มต้นของ Agent
- ตัววางแผนหรือตัวประสานงาน
- ชั้นการค้นคืนข้อมูล
- โมเดล embedding
- ฐานข้อมูลเวกเตอร์ ดัชนีค้นหา คลังเอกสาร หรือแหล่งความรู้ภายใน
- ชั้น reranking เพื่อปรับปรุงลำดับผลลัพธ์
- ชั้นการใช้เหตุผลของ LLM
- การจัดการความจำและบริบท
- ชั้นเรียกใช้เครื่องมือ
- ตรรกะการอ้างอิงและการยึดโยงคำตอบกับแหล่งข้อมูล
- Guardrail และการควบคุมการเข้าถึง
- องค์ประกอบด้านการประเมินและการตรวจสอบติดตาม
ไม่ควรเลือกองค์ประกอบเหล่านี้เพียงเพราะเป็นที่นิยม แต่ควรเลือกให้สอดคล้องกับเวิร์กโฟลว์ ระดับความเสี่ยง ปริมาณการใช้งานที่คาดไว้ ความซับซ้อนของแหล่งข้อมูล และรูปแบบการดำเนินงาน
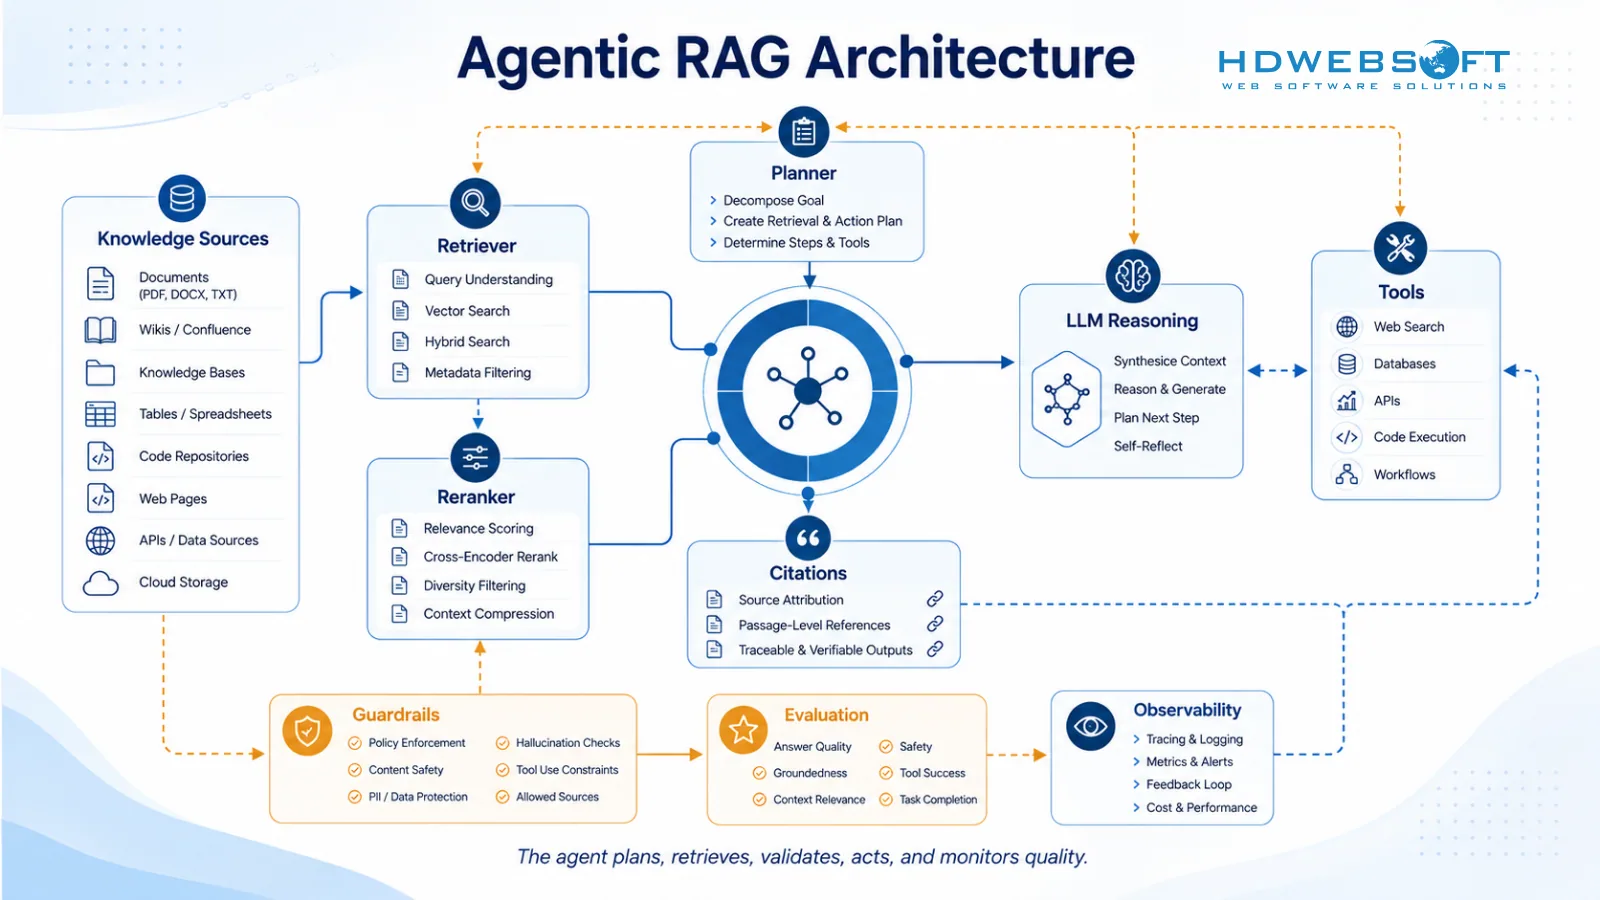
ตัววางแผนและตัวจัดการ
ตัววางแผนตัดสินใจว่า agent ควรทำอะไรต่อ เช่น ระบุว่าคำถามของผู้ใช้ต้องใช้เอกสารผลิตภัณฑ์ จากนั้นจึงใช้ข้อมูลบัญชีลูกค้า และจบด้วยคำตอบพร้อมการอ้างอิง นอกจากนี้ยังอาจตัดสินใจว่าบริบทที่มีไม่เพียงพอ และถามคำถามเพิ่มเติมแทนการคาดเดา
ตัวประสานงานควบคุมกระบวนการทั้งหมด ทั้งการลองค้นคืนข้อมูล การเรียกใช้เครื่องมือ เงื่อนไขหยุด เส้นทางสำรอง และจุดที่ต้องขออนุมัติจากมนุษย์ ในระบบง่าย ๆ อาจเป็นเวิร์กโฟลว์สั้น ๆ ที่มีขั้นตอนตายตัวไม่กี่ขั้น ส่วนระบบซับซ้อนอาจใช้การวางแผนแบบไดนามิกและเครื่องมือหลายประเภท โดยเฉพาะเมื่อชั้น RAG ต้องเชื่อมต่อกับรูปแบบการผสานรวมในคู่มือการเชื่อมต่อและการทำงานร่วมกันของ AI Agentของเรา
ชั้น retrieval
ชั้นการค้นคืนข้อมูลมีหน้าที่ค้นหาบริบทที่เป็นประโยชน์ โดยอาจใช้ Embedding การค้นหาด้วยคำสำคัญ Hybrid Search ตัวกรอง Metadata หรือ Reranking ในระบบระดับองค์กร การค้นคืนข้อมูลยังต้องเคารพบทบาทของผู้ใช้ขอบเขต Tenant สถานะของเอกสาร และความเป็นปัจจุบันของแหล่งข้อมูล
นี่คือจุดที่สถาปัตยกรรม Agentic RAG แตกต่างจากแชตบอตทั่วไป Agent ไม่ได้ถามเพียงว่า “ข้อความใดมีความหมายใกล้เคียงกัน” แต่ยังถามว่า “แหล่งใดเกี่ยวข้อง ผู้ใช้มีสิทธิ์เข้าถึง เป็นข้อมูลปัจจุบัน และเพียงพอสำหรับงานนี้”
Vector database และแหล่งความรู้
ฐานข้อมูลเวกเตอร์เป็นแหล่งที่ใช้บ่อยในระบบ RAG แต่ไม่ใช่แหล่งความรู้เพียงประเภทเดียว RAG ระดับองค์กรอาจต้องอาศัยดัชนีค้นหา ฐานข้อมูลเชิงสัมพันธ์ คลังเอกสาร ระบบ CRM แพลตฟอร์ม Ticketing คลังข้อมูล หรือ API ภายในด้วย
สถาปัตยกรรมควรระบุให้ชัดว่าแหล่งใดเป็นแหล่งอ้างอิงหลักสำหรับคำถามแต่ละประเภท หากเอกสารผลิตภัณฑ์กับตั๋วสนับสนุนให้ข้อมูลไม่ตรงกัน Agent ต้องมีกฎว่าแหล่งใดมีลำดับความสำคัญกว่า หรือเมื่อใดควรส่งต่อให้มนุษย์
การจัดการ memory และ context
Memory ช่วยให้ Agent ติดตามสถานะของการสนทนาหรืองาน ส่วนบริบทที่ค้นคืนมาช่วยให้ Agent ตอบคำถามเฉพาะ สิ่งสองอย่างนี้ไม่ใช่สิ่งเดียวกัน
ระบบจริงควรแยก Memory ของเซสชัน ความชอบของผู้ใช้ เอกสารที่ค้นคืนมา สถานะการใช้เหตุผลระหว่างทาง และความรู้ระยะยาวออกจากกัน หากไม่แยกให้ชัด Agent อาจใช้บริบทที่ล้าสมัย หยิบรายละเอียดที่ไม่เกี่ยวข้องไปใช้ต่อ หรือผสมข้อความจากผู้ใช้เข้ากับข้อมูลจากแหล่งที่เชื่อถือได้
ชั้นเรียกใช้เครื่องมือ
การเรียกใช้เครื่องมือช่วยให้ agent โต้ตอบกับระบบนอกโมเดล ใน agentic RAG การใช้เครื่องมือควรได้รับข้อมูลจาก context ที่ retrieve มา ตัวอย่างเช่น agent อาจ retrieve นโยบายการรับประกันก่อนตัดสินใจว่าจะสร้างตั๋วคืนสินค้าหรือไม่ หรือ retrieve engineering runbook ก่อนร่างการตอบสนองเหตุการณ์ หลักการเดียวกันปรากฏในงานเชื่อมต่อแชตบอทในทางปฏิบัติ เช่น กรณีศึกษา การเชื่อมต่อ AI chatbot สำหรับตลาดดิจิทัล ของเรา ที่การตอบสนอง AI ต้องเชื่อมต่อกับเวิร์กโฟลว์ตลาดและแคมเปญแบบเรียลไทม์
เครื่องมือควรกำหนดขอบเขต ตรวจสอบความถูกต้อง และเชื่อมกับกฎธุรกิจที่ชัดเจน ผลการค้นคืนควรเป็นหลักฐานประกอบการกระทำ ไม่ใช่การอนุญาตให้ทำทุกอย่างโดยอัตโนมัติ
ชั้นการอ้างอิงและการยึดโยงคำตอบกับแหล่งข้อมูล
การยึดโยงคำตอบกับแหล่งข้อมูลคือการเชื่อมคำตอบของ Agent กลับไปยังหลักฐานที่ค้นคืนมา การอ้างอิงช่วยให้ผู้ใช้และผู้ตรวจสอบเข้าใจว่าคำตอบมาจากที่ใด และช่วยให้แก้ไขข้อผิดพลาดได้ง่ายขึ้น
คุณภาพของการอ้างอิงมีความสำคัญ การอ้างอิงไม่มีประโยชน์หากชี้ไปยังหน้าที่เกี่ยวข้องเพียงผิวเผิน แต่คำตอบจริงอาศัยอีกแหล่งหนึ่ง ระบบ Agentic RAG ที่แข็งแกร่งจะติดตามว่าส่วนข้อมูลใดที่ค้นคืนมาสนับสนุนข้อกล่าวอ้างใดอย่างแท้จริง
คอมโพเนนต์ guardrail การประเมิน และการตรวจสอบ
Guardrail การประเมิน และ Observability ควรเป็นส่วนหนึ่งของสถาปัตยกรรม ไม่ใช่สิ่งที่ค่อยเพิ่มภายหลัง ในสถาปัตยกรรม Guardrail กำหนดจุดควบคุมการเข้าถึงและการตรวจสอบ การประเมินกำหนดวิธีวัดคุณภาพ ส่วน Observability กำหนดสิ่งที่ทีมตรวจสอบได้เมื่อ Agent ทำงานผิดพลาด แนวทางนี้สอดคล้องกับ NIST AI Risk Management Framework ซึ่งสนับสนุนการออกแบบระบบ AI ให้มีความถูกต้อง ความน่าเชื่อถือ ความปลอดภัย ความมั่นคง ความโปร่งใส ความสามารถในการอธิบาย ความเป็นส่วนตัว และความเป็นธรรม
บทความนี้เน้นการควบคุมเฉพาะสำหรับ RAG หากต้องการศึกษาเรื่อง Prompt Injection สิทธิ์ของเครื่องมือ เวิร์กโฟลว์ Human-in-the-Loop ถิ่นที่อยู่ของข้อมูล และ Audit Log ในภาพรวม โปรดดูคู่มือความปลอดภัยของ LLM สำหรับ Agentic AI
วิธีสร้างระบบ Agentic RAG
การสร้างระบบ Agentic RAG ควรเริ่มจากเวิร์กโฟลว์ ไม่ใช่เริ่มจากโมเดล หากทีมของคุณกำลังหาวิธีสร้างระบบนี้ แนวทางที่น่าเชื่อถือที่สุดคือกำหนดผู้ใช้ แหล่งข้อมูล สิทธิ์ การกระทำ และเกณฑ์ความสำเร็จให้ชัดเจน ก่อนสร้างไปป์ไลน์ค้นคืนข้อมูลแรก
ขั้นที่ 1: กำหนดเวิร์กโฟลว์ทางธุรกิจ
เริ่มจากกำหนดว่า Agent ต้องช่วยงานใด เป้าหมายกว้าง ๆ อย่าง “ตอบคำถามเกี่ยวกับเอกสารของเรา” ยังไม่เพียงพอ นิยามเวิร์กโฟลว์ที่ชัดเจนกว่าอาจเป็น “ช่วยทีมสนับสนุนตอบคำถามลูกค้าเกี่ยวกับการตั้งค่าผลิตภัณฑ์ โดยใช้เอกสารที่อนุมัติ บันทึกการออกรุ่นล่าสุด และการตั้งค่าเฉพาะบัญชี”
ต้องระบุว่าใครจะใช้ระบบ ระบบเข้าถึงแหล่งใดได้บ้าง ทำอะไรได้บ้าง สิ่งใดห้ามทำ และกรณีใดต้องขออนุมัติจากมนุษย์ ควรกำหนดผลลัพธ์ที่วัดได้ด้วย เช่น ความแม่นยำของคำตอบ เวลาเฉลี่ยในการจัดการ คุณภาพของการส่งต่อ หรืออัตราการทำงานสำเร็จ
ขั้นที่ 2: เตรียมฐานความรู้
การเตรียมฐานความรู้มักเป็นส่วนที่ถูกประเมินต่ำเกินไปมากที่สุดของการพัฒนา RAG ทีมต้องระบุระบบต้นทางที่ได้รับอนุมัติ ลบเอกสารซ้ำหรือเก่าเกินไป รักษาข้อมูลเจ้าของเอกสาร เพิ่ม Metadata และกำหนดวิธีส่งต่อสิทธิ์จากระบบต้นทางมายังชั้นการค้นคืนข้อมูล
ขั้นตอนนี้ทำให้ข้อกำหนดด้านความเป็นปัจจุบันกลายเป็นงานที่จัดการได้จริง ผู้ช่วยด้านนโยบายอาจต้องอัปเดตทุกวัน ผู้ช่วยเอกสารผลิตภัณฑ์อาจต้องอัปเดตทุกครั้งที่มีการออกรุ่น และผู้ช่วย HR ภายในอาจต้องใช้การควบคุมเวอร์ชันเพื่อไม่ให้ตอบจากนโยบายที่เลิกใช้แล้ว
ขั้นที่ 3: ออกแบบ chunking และ retrieval
การตัดสินใจเรื่องการแบ่งส่วนข้อมูลและการค้นคืนควรสอดคล้องกับประเภทเนื้อหาและงานของผู้ใช้ เอกสารนโยบายยาว ๆ เอกสารอ้างอิง API ตั๋วสนับสนุน และแคตตาล็อกผลิตภัณฑ์มักต้องใช้กลยุทธ์การแบ่งส่วนและ Metadata ที่แตกต่างกัน
ทีมควรตัดสินใจว่าการค้นหาด้วยเวกเตอร์เพียงอย่างเดียวเพียงพอหรือจำเป็นต้องใช้ Hybrid Search รวมถึงพิจารณาว่า Reranking คุ้มกับต้นทุนและความหน่วงที่เพิ่มขึ้นหรือไม่ หากต้องมีการอ้างอิง ส่วนข้อมูลที่แบ่งไว้ควรรักษาบริบทให้เพียงพอเพื่อให้คำตอบเข้าใจได้และตรวจสอบย้อนหลังได้
เป้าหมายไม่ใช่ใช้เทคนิคการค้นคืนทุกแบบ แต่คือการค้นคืนบริบทชุดเล็กที่สุดที่มีประโยชน์ ได้รับอนุญาต เป็นปัจจุบัน และตรงกับแหล่งข้อมูล
ขั้นที่ 4: เพิ่มการจัดการ agent
เมื่อการค้นคืนข้อมูลทำงานได้กับคำถามตัวแทนแล้ว จึงเพิ่มการประสานงานของ Agent Agent อาจต้องเขียนคำค้นใหม่ ค้นจากแหล่งที่สอง ถามคำถามเพื่อขอรายละเอียด เรียกใช้เครื่องมือธุรกิจ หรือหยุดทำงานเมื่อระดับความมั่นใจต่ำเกินไป
การประสานงานที่ดีต้องมีเงื่อนไขหยุดที่ชัดเจน หากไม่มี Agent อาจวนเรียกการค้นคืนซ้ำ เพิ่มต้นทุน และยังสร้างคำตอบที่ไม่แน่นอน ควรออกแบบเส้นทางสำรองตั้งแต่ต้น เช่น ขอข้อมูลเพิ่มเติมจากผู้ใช้ แสดงตัวเลือกแหล่งข้อมูล ส่งต่อให้มนุษย์ หรือปฏิเสธเมื่อหลักฐานไม่เพียงพอ
ขั้นที่ 5: เพิ่ม guardrail เฉพาะ RAG
Guardrail เฉพาะ RAG มุ่งควบคุมเนื้อหาที่ค้นคืนมาและเวิร์กโฟลว์ที่เชื่อมกับแหล่งข้อมูล เอกสารที่ค้นคืนควรถูกมองเป็นข้อมูล ไม่ใช่คำสั่ง ระบบควรตรวจสอบแหล่งข้อมูล บังคับใช้สิทธิ์ก่อนส่งผลการค้นคืนให้โมเดล และจำกัดการเรียกใช้เครื่องมือตามบริบทที่ผ่านการตรวจสอบแล้ว
Agent ควรรู้ด้วยว่าต้องทำอย่างไรเมื่อแหล่งข้อมูลไม่เพียงพอ สำหรับเวิร์กโฟลว์ระดับองค์กร การปฏิเสธหรือส่งต่ออย่างปลอดภัยย่อมดีกว่าการให้คำตอบที่ฟังดูมั่นใจแต่ไม่มีหลักฐานรองรับเพียงพอ
ขั้นที่ 6: เตรียมการประเมินก่อนเปิดตัว
ก่อนเปิดตัว ให้เตรียมชุดข้อมูลประเมินและเกณฑ์อนุมัติการปล่อย ชุดข้อมูลควรมีคำถามทั่วไป เคสขอบเขต เคสที่เกี่ยวกับสิทธิ์ เอกสารล้าสมัย คำขอคลุมเครือ และเวิร์กโฟลว์ที่เชื่อมต่อกับเครื่องมือ
อย่ารอจนถึง Production จึงค่อยตัดสินใจว่า “คำตอบที่ดี” คืออะไร ควรกำหนดเกณฑ์ที่ยอมรับได้สำหรับความเกี่ยวข้องของผลการค้นคืน ความสอดคล้องกับแหล่งข้อมูล คุณภาพการอ้างอิง ความสำเร็จของงาน ความหน่วง และต้นทุน ก่อนที่ผู้ใช้จะเริ่มพึ่งพาระบบ
สรุปขั้นการใช้งานอย่างกระชับ
| ขั้น | เน้นหลัก |
|---|---|
| ค้นพบ | Use case แหล่งข้อมูล ความเสี่ยง และตัวชี้วัดความสำเร็จ |
| ต้นแบบ | Ingestion retrieval และการยึดโยงกับแหล่งข้อมูล |
| การจัดการ | การวางแผน การเรียกเครื่องมือ สำรอง และการอนุมัติมนุษย์ |
| การเสริมความแข็งแกร่ง | การประเมิน ความปลอดภัย สิทธิ์ และ guardrail |
| Production | การตรวจสอบ การควบคุมต้นทุน ผลตอบรับ และการบำรุงรักษา |
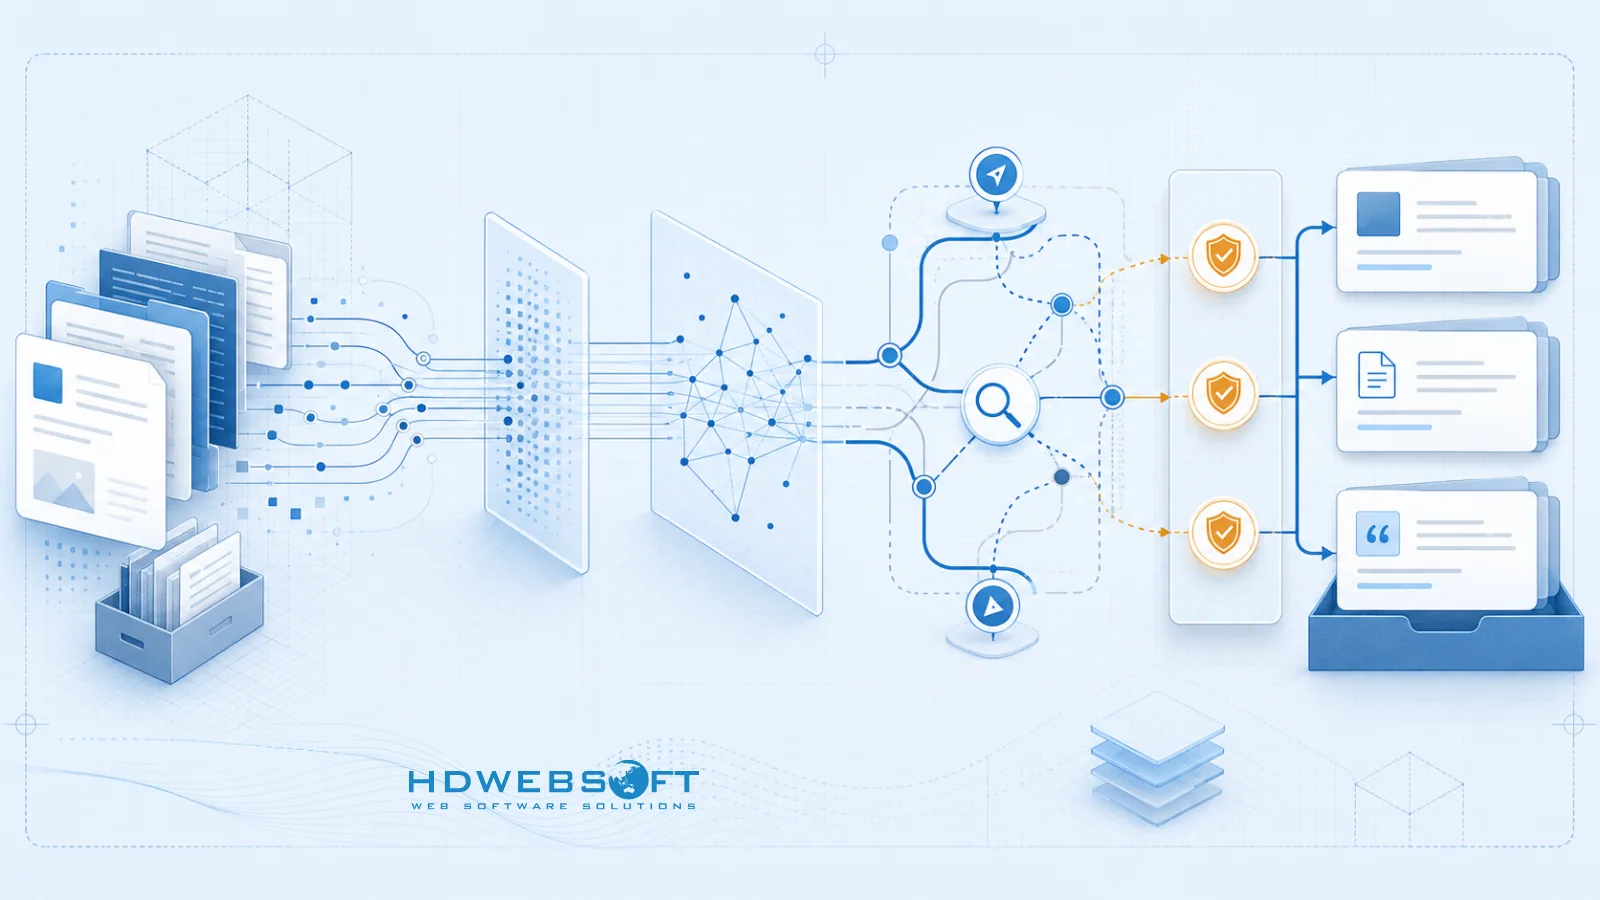
การประเมิน RAG: จะรู้ได้อย่างไรว่าทำงาน
การประเมิน RAG ควรตอบคำถามเชิงปฏิบัติว่า ระบบค้นคืนบริบทที่ถูกต้อง สร้างคำตอบที่สอดคล้องกับแหล่งข้อมูล ทำงานให้สำเร็จ และทำทั้งหมดนี้ภายใต้ขอบเขตต้นทุน ความหน่วง และสิทธิ์ที่ยอมรับได้หรือไม่ กรอบการประเมินอย่าง Ragas เป็นข้อมูลอ้างอิงที่มีประโยชน์ เพราะแยกความสอดคล้องกับแหล่งข้อมูล ความเกี่ยวข้องของคำตอบ และคุณภาพของบริบท แทนการรวมทุกอย่างเป็นคะแนน “คำตอบที่ดี” เพียงค่าเดียว
ประเด็นนี้กว้างกว่าการทดสอบแชตบอต แชตบอตอาจวัดจากคุณภาพคำตอบเป็นหลัก แต่ระบบ Agentic RAG ต้องวัดคุณภาพการค้นคืน การยึดโยงกับแหล่งข้อมูล พฤติกรรมการใช้เครื่องมือ ผลลัพธ์ของเวิร์กโฟลว์ และความน่าเชื่อถือในการดำเนินงานด้วย
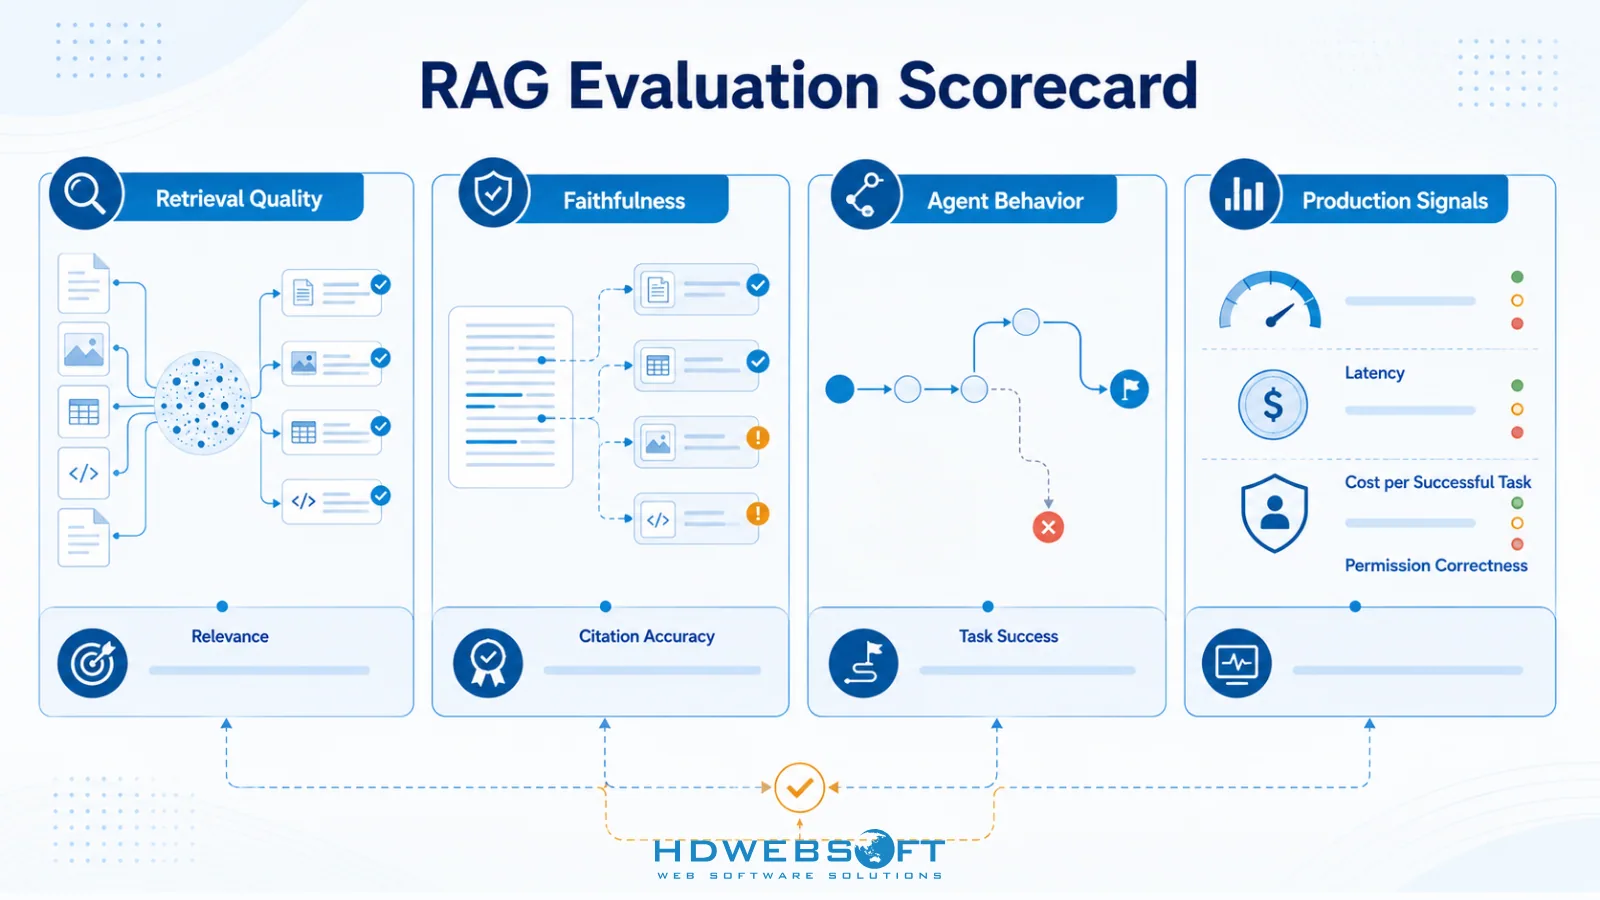
ทำไมการประเมิน RAG ยากกว่าการทดสอบแชตบอท
ระบบ RAG อาจล้มเหลวได้หลายรูปแบบ เช่น ค้นคืนจากแหล่งผิด ค้นคืนแหล่งถูกแต่ไม่ใช้ข้อมูลนั้น อ้างอิงแหล่งที่ไม่สนับสนุนคำตอบ ตอบถูกแต่ละเมิดสิทธิ์ หรือทำงานสำเร็จแต่เรียกใช้เครื่องมือมากเกินไปจนช้าและมีต้นทุนสูง
การแยกสาเหตุของความล้มเหลวเหล่านี้สำคัญ เพราะแต่ละแบบต้องแก้ด้วยวิธีต่างกัน พรอมป์ที่ดีขึ้นไม่ช่วยแก้ปัญหาตัวกรองสิทธิ์ที่หายไป และฐานข้อมูลเวกเตอร์ที่ดีขึ้นก็ไม่ช่วยแก้ Agent ที่เรียกใช้เครื่องมือผิด
ตัวชี้วัด retrieval
ตัวชี้วัด retrieval แสดงว่าระบบพบ context ที่มีประโยชน์ก่อนการสร้างเริ่มหรือไม่
- Recall@K แสดงว่าแหล่งที่ถูกต้องปรากฏในผลลัพธ์ retrieval สูงสุดหรือไม่ สำคัญเพราะโมเดลไม่สามารถใช้หลักฐานที่ไม่เคยถูก retrieve
- Precision@K แสดงว่าชุดที่ retrieve มามีประโยชน์จริงเท่าใด สำคัญเพราะ context ที่มีสัญญาณรบกวนสามารถสับสนโมเดลและเพิ่มต้นทุน
- MRR แสดงว่าแหล่งที่ดีที่สุดปรากฏใกล้ด้านบนหรือไม่ สำคัญเพราะผลลัพธ์ที่จัดอันดับสูงมักได้รับความสนใจมากขึ้นใน prompt สุดท้ายหรือกระแส reranking
- NDCG ช่วยประเมินว่าลำดับการจัดอันดับมีประโยชน์เมื่อแหล่งบางแหล่งเกี่ยวข้องมากกว่าแหล่งอื่น สำคัญสำหรับคำถามที่ซับซ้อนที่เอกสารหลายฉบับอาจช่วยได้บางส่วน
สำหรับการใช้งานระดับองค์กร ควรใช้ตัวชี้วัดการจัดอันดับร่วมกับการตรวจสอบเชิงปฏิบัติ ได้แก่ ความเกี่ยวข้องของผลการค้นคืน ความครอบคลุมของแหล่งข้อมูล ความเป็นปัจจุบัน และการตรวจสอบสิทธิ์ที่ถูกต้อง เอกสารที่เกี่ยวข้องในทางเทคนิคก็ยังไม่ควรถูกนำมาใช้ หากผู้ใช้ไม่มีสิทธิ์เข้าถึง
ตัวชี้วัดการสร้างและพื้นฐาน
ตัวชี้วัดการสร้างแสดงว่าโมเดลใช้ context ที่ retrieve มาอย่างถูกต้องหรือไม่
- ความสอดคล้องกับแหล่งข้อมูล ตรวจสอบว่าคำตอบได้รับการสนับสนุนจากแหล่งที่ retrieve มาหรือไม่
- ความเกี่ยวข้องของคำตอบ ตรวจสอบว่าการตอบสนองตอบคำถามของผู้ใช้จริงๆ หรือไม่
- ความแม่นยำของการอ้างอิง ตรวจสอบว่าแหล่งที่อ้างอิงสนับสนุนข้ออ้างสิทธิ์ที่แนบไปหรือไม่
- อัตรา hallucination ติดตามข้ออ้างสิทธิ์ที่ไม่ได้รับการสนับสนุนหรือที่ประดิษฐ์ขึ้น
- ความสมบูรณ์ ตรวจสอบว่าคำตอบครอบคลุมส่วนที่จำเป็นของงานหรือไม่
- ความถูกต้องของการปฏิเสธ ตรวจสอบว่าระบบปฏิเสธหรือส่งต่อเมื่อแหล่งไม่เพียงพอหรือไม่
สำหรับ Agentic RAG ความแม่นยำของการอ้างอิงมักมีประโยชน์มากกว่าคะแนน “คำตอบที่ดี” แบบกว้าง ๆ ผู้ใช้ทางธุรกิจต้องรู้ไม่ใช่เพียงว่าคำตอบฟังดูถูกต้อง แต่ยังต้องรู้ว่าคำตอบอ้างอิงจากแหล่งที่ถูกต้องหรือไม่
ตัวชี้วัดพฤติกรรม agent
ตัวชี้วัดพฤติกรรม agent ประเมินว่าระบบทำเวิร์กโฟลว์ให้สำเร็จหรือไม่ ไม่ใช่เพียงว่าเขียนย่อหน้าที่ดีหรือไม่
ตัวชี้วัดสำคัญ ได้แก่ อัตราความสำเร็จของงาน ความแม่นยำในการเรียกใช้เครื่องมือ ความแม่นยำของการส่งต่อ อัตราที่มนุษย์ต้องแทรกแซง อัตราการกู้คืนจากความล้มเหลว และจำนวนขั้นตอนเฉลี่ย จำนวนขั้นตอนไม่ได้ดีหรือแย่โดยตัวมันเอง แต่ช่วยเปิดเผยการประสานงานที่ไม่มีประสิทธิภาพ หากงานง่ายต้องเรียกค้นข้อมูลและเครื่องมือหลายครั้ง ระบบอาจช้าหรือแพงเกินไปสำหรับ Production
ความแม่นยำของการเรียกเครื่องมือสมควรได้รับความสนใจพิเศษ agent สนับสนุนที่ retrieve นโยบายคืนเงินที่ถูกต้องแต่เปิดประเภทตั๋วผิดยังล้มเหลวเวิร์กโฟลว์
ตัวชี้วัดคุณภาพการดำเนินงาน
ตัวชี้วัดการดำเนินงานแสดงว่าระบบใช้งานได้ในระดับใหญ่หรือไม่ ติดตาม latency ต้นทุนต่องานที่สำเร็จ อัตราข้อผิดพลาด อัตราความล้มเหลวของ retrieval ผลตอบรับของผู้ใช้ และอัตราความล้มเหลวจาก regression
ต้นทุนต่องานที่สำเร็จมีประโยชน์มากกว่าการดูปริมาณโทเคนที่ใช้เพียงอย่างเดียว ระบบที่มีต้นทุนต่อคำขอสูงกว่าอาจยังคุ้มค่า หากทำเวิร์กโฟลว์สำคัญให้สำเร็จอย่างน่าเชื่อถือ ขณะที่ระบบราคาถูกกว่าอาจแย่กว่า หากสร้างงานแก้ไขซ้ำ การส่งต่อ หรือคำตอบที่ไม่ถูกต้อง
การออกแบบชุดข้อมูลการประเมิน
ชุดข้อมูลประเมินที่มีประโยชน์ควรสะท้อนการใช้งานจริงขององค์กร ไม่ใช่มีเพียงคำถามในอุดมคติ สำหรับทีมที่กำลังวางแผนประเมินระบบ RAG ชุดข้อมูลควรมีคู่คำถาม-คำตอบมาตรฐาน คำถามจากผู้ใช้จริง เคสขอบเขต คำขอคลุมเครือ สถานการณ์ที่เกี่ยวกับสิทธิ์ เอกสารล้าสมัย และเนื้อหาที่ค้นคืนซึ่งพยายามชักนำระบบไปในทางที่ผิด
หาก agent ใช้เครื่องมือ รวมเคสเวิร์กโฟลว์ที่เชื่อมต่อเครื่องมือ ตัวอย่างเช่น ทดสอบว่า agent สามารถ retrieve นโยบาย ตัดสินใจว่าต้องมีการอนุมัติของมนุษย์ และหลีกเลี่ยงการเรียกเครื่องมือกระทำก่อนกำหนดหรือไม่
ชุดข้อมูลควรพัฒนาหลังเปิดตัว ผลตอบรับจาก production คำถามที่ล้มเหลว อัตราที่มนุษย์ต้องแทรกแซง และการส่งต่อสนับสนุนควรกลายเป็นเคส regression ใหม่
การประเมินโดยมนุษย์และการประเมินอัตโนมัติ
การประเมินอัตโนมัติมีประโยชน์ต่อการทดสอบ Regression และการทำซ้ำอย่างรวดเร็ว แนวทาง LLM-as-Judge ช่วยตรวจสอบความเกี่ยวข้องของคำตอบหรือความสอดคล้องกับแหล่งข้อมูลได้ แต่ไม่ควรเป็นเกณฑ์คุณภาพเพียงอย่างเดียวสำหรับเวิร์กโฟลว์ที่มีความเสี่ยงสูง
การตรวจสอบโดยมนุษย์ยังสำคัญเมื่อคำตอบกระทบลูกค้า เงิน การปฏิบัติตามกฎระเบียบ ความปลอดภัย หรือการตัดสินใจภายใน แนวทางที่ใช้งานได้มักเป็นแบบหลายชั้น: การตรวจสอบอัตโนมัติสำหรับทุกการเปลี่ยนแปลง การตรวจสอบโดยมนุษย์แบบสุ่มสำหรับคุณภาพ และการตรวจสอบที่ลึกขึ้นสำหรับเวิร์กโฟลว์ที่มีความเสี่ยงสูง
การปรับใช้ RAG ใน Production
การนำ RAG ไปใช้ใน Production คือการบริหารระบบที่สร้างเสร็จแล้วให้ทำงานได้อย่างน่าเชื่อถือ ประเด็นหลัก ได้แก่ การนำเข้าข้อมูลอย่างปลอดภัย การตรวจสอบ การแจ้งเตือน การควบคุมการเข้าถึง ความเป็นปัจจุบันของความรู้ ต้นทุน ความหน่วง และการกู้คืนจากความล้มเหลว
รายการตรวจสอบสถาปัตยกรรม production
สภาพแวดล้อม RAG ใน production ควรรวมถึง:
- ไปป์ไลน์ ingestion และ refresh ที่ปลอดภัย
- การแยกสภาพแวดล้อมสำหรับ development, staging และ production
- การบังคับการควบคุมการเข้าถึงใน retrieval
- การสำรองและกู้คืน vector index
- การตรวจสอบและการแจ้งเตือน
- การควบคุมต้นทุน
- เส้นทางสำรอง
- การส่งต่อมนุษย์
- การตอบสนองเหตุการณ์
- การประเมินอย่างต่อเนื่อง
เป้าหมายไม่ใช่ทำให้ระบบซับซ้อน แต่คือทำให้ความล้มเหลวมองเห็นได้ ควบคุมได้ และกู้คืนได้
Ingestion ที่ปลอดภัยและความเป็นปัจจุบันของความรู้
ความเป็นปัจจุบันของความรู้เป็นความรับผิดชอบของ Production หากเอกสารต้นทางเปลี่ยนแต่ดัชนีไม่อัปเดต Agent อาจตอบจากข้อมูลเก่า ระบบจริงจึงต้องมีงานอัปเดตตามกำหนด การแจ้งเตือนเมื่อการนำเข้าข้อมูลล้มเหลว การควบคุมเวอร์ชันเอกสาร และการระบุเจ้าของแหล่งข้อมูลอย่างชัดเจน
การซิงค์สิทธิ์สำคัญไม่แพ้การซิงค์เนื้อหา หากผู้ใช้สูญเสียสิทธิ์เข้าถึงเอกสารในระบบต้นทาง ชั้นการค้นคืนข้อมูลควรสะท้อนการเปลี่ยนแปลงได้เร็วพอตามระดับความเสี่ยงของเวิร์กโฟลว์
การตรวจสอบและการแจ้งเตือน
การตรวจสอบควรทำให้สามารถวินิจฉัยความล้มเหลวของ RAG ได้ ทีมควรตรวจสอบคำถามของผู้ใช้ ส่วนข้อมูลที่ค้นคืน Metadata ของแหล่ง การอ้างอิง การเรียกใช้เครื่องมือ ความหน่วง ต้นทุน และคำตอบสุดท้ายได้
การแจ้งเตือนที่มีประโยชน์ ได้แก่ การเพิ่มขึ้นของผลการค้นคืนที่ว่างเปล่า ความล้มเหลวในการอ้างอิง การเรียกใช้เครื่องมือที่ล้มเหลว งานนำเข้าข้อมูลที่ล้มเหลว ต้นทุนพุ่งผิดปกติ ความหน่วงแย่ลง แนวโน้มความคิดเห็นเชิงลบ และสัญญาณว่าคุณภาพลดลง
การควบคุมการเข้าถึงและการกำกับดูแลใน production
การควบคุมการเข้าถึงต้องดำเนินต่อหลังเปิดตัว ทีม Production ควรตรวจสอบสิทธิ์ที่ไม่ตรงกัน ปัญหาการแยก Tenant การจัดการเอกสารสำคัญ และการเปลี่ยนแปลงบทบาทในระบบต้นทาง งานวิจัย Cost of a Data Breach ปี 2025 ของ IBM ระบุว่า 13% ขององค์กรประสบเหตุละเมิดที่เกี่ยวข้องกับโมเดลหรือแอปพลิเคชัน AI และ 97% ขององค์กรกลุ่มนั้นขาดการควบคุมการเข้าถึง AI ที่เหมาะสม จึงเห็นได้ว่าสิทธิ์ของการค้นคืนและการอนุญาตใช้เครื่องมือเป็นมาตรการควบคุมการดำเนินงาน ไม่ใช่ตัวเลือกเสริม
เรื่องนี้สำคัญเป็นพิเศษสำหรับ SaaS แบบหลาย Tenant อุตสาหกรรมที่อยู่ภายใต้การกำกับดูแล เครื่องมือ HR ภายใน ฐานความรู้ด้านกฎหมาย และระบบสนับสนุนเฉพาะลูกค้า ในกรณีเหล่านี้ ผลการค้นคืนที่ผิดอาจกลายเป็นเหตุข้อมูลรั่วไหล ไม่ใช่เพียงปัญหาคุณภาพคำตอบ
การเพิ่มประสิทธิภาพต้นทุนและ latency
ระบบ RAG อาจมีต้นทุนสูงขึ้นเมื่อค้นคืนข้อมูลมากเกินไปทำ Reranking บ่อยเกินไป ใช้โมเดลขนาดใหญ่กับงาน Routing ง่าย ๆ หรือปล่อยให้ Agent วนผ่านขั้นตอนที่ไม่จำเป็น
แนวทางเพิ่มประสิทธิภาพที่ใช้ได้จริง ได้แก่ แคชผลการค้นคืนที่พบบ่อย ใช้โมเดลขนาดเล็กสำหรับ Routing บีบอัดบริบท ปรับ Threshold ของการค้นคืน ทำ Embedding แบบ Batch และใช้ Reranking เฉพาะเมื่อคุณภาพที่เพิ่มขึ้นคุ้มกับต้นทุน
ควรวัดความหน่วงจากมุมมองของผู้ใช้ สถาปัตยกรรมที่ดูดีทางเทคนิคยังไม่พร้อมใช้งานจริง หากผู้ใช้เลิกใช้งานเพราะทุกคำตอบใช้เวลานานเกินไป
การจัดการความล้มเหลวและการตอบสนองเหตุการณ์
ความล้มเหลวที่พบบ่อยใน Production ได้แก่ การค้นคืนจากแหล่งผิด การค้นคืนแหล่งถูกแต่คำตอบไม่มีหลักฐานรองรับ การอ้างอิงหายไป ความรู้ล้าสมัย สิทธิ์ไม่ตรงกัน การเรียกใช้เครื่องมือผิดพลาด และต้นทุนพุ่งสูง
ความล้มเหลวแต่ละแบบต้องมีเส้นทางรับมือ ระบบอาจขอข้อมูลเพิ่ม ปฏิเสธ ส่งต่อให้มนุษย์ ปิดเครื่องมือ ย้อนกลับการอัปเดตดัชนี หรือเปลี่ยนเส้นทางไปยังระบบสำรองที่ปลอดภัยกว่า ทีมควรกำหนดเจ้าของเหตุการณ์แต่ละประเภทให้ชัดเจนก่อนระบบมีความสำคัญต่อธุรกิจ
การประเมินอย่างต่อเนื่อง
ผลตอบรับจาก production ควรป้อนการประเมินอย่างต่อเนื่อง สุ่มคำถามจริง ตรวจสอบคำตอบที่ล้มเหลว เพิ่มการทดสอบ regression และต้องการการตรวจสอบคุณภาพก่อนการเปลี่ยนแปลง prompt, retrieval, โมเดล หรือ index ถูกปล่อย
ตัวชี้วัดการประเมินไม่ต้องถูกแสดงซ้ำในทุกการตรวจสอบ production สิ่งที่สำคัญคือระบบมีเกณฑ์คุณภาพและการเปลี่ยนแปลงถูกวัดเทียบกับเกณฑ์เหล่านั้น
ความผิดพลาดทั่วไปของ Agentic RAG
โครงการ Agentic RAG มักล้มเหลวจากเหตุผลเชิงปฏิบัติ เช่น เวิร์กโฟลว์ไม่ชัดเจน คุณภาพแหล่งข้อมูลต่ำ สิทธิ์ไม่ครบ การประเมินไม่เพียงพอ หรือการใช้เครื่องมือโดยไม่มีการควบคุม ปัญหาเหล่านี้หลีกเลี่ยงได้ หากทีมมอง RAG เป็นระบบ Production ไม่ใช่เพียงเดโมค้นหา
ปฏิบัติต่อ RAG เป็นเพียง vector search
การค้นหาด้วยเวกเตอร์เป็นเพียงส่วนหนึ่งของระบบ หาก Agent ไม่เข้าใจเวิร์กโฟลว์ เคารพสิทธิ์ อ้างอิงแหล่งข้อมูล หรือตัดสินใจได้ว่าเมื่อใดควรส่งต่อ ก็จะไม่ทำงานเหมือนผู้ช่วยระดับองค์กรที่น่าเชื่อถือ
แนวทางแก้คือออกแบบจากงานทางธุรกิจก่อน แล้วจึงเลือกวิธีการค้นคืนที่สนับสนุนงานนั้น
ข้ามการประเมินจนหลังเปิดตัว
หากไม่มีการประเมิน ทีมมักค้นพบช่องว่างของการค้นคืน อาการหลอน และปัญหาการอ้างอิงก็ต่อเมื่อผู้ใช้เริ่มพึ่งพาระบบแล้ว
การแก้ไขคือเตรียมเคสการประเมินและเกณฑ์การปล่อยก่อนเปิดตัว จากนั้นขยายด้วยผลตอบรับจาก production
ใช้กลยุทธ์ retrieval เดียวสำหรับทุกคำถาม
คำถาม FAQ ง่าย ๆ คำถามด้านการปฏิบัติตามข้อกำหนด และเวิร์กโฟลว์สนับสนุนลูกค้าหลายขั้นตอนไม่ควรใช้เส้นทางค้นคืนเดียวกันเสมอไป กลยุทธ์เดียวอาจแพงเกินไปสำหรับเคสง่ายและตื้นเกินไปสำหรับเคสซับซ้อน
แนวทางแก้คือเลือกเส้นทางตามเจตนา ประเภทเอกสาร ระดับความเสี่ยง และข้อกำหนดของแหล่งข้อมูล
ละเลยสิทธิ์ของแหล่ง
เอกสารที่ค้นคืนมาอาจเกี่ยวข้องแต่ยังไม่ปลอดภัยที่จะนำไปใช้ หากผู้ใช้ไม่มีสิทธิ์เข้าถึง Agent ก็ไม่ควรเห็นเอกสารนั้นเช่นกัน
แนวทางแก้คือต้องรักษาสิทธิ์ตั้งแต่การนำเข้าข้อมูล บังคับใช้สิทธิ์ระหว่างการค้นคืน และตรวจสอบสิทธิ์ใน Production
ปล่อยให้ agent กระทำโดยไม่มีขอบเขต
เวิร์กโฟลว์ RAG ที่เชื่อมต่อเครื่องมืออาจล้มเหลวเมื่อ Agent ลงมือทำจากบริบทที่มีหลักฐานอ่อน เอกสารที่ค้นคืนมาอาจล้าสมัย ไม่ครบถ้วน หรือไม่เกี่ยวข้องกับการกระทำที่ร้องขอ
แนวทางแก้คือตรวจสอบ Input ของเครื่องมือ ต้องใช้หลักฐานที่รัดกุมกว่าสำหรับการกระทำที่มีความเสี่ยงสูง เพิ่มเส้นทางสำรอง และใช้การอนุมัติจากมนุษย์เมื่อเหมาะสม
สร้างภายในหรือจ้างพันธมิตร?
บางทีมควรสร้าง Agentic RAG เองภายในองค์กร ขณะที่บางทีมจะส่งมอบได้เร็วขึ้นและลดความเสี่ยงด้วยการทำงานร่วมกับพันธมิตรพัฒนา AI ที่มีประสบการณ์
ควรสร้างภายในเมื่อมีวิศวกร AI/ML และ Platform ที่แข็งแกร่ง ทีมสนับสนุนด้านความปลอดภัย ผู้รับผิดชอบการกำกับดูแลข้อมูล และความสามารถในการดูแลระบบหลังเปิดตัว แนวทางนี้เหมาะเมื่อ Agentic RAG เป็นส่วนหนึ่งของแพลตฟอร์ม AI เชิงกลยุทธ์ระยะยาว
ควรพิจารณาจ้างพันธมิตรเมื่อจำเป็นต้องส่งมอบระบบจริงเร็วขึ้น ต้องการประสบการณ์ด้านสถาปัตยกรรมการค้นคืน การสนับสนุนการประเมิน การผสานรวมระดับองค์กร หรือการถ่ายทอดความรู้ให้ทีมภายใน Agentic RAG ต้องการมากกว่าการเชื่อม LLM เข้ากับฐานข้อมูลเวกเตอร์ แต่ยังรวมถึงการออกแบบเวิร์กโฟลว์ การนำเข้าข้อมูล สิทธิ์ การประสานงาน การประเมิน การตรวจสอบ และการปรับปรุงต่อเนื่อง
HDWEBSOFT ช่วยทีมออกแบบ สร้าง ประเมิน และนำระบบ Agentic RAG ไปใช้กับเวิร์กโฟลว์ระดับองค์กร เราสนับสนุนได้ตั้งแต่สถาปัตยกรรมการค้นคืน การนำเข้าความรู้ การประสานงาน การเชื่อมต่อเครื่องมือ การประเมิน การตรวจสอบใน Production ไปจนถึงการบำรุงรักษาระยะยาว ผ่านบริการพัฒนา AI, บริการเชื่อมต่อ AI และบริการพัฒนา AI Chatbot
บทสรุป
Agentic RAG เป็นมากกว่าการเพิ่มการค้นหาด้วยเวกเตอร์ให้ LLM แต่เป็นสถาปัตยกรรมที่ช่วยให้ AI agent เข้าถึงความรู้ที่มีแหล่งอ้างอิง คำนึงถึงสิทธิ์ และใช้ข้อมูลในเวิร์กโฟลว์ธุรกิจได้อย่างควบคุม
RAG มักเป็นรากฐานที่เหมาะสมเมื่อความรู้เป็นส่วนตัว เปลี่ยนแปลง และต้องอ้างอิงแหล่งที่มา ส่วน Fine-tuning ยังมีประโยชน์เมื่อระบบต้องการพฤติกรรม รูปแบบ หรือรูปแบบการตอบสนองเฉพาะโดเมนที่สม่ำเสมอ ระบบ Production ที่แข็งแกร่งมักใช้ทั้งสองแนวทาง แล้วตรวจสอบคุณภาพด้วยการประเมินและรักษาความน่าเชื่อถือด้วยการดำเนินงานจริง
หากองค์กรกำลังวางแผนสร้างระบบ Agentic RAG ให้เริ่มจากเวิร์กโฟลว์ คุณภาพของแหล่งข้อมูล สิทธิ์ และตัวชี้วัดความสำเร็จ จากนั้นจึงออกแบบชั้นการค้นคืนและการประสานงานให้สอดคล้องกับข้อกำหนดเหล่านั้น เมื่อระบบต้องรองรับผู้ใช้ ข้อมูล และการกระทำทางธุรกิจจริง สถาปัตยกรรมที่รอบคอบและวินัยในการนำระบบไปใช้จริงสำคัญกว่าเดโมที่สร้างได้รวดเร็ว
หากต้องการความช่วยเหลือด้านการออกแบบหรือนำระบบ Agentic RAG ไปใช้ HDWEBSOFT พร้อมช่วยพาคุณจากแนวคิดสู่ Production ด้วยวิศวกรรม การประเมิน และการผสานรวมที่ใช้งานได้จริง
FAQ
Agentic RAG คืออะไร?
Agentic RAG คือสถาปัตยกรรม Retrieval-Augmented Generation ที่ AI agent สามารถวางแผนขั้นตอนการค้นคืนข้อมูล สอบถามแหล่งความรู้ ใช้เครื่องมือ ใช้เหตุผลกับบริบทที่ค้นคืนมา และตัดสินใจว่าจะตอบ ค้นข้อมูลเพิ่มเติม หรือส่งต่อให้มนุษย์
Agentic RAG แตกต่างจาก standard RAG อย่างไร?
Standard RAG มักค้นคืนข้อมูลหนึ่งครั้งก่อนสร้างคำตอบ ส่วน Agentic RAG สามารถวางแผน ค้นคืนข้อมูลหลายรอบ ประเมินว่าบริบทเพียงพอหรือไม่ เรียกใช้เครื่องมือ และปรับขั้นตอนถัดไปตามเวิร์กโฟลว์
RAG ดีกว่า fine-tuning สำหรับ AI agent หรือไม่?
RAG มักเหมาะกว่าสำหรับความรู้ส่วนตัวที่เปลี่ยนแปลงและต้องอ้างอิงแหล่งที่มา ส่วน Fine-tuning เหมาะกับพฤติกรรม น้ำเสียง รูปแบบ หรือรูปแบบการตอบสนองเฉพาะโดเมนที่ต้องการให้สม่ำเสมอ ระบบ Production จำนวนมากใช้ทั้งสองแนวทาง
จะสร้างระบบ agentic RAG ได้อย่างไร?
เริ่มจากเวิร์กโฟลว์ทางธุรกิจ เตรียมฐานความรู้ ออกแบบการแบ่งส่วนข้อมูลและการค้นคืน เพิ่มการประสานงาน วาง Guardrail เฉพาะสำหรับ RAG และกำหนดเกณฑ์การประเมินก่อนเปิดตัว
จะประเมินระบบ RAG ได้อย่างไร?
ประเมินความเกี่ยวข้องของผลการค้นคืน ความสอดคล้องกับแหล่งข้อมูล ความแม่นยำของการอ้างอิง อัตราความสำเร็จของงาน ความแม่นยำในการเรียกใช้เครื่องมือ การตรวจสอบสิทธิ์ ความหน่วง และต้นทุนต่องานที่สำเร็จ โดยใช้กรณีทดสอบระดับองค์กรที่สมจริง
จะปรับใช้ RAG ใน production ได้อย่างไร?
RAG ใน Production ต้องมีไปป์ไลน์นำเข้าและอัปเดตข้อมูลที่ปลอดภัย การตรวจสอบ การแจ้งเตือน การควบคุมการเข้าถึง การตรวจสอบความเป็นปัจจุบันของความรู้ การสำรองและกู้คืน การควบคุมต้นทุน เส้นทางสำรอง และการประเมินอย่างต่อเนื่อง