L’ottimizzazione delle prestazioni web per il Black Friday combina load testing con traffico realistico, ottimizzazione di frontend e backend, ingegneria dell’affidabilità per checkout e pagamenti, e sincronizzazione accurata dell’inventario su tutti i canali di vendita. La velocità di caricamento da sola non determina se il vostro negozio sopravvive al traffico di picco — ciò che conta è che l’intero percorso di transazione, dalla navigazione dei prodotti all’ordine confermato, regga quando migliaia di clienti agiscono contemporaneamente.
Per le aziende e-commerce, eventi come il Black Friday, il Cyber Monday e i flash sale stagionali sono le finestre operative più critiche dell’anno. Questa guida spiega come valutare, testare e rafforzare la vostra piattaforma prima che arrivi il traffico — concentrandosi sulle tre aree di fallimento che costano più fatturato: degradazione delle prestazioni, errori di checkout e pagamento, e problemi di sincronizzazione dell’inventario.
Mentre un’architettura e-commerce headless scalabile fornisce le fondamenta per gestire traffico elevato, la readiness operativa richiede attenzione aggiuntiva a load testing, affidabilità del checkout e sincronizzazione dell’inventario. Questo articolo riguarda il lato operativo: come testare ciò che avete, trovare dove si rompe e sistemarlo prima che siano i clienti a scoprirlo.
Punti Chiave
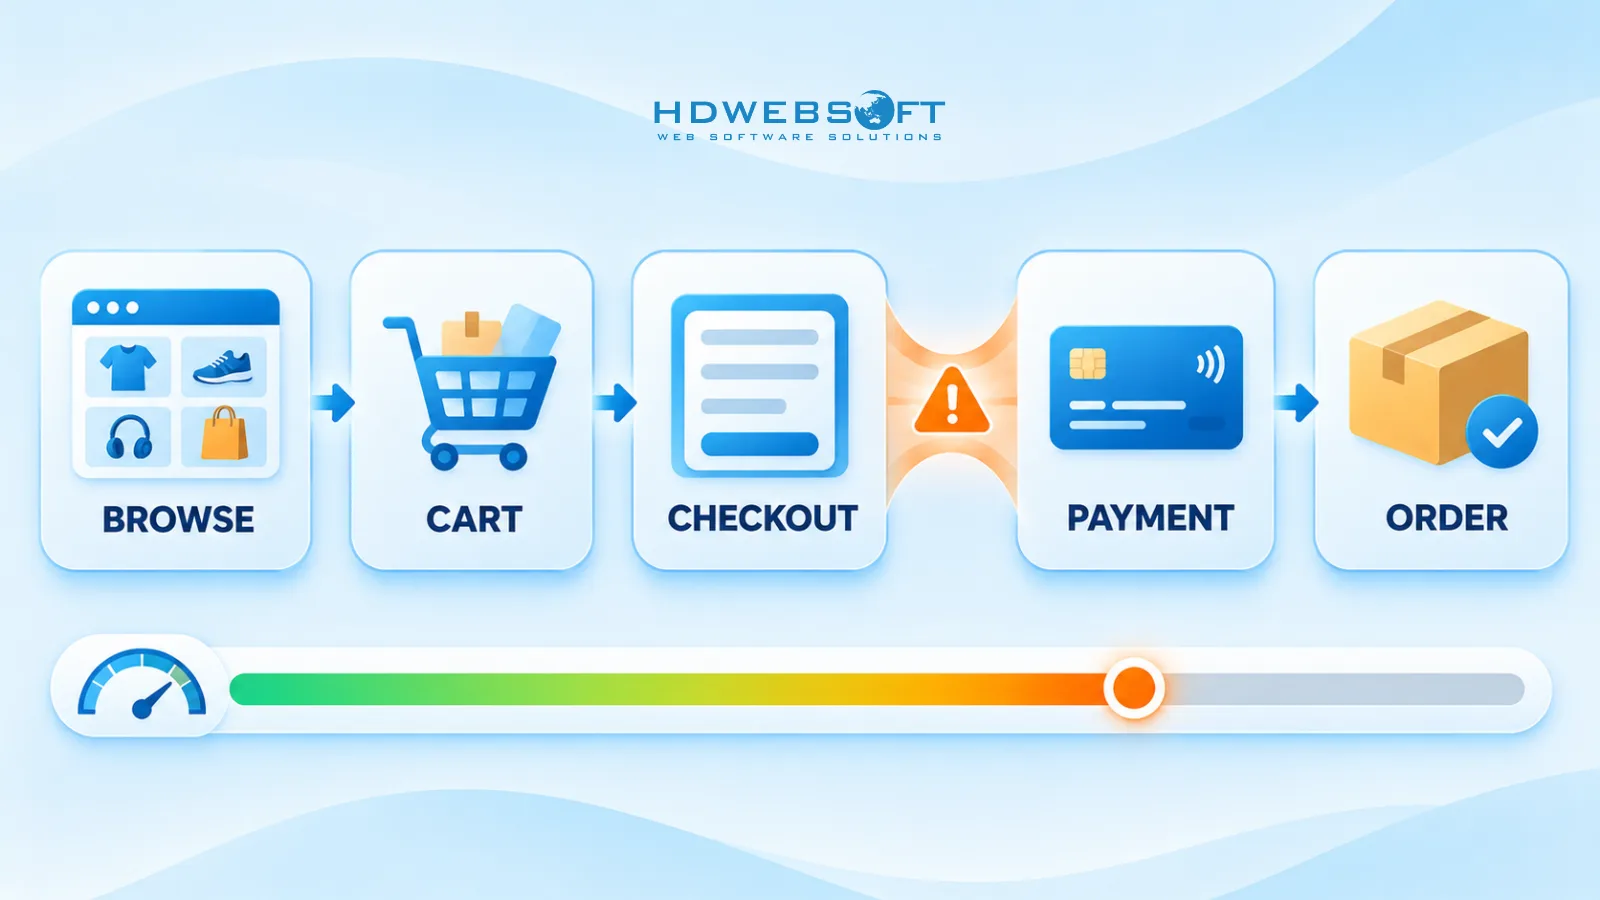
- Le prestazioni web del Black Friday sono un problema di percorso di transazione, non solo di velocità della pagina — l’affidabilità del checkout e la precisione dell’inventario contano quanto i tempi di caricamento.
- I load test devono simulare i percorsi reali degli utenti (navigazione → carrello → checkout → pagamento), non richieste alla homepage, altrimenti mancano i colli di bottiglia che falliscono davvero.
- Le richieste di pagamento idempotenti e i timeout del gateway gestiti con eleganza prevengono gli addebiti duplicati e gli ordini falliti che esplodono sotto alta concorrenza di checkout.
- L’overselling è una race condition — la prenotazione dello stock al checkout più la sincronizzazione event-driven tra canali sono la soluzione affidabile.
- Una checklist di readiness con criteri di successo verificabili batte un vago “abbiamo testato” — e la revisione post-vendita trasforma ogni campagna in dati per la prossima.
Perché il Black Friday Espone i Colli di Bottiglia dell’E-Commerce
Durante un evento di vendita di picco accadono due cose contemporaneamente che non succedono in un giorno normale.
Primo, il volume di traffico si moltiplica. Campagne di marketing, invii email e pubblicità a pagamento si attivano tutte allo stesso orario, comprimendo settimane di traffico tipico in poche ore. Secondo — ed è ciò che i team sottovalutano — la concorrenza transazionale si moltiplica ancora più velocemente. Durante un flash sale, una quota sproporzionata di visitatori fa la stessa cosa contemporaneamente: visita gli stessi prodotti in promozione, li aggiunge al carrello e va al checkout in una finestra ristretta.
Questa distinzione conta perché diverse parti del sistema assorbono pressioni diverse. L’alto volume di traffico stressa frontend, CDN e API del catalogo. L’alta concorrenza transazionale stressa il percorso di checkout, le chiamate al gateway di pagamento, le scritture dell’inventario e l’elaborazione degli ordini — le parti più difficili da mettere in cache e le più costose quando si rompono.
Le modalità di fallimento seguono in modo prevedibile: ritardi di caricamento del frontend e aumento della latenza API quando le risorse condivise saturano, pool di connessioni e lock del database che diventano colli di bottiglia sotto pressione di scrittura, errori tecnici del checkout che si traducono direttamente in fatturato perso e carrelli abbandonati, e race condition di inventario in cui due clienti acquistano la stessa ultima unità. I provider di pagamento aggiungono i propri vincoli — timeout, rate limit e occasionali degradazioni del servizio proprio quando il vostro volume raggiunge il picco.
Niente di tutto questo è misterioso. Tutto è testabile in anticipo, ed è questo il punto delle sezioni seguenti.
Ottimizzazione delle Prestazioni E-Commerce Prima del Traffico di Picco
Prima di simulare il traffico, chiudete le lacune evidenti. L’ottimizzazione delle prestazioni e-commerce si divide in lavoro completabile in settimane e lavoro che appartiene a una roadmap più lunga — sapere qual è quale impedisce ai team di iniziare una ri-architettura tre settimane prima del Black Friday.
Ottimizzazione del Frontend
- Core Web Vitals sotto carico. Misurate Largest Contentful Paint e Interaction to Next Paint con traffico realistico, non su un ambiente di staging inattivo. I punteggi che sembrano buoni in locale si degradano rapidamente quando la latenza del backend aumenta.
- Ottimizzazione delle immagini. Servite immagini responsive in formati moderni, applicate lazy-load ai contenuti sotto la prima piega e pre-generate le varianti — non ridimensionate al volo durante la vendita.
- Caching degli asset statici. Spingete gli asset cacheabili verso la CDN con header di cache espliciti. Ogni hit di cache all’edge è una richiesta che la vostra origine non vede mai.
- Script di terze parti. Verificate tag manager, widget di chat, analytics e script di personalizzazione. Ognuno aggiunge latenza e ogni dipendenza esterna è un punto di fallimento che non controllate.
Ottimizzazione del Backend
- Query del database. Profilate le query eseguite durante navigazione e checkout — query lente del catalogo, pattern N+1 e lookup non indicizzati sono le prime a collassare sotto carico.
- Pool di connessioni. Dimensionate deliberatamente i pool di connessioni di database e servizi. Un pool troppo piccolo mette in coda le richieste; troppo grande esaurisce il database.
- Tempi di risposta delle API. Misurate individualmente le API sul percorso di transazione — prodotto, prezzi, carrello, checkout, pagamento. La più lenta definisce l’esperienza del cliente.
- Strategia di caching. Il catalogo prodotti e i dati sui prezzi si mettono in cache bene e tollerano una breve obsolescenza. I contenuti personalizzati e lo stato del carrello no — metteteli in cache per utente, per sessione, o per niente.
Quick Win vs. Lavoro Strutturale
Cambi di configurazione, ottimizzazione delle query, tuning della cache e regole CDN sono quick win — da giorni a settimane di lavoro. Tutto ciò che comporta ri-architetturare servizi, cambiare datastore o dividere il percorso di checkout è lavoro strutturale e appartiene alla roadmap post-stagione. Se un collo di bottiglia non si può risolvere prima della vendita, la mossa corretta è testarlo, conoscerne i limiti e costruirci attorno una mitigazione — non avviare comunque la ricostruzione.
Load Testing E-Commerce: Simulare il Traffico del Black Friday
Il load testing e-commerce risponde a una domanda specifica: a quale livello di traffico il vostro percorso di transazione inizia a fallire, e come fallisce? Eseguire test realistici settimane prima della vendita vi dà il tempo di sistemare ciò che trovate — eseguirli la settimana dell’evento vi dice solo cosa sta per andare storto.
Load Testing vs. Stress Testing vs. Spike Testing
| Tipo di test | Cosa fa | Quando usarlo |
|---|---|---|
| Load test | Applica il traffico di picco previsto e verifica che il sistema raggiunga gli obiettivi di prestazioni | In ogni campagna — stabilisce la risposta go/no-go di riferimento |
| Stress test | Spinge il traffico oltre il picco previsto fino alla rottura del sistema | Per trovare il punto di rottura e osservare le modalità di fallimento in sicurezza |
| Spike test | Aumenta il traffico bruscamente — da quasi zero al picco in pochi minuti | Flash sale e lanci programmati in cui il tasso di arrivo è il vero stress |
Un load test conferma che il vostro sistema funziona al volume previsto. Uno stress test vi dice quanto margine reale avete e — altrettanto prezioso — se il sistema degrada con eleganza o collassa. Uno spike test è quello che conta di più per il Black Friday perché il traffico non arriva gradualmente; arriva quando viene inviata la campagna email.
Una regola vale per tutti e tre: testate percorsi utente e carichi transazionali, non richieste alla homepage. Un test che martella la vostra homepage riporterà numeri sani mentre l’API di checkout crolla silenziosamente. Le metriche che contano vivono nel percorso di transazione, quindi è quello che si simula.
Costruire Scenari di Test E-Commerce Realistici
Gli scenari realistici modellano ciò che i clienti fanno davvero, nelle proporzioni in cui lo fanno:
- Traffico dominato dalla navigazione. La maggior parte degli utenti naviga pagine prodotto, categorie e ricerca senza comprare. Modellate questa quota come la proporzione maggiore di utenti virtuali — stressa le API del catalogo, la ricerca e il comportamento della CDN.
- Flussi di carrello e checkout. Una quota minore ma critica aggiunge al carrello, entra nel checkout e completa il pagamento. Queste sessioni mantengono stato, scrivono nei database e chiamano servizi di terze parti — le operazioni costose.
- Sessioni di checkout concorrenti. Modellate centinaia di checkout simultanei con comportamento di sessione reale, inclusi utenti che esitano, tornano indietro e riprovano.
- Contesa di inventario in flash sale. Puntate molti acquirenti concorrenti sullo stesso prodotto a basso stock. Questo è lo scenario che porta alla luce le race condition dell’overselling.
- Latenza delle terze parti. Iniettate ritardi realistici nelle chiamate al gateway di pagamento, al calcolatore di spedizione, al servizio fiscale e all’API di inventario. Se il vostro test assume risposte istantanee dalle terze parti, non sta testando la produzione.
- Fallimenti delle dipendenze. Fate fallire completamente la sandbox di pagamento per intervalli. Il vostro sistema deve degradare in modo prevedibile, non bloccarsi.
Eseguite i flussi di pagamento contro sandbox o mock del gateway — non processate mai transazioni reali in un test e non puntate mai un load test sull’endpoint di produzione di un provider senza la sua approvazione esplicita.
Metriche Che Contano Durante il Load Testing
- Percentili di latenza. Il p50 indica l’esperienza tipica; il p95 e il p99 mostrano com’è la coda — e durante una vendita, la coda è un gran numero di clienti. Monitorate i percentili per fase del percorso, non come media dell’intero sito.
- Tassi di errore. Errori HTTP, errori dell’API di checkout e fallimenti di pagamento, ognuno misurato separatamente.
- Throughput. Le richieste al secondo sono la metrica di punta, ma gli ordini completati al minuto sono quelli che correlano con il fatturato.
- Saturazione delle risorse. CPU, memoria, connessioni al database, utilizzo dei pool di thread e connessioni e profondità delle code — mostrano quale componente si romperà per primo.
- Metriche di business. Tasso di completamento del checkout e tasso di fallimento dei pagamenti sotto carico. L’infrastruttura può sembrare sana mentre i clienti non riescono a comprare.
Quando il traffico supera la capacità, i sistemi hanno bisogno di un comportamento di sovraccarico definito — accodamento, scarto delle richieste a bassa priorità o risposte degradate — invece di un fallimento incontrollato. Il capitolo del libro SRE di Google sulla gestione del sovraccarico di sistema descrive le tecniche standard: load shedding, degradazione elegante e throttling lato client.
Ottimizzare le Prestazioni del Checkout e l’Affidabilità dei Pagamenti
Il checkout è dove i problemi di prestazioni diventano problemi di fatturato. Una pagina prodotto lenta costa engagement; un checkout lento o fallito costa ordini completati — e li costa nel momento di massima intenzione.
Partite dalla latenza dell’API di checkout. Ogni passo sul percorso — validazione del carrello, calcolo della spedizione, ricerca delle imposte, autorizzazione del pagamento, creazione dell’ordine — è una chiamata di rete con la propria latenza e le proprie modalità di fallimento. Misurate ogni passo separatamente durante i test, perché il numero aggregato nasconde il vero collo di bottiglia. Un checkout che impiega otto secondi ha di solito un passo che ne impiega sei.
Il comportamento del gateway di pagamento sotto carico merita particolare attenzione:
- Timeout. I provider di pagamento impongono i propri timeout e rate limit. Il vostro checkout deve trattare un timeout del gateway come uno scenario di prima classe — cosa vede il cliente, cosa succede all’ordine, cosa viene riprovato?
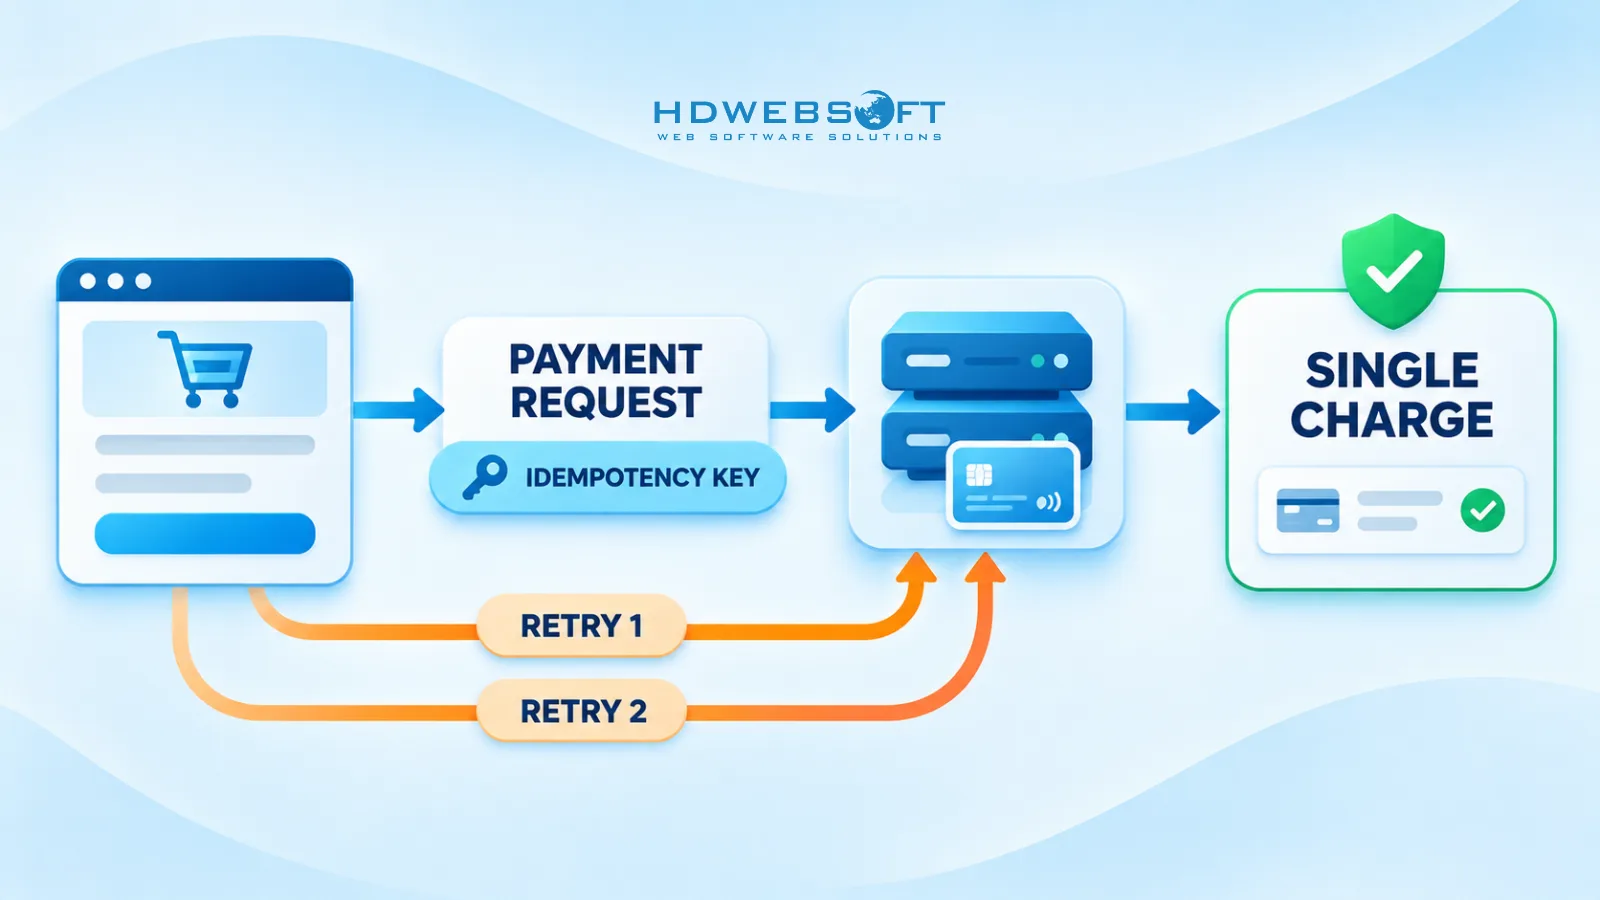
- Retry e richieste duplicate. Gli utenti fanno doppio clic sui pulsanti di invio. I browser riprovano le richieste fallite. Anche il vostro codice client riprova. Senza deduplicazione, ognuno di questi casi diventa un potenziale addebito duplicato.
- Idempotenza. La soluzione standard è una chiave di idempotenza: un identificatore univoco per tentativo di pagamento che permette al provider di riconoscere una richiesta riprovata come la stessa transazione. Stripe documenta il pattern nella sua guida alle richieste di pagamento idempotenti, e la maggior parte dei grandi provider supporta un meccanismo equivalente.
- Fallimento elegante. Quando il provider di pagamento è irraggiungibile o in down, il comportamento corretto è un messaggio chiaro al cliente, un carrello preservato e un ordine mantenuto in uno stato recuperabile — non una schermata che gira e un carrello perso.
Monitorate i tassi di errore del checkout e i fallimenti delle transazioni in tempo reale durante la vendita, con soglie di alerting. Queste metriche meritano un posto nella dashboard degli incidenti accanto ai grafici della CPU — sono il segnale più precoce che il fatturato sta scappando.
Una distinzione necessaria: questa sezione copre l’ottimizzazione tecnica del checkout — latenza, affidabilità e gestione degli errori. L’ottimizzazione del checkout orientata a UX e tasso di conversione (campi del form, layout della pagina, segnali di fiducia) è una disciplina diversa con owner diversi. Entrambe contano; non confusele.
Mantenere Accuratezza di Inventario e Ordini su Tutti i Canali
L’inventario è la modalità di fallimento che i team scoprono dopo la vendita, sotto forma di prodotti sovra-venduti, ordini cancellati ed email di scuse. Accade per una race condition: due clienti vanno al checkout sulla stessa unità di stock, ed entrambe le transazioni si completano prima che una aggiorni il conteggio.
Il problema si moltiplica tra canali. Quando il vostro sito web, il POS fisico e i listing dei marketplace condividono un pool di stock, il ritardo di sincronizzazione dell’inventario è overselling con un altro nome — ogni canale vede un conteggio obsoleto e vende indipendentemente su di esso.
I controlli che funzionano:
- Prenotazione dello stock al checkout. Prenotate l’unità quando il checkout inizia, non quando il pagamento si completa. Una prenotazione che scade su un timer evita che lo stock trattenuto si accumuli pur proteggendo la finestra d’acquisto.
- Decrementi atomici. Gli aggiornamenti dell’inventario devono essere operazioni atomiche — scritture condizionali o decrementi a livello di database — mai sequenze lettura-scrittura che due transazioni possono interlacciare.
- Aggiornamenti event-driven. I cambiamenti di stock devono propagarsi come eventi a ogni canale immediatamente, non secondo un ciclo di polling misurato in minuti. Durante un flash sale, i minuti sono intere finestre di overselling.
- Elaborazione degli ordini via coda. Bufferizzate la creazione degli ordini tramite una coda in modo che raffiche di pagamenti confermati non possano sopraffare il servizio inventario contemporaneamente.
- Riconciliazione post-vendita. Qualunque sia l’architettura, eseguite la riconciliazione dopo l’evento: confrontate gli ordini con lo stock decrementato per canale e risolvete le discrepanze prima che il fulfillment le trasformi in un problema di cancellazioni.
HDWEBSOFT ha implementato questo pattern nella pratica per una piattaforma seller workspace — integrando storefront WooCommerce con un layer centralizzato di inventario e POS in modo che lo stock restasse coerente tra canali online e fisici. Il case study sulla sincronizzazione di inventario WooCommerce e POS dettaglia l’approccio di integrazione.
Gestite l’inventario su più canali di vendita? Scoprite come HDWEBSOFT ha supportato l’integrazione WooCommerce e POS per ottimizzare la sincronizzazione dell’inventario e la gestione degli ordini.
Gestire il Supporto Clienti AI Durante i Picchi di Vendita
I chatbot AI dimostrano il loro valore durante i picchi di vendita assorbendo il volume di richieste di routine — tracciamento ordini, stato della spedizione, stime di consegna, FAQ — che altrimenti seppellirebbero un team di supporto umano. Ma hanno i propri limiti operativi.
La latenza di risposta dei chatbot degrada sotto lo stesso carico che stressa tutto il resto. Le API AI sottostanti applicano rate limit e possono restituire errori o risposte lente proprio quando il volume delle richieste raggiunge il picco. L’automazione del supporto che funziona a volume normale può andare in timeout a volume di vendita.
Due principi mantengono il supporto AI sicuro durante gli eventi di picco:
- Comportamento di fallback. Quando il servizio AI è degradato, il sistema deve degradare verso uno stato definito — una risposta umana in coda, una FAQ statica o un chiaro messaggio “risponderemo a breve” — non un errore o il silenzio.
- Percorsi di escalation umana. Dispute di pagamento, addebiti falliti, richieste di rimborso ed errori d’ordine devono essere indirizzati rapidamente agli umani. Queste sono le richieste dove una risposta automatica sbagliata o in ritardo fa danni reali.
Mantenete il supporto clienti AI disaccoppiato dai processi transazionali critici. Il chatbot non deve mai condividere una dipendenza forte con i flussi di checkout o pagamento — un servizio di supporto sovraccarico non deve poter trascinare giù il percorso di transazione con sé.
Checklist di Readiness Tecnica E-Commerce per il Black Friday
Una checklist di readiness trasforma “pensiamo di essere pronti” in una serie di verifiche accertabili. I criteri seguenti sono deliberatamente formulati come verifiche piuttosto che soglie universali — il giusto obiettivo di latenza, il multiplo di capacità e il tasso di errore accettabile dipendono dalla vostra piattaforma, dalla vostra previsione di traffico e dalla vostra tolleranza aziendale. Definite i vostri numeri; questi controlli confermano che li rispettate davvero.
| Area | Verifica tecnica | Criterio di successo | Go/No-Go |
|---|---|---|---|
| Prestazioni Sito & Backend | Load test al traffico di picco previsto | Sostiene il throughput target con latenza entro i vostri budget definiti | ☐ |
| Prestazioni Sito & Backend | Stress test oltre le previsioni | Punto di rottura identificato; il sistema degrada con eleganza, non catastroficamente | ☐ |
| Prestazioni Sito & Backend | Copertura CDN e cache | Asset statici e di catalogo serviti dall’edge; offload dell’origine verificato | ☐ |
| Prestazioni Sito & Backend | Dimensionamento database e pool | Nessun esaurimento del pool né contesa di lock al carico di picco testato | ☐ |
| Checkout & Pagamento | Checkout end-to-end sotto carico concorrente | Il tasso di completamento del checkout mantiene il vostro obiettivo sotto traffico di test | ☐ |
| Checkout & Pagamento | Idempotenza dei pagamenti | Pagamenti riprovati e doppi invii producono un unico addebito | ☐ |
| Checkout & Pagamento | Simulazione di fallimento del gateway | Timeout e down del provider producono comportamento elegante lato cliente | ☐ |
| Inventario & Ordini | Test di contesa in flash sale | Nessun overselling sotto acquisti concorrenti di articoli a basso stock | ☐ |
| Inventario & Ordini | Sincronizzazione stock multicanale | I cambiamenti di stock si propagano a tutti i canali entro il vostro budget di ritardo | ☐ |
| Inventario & Ordini | Piano di riconciliazione ordini | Procedura di riconciliazione post-vendita definita e pianificata | ☐ |
| Monitoring & Incidenti | Dashboard e alert in tempo reale | Alerting attivo su latenza, tasso di errore, completamento checkout e fallimenti pagamento | ☐ |
| Monitoring & Incidenti | Runbook di incidente | Responsabilità di escalation, piano di rollback e interruttori di degradazione documentati | ☐ |
Qualsiasi riga che non può essere spuntata è o una correzione da fare ora o un rischio noto da pianificare — entrambe sono risposte migliori dello scoprirlo durante la vendita.
Risposta agli Incidenti e Revisione delle Prestazioni Post-Vendita
La preparazione riduce gli incidenti; non li elimina. Il modo in cui il team si comporta durante l’evento conta quanto i test che l’hanno preceduto.
Durante la vendita, il monitoraggio in tempo reale è il quadro operativo. Le dashboard che coprono latenza, tassi di errore, completamento del checkout, fallimenti di pagamento e saturazione dell’infrastruttura devono essere osservate continuamente — con alert calibrati abbastanza stretti da intercettare la degradazione prima che i clienti la segnalino. Assegnate esplicitamente la proprietà degli incidenti: chi osserva, chi decide, chi esegue un rollback o un interruttore di degradazione e chi comunica. I percorsi di escalation concordati in anticipo sono minuti risparmiati quando conta.
Quando il carico supera comunque la capacità, la degradazione elegante è la valvola di sicurezza. Interruttori di degradazione definiti — disattivare la personalizzazione, mettere in pausa i widget di raccomandazione, accodare le funzioni non critiche — vi permettono di ridurre il carico deliberatamente invece di fallire casualmente. Questi interruttori devono essere testati in anticipo, non inventati nel mezzo dell’incidente.
Dopo la vendita, la revisione è dove l’investimento rende:
- Analisi delle prestazioni. Dove si sono attestati i percentili di latenza rispetto agli obiettivi? Quali componenti hanno saturato per primi?
- Revisione di checkout e pagamento. Contate le transazioni fallite, i tassi di timeout e gli incidenti del provider di pagamento — ognuno ha un valore di fatturato associato.
- Audit dell’inventario. Riconciliate gli ordini con lo stock su ogni canale; investigate ogni discrepanza.
- Revisione dei colli di bottiglia del supporto. Quali tipologie di richiesta hanno sopraffatto il team o l’automazione?
- Backlog di miglioramenti. Convertite ogni risultato in un task ingegneristico concreto per il prossimo evento.
L’ingegneria dell’affidabilità tratta queste pratiche come discipline continue, non progetti pre-festivi. Il pilastro Reliability dell’AWS Well-Architected Framework fornisce un framework utile per il ripristino dai guasti e il miglioramento operativo che si applica ben oltre i sistemi ospitati su AWS.
Conclusione: Costruire le Prestazioni E-Commerce Oltre il Black Friday
Il Black Friday è lo stress test più impegnativo che la maggior parte delle piattaforme e-commerce affronta durante l’anno — ma il lavoro che determina se lo superate non avviene a novembre. Le prestazioni e-commerce sono una disciplina ingegneristica per tutto l’anno: load testing realistici, gestione affidabile di checkout e pagamenti, e sincronizzazione accurata dell’inventario tra canali sono capacità operative, non checklist di campagna.
I team che trattano ogni evento di picco come dati — misurati, revisionati e alimentati nel ciclo di miglioramento successivo — sono quelli le cui piattaforme diventano più forti ogni stagione invece che semplicemente più fortunate. Questa è anche la differenza tra l’ottimizzazione come progetto una tantum e l’ingegneria delle prestazioni come pratica continua.
Se la vostra piattaforma ha bisogno di più del tuning di configurazione — programmi di load testing, ingegneria dell’affidabilità del checkout o integrazione di sistemi — i servizi di sviluppo software e-commerce di HDWEBSOFT coprono esattamente questo territorio. Contattate il nostro team per definire una valutazione di readiness per il vostro prossimo evento di picco.
Domande Frequenti
Come si esegue il load testing di un sito e-commerce per il Black Friday?
Costruite scenari di test che replicano i percorsi reali degli utenti — navigazione prodotti, ricerca, aggiunta al carrello, checkout e pagamento — invece di inviare richieste solo alla homepage. Eseguite load test al volume di picco previsto, stress test per trovare il punto di rottura e spike test che simulano l’impennata di traffico di un flash sale. Usate le sandbox dei gateway di pagamento per evitare transazioni reali.
Quali metriche contano di più nel load testing e-commerce?
Monitorate la latenza p95 e p99, i tassi di errore, le richieste al secondo e gli ordini completati al minuto. Lato infrastruttura, osservate CPU, memoria, pool di connessioni al database e profondità delle code. Soprattutto, misurate il tasso di completamento del checkout e il tasso di fallimento dei pagamenti — le metriche infrastrutturali da sole non mostrano se i clienti riescono davvero ad acquistare.
Come si prevengono i pagamenti duplicati durante i picchi di traffico?
Usate chiavi di idempotenza sulle richieste di pagamento in modo che gli invii ripetuti — sia da utenti che cliccano due volte sia dalla logica di retry lato client — risultino in un unico addebito. Provider come Stripe supportano le richieste idempotenti nativamente. Combinatelo con la disabilitazione del pulsante di invio dopo il primo clic e con la deduplicazione lato server alla creazione dell’ordine.
Cosa causa l’overselling durante i flash sale e come si previene?
L’overselling avviene quando due clienti completano il checkout sulla stessa unità di stock prima che l’inventario si aggiorni — una race condition tra carrello, checkout e servizio inventario. La prevenzione richiede prenotazione dello stock all’inizio del checkout, decrementi atomici dell’inventario, aggiornamenti event-driven su tutti i canali di vendita e riconciliazione degli ordini dopo la campagna.
Cosa deve includere una checklist di readiness tecnica per il Black Friday?
Quattro aree: prestazioni di sito e backend (caching, CDN, capacità del database verificata con load test), affidabilità di checkout e pagamenti (pagamenti idempotenti, gestione elegante dei timeout del gateway, monitoraggio degli errori), sincronizzazione di inventario e ordini (prenotazioni, sincronizzazione multicanale, piano di riconciliazione) e readiness agli incidenti (alerting, responsabilità di escalation, piani di rollback e degradazione).