Un modello NER (Named Entity Recognition) è un pilastro della NLP che identifica e classifica le entità nel testo. In un mondo in cui i dati non strutturati crescono in modo esponenziale, estrarre informazioni significative è diventato fondamentale per le aziende. Questa capacità di analizzare e organizzare i dati testuali ha reso il NER essenziale in vari settori.
Nell’articolo di oggi, ti spiegheremo cos’è esattamente il named entity recognition e il suo concetto con un esempio semplice. Inoltre, scoprirai vari casi d’uso del NER e comprenderai come funziona.
Cos’è il Named Entity Recognition?
Il Named Entity Recognition è una tecnica di Natural Language Processing che identifica e categorizza entità specifiche nel testo. Queste entità possono includere persone, organizzazioni, luoghi, date, valori numerici e altro ancora.
Ovviamente, il NER è al centro di questa tecnologia, consentendo ai sistemi di strutturare dati testuali non strutturati estraendo insight significativi. Il modello NER costituisce la spina dorsale di molte applicazioni, come chatbot, sentiment analysis e motori di ricerca. Secondo un report recente, il mercato globale della NLP dovrebbe raggiungere 156,80 miliardi di dollari entro il 2030. Con l’adozione di strumenti come il NER, possiamo aspettarci un futuro più luminoso per AI e ML in vari ambiti.
Lo Scopo del Modello NER
L’obiettivo principale di un modello di Named Entity Recognition è trasformare il testo grezzo in un formato strutturato per l’analisi. Categorizzando le informazioni chiave, aiuta le aziende a estrarre insight azionabili da dataset enormi. Come risultato auspicabile, questo consente un processo decisionale efficiente e supporta applicazioni in settori come sanità, finanza e customer service.
Il Concetto Chiave del Modello NER

Dietro le quinte, il NER si affida a diversi concetti e tecniche chiave per comprendere ed elaborare il linguaggio in modo efficace. Esploriamo questi componenti in dettaglio.
POS Tagging
Il Parts of Speech tagging, o POS tagging, è uno dei passaggi fondamentali nella costruzione di un modello NER. Consiste nell’etichettare ogni parola di una frase con il suo ruolo grammaticale, come sostantivo, verbo, aggettivo o avverbio. Per esempio, nella frase “The doctor visited Paris,” il modello taggherebbe doctor come sostantivo e visited come verbo.
Questo tagging è cruciale per il NER perché aiuta il modello a comprendere il ruolo che ogni parola svolge nella frase. Nello specifico, i nomi propri sono spesso indicativi di nomi di persone, luoghi o organizzazioni. Da questo punto di vista, il POS tagging fornisce contesto, consentendo al modello di fare previsioni più accurate nella categorizzazione delle entità.
In sostanza, questo processo di tagging permette al modello di restringere il proprio focus sulle parole che probabilmente sono entità, migliorandone la precisione.
Corpus
Un corpus è essenzialmente una grande raccolta di testi usata per addestrare il modello di Named Entity Recognition. Questo dataset è annotato con esempi etichettati, come la marcatura di nomi, luoghi e date. In un corpus di addestramento per un modello NER, la frase “Apple Inc. is based in California” evidenzierebbe Apple Inc. come organizzazione e California come luogo.
La qualità e la diversità del corpus influenzano direttamente le performance del modello. Un corpus ben bilanciato garantisce che il NER possa gestire diversi tipi di testo, dai documenti aziendali formali ai post informali sui social media. Imparando i pattern dal corpus, il modello può generalizzare la propria comprensione per elaborare efficacemente dati mai visti prima.
Chunking
Poi abbiamo il chunking, noto anche come shallow parsing, che consiste nel scomporre le frasi in frasi più piccole e gestibili o “chunk”. Per esempio, la frase “The quick brown fox jumped over the lazy dog” potrebbe essere suddivisa in frasi come “The quick brown fox” e “over the lazy dog.”
Nel contesto del NER, il chunking aiuta a raggruppare le parole per identificare le entità. Questo concetto del modello NER è particolarmente importante per le entità composte da più parole. In questi casi, comprendere la relazione tra le parole è cruciale per un riconoscimento accurato.
Word Embeddings
I word embeddings sono rappresentazioni matematiche delle parole in uno spazio multidimensionale. Sono rappresentazioni avanzate delle parole in formato numerico, che catturano il loro significato semantico e le relazioni contestuali.
Nel NER, embeddings come Word2Vec, GloVe o quelli generati da modelli basati su transformer come BERT giocano un ruolo fondamentale. Nello specifico, questi embeddings consentono al modello di comprendere sia il significato letterale di una parola che la sua relazione con le altre parole della frase. Questa capacità diventa particolarmente importante per distinguere le entità in contesti ambigui o complessi. Senza un’analisi così profonda, gli approcci superficiali potrebbero non riuscire a fornire risultati accurati.
Un Esempio di NER
Considera la frase per testare un modello NER: “Tesla announced that Elon Musk plans to open a new factory in Austin, Texas, by the end of 2025.”
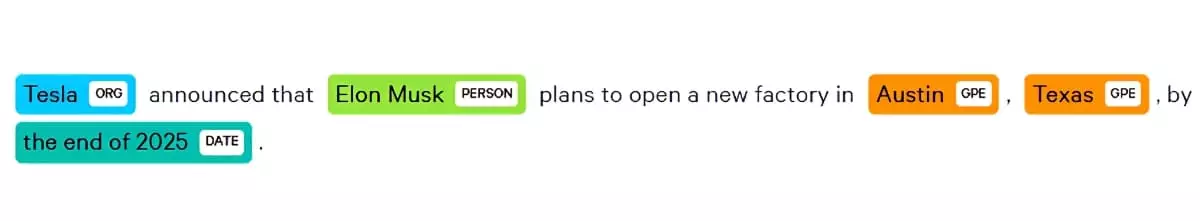
Modello NER applicato alla frase usando il displaCy Named Entity Visualizer.
In questa frase:
- “Tesla” è taggato come ORG, a rappresentare un’organizzazione o azienda.
- “Elon Musk” è etichettato come PERSON, indicando che è un’entità che si riferisce al nome di una persona.
- “Austin” e “Texas” sono classificati come GPE, che sta per Geopolitical Entity, identificando città o regioni specifiche.
- “2025” è riconosciuto come DATE, rappresentando un’entità temporale.
Essenzialmente, se vuoi estrarre e categorizzare automaticamente entità nominate come queste dal testo, il NER è la tecnica da impiegare. In sostanza, aiuta i computer a comprendere il significato del testo identificando gli elementi chiave e le loro relazioni.
Casi d’Uso Chiave del Modello NER
Il modello di Named Entity Recognition sta guidando l’innovazione in diversi settori. Identificando e categorizzando le entità nel testo non strutturato, consente alle aziende di snellire i processi, migliorare gli insight e prendere decisioni basate sui dati. Esploriamo alcune delle applicazioni chiave del modello NER in vari domini:
Information Retrieval
Una delle applicazioni principali del NER è l’information retrieval. In un’epoca in cui vengono generate ogni giorno enormi quantità di dati, recuperare informazioni rilevanti dal testo non strutturato è importante. Nello specifico, il Named Entity Recognition eccelle nell’estrarre entità come nomi, luoghi, date o termini specifici da dataset estesi. Di conseguenza, diventa più facile indicizzare e cercare contenuti rilevanti.
Il modello NER è particolarmente utile nel recuperare informazioni da una massa di dati.
Prendiamo il settore legale come esempio. Il modello di Named Entity Recognition può estrarre numeri di causa, nomi dei contendenti o dettagli delle sentenze dai documenti legali. Di conseguenza, il processo di ricerca dei casi viene accelerato. Allo stesso modo, nel mondo accademico, i ricercatori lo usano per estrarre informazioni critiche da articoli scientifici o dataset di studio, risparmiando tempo e fatica.
Inserimento Dati Automatizzato
L’inserimento manuale dei dati non è solo dispendioso in termini di tempo, ma anche soggetto a errori. La tecnologia automatizza questo processo identificando le informazioni chiave nel testo e categorizzandole in formati strutturati. In particolare, il modello NER è utile in settori come la sanità, dove la registrazione accurata dei dati è vitale per la cura dei pazienti.
Per illustrare, un provider sanitario può usare il NER per estrarre nomi dei pazienti, condizioni mediche e trattamenti prescritti dalle note cliniche. Questi dati vengono poi inseriti senza attriti nelle cartelle cliniche elettroniche (EHR), riducendo il carico amministrativo e migliorando l’accuratezza. Allo stesso modo, il modello di Named Entity Recognition funge da applicazione dell’AI nella finanza. Nello specifico, può automatizzare l’estrazione di dettagli delle transazioni, numeri di conto e date da fatture o estratti conto bancari.
Miglioramento della Sentiment Analysis
Valutare le emozioni o le opinioni espresse nel testo è lo scopo della sentiment analysis, uno strumento di AI spesso usato nel marketing e nel customer service. Mentre la sentiment analysis tradizionale fornisce un punteggio di sentiment complessivo, l’integrazione della tecnologia NER ne migliora la granularità. Il modello NER identifica entità specifiche nel testo, come nomi di prodotti, menzioni di servizi o concorrenti. Così facendo, consente alle organizzazioni di individuare di cosa parlano i clienti e di capire come si sentono al riguardo.
Vediamo un esempio. Se la recensione di un cliente dice: “Ho adorato la fotocamera del nuovo Phone X, ma la durata della batteria è deludente”, il modello può identificare Phone X come il prodotto. Inoltre, può segmentare separatamente il sentiment relativo alla fotocamera e alla durata della batteria. Questo livello di dettaglio è prezioso per le aziende che mirano a migliorare le proprie offerte o l’esperienza del cliente.
In settori come il retail e l’hospitality, il feedback dei clienti è fondamentale. Pertanto, il modello di Named Entity Recognition guida insight azionabili che aiutano a migliorare le strategie e ad aumentare la soddisfazione dei clienti.
Come Funziona il Modello NER
Fondamentalmente, il NER comporta due passaggi principali:
- Rilevare le entità all’interno del testo.
- Classificare queste entità in categorie specifiche.
Entriamo più nel dettaglio:
Rilevamento delle Entità
Il passaggio fondamentale nel processo del modello NER è il rilevamento delle entità, noto anche come mention detection o entity spotting. Consiste nell’identificare frammenti di testo che possono rappresentare entità di interesse. Questa fase è critica perché restringe il campo per le analisi successive. Di conseguenza, garantisce che solo le parti rilevanti del testo procedano alla fase successiva.
L’entity spotting, il primo passo del modello NER al lavoro, rileva e indica le entità rilevanti.
Tokenizzazione
Al centro del rilevamento delle entità c’è la tokenizzazione, un processo che scompone una frase o un documento in componenti più piccoli chiamati token. I token sono tipicamente parole, ma possono includere anche punteggiatura o simboli. Per esempio, nella frase “OpenAI created ChatGPT in 2023,” i token potrebbero essere OpenAI, created, ChatGPT e 2023.
Segmentando il testo in unità gestibili, la tokenizzazione pone le basi per l’elaborazione successiva. Di conseguenza, consente al modello di Named Entity Recognition di isolare entità specifiche dal testo circostante.
Estrazione delle Caratteristiche
Una volta identificati i token, il modello NER estrae da essi caratteristiche significative per determinarne il potenziale come entità. Questo passaggio esamina:
- Caratteristiche Morfologiche: Analizzano le strutture delle parole, come radici, prefissi o suffissi, aiutando a identificare varianti come run e running.
- Caratteristiche Sintattiche: Si concentrano sulle relazioni tra le parole in una frase. In particolare, identificano un sostantivo che segue un verbo come potenziale entità.
- Caratteristiche Semantiche: Catturano il significato più ampio di una parola nel suo contesto. Ad esempio, la parola bank potrebbe riferirsi a un istituto finanziario o alla sponda di un fiume, a seconda della frase.
Con queste caratteristiche a disposizione, il NER garantisce di non trascurare entità significative filtrando al contempo quelle irrilevanti.
Classificazione delle Entità
Il passaggio successivo è la classificazione delle entità, dove le entità rilevate vengono assegnate a categorie predefinite in base al loro contesto e alla loro rilevanza. Questa fase è critica per trasformare il testo grezzo in insight strutturati.
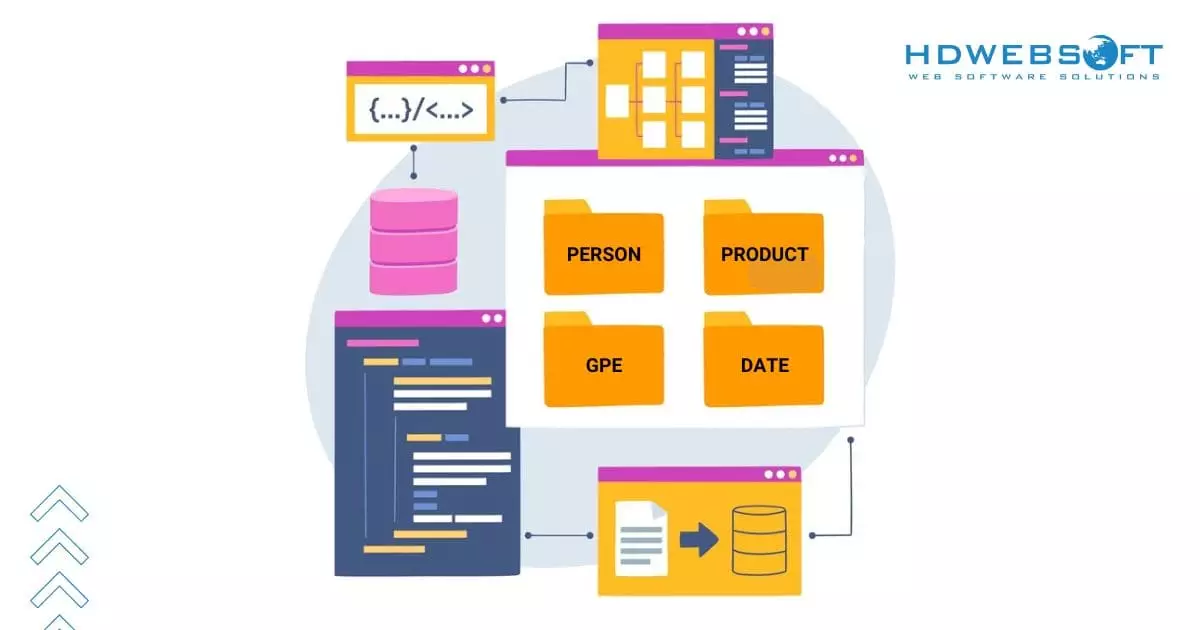
Il passo successivo è classificare le entità rilevate in categorie prescritte.
Comprensione Contestuale
Una classificazione efficace delle entità nel modello NER richiede una comprensione sfumata del contesto del testo. Per esempio, nella frase “Amazon delivers goods worldwide,” Amazon verrebbe classificata come organizzazione. Tuttavia, in “The Amazon rainforest is vast,” la stessa parola rappresenta un luogo.
Per raggiungere questo risultato, il modello si affida a una combinazione di analisi linguistica e tecniche di machine learning, tra cui:
- Approcci Basati su Regole: Regole e pattern predefiniti, come la maiuscolettatura o posizioni specifiche delle parole, aiutano a categorizzare le entità.
- Modelli Statistici: Gli algoritmi analizzano i pattern nei dataset annotati per fare previsioni sulla categoria di un’entità.
- Modelli di Deep Learning: Architetture avanzate come BERT usano i word embeddings per catturare il significato contestuale più profondo, raffinando il processo di classificazione.
Gestione delle Ambiguità
Il linguaggio naturale spesso contiene ambiguità che sfidano la classificazione delle entità. Per esempio, in “Spring arrives in March,” Spring si riferisce a una stagione, ma in “Spring Technologies launched a new app,” è un’organizzazione. Risolvere queste ambiguità richiede modelli sofisticati addestrati su dataset diversificati e completi.
Integrando senza sforzo il rilevamento e la classificazione delle entità, il modello NER trasforma i dati non strutturati in insight azionabili. Per questo motivo, guida l’efficienza in settori e applicazioni diversi.
Lettura consigliata: Come Viene Usata l’Analisi del Testo con l’AI nel Business?
Le Sfide del Modello NER
La tecnologia Named Entity Recognition si è rivelata preziosa, eppure non è priva di sfide. Questi ostacoli spesso derivano dalla complessità del linguaggio umano e dai limiti intrinseci della tecnologia. Esploriamo alcune delle sfide più pressanti affrontate dal modello.
Ambiguità
Innanzitutto, l’ambiguità è uno degli ostacoli più significativi nel NER. Le parole o le frasi del linguaggio naturale spesso hanno significati multipli, e determinare quale significato si applica in un contesto può essere impegnativo.
Questo problema complica quindi l’identificazione e la categorizzazione delle entità, poiché il modello deve dedurre il significato corretto da informazioni limitate. Inoltre, l’ambiguità aumenta la probabilità di errori, in particolare in testi altamente sfumati o specifici di dominio.
Dipendenza dal Contesto
Il linguaggio è fortemente dipendente dal contesto, e questo pone un ulteriore livello di complessità per il modello NER. Il significato e la categorizzazione delle entità spesso si basano sulle parole e sulle frasi circostanti.
Pensaci. Un termine che è un’entità in uno scenario potrebbe non avere lo stesso significato in un altro. Questa dipendenza dagli indizi contestuali richiede che il modello possieda una profonda comprensione delle singole parole. Inoltre, deve comprendere come queste parole interagiscono all’interno del testo più ampio.
Variazioni Linguistiche
In questo mondo, il linguaggio è diversificato, con numerosi dialetti, espressioni idiomatiche e strutture grammaticali uniche. Questa diversità rende impegnativo per il NER operare in modo coerente tra lingue diverse o persino tra varianti della stessa lingua. Inoltre, fattori come l’ordine delle parole e le differenze sintattiche possono influire sulla capacità del modello di identificare e classificare le entità in modo accurato.
La diversità delle lingue può essere determinante per il modello NER.
Scarsità di Dati
Un’altra sfida significativa è la scarsità di dati. Molte applicazioni del mondo reale richiedono che il modello gestisca domini di dati specializzati o meno comuni, dove i dataset di addestramento annotati sono scarsi. Senza dati di addestramento sufficienti, il modello NER fatica ad apprendere i pattern e le relazioni necessari per un riconoscimento efficace delle entità.
Prevedibilmente, questa limitazione può ostacolarne le performance, specialmente quando applicato a campi di nicchia o argomenti emergenti.
Generalizzazione del Modello
Ultima ma non meno importante, la generalizzazione del modello. Si riferisce alla capacità di ottenere buone performance su dati nuovi e mai visti che differiscono dal dataset di addestramento. Raggiungere questo livello di adattabilità è particolarmente impegnativo perché il linguaggio negli scenari reali è diversificato e imprevedibile.
Di conseguenza, un modello addestrato su dataset specifici potrebbe non riuscire a riconoscere o classificare correttamente le entità in un contesto completamente diverso. Questo, a sua volta, ne limita la scalabilità e l’usabilità tra i domini.
Conclusione
Il modello NER sta rivoluzionando il modo in cui elaboriamo e analizziamo il testo, offrendo un immenso valore in diversi settori. Man mano che l’adozione della NLP cresce, spinta dai progressi dell’AI e dall’aumento dei volumi di dati, le applicazioni del NER sono illimitate. Che sia nella sanità, nella finanza o nel customer service, il NER si distingue come uno strumento potente nella cassetta degli attrezzi dell’AI. Le organizzazioni possono aspettarsi di sbloccare il pieno potenziale dei propri dati non strutturati.
In HDWEBSOFT, siamo specializzati nello sviluppo di AI e ML e possiamo aiutare le aziende a integrare il NER nelle proprie operazioni senza sforzo. La nostra esperienza nell’intelligenza artificiale e nel natural language processing garantisce che le aziende possano sfruttare efficientemente la potenza del NER. Lascia che ti aiutiamo a sfruttare questa tecnologia all’avanguardia per restare al passo nel competitivo panorama odierno.