L’outsourcing IT fallisce più spesso di quanto i buyer ammettano. Il motivo non è che i fornitori siano scadenti o che i clienti siano irragionevoli. La ragione è che il fallimento dell’outsourcing è raramente un evento singolo — è una catena di cause profonde che si compongo fino al collasso dell’incarico. Quando il fallimento diventa visibile, la catena si è già completata, e la conversazione passa da “come lo correggiamo” a “come usciamo”.
Questo articolo non è un elenco di errori generici. È un framework di diagnosi delle cause profonde. Ognuna delle dieci cause profonde seguenti è analizzata per come causa il fallimento, i segnali d’allarme precoci che la rivelano prima che si componga, e il controllo che rompe la catena in quel punto. L’obiettivo non è memorizzare dieci rischi — è riconoscere la catena prima che si completi.
Questo articolo non copre la selezione dei fornitori, le clausole contrattuali, la verifica della fiducia o le metriche di successo. HDWEBSOFT ha articoli separati per quelle finalità. Questo articolo copre ciò che accade dopo la firma del contratto e la costituzione del team: perché gli incarichi falliscono, come rilevare il fallimento in anticipo e dove risiede effettivamente la proprietà di ogni causa profonda.
La catena dei fallimenti: come le cause profonde si compongono
La convinzione più dannosa sul fallimento dell’outsourcing è che abbia una causa singola. “Abbiamo scelto il fornitore sbagliato.” “La comunicazione era scarsa.” “Lo scope non era chiaro.” Queste spiegazioni sono sintomi, non cause profonde — e quasi mai sono indipendenti.
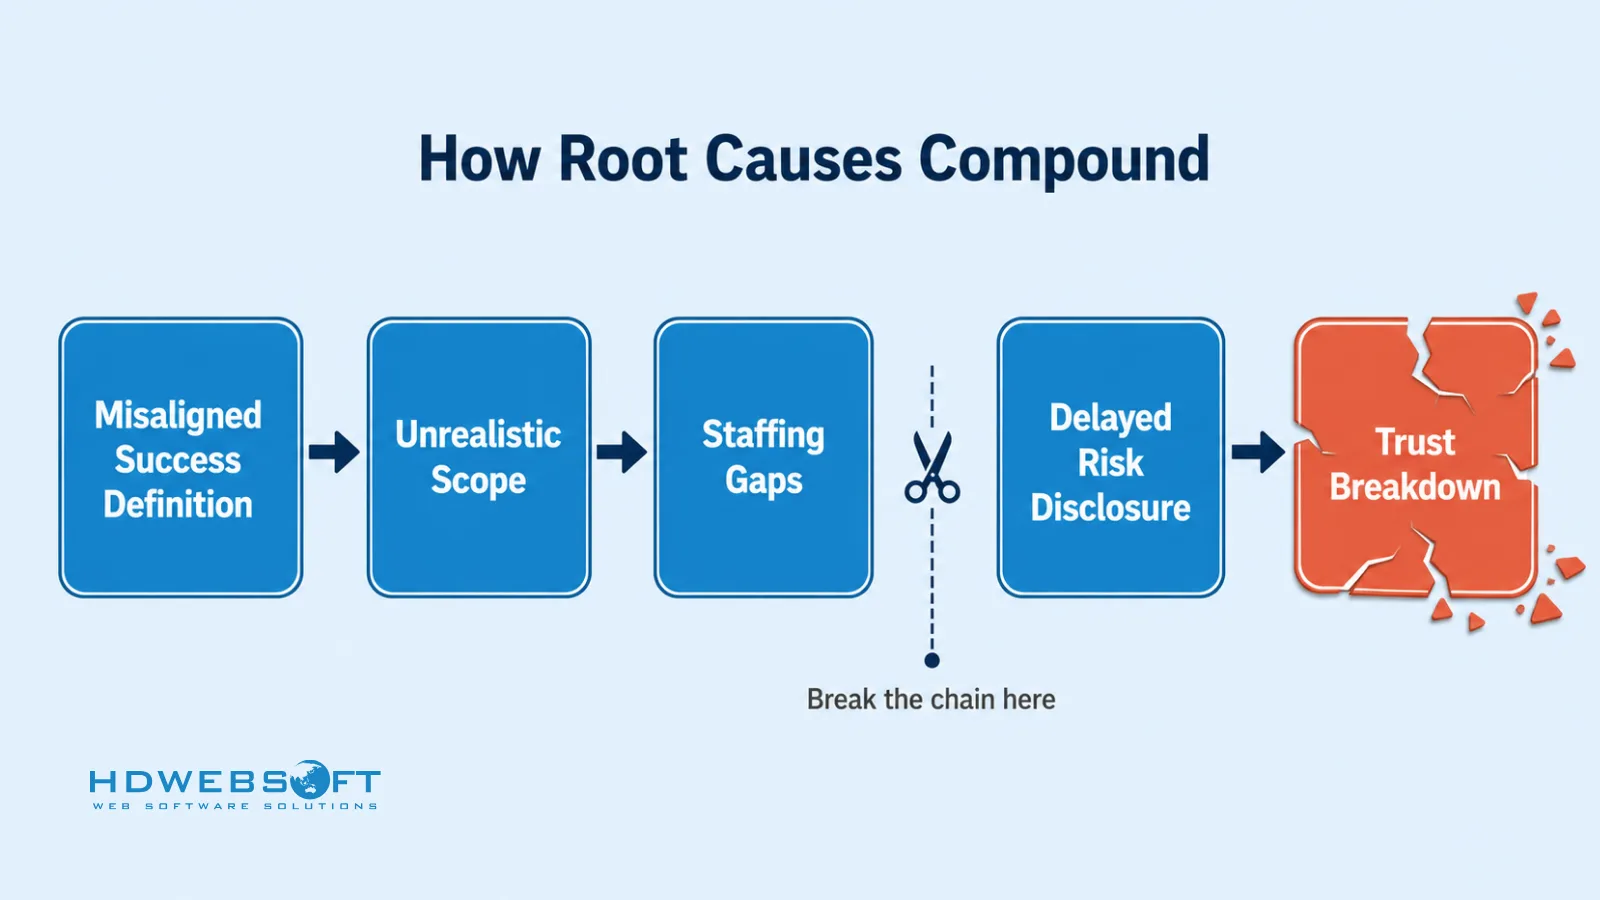
Il fallimento dell’outsourcing è una catena. Una causa profonda non rilevata crea le condizioni per la successiva, che crea le condizioni per la successiva, fino al collasso dell’incarico. Considera una catena comune:
- Definizione di successo disallineata — il cliente definisce il successo come “prodotto consegnato con qualità”, il fornitore lo definisce come “deliverable accettati e ore fatturate”. Nessuna delle parti nota il divario.
- Scope e tempistiche non realistici — poiché il successo è misurato dai deliverable, la tempistica è fissata in modo aggressivo per massimizzare l’accettazione iniziale. Il fornitore accetta perché spingere contro rischierebbe l’accordo.
- Lacune di personale — la tempistica aggressiva costringe il fornitore a staffare con gli ingegneri disponibili, non con quelli giusti. Persone junior vengono assegnate a lavori che richiedono giudizio senior.
- Divulgazione ritardata dei rischi — il team junior incontra problemi che non sa risolvere, ma riportarli verso l’alto significa ammettere che il team è sottoqualificato. I problemi vengono nascosti.
- Rottura della fiducia — quando il cliente scopre i problemi, la tempistica è slittata, la qualità è scarsa e il fornitore nasconde problemi da settimane. L’incarico collassa.
Quale causa profonda ha causato il fallimento? Tutte. Se la definizione di successo fosse stata allineata, la tempistica sarebbe stata realistica. Se la tempistica fosse stata realistica, lo staffing sarebbe stato appropriato. Se lo staffing fosse stato appropriato, i problemi sarebbero stati risolti, non nascosti. Se i problemi fossero stati divulgati, il cliente avrebbe potuto intervenire prima che la fiducia si rompesse.
La catena può essere spezzata in qualsiasi anello. Questa è la tesi di questo articolo: il fallimento è prevenibile non evitando un singolo errore, ma rilevando e spezzando la catena prima che si completi. Le dieci cause profonde seguenti sono gli anelli più comunemente osservati negli incarichi di outsourcing IT falliti. Ognuna include i segnali d’allarme precoci che la rivelano — perché il rilevamento è il prerequisito per l’intervento. Per la prospettiva complementare — come definire e sostenere il successo una volta avviato l’incarico — vedi il nostro framework di ciclo di vita per un outsourcing di successo.
Perché l’outsourcing IT fallisce: 10 cause profonde
La ricerca aziendale 2025 di ISG ha rilevato che quasi il 65% delle organizzazioni era insoddisfatto o solo moderatamente soddisfatto della capacità dei propri fornitori di guidare l’innovazione nei servizi di outsourcing IT. Le dieci cause profonde seguenti spiegano perché quel divario è così ampio. Ogni causa segue la stessa struttura: cosa è la causa profonda, come causa il fallimento, i segnali d’allarme precoci che la rivelano e il controllo che impedisce che si componga nell’anello successivo.
RC1 — Definizione di successo disallineata
- Causa profonda: Il cliente e il fornitore definiscono “successo” in modo diverso. Il cliente pensa in termini di risultati di business — prodotto rilasciato, utenti serviti, ricavi generati. Il fornitore pensa in termini di deliverable contrattuali — funzionalità sviluppate, ore fatturate, milestone firmate.
- Come causa il fallimento: Il fornitore consegna esattamente ciò che era specificato, il cliente lo accetta perché corrisponde al contratto, e il prodotto non produce valore di business. L’incarico è “completato” ma il risultato è un fallimento. Questa causa profonda è il primo anello di molte catene perché fa ottimizzare ogni decisione a valle per l’obiettivo sbagliato.
- Segnali d’allarme precoci: Il fornitore misura il successo dall’output — ticket chiusi, ore fatturate, deliverable accettati — mai dal risultato. Non esiste una definizione condivisa e documentata di “fatto” che includa risultati di business. Le sprint review si concentrano su ciò che è stato costruito, non su se ha raggiunto il risultato utente o di business previsto.
- Prevenzione e controllo: Documenta la definizione di successo all’avvio dell’incarico, inclusi i risultati di business — non solo i deliverable. Rivedila ogni trimestre: “stiamo misurando la stessa cosa, e la cosa che misuriamo è quella che vogliamo davvero?”
RC2 — Colli di bottiglia informativi e di escalation
- Causa profonda: L’informazione deve passare attraverso più livelli prima di raggiungere la persona che può agire. L’ingegnere del fornitore riporta al PM del fornitore, che riporta all’account manager del fornitore, che riporta allo stakeholder del cliente, che riporta al decisore del cliente.
- Come causa il fallimento: Un blocco risolvibile in ore impiega giorni per raggiungere il decisore. Quando la decisione arriva, il blocco è cresciuto fino a diventare una crisi. L’incarico accumula crisi più velocemente di quante le risolva.
- Segnali d’allarme precoci: Il tempo dall’insorgere di un blocco alla consapevolezza del cliente è superiore alla baseline concordata. Il PM trasmette buone notizie più spesso di quelle cattive. Il cliente scopre i problemi durante le demo invece che tramite il canale di escalation — a significare che il canale non funziona.
- Prevenzione e controllo: Dai agli stakeholder del cliente accesso diretto agli strumenti del team — Jira, GitHub o equivalenti. Stabilisci un protocollo di escalation con uno SLA definito per ogni livello di gravità. Il PM deve fungere da ponte che abilita la conversazione cliente-ingegnere, non da filtro che controlla ciò che il cliente vede.
RC3 — Aspettative non realistiche di scope, costi o tempistiche
- Causa profonda: Scope, costi e tempistiche vengono impegnati prima di sapere abbastanza per impegnarsi con precisione. Le stime di vendita si basano su ipotesi ottimistiche. La discovery viene saltata o compressa per vincere l’affare.
- Come causa il fallimento: Il team è costretto a consegnare contro una tempistica mai realizzabile. Per rispettarla, taglia gli angoli — salta i test, riduce la documentazione, semplifica funzionalità senza discussione. La qualità cala. Le rilavorazioni aumentano. La tempistica slitta ulteriormente. La pressione aumenta. Si tagliano più angoli. Il loop si compone.
- Segnali d’allarme precoci: Il fornitore dice sì a ogni cambio di scadenza senza opporsi. Le voci di scope vengono “semplificate” senza una discussione su cosa è stato perso. La velocity di sprint declina stabilmente dopo il secondo o terzo sprint — segno che il team è in burnout o lo scope è più grande dello stimato.
- Prevenzione e controllo: Esegui una fase di discovery prima di impegnarti su una tempistica. Quando lo scope cambia, ricalibra la tempistica — non mantenere la scadenza originale contro uno scope cambiato. Un fornitore che non spinge mai contro non è un buon segno; è un avviso che il fornitore ottimizza per l’accordo, non per la consegna.
RC4 — Mismatch tra capacità e modello di incarico
- Causa profonda: Il modello di incarico non corrisponde al tipo di lavoro. Lo staff augmentation viene usato per un progetto che richiede ownership end-to-end. Un modello a prezzo fisso viene usato per un lavoro che richiede iterazione e discovery continue.
- Come causa il fallimento: Il team non ha l’autorità né il contesto per consegnare. Gli ingegneri in staff augmentation aspettano attività. I team a progetto aspettano specifiche. Il lavoro si blocca nei punti di passaggio tra cliente e fornitore, e nessuno possiede il divario.
- Segnali d’allarme: Il lavoro si blocca ai passaggi di consegne tra cliente e fornitore. Il team chiede frequentemente “chi possiede questa decisione?” I deliverable corrispondono alle specifiche ma non si integrano in un prodotto funzionante — perché nessuno si è fatto carico dell’integrazione.
- Prevenzione e controllo: Abbina il modello di incarico al tipo di lavoro all’avvio. Se la natura del lavoro cambia durante l’incarico, rivaluta il modello. Documenta una matrice di proprietà: chi decide, chi consegna, chi revisiona, chi è responsabile per ogni categoria di lavoro.
RC5 — Governance e ownership deboli
- Causa profonda: Nessuno è assegnato esplicitamente come proprietario di decisioni, rischi e problemi. “Tutti sono responsabili” significa che nessuno lo è. La governance è trattata come una riunione, non come un sistema.
- Come causa il fallimento: I problemi si accumulano perché non hanno un proprietario. I rischi non vengono escalati perché nessuno è responsabile del loro escalation. Le decisioni si ritardano perché non è chiaro chi abbia l’autorità per decidere. L’incarico deriva.
- Segnali d’allarme: Lo stesso problema viene discusso in tre o più riunioni senza risoluzione. Non esiste un registro dei rischi, o il registro esiste ma non viene aggiornato. Le decisioni vengono invertite perché “qualcuno più in alto non era d’accordo” — ma non è chiaro chi sia quel qualcuno, o perché non è stato consultato prima.
- Prevenzione e controllo: Crea una matrice di ownership all’avvio: ogni tipo di decisione, categoria di rischio e classe di problema ha un responsabile nominato. Esegui una revisione di governance settimanale con un’agenda esplicita — decisioni necessarie, rischi in escalation, problemi bloccanti — e traccia ogni voce fino alla chiusura.
RC6 — Lacune di personale e competenze
- Causa profonda: Il team assegnato alla consegna non corrisponde ai requisiti di competenze del progetto. Le persone senior che hanno colpito durante la vendita non sono quelle che fanno il lavoro. La conoscenza si concentra in una o due persone.
- Come causa il fallimento: Gli ingegneri junior faticano con complessità per cui non erano pronti. Le rilavorazioni aumentano. Le scadenze slittano. Un ingegnere senior viene tirato dentro per sistemare le cose, si sovraccarica, e la qualità dell’intero team cala. L’incarico diventa dipendente da una o due persone che non possono scalare.
- Segnali d’allarme: La stessa persona revisiona ogni pull request. La conoscenza si concentra in una o due persone — quando sono in ferie, la consegna si blocca. Le nuove assunzioni impiegano più del ramp concordato per contribuire. Il team non può rispondere a domande tecniche senza consultare una persona specifica.
- Prevenzione e controllo: Costruisci una matrice delle competenze all’avvio: competenze richieste versus competenze dimostrate dal team assegnato. Documenta il processo di sostituzione per i ruoli chiave. Fissa un obiettivo di distribuzione della conoscenza — nessuna conoscenza critica deve vivere solo nella testa di una persona.
RC7 — Scarso trasferimento di conoscenze
- Causa profonda: La conoscenza vive dentro il team del fornitore e non viene trasferita al cliente. La documentazione è trattata come un ripensamento — qualcosa da fare alla fine, se c’è tempo.
- Come causa il fallimento: Il cliente non può operare o mantenere il prodotto dopo l’handover. Il fornitore diventa una dipendenza — il cliente non può uscire senza perdere mesi di contesto. L’incarico continua non perché stia avendo successo, ma perché il costo dell’uscita è troppo alto.
- Segnali d’allarme: Il team del cliente non può fare demo del prodotto senza il fornitore presente. La documentazione è obsoleta, mancante o esiste solo nel wiki interno del fornitore. Inserire un nuovo membro del team cliente richiede supporto del fornitore invece della documentazione lato cliente.
- Prevenzione e controllo: Crea un piano di trasferimento delle conoscenze dal primo giorno — non alla fine del progetto. Tratta la documentazione come un deliverable revisionato a ogni sprint. Esegui un audit periodico di ritenzione delle conoscenze: che percentuale delle conoscenze critiche è documentata e accessibile al team del cliente in modo indipendente?
RC8 — Incentivi commerciali disallineati
- Causa profonda: Il fornitore è incentivato dall’output — ore fatturabili, deliverable accettati — piuttosto che dal risultato — valore di business creato, qualità raggiunta. Il cliente vuole risultati. Il fornitore è pagato per l’output.
- Come causa il fallimento: Il fornitore ottimizza per le ore fatturabili, non per la qualità del prodotto. Le richieste di modifica diventano un’opportunità di fatturato anziché una preoccupazione di consegna. Il fornitore non ha incentivi per prevenire i problemi, perché i problemi creano lavoro aggiuntivo — e lavoro aggiuntivo è ricavo aggiuntivo.
- Segnali d’allarme: Il fornitore spinge change request senza una chiara giustificazione di business. I problemi di qualità generano fatturazione aggiuntiva per correggerli. Il fornitore non propone mai miglioramenti di efficienza — perché l’efficienza significa meno ore, e meno ore significano meno ricavi.
- Prevenzione e controllo: Allinea il modello commerciale ai risultati dove è fattibile — pricing a milestone, basato sul valore o collegato agli outcome. Rivedi periodicamente gli incentivi del fornitore: “questo fornitore trae più beneficio dal nostro successo o dai nostri problemi?” Se la risposta è quest’ultima, il modello commerciale sta lavorando contro l’incarico.
RC9 — Lacune di compatibilità operativa
- Causa profonda: Le dinamiche di lavoro delle due organizzazioni non corrispondono. La sovrapposizione di orari è troppo piccola per una collaborazione in tempo reale. La latenza decisionale è troppo lunga per la cadenza dello sprint. I cicli di feedback non corrispondono alla cadenza di consegna.
- Come causa il fallimento: Le decisioni si ritardano perché la finestra di sovrapposizione è troppo breve. Il feedback viene implementato uno o due sprint dopo, il che significa che il team costruisce sopra lavoro che sta per essere respinto. La cadenza degli sprint e quella di integrazione divergono, producendo problemi di integrazione tardivi nel ciclo.
- Segnali d’allarme: Le decisioni semplici richiedono più tempo dell’obiettivo concordato. Il feedback viene implementato uno o due sprint dopo essere stato dato, non nello sprint corrente. La cadenza delle riunioni non è sufficiente per una collaborazione genuina — è solo report di stato.
- Prevenzione e controllo: Documenta la compatibilità operativa all’avvio: sovrapposizione degli orari, obiettivi di latenza decisionale, obiettivi di ciclo di feedback. Misurali e revisionali periodicamente. Se il divario è strutturale, aggiusta la cadenza — non fingere che il divario non esista.
RC10 — Bassa trasparenza e divulgazione ritardata dei rischi
- Causa profonda: Il fornitore nasconde rischi e problemi per paura — paura del biasimo, paura delle penali contrattuali, paura di danneggiare la relazione. Il cliente non insiste per la trasparenza perché non vuole creare tensione. Entrambe le parti cospirano nel silenzio.
- Come causa il fallimento: I rischi si accumulano silenziosamente. Quando un rischio diventa un problema, è troppo grande da cui riprendersi. Il cliente scopre il problema troppo tardi per intervenire. L’incarico collassa non perché il problema fosse insolubile, ma perché era invisibile finché non era troppo tardi.
- Segnali d’allarme: I report di stato sono sempre “verdi” o “in linea”. Il fornitore non offre volontariamente informazioni sui rischi — il cliente deve chiedere. I problemi emergono solo quando sono troppo grandi da nascondere. Il cliente viene a sapere dei problemi dalla demo, non dal canale di escalation.
- Prevenzione e controllo: Normalizza la divulgazione dei rischi. Un rischio riportato presto è un segnale positivo, non negativo — significa che il team sta facendo attenzione. Dai al cliente accesso diretto agli strumenti così che lo stato possa essere verificato, non solo riportato. Costruisci una cultura del “bad news fast”. Se il problema è un occultamento intenzionale o una violazione della fiducia, è una causa profonda diversa — vedi il nostro framework per fidarsi di un fornitore offshore per il modello di decisione riparazione-o-uscita.
Lato cliente vs lato fornitore vs condivise: dove vive la causa profonda
Uno degli errori più comuni nel diagnosticare il fallimento dell’outsourcing è assumere che il fornitore sia colpevole. Le dieci cause profonde sopra non appartengono solo al fornitore. Comprendono cause di proprietà del cliente, del fornitore e condivise — e la proprietà determina quale dovrebbe essere l’azione di recupero.
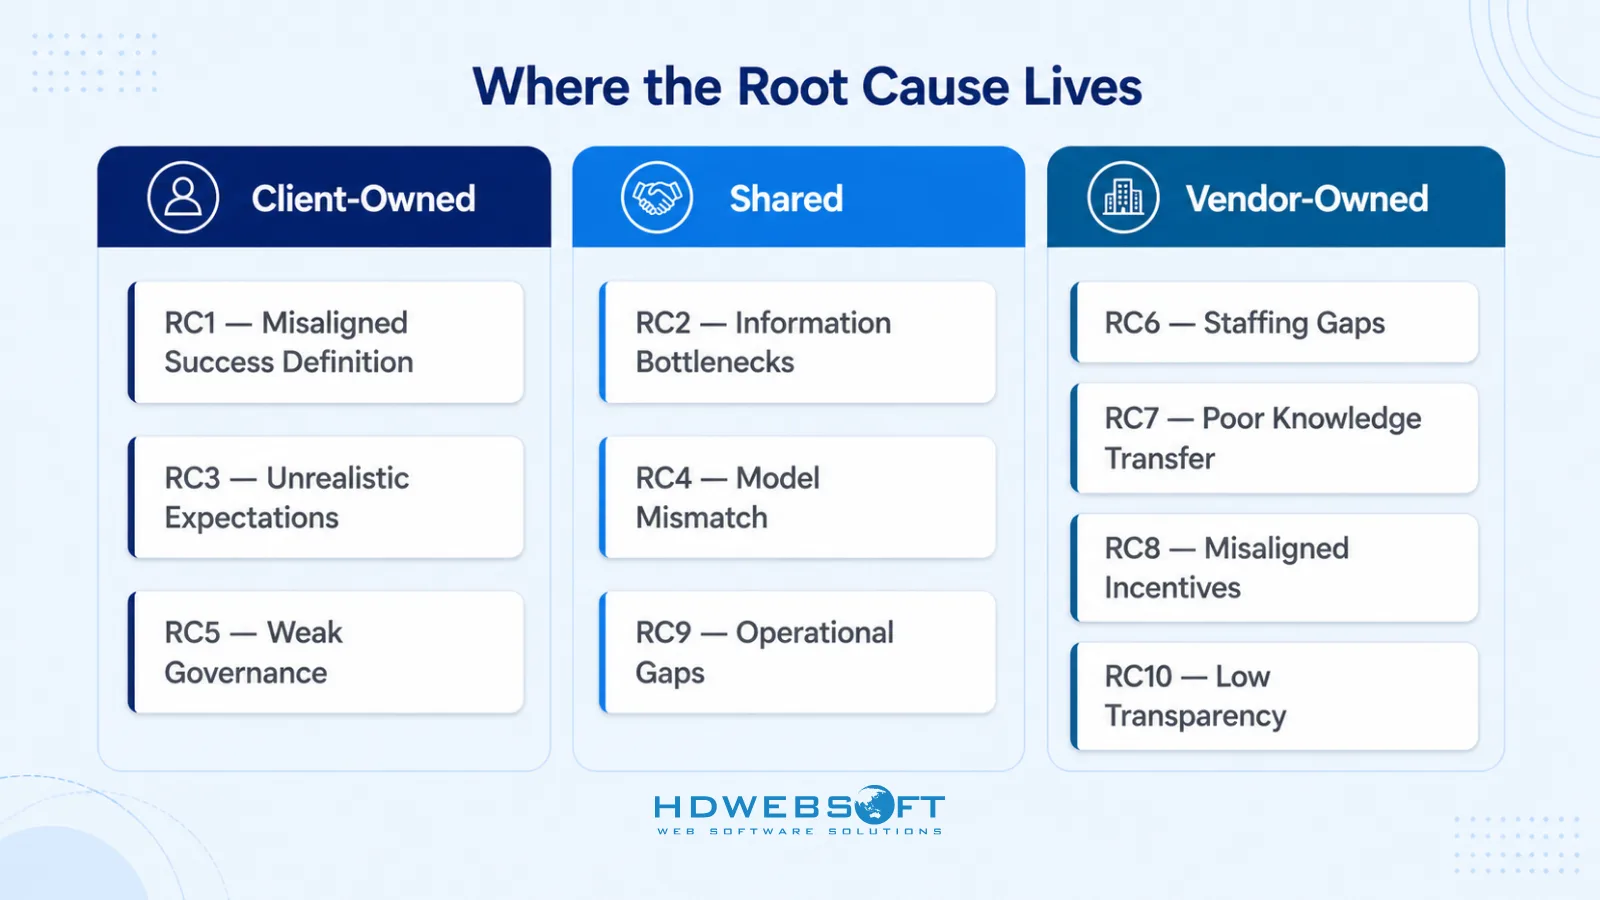
Le cause profonde di proprietà del cliente sono le più difficili da rilevare perché i clienti raramente auditano il proprio comportamento. Se il cliente possiede la causa ma incolpa il fornitore, il recupero fallirà — perché l’intervento mira alla parte sbagliata.
- RC1 — Definizione di successo disallineata: Il cliente definisce cosa significa successo. Se la definizione manca o è solo output, è una lacuna lato cliente.
- RC3 — Aspettative non realistiche: Il cliente imposta scope, costi e tempistiche. Se sono irrealistiche, il cliente possiede la causa — anche se il fornitore le ha accettate.
- RC5 — Governance debole: La governance è responsabilità del cliente. Se non esiste una matrice di ownership, un registro dei rischi e un protocollo decisionale, il cliente non ha costruito il sistema di cui l’incarico ha bisogno.
Le cause profonde di proprietà del fornitore richiedono responsabilità del fornitore — ma il cliente deve rilevarle, perché il fornitore non ha incentivi ad auto-segnalarle.
- RC6 — Lacune di personale: Il fornitore assegna il team. Se il team non corrisponde ai requisiti di competenze, il fornitore possiede la lacuna.
- RC7 — Scarso trasferimento di conoscenze: Il fornitore detiene la conoscenza. Se non viene trasferita, il fornitore possiede la carenza.
- RC8 — Incentivi disallineati: Il fornitore progetta il proprio modello commerciale. Se il modello premia l’output sul risultato, il fornitore possiede il disallineamento.
- RC10 — Bassa trasparenza: Il fornitore controlla quali informazioni vengono divulgate. Se i rischi sono nascosti, il fornitore possiede l’occultamento.
Cause profonde condivise richiedono un reset congiunto — nessuna parte può risolverle da sola.
- RC2 — Colli di bottiglia informativi: Il percorso di escalation attraversa entrambe le organizzazioni. Entrambe devono concordare di accorciarlo.
- RC4 — Mismatch capacità/modello: Il modello è stato scelto congiuntamente. Se non si adatta più, entrambi devono concordare una rivalutazione.
- RC9 — Lacune operative: Orari di lavoro, cadenze e cicli di feedback sono vincoli di entrambe le organizzazioni. Entrambe devono adattarsi.
La mappa di ownership non riguarda l’attribuzione delle colpe. Riguarda il dirigere l’azione di recupero. Una causa di proprietà del cliente richiede al cliente di cambiare il proprio comportamento. Una causa del fornitore richiede responsabilità del fornitore. Una causa condivisa richiede un reset congiunto. Diagnosticare male la proprietà è uno dei motivi più comuni per cui i tentativi di recupero falliscono — l’intervento colpisce la parte sbagliata, e la catena continua.
Segnali d’allarme precoci che la tua collaborazione di outsourcing sta iniziando a fallire
La tabella diagnostica seguente mappa i segnali d’allarme osservabili alla probabile causa profonda e all’azione raccomandata. Usala trimestralmente, o ogni volta che la collaborazione sembra “strana” — ma non aspettare una sensazione. I segnali d’allarme sono schemi osservabili. Tracciali deliberatamente.
| Segnale di allarme | Probabile causa profonda | Azione raccomandata |
|---|---|---|
| I report di stato sono sempre “verdi” o “in linea” | Bassa trasparenza (RC10) | Richiedi accesso diretto agli strumenti; confronta i dati reali con lo stato riportato |
| Lo stesso problema è discusso in 3+ riunioni senza risoluzione | Governance debole (RC5) | Assegna un responsabile esplicito; fissa una scadenza decisionale |
| Il fornitore dice sì a ogni cambio di scadenza senza opposizione | Aspettative non realistiche (RC3) | Richiedi opposizione o ricalibrate insieme scope e tempistica |
| Il team non può rispondere a domande tecniche senza una persona | Lacuna di personale (RC6) | Rivedi la matrice delle competenze; costruisci un piano di distribuzione della conoscenza |
| Il cliente non può fare demo del prodotto senza il fornitore presente | Scarso trasferimento di conoscenze (RC7) | Esegui un audit della documentazione; dedica uno sprint al trasferimento di conoscenze |
| I blocchi emergono dopo la scadenza, non prima | Collo di bottiglia informativo (RC2) | Rivedi il protocollo di escalation; apri un canale diretto PM-stakeholder |
| Il fornitore spinge change request senza giustificazione di business | Incentivi disallineati (RC8) | Rivedi il modello commerciale; lega il pagamento ai risultati, non all’output |
| I deliverable corrispondono alle specifiche ma mancano l’intento | Definizione di successo disallineata (RC1) | Ridefinisci il “fatto” con risultati di business; esegui una revisione congiunta del successo |
| Il lavoro si blocca nei punti di passaggio tra cliente e fornitore | Mismatch capacità/modello (RC4) | Rivaluta il modello di incarico; costruisci una matrice di ownership |
| Le decisioni semplici richiedono più tempo dell’obiettivo concordato | Lacuna operativa (RC9) | Documenta la sovrapposizione effettiva; accorcia il ciclo di feedback |
Conclusione
Il fallimento dell’outsourcing IT è una catena, non un evento. Ogni causa profonda non rilevata crea le condizioni per la successiva, fino a quando l’incarico collassa e l’unica domanda rimasta è come uscire. La buona notizia è che la catena può essere spezzata in qualsiasi anello — se i segnali d’allarme vengono rilevati abbastanza presto.
I segnali d’allarme nella tabella diagnostica sopra non sono sensazioni. Sono schemi osservabili: report di stato sempre verdi, lo stesso problema discusso in tre riunioni senza risoluzione, un fornitore che non spinge mai contro, un team che non può rispondere a una domanda senza una persona. Tracciali deliberatamente, non quando la collaborazione sembra già rotta.
Se stai valutando un partner di outsourcing e ne vuoi uno che operi con trasparenza — accesso diretto agli strumenti, divulgazione precoce dei rischi, una matrice delle competenze che corrisponda al tuo progetto e un modello commerciale che non premia i tuoi problemi — esplora i nostri servizi di outsourcing software o parla con il nostro team. Preferiamo perdere un affare durante la diagnosi che perdere la tua fiducia dopo la firma.
Punti chiave
- Il fallimento dell’outsourcing IT è una catena di cause profonde che si compongono, non un evento singolo — ogni causa non rilevata abilita la successiva, fino al collasso dell’incarico.
- Le dieci cause profonde comprendono definizione di successo disallineata, colli di bottiglia informativi, aspettative non realistiche, mismatch di modello, governance debole, lacune di personale, scarso trasferimento di conoscenze, incentivi disallineati, lacune operative e bassa trasparenza.
- I segnali d’allarme precoci sono schemi osservabili, non sensazioni: stato sempre verde, stesso problema in 3+ riunioni, fornitore che non spinge mai contro, team che non risponde senza una persona, cliente che non può fare demo senza il fornitore.
- Le cause profonde hanno una proprietà — cliente, fornitore o condivise. L’azione di recupero deve mirare al proprietario giusto; incolpare il fornitore per una causa del cliente è un motivo comune di fallimento del recupero.
- La tabella diagnostica mappa i segnali d’allarme alle probabili cause profonde e alle azioni raccomandate — usala trimestralmente o ogni volta che la collaborazione sembra fuori strada, ma non aspettare una sensazione per iniziare a controllare.
FAQ
Perché i progetti di outsourcing IT falliscono?
I progetti di outsourcing IT falliscono perché le cause profonde si compongono in una catena: una definizione di successo disallineata porta a uno scope non realistico, che crea lacune di personale, che innesca una divulgazione ritardata dei rischi, che finisce in una rottura della fiducia. Raramente esiste una causa singola. Diagnosticare la catena — non un solo anello — è ciò che permette l’intervento precoce.
Quali sono i segnali d’allarme precoci del fallimento dell’outsourcing IT?
I segnali d’allarme osservabili includono report di stato sempre verdi, lo stesso problema discusso in tre o più riunioni senza risoluzione, un fornitore che dice sì a ogni cambio di scadenza, un team che non può rispondere a domande tecniche senza consultare una persona e un cliente che non può fare demo del prodotto senza il fornitore presente. Questi sono schemi, non sensazioni.
Un incarico di outsourcing IT in fallimento può essere salvato?
Sì, quando il declino è un problema di prestazioni. Diagnostica la causa profonda, resetta scope e baseline e verifica il miglioramento in una finestra definita. Se la causa è una violazione della fiducia o un occultamento intenzionale, l’incarico richiede una valutazione separata — il recupero delle prestazioni non ripara un fallimento della fiducia.
Il fallimento dell’outsourcing IT è sempre colpa del fornitore?
No. Le cause profonde abbracciano proprietà del cliente, del fornitore e condivise. La definizione di successo disallineata è tipicamente di proprietà del cliente. La bassa trasparenza è tipicamente del fornitore. I colli di bottiglia informativi e le lacune operative sono condivise. Incolpare il fornitore per una causa di proprietà del cliente è uno dei motivi più comuni per cui il recupero fallisce.
Come si prevengono i fallimenti dell’outsourcing IT?
Preveni i fallimenti affrontando le cause profonde prima che si componghino: documenta una definizione di successo condivisa con risultati di business, dai agli stakeholder accesso diretto agli strumenti, stabilisci un protocollo di escalation con SLA definiti, mantieni una matrice delle competenze, richiedi un piano di trasferimento delle conoscenze dal primo giorno, allinea gli incentivi commerciali ai risultati e normalizza la divulgazione precoce dei rischi.
Qual è la differenza tra fallimento e declino dell’outsourcing IT?
Il declino è un deterioramento delle prestazioni — prevedibilità in calo, rilavorazioni in aumento, efficienza dei costi in peggioramento — ed è recuperabile. Il fallimento è la catena completata — l’incarico collassa, richiedendo uscita o riavvio. Un declino non rilevato diventa fallimento. La tabella diagnostica in questo articolo mappa i segnali d’allarme alle cause profonde così che il declino venga intercettato prima che completi la catena.